
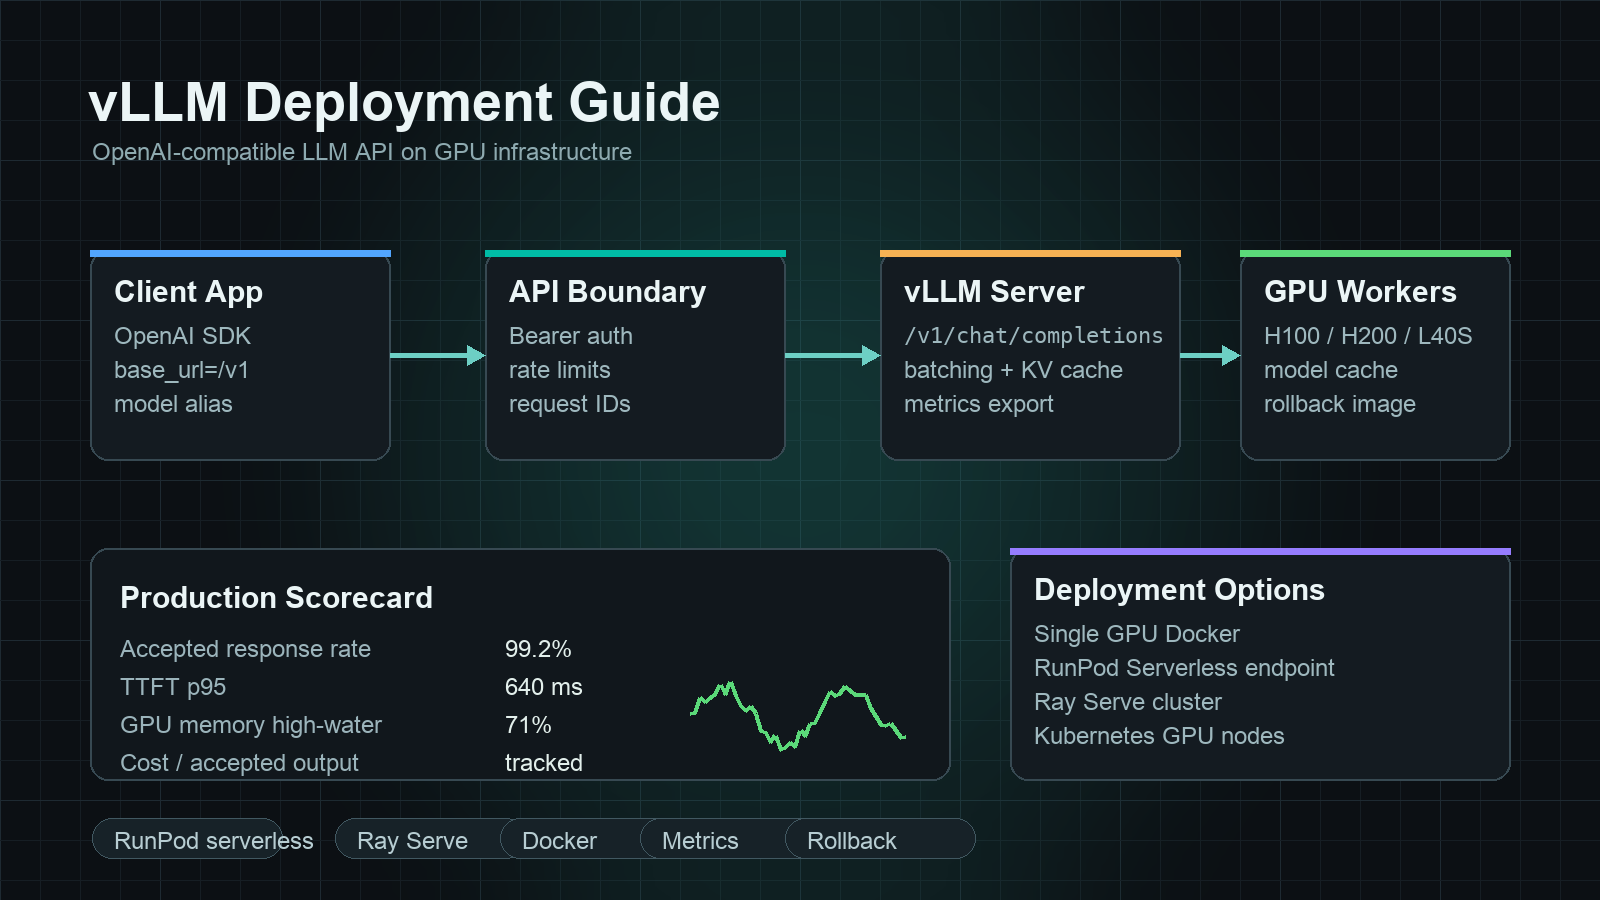
Một hướng dẫn triển khai vLLM nên trả lời một câu hỏi thực tế: làm thế nào để biến năng lực GPU thành một API LLM tương thích OpenAI mà các nhóm ứng dụng có thể gọi, giám sát, rollback và so sánh với các API mô hình được quản lý?
Câu trả lời ngắn gọn là bắt đầu với một mô hình, một cấu hình GPU, một tuyến OpenAI-compatible và một kế hoạch đo lường. vLLM có thể cung cấp các endpoint quen thuộc như /v1/models, /v1/chat/completions và các endpoint theo kiểu OpenAI liên quan, nhưng một triển khai production không chỉ là lệnh vllm serve đầu tiên. Bạn cần một image container, cache mô hình, ranh giới xác thực, health check, metrics, giới hạn request, bài kiểm thử tải, và một bảng điểm chi phí trên mỗi đầu ra được chấp nhận.
Hướng dẫn triển khai vLLM này cung cấp cho các nhà phát triển AI và các nhóm nền tảng một lộ trình triển khai từ một máy chủ GPU đơn lẻ đến RunPod Serverless, Ray Serve, và các mẫu production kiểu Kubernetes. Nó cũng giải thích khi nào một API mô hình hoặc bộ định tuyến như Flatkey có thể đơn giản hơn so với việc tự quản lý lớp phục vụ GPU.
Hướng dẫn triển khai vLLM nhanh
Sử dụng chuỗi này trước khi thêm độ phức tạp của orchestration.
| Bước | Quyết định | Mặc định thực tế |
|---|---|---|
| 1. Chọn mô hình | Chọn một mô hình được hỗ trợ và một revision chính xác | Bắt đầu với mô hình nhỏ nhất chứng minh được hợp đồng API, rồi mở rộng sau |
| 2. Chọn GPU | Xác nhận vừa đủ bộ nhớ trước khi tối ưu throughput | Dùng cùng một lớp GPU trong kiểm thử và production |
| 3. Khởi động vLLM | Expose một API tương thích OpenAI | Trước tiên dùng vllm serve, sau đó mới container hóa |
| 4. Khóa giới hạn request | Giới hạn độ dài ngữ cảnh, mức đồng thời và kích thước đầu ra | Bảo vệ GPU khỏi các prompt không có giới hạn |
| 5. Thêm auth và kiểm soát mạng | Không expose trực tiếp một GPU worker thô | Đặt một gateway, ingress hoặc private endpoint ở phía trước |
| 6. Đo đầu ra được chấp nhận | Theo dõi phản hồi thành công, độ trễ, retry và chi phí | So sánh với chi phí của API mô hình trên mỗi đầu ra được chấp nhận |
| 7. Thêm cơ chế triển khai dần | Canary, rollback và model alias theo phiên bản | Giữ code client ổn định trong khi thay đổi phần phục vụ |
Mục tiêu không phải là tự lưu trữ mọi workload. Mục tiêu là biết khi nào vLLM tự lưu trữ đáng với bề mặt vận hành.
vLLM cung cấp gì cho bạn
vLLM là một engine inference và phục vụ mã nguồn mở cho các mô hình ngôn ngữ lớn. Tài liệu của nó bao gồm phục vụ tương thích OpenAI, triển khai Docker, metrics, prefix caching, quantization, speculative decoding, song song hóa và các kiến trúc mô hình được hỗ trợ. Những thành phần đó khiến vLLM trở thành lựa chọn mặc định mạnh mẽ khi bạn muốn phục vụ các mô hình open-weight phía sau một hợp đồng API quen thuộc.
Thuộc tính hữu ích trong production là ranh giới API. Nếu ứng dụng của bạn đã gọi một client tương thích OpenAI, một endpoint vLLM có thể giảm công việc viết lại ứng dụng. Lớp phục vụ có thể thay đổi, trọng số mô hình có thể thay đổi, và máy chủ GPU có thể di chuyển, trong khi code client vẫn chỉ gửi các yêu cầu chat-completion đến một base URL.
Điều đó không loại bỏ công việc nền tảng. Nó chuyển phần khó từ tích hợp ứng dụng sang vận hành inference: cấp phát GPU, tải mô hình, batching, khả năng quan sát, giới hạn tốc độ, xử lý sự cố và quản lý chi phí.
Triển khai vLLM trên một GPU
Bắt đầu cục bộ hoặc trên một GPU cloud trước khi thêm serverless, Ray hoặc Kubernetes.
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Sau đó kiểm tra endpoint tương thích OpenAI.
curl http://localhost:8000/v1/models
Sử dụng một request chat trông giống với request mà ứng dụng của bạn thực sự sẽ gửi.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Write a three-bullet deployment checklist."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
Triển khai đầu tiên này chưa phải production. Nó trả lời bốn câu hỏi:
- Mô hình có tải được trên GPU đã chọn không?
- Client của bạn có hiểu hình dạng phản hồi không?
- Streaming, gọi tool, hoặc đầu ra có cấu trúc có hoạt động với request cụ thể của bạn không?
- Thời gian đến token đầu tiên và độ trễ end-to-end xấp xỉ là bao nhiêu?
Giữ cho bài kiểm tra đầu tiên thật đơn giản. Đừng tinh chỉnh batching, quantization, hoặc song song hóa cho đến khi endpoint cơ bản hoạt động.
Triển khai Docker cho một máy chủ GPU có thể lặp lại
Đối với một máy chủ có thể lặp lại, hãy dùng đường dẫn Docker chính thức của vLLM hoặc một image container đã cố định trong registry của riêng bạn. Các kiểm soát production quan trọng không chỉ là tag image. Chúng còn là driver stack, khả năng tương thích CUDA, cache mô hình, volume mount, cổng mạng và các cờ tiến trình.
Ví dụ:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Trước khi dùng mẫu này trong production, hãy cố định các phiên bản:
- Tag image vLLM.
- NVIDIA driver và container runtime.
- Chuỗi CUDA, nếu được quản lý riêng.
- Revision mô hình hoặc commit hash.
- Hành vi tokenizer và chat template.
- Chế độ quantization, nếu dùng.
Một hướng dẫn triển khai vLLM là chưa đầy đủ nếu chỉ nói “chạy Docker.” Runbook cũng cần hành vi khởi động lại, ghi log, khởi động sẵn bộ nhớ đệm mô hình, các probe sẵn sàng, và một đường rollback về image và phiên bản mô hình trước đó.
Làm cho endpoint tương thích OpenAI, nhưng không để không xác thực
vLLM có thể nói API tương thích OpenAI, nhưng worker vLLM thô của bạn thường không nên là ranh giới với internet công cộng. Hãy đặt một lớp phía trước nó:
- Một endpoint VPC riêng cho các dịch vụ nội bộ.
- Một API gateway với xác thực bearer-token.
- Một service mesh hoặc ingress controller với mTLS.
- Một proxy mỏng ở tầng ứng dụng thực thi bí danh mô hình, request ID và ngân sách theo từng nhóm.
- Một lớp router khi bạn cần chuyển sang các API mô hình được quản lý làm phương án dự phòng.
Hãy dùng các base URL theo từng môi trường:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
Sau đó giữ cho client của ứng dụng có thể đảo ngược:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Tóm tắt kế hoạch triển khai."}],
)
Nếu sau này bạn định tuyến một số yêu cầu sang lớp API mô hình tương thích OpenAI của Flatkey, mẫu client này vẫn hữu ích: chỉ cần đổi base URL, API key và bí danh mô hình trong khi giữ hợp đồng ứng dụng ổn định.
Các thiết lập production cần quyết định trước khi có lưu lượng
Các cờ triển khai phụ thuộc vào mô hình, GPU và workload, nhưng mọi nhóm đều nên quyết định các điều khiển này trước khi có traffic production:
| Điều khiển | Vì sao quan trọng |
|---|---|
| Độ dài mô hình tối đa | Ngăn một vài prompt dài chiếm hết bộ nhớ KV-cache |
| Số token đầu ra tối đa | Ngăn các quá trình sinh văn bản mất kiểm soát làm chiếm tài nguyên decode |
| Giới hạn đồng thời | Bảo vệ độ trễ p95 và p99 khi lưu lượng tăng đột biến |
| Timeout yêu cầu | Ngăn các yêu cầu bị treo che giấu tình trạng quá tải |
| Chính sách hàng đợi | Quyết định liệu nhu cầu vượt mức sẽ chờ, fail nhanh hay chuyển sang dự phòng |
| Bí danh mô hình | Cho phép client dùng một tên ổn định trong khi phiên bản được phục vụ thay đổi |
| Ranh giới xác thực | Ngăn một endpoint GPU đắt đỏ trở thành open proxy |
| Chính sách ghi log | Cân bằng giữa debug với yêu cầu lưu giữ dữ liệu và quyền riêng tư |
| Xuất metrics | Giúp quan sát độ trễ, lỗi, hành vi cache và throughput |
Đừng sao chép cờ của nhóm khác. Hãy sao chép phương pháp đo lường của họ.
Metrics cho các triển khai vLLM production
Theo dõi metrics ở ba lớp.
| Lớp | Metrics cần theo dõi |
|---|---|
| Lớp API | Số lượng request, tỷ lệ phản hồi được chấp nhận, tỷ lệ 4xx/5xx, tỷ lệ timeout, tỷ lệ retry |
| Lớp serving | Thời gian đến token đầu tiên, độ trễ giữa các token, độ trễ end-to-end, thời gian chờ hàng đợi, token mỗi giây |
| Lớp GPU | Mức sử dụng GPU, mức sử dụng bộ nhớ, sự kiện OOM, thời gian tải mô hình, số lần khởi động lại |
Sau đó thêm chỉ số tài chính:
chi phí trên mỗi đầu ra được chấp nhận =
  (tiền thuê GPU + lưu trữ + băng thông + retry + thời gian vận hành)
  / số phản hồi được chấp nhận vượt qua kiểm tra chất lượng
Điều này giữ cho hướng dẫn triển khai vLLM gắn với kinh tế production. Một endpoint nhanh hơn không có nghĩa là rẻ hơn nếu nó thất bại thường xuyên hơn, cần nhiều can thiệp thủ công hơn, hoặc phần lớn thời gian bị nhàn rỗi.
Để có bối cảnh chi phí rộng hơn, hãy so sánh endpoint bạn đo được với giá thuê GPU, GPU tốt nhất cho suy luận LLM, GPU cloud so với API mô hình, và TCO của cụm GPU.
Hướng dẫn triển khai vLLM serverless trên RunPod
Một hướng dẫn triển khai vLLM serverless trên RunPod có mô hình vận hành khác với một GPU VM chạy liên tục. Bạn đóng gói handler hoặc container, định nghĩa endpoint serverless, và để nền tảng tự mở rộng worker theo các request. Điều này có thể hữu ích khi lưu lượng theo đợt hoặc khi bạn muốn một bề mặt thực thi GPU được quản lý mà không phải sở hữu mọi chi tiết vòng đời của VM.
Hãy dùng RunPod Serverless khi:
- Bạn muốn thực thi GPU theo kiểu endpoint mà không phải quản lý host liên tục.
- Lưu lượng có tính đột biến, đến mức công suất GPU luôn bật sẽ bị nhàn rỗi.
- Hành vi cold start và tải mô hình là chấp nhận được với workload.
- Ứng dụng của bạn có thể chịu được mẫu request bất đồng bộ hoặc đặc thù của endpoint của nền tảng.
- Bạn có thể kiểm thử hành vi đồng thời, xếp hàng và timeout trước khi ra mắt.
Hãy cẩn thận với serverless đối với chat nhạy cảm về độ trễ. Các mô hình lớn có thể có cold-start và thời gian tải đáng kể. Hãy đo độ trễ đến token đầu tiên sau các khoảng idle, không chỉ trong một benchmark khi đã warm.
Đối với một hướng dẫn triển khai vLLM endpoint serverless trên RunPod, bài kiểm thử chấp nhận của bạn nên bao gồm:
| Kiểm tra | Vì sao nó quan trọng |
|---|---|
| Thời gian tải image container | Image lớn có thể chi phối thời gian khởi động nguội |
| Tải trọng số model hoặc gắn volume | Tải xuống lặp lại có thể xóa sạch lợi ích serverless |
| Số worker tối đa | Ngăn chi tiêu bất ngờ trong các đợt tăng đột biến |
| Timeout hàng đợi | Xác định hành vi lỗi mà người dùng nhìn thấy |
| Chính sách worker ấm | Thay đổi độ trễ và chi phí nhàn rỗi |
| Hình dạng request và response | Xác nhận các client tương thích OpenAI có thể được điều chỉnh một cách trơn tru |
Nếu truy vấn tìm kiếm chính xác của bạn là runpod serverless endpoints vllm deployment guide, hãy coi "endpoints" như một chủ đề vận hành: xây dựng endpoint, nhưng cũng cần kiểm thử khởi động nguội, mở rộng worker, giới hạn request và khả năng rollback.
Hướng dẫn triển khai Ray Serve vLLM
Một hướng dẫn triển khai Ray Serve vLLM hữu ích khi triển khai không còn chỉ là một model trên một worker. Ray Serve có thể giúp các nhóm xây dựng một ứng dụng phục vụ kết hợp nhiều deployment, mở rộng replicas và chạy trên một cụm Ray. Điều này rất giá trị khi bạn cần logic phục vụ ở cấp Python quanh model, định tuyến tùy chỉnh, ứng dụng đa model hoặc một cụm đã chuẩn hóa trên Ray.
Sử dụng Ray Serve khi:
- Bạn đã vận hành Ray cho hạ tầng ML.
- Bạn cần nhiều deployment trong một đồ thị phục vụ.
- Bạn muốn định tuyến ở cấp ứng dụng xung quanh một hoặc nhiều engine vLLM.
- Bạn cần một lộ trình từ kiểm thử cục bộ đến một cụm Ray.
- Nhóm nền tảng của bạn có thể vận hành Ray, không chỉ vLLM.
Điểm đánh đổi là bề mặt vận hành. Ray mang lại sức mạnh điều phối, nhưng cũng bổ sung vận hành cụm Ray, hành vi autoscaling, các cân nhắc về object store, logs, dashboards và một lộ trình nâng cấp khác. Với một model duy nhất phía sau một endpoint, triển khai vLLM trực tiếp có thể đơn giản hơn.
Mô hình triển khai Kubernetes
Kubernetes là lựa chọn phù hợp khi tổ chức của bạn đã vận hành các node GPU, ingress, secrets, metrics và chính sách rollout trong Kubernetes. Nó không tự động là triển khai đầu tiên phù hợp cho một nhóm nhỏ.
Danh sách kiểm tra Kubernetes:
| Hạng mục | Danh sách kiểm tra |
|---|---|
| Lập lịch GPU | Node labels, taints, resource requests, device plugin và cô lập GPU |
| Lưu trữ model | Persistent volume, đồng bộ object store hoặc chiến lược bake vào image |
| Khởi động | Làm ấm cache model và readiness probe thực tế |
| Sức khỏe | Liveness probe không được giết các lần tải model chậm nhưng vẫn khỏe |
| Rollout | Triển khai canary hoặc blue-green với khả năng rollback nhanh |
| Autoscaling | Scale theo hàng đợi, độ trễ hoặc metrics GPU, không chỉ theo CPU |
| Mạng | Mặc định chỉ nội bộ; public ingress chỉ thông qua kiểm soát xác thực |
| Khả năng quan sát | Độ trễ theo route, tỷ lệ lỗi, bộ nhớ GPU và phân bổ chi phí |
Nếu nền tảng của bạn chưa có mức độ trưởng thành Kubernetes với GPU, hãy bắt đầu với một host GPU hoặc một endpoint được quản lý trước. Kubernetes nên giảm rủi ro vận hành, chứ không biến một endpoint đơn giản thành một dự án cụm.
Kế hoạch kiểm thử tải cho một triển khai vLLM
Đừng kiểm thử tải chỉ với một prompt. Hãy tạo một bộ request đại diện.
Sử dụng ít nhất ba trace:
- Chat ngắn: prompt ngắn, đầu ra ngắn, độ đồng thời cao.
- RAG ngữ cảnh dài: prompt dài, đầu ra trung bình, template hệ thống và truy xuất lặp lại.
- Agent hoặc vòng lặp công cụ: schema lặp lại, đầu ra có cấu trúc, hủy, thử lại và ngữ cảnh nhiều lượt.
Ghi lại:
| Chỉ số | Mục tiêu |
|---|---|
| Số request được chấp nhận mỗi phút | Đo thông lượng hữu ích |
| Thời gian đến token đầu tiên p50/p95/p99 | Cho thấy độ trễ tương tác |
| Độ trễ end-to-end p50/p95/p99 | Cho thấy thời gian tác vụ mà người dùng nhìn thấy |
| Tỷ lệ lỗi và timeout | Cho thấy độ tin cậy dưới tải |
| Độ trễ đã điều chỉnh theo retry | Cho thấy trải nghiệm thực tế sau khi lỗi |
| Mức cao nhất của bộ nhớ GPU | Cho thấy dung lượng dự phòng |
| Chi phí trên mỗi đầu ra được chấp nhận | Cho thấy hiệu quả kinh tế |
Chạy hai benchmark:
- Chạy mặc định: tinh chỉnh tối thiểu, để bạn biết thời gian đến sản xuất.
- Chạy đã tinh chỉnh: batching, cache, quantization và giới hạn request đã được tinh chỉnh, để bạn biết trần hiệu năng.
Nếu lần chạy đã tinh chỉnh nhanh hơn nhưng mong manh, đừng triển khai nó làm mặc định. Hãy triển khai cấu hình mà đội on-call của bạn có thể giải thích được.
Khi nào không nên tự triển khai vLLM
Tự lưu trữ có giá trị khi bạn cần kiểm soát phần cứng, weights tùy chỉnh, vị trí dữ liệu nghiêm ngặt hoặc mức sử dụng cao, ổn định trên một workload bền vững. Nó kém hấp dẫn hơn khi lưu lượng không chắc chắn, lựa chọn model thay đổi thường xuyên, cần các model proprietary tiên tiến, hoặc nhóm không có năng lực vận hành inference.
Hãy chọn một API model được quản lý hoặc router trước khi:
- Bạn vẫn đang kiểm tra chất lượng model.
- Bạn cần thay đổi model thường xuyên.
- Lưu lượng tăng theo đợt hoặc khó dự báo.
- Khả năng dự phòng qua nhiều nhà cung cấp quan trọng hơn việc kiểm soát GPU.
- Bạn cần sổ cái sử dụng, ngân sách, hóa đơn và quản trị nhóm trước khi tinh chỉnh GPU.
Flatkey phù hợp với lớp này khi khối lượng công việc phía API cần một khóa, một số dư, một hóa đơn, bản ghi sử dụng và quyền truy cập vào các route mô hình chính thức. Nếu sau này một khối lượng công việc chứng minh đủ ổn định để phục vụ trên GPU chuyên dụng, hãy tiếp tục so sánh endpoint vLLM tự triển khai với so sánh giá mô hình AI, so sánh giá API AI, và chi phí GPU đo được của bạn trên mỗi output được chấp nhận.
Mẫu runbook triển khai
Sao chép phần này trước khi ra mắt.
Service:
  Owner:
  On-call:
  Model alias:
  Served model revision:
  vLLM version:
  Container image:
  GPU type and count:
  Base URL:

Request policy:
  Max model length:
  Max output tokens:
  Max concurrency:
  Queue timeout:
  Request timeout:
  Auth method:

Observability:
  Metrics dashboard:
  Log location:
  Trace/request ID field:
  Alert thresholds:

Rollout:
  Canary percentage:
  Rollback image:
  Rollback model revision:
  Fallback route:

Cost:
  GPU cost source:
  Storage/bandwidth assumptions:
  Accepted-output denominator:
  Weekly cost review owner:
Mẫu này quan trọng hơn một lệnh đầu tiên hoàn hảo. Một hướng dẫn triển khai vLLM không thể bàn giao cho người trực on-call thì vẫn chỉ là một nguyên mẫu.
Câu hỏi thường gặp
Có được xem là nội dung hướng dẫn triển khai vLLM nếu tôi dùng endpoint GPU được quản lý không?
Có. Nếu vLLM là engine phục vụ và bạn đang quyết định cách mở lộ, mở rộng, quan sát và bảo mật nó, thì nó vẫn thuộc về một hướng dẫn triển khai vLLM. Các chi tiết vận hành khác nhau giữa một VM thô, RunPod Serverless, Ray Serve và Kubernetes, nhưng các bài kiểm thử chấp nhận thì tương tự: hợp đồng endpoint, độ trễ, lỗi, đồng thời, rollback và chi phí trên output được chấp nhận.
Tôi nên dùng RunPod Serverless hay một VM GPU bền vững cho vLLM?
Dùng RunPod Serverless khi khả năng xử lý đột biến và vận hành endpoint được quản lý quan trọng hơn độ trễ luôn luôn ấm. Dùng một VM GPU bền vững khi bạn cần hiệu năng ấm dự đoán được, quyền kiểm soát trực tiếp máy chủ, hoặc một đường gỡ lỗi đơn giản hơn. Hãy benchmark cả hai nếu độ trễ và mức sử dụng quyết định lựa chọn.
Khi nào Ray Serve phù hợp với vLLM?
Ray Serve phù hợp khi vLLM là một phần của một ứng dụng phục vụ lớn hơn, đặc biệt nếu bạn đã vận hành Ray. Với một mô hình sau một endpoint, phục vụ vLLM trực tiếp có thể dễ vận hành hơn.
vLLM có thể thay thế OpenAI API không?
vLLM có thể cung cấp giao diện tương thích OpenAI cho các mô hình tự lưu trữ được hỗ trợ, nhưng nó không làm cho các mô hình open-weight trở nên giống hệt các API độc quyền hàng đầu. Hãy xem nó như một hợp đồng endpoint và một lựa chọn phục vụ, rồi xác thực chất lượng mô hình, độ trễ và chi phí vận hành theo khối lượng công việc của bạn.
Tôi nên đo lường gì trước tiên?
Hãy đo tỷ lệ phản hồi được chấp nhận, thời gian đến token đầu tiên, độ trễ p95 và p99, tỷ lệ timeout, áp lực bộ nhớ GPU, và chi phí trên mỗi output được chấp nhận. Số token thô mỗi giây rất hữu ích, nhưng không đủ cho các quyết định sản xuất.
Flatkey phù hợp ở đâu với vLLM?
Dùng vLLM khi bạn cần sở hữu tầng phục vụ GPU. Dùng Flatkey khi bạn muốn một lớp API mô hình tương thích OpenAI, thanh toán hợp nhất, bản ghi sử dụng và quản trị xuyên suốt các route mô hình và công cụ chính thức. Nhiều nhóm sẽ dùng cả hai: vLLM cho khối lượng công việc tự lưu trữ ổn định và Flatkey cho các mô hình tiên phong, dự phòng, thử nghiệm, và quản trị phía API.
Danh sách kiểm tra cuối cùng
Trước khi ra mắt, hướng dẫn triển khai vLLM của bạn nên tạo ra các đầu ra sau:
- Một revision mô hình và phiên bản container được ghim cố định.
- Một base URL tương thích OpenAI đã được kiểm thử.
- Ranh giới xác thực và mạng.
- Giới hạn yêu cầu cho ngữ cảnh, output, timeout và đồng thời.
- Các chỉ số cho độ trễ, lỗi, xếp hàng, thông lượng và bộ nhớ GPU.
- Một route rollback và image tốt đã biết trước đó.
- Một bảng tính chi phí trên mỗi output được chấp nhận.
- Một biên bản quyết định giải thích vì sao vLLM tự lưu trữ tốt hơn API mô hình được quản lý cho khối lượng công việc này.
Nếu những đầu ra đó tồn tại, bạn không chỉ đang chạy vLLM. Bạn đang vận hành một API LLM trên GPU.


