
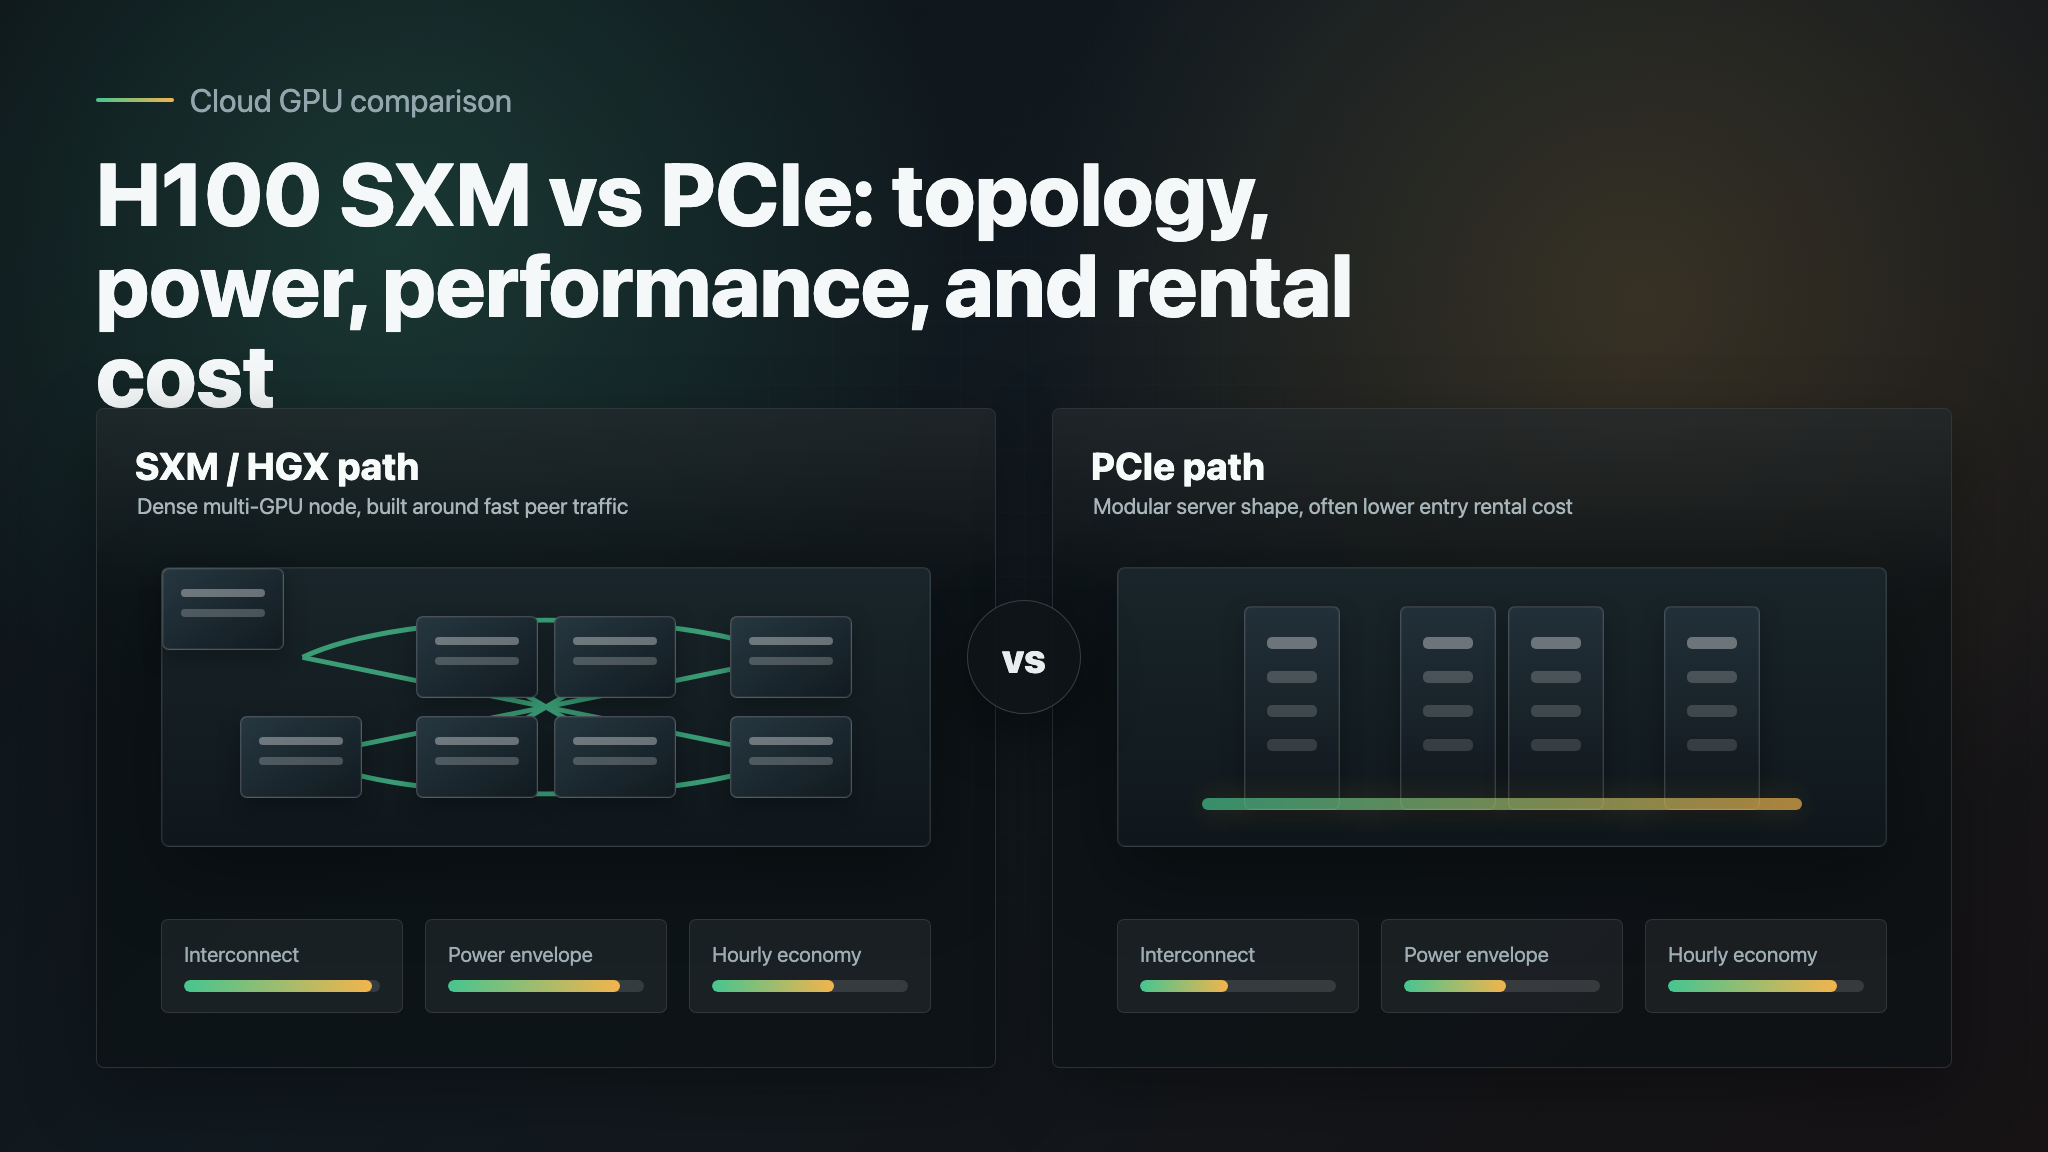
如果您正在搜索 h100 pcie vs sxm,简短答案很简单:当您的工作负载受益于高密度多 GPU 带宽、NVLink/NVSwitch 拓扑以及更高功耗上限时,选择 H100 SXM;当您需要更低的租赁成本、更方便的单 GPU 使用,或更简单的服务器形态时,选择 H100 PCIe。
更难的答案在于经济性。如果作业运行更久、在 GPU 间通信上等待更多,或者迫使您将模型过度分片,那么更便宜的 H100 PCIe 按小时计费并不一定更便宜。如果推理服务对显存要求较低、受 CPU 限制,或者大多是单 GPU 运行,那么更高价的 H100 SXM 按小时计费也不一定更好。
本指南将从 NVLink、功耗、预期性能表现和租赁成本四个方面比较 H100 SXM vs PCIe。同时也会区分普通 H100 PCIe 列表与 H100 NVL——后者是带有 NVLink 桥接支持的 PCIe 家族 NVIDIA 产品,经常与通用 H100 PCIe 租赁混淆。
H100 PCIe vs SXM 一览
| 决策点 | H100 SXM | H100 PCIe / PCIe 家族 |
|---|---|---|
| 最佳适用场景 | 多 GPU 训练、高吞吐推理、可扩展到 4-8 张 GPU 的任务 | 单 GPU 实验、更小的推理服务、更低成本的租赁、更广泛的服务器兼容性 |
| 物理形态 | HGX/DGX 风格系统中的 SXM 模块 | PCIe 双槽显卡或 PCIe 家族系统 |
| 互连特性 | 专为高带宽 GPU 间通信而设计;NVIDIA 列出的 H100 SXM NVLink 带宽为 900 GB/s | 普通 PCIe 很大程度上依赖服务器设计;NVIDIA H100 NVL 是一种带有 NVLink 桥接支持的特殊 PCIe 家族选项 |
| 功耗上限 | NVIDIA 列出的 H100 SXM 最高可配置 TDP 为 700W | NVIDIA 列出的 H100 NVL 可配置 TDP 为 350-400W;许多普通 H100 PCIe 租赁是为了更低功耗的服务器插槽而被选用 |
| 显存带宽 | NVIDIA 列出的 H100 SXM 为 3.35 TB/s | NVIDIA 列出的 H100 NVL 为 3.9 TB/s,但这并不等同于每一个通用 H100 PCIe 列表 |
| 租赁模式 | 在 2026 年 10 月 13 日的 Price of Compute 快照中,按需平均价格更高,但列出的供应商更多 | 在同一快照中,按需平均价格更低,但列出的供应商更少 |
| 买方风险 | 当工作负载并不受互连限制时,却为 SXM 买单 | 当工作负载 वास्तव需要快速的多 GPU 集合通信时,却低配成 PCIe |
对于大多数团队来说,nvidia h100 sxm vs pcie differences 归结为拓扑结构。SXM 通常更适合让多张 GPU 像一台紧密耦合的机器一样工作。PCIe 通常更适合每张 GPU 可以独立工作,或者租赁灵活性比极致集群效率更重要的场景。
快速规则
在看价格之前,先用这条规则:
| 如果您的工作负载主要是... | 优先从... | 原因 |
|---|---|---|
| 分布式训练、微调,或跨多张 GPU 的大批量推理 | H100 SXM | NVLink/NVSwitch 拓扑可以减少通信瓶颈 |
| 单 GPU 推理、嵌入向量、批处理任务、原型验证或延迟测试 | H100 PCIe | 您可能不会用到足够的互连能力来证明 SXM 的租赁溢价合理 |
| 运行一个刚好能放进单张 GPU 的大模型 | 两者都测试 | 显存、张量并行和批次形状会决定真正的赢家 |
| 时间很短、且排队时间很重要的实验 | 满足显存需求的可用租赁资源 | 等待理想的形态可能比价差更贵 |
| 不需要直接 CUDA 控制的生产推理 | 将 GPU 租赁与托管模型/API 基线对比 | 当利用率较低或波动较大时,托管 API 在运维上可能更便宜 |
如果您只是偶尔需要 H100 级别的算力,那么在预留硬件之前,先把 GPU 方案与托管模型/API 方案做比较。Flatkey 为团队提供一个 API 密钥、一个计费界面,以及对多种模型系列的 OpenAI 兼容访问;当重点并不在于直接控制 GPU 时,这通常是更简单的基线方案。
NVLink 是最重要的架构差异
NVLink 是 h100 pcie vs sxm 不只是插槽形态问题的主要原因。
NVIDIA 的公开 H100 页面列出了第四代 NVLink,提供 900 GB/s 的 GPU 到 GPU 互连带宽;其 H100 产品表也列出了 H100 SXM 采用 NVIDIA NVLink,带宽为 900 GB/s,同时 PCIe Gen5 为 128 GB/s。这就是 SXM 租户通常为之付费的拓扑:一种让多张 GPU 能以高带宽和可预测延迟通信的服务器设计。
对于分布式训练,这一点很关键,因为 all-reduce、张量并行、流水线并行以及优化器同步都可能成为瓶颈。一个在单张 GPU 上看起来是计算受限的工作负载,一旦扩展到四张或八张 GPU,可能就会变成通信受限。在这种情况下,H100 SXM vs PCIe 的问题应该通过基准测试的作业时间来回答,而不只是看每小时价格。
PCIe 则不同。它灵活、常见,也更容易适配许多服务器设计,但并不意味着每张 GPU 都自动拥有到节点内每一张其他 GPU 的密集 NVLink 连接。一些 PCIe 家族的 H100 系统确实包含桥接选项。NVIDIA 的 H100 NVL 产品明确是一种 PCIe 双槽风冷设计,支持 NVLink 桥接,并在成对配置下提供 188 GB HBM3,面向 LLM 推理。这并不意味着所有被称为“ H100 PCIe ”的云列表都具有相同的拓扑结构。
在默认接受答案之前,向租赁服务商提出这些问题:
- 这是普通的 H100 PCIe、H100 NVL、HGX H100,还是其他服务器设计?
- 节点中有多少块 GPU?
- 您租用的 GPU 之间启用了 NVLink 吗?
- 是否配备 NVSwitch?
- 在确切的节点类型上,测得的 NCCL all-reduce 带宽是多少?
- GPU 是专属于单个客户,还是通过市场调度器共享?
这些答案通常比单独看“PCIe”和“SXM”这两个词更重要。
功耗与数据中心限制
关键词 nvidia h100 sxm vs pcie power consumption 通常指向一个实际问题:您的服务商、托管机柜或私有集群能否支持相应的功耗与散热配置?
NVIDIA 将 H100 SXM 的可配置 TDP 标为最高 700W。它将 H100 NVL(采用 PCIe 双插槽风冷设计的产品)的可配置 TDP 标为 350-400W。直白地说,SXM 是为高密度加速服务器设计的,这类平台预期具备顶级 GPU 集群所需的供电、散热和板卡集成能力。PCIe 系列卡则更适合传统服务器形态。
在租赁场景中,功耗差异通常会间接体现出来:
- SXM 容量通常以内置于 HGX、DGX 或同类高密度多 GPU 系统的形式出售。
- PCIe 容量更容易在较小的节点形态和市场平台中找到。
- 对于通信密集型工作,SXM 的单任务吞吐量可能更强。
- 对于单 GPU 任务,PCIe 可能更容易获得,或入门成本更低。
不要把 TDP 当作您的计费电费来比较。云 GPU 租用者通常支付的是捆绑后的按小时价格。真正相关的经济问题是:更高功耗的 SXM 系统是否能更快完成任务,或支持足够更高的批处理吞吐量,从而降低每个已完成任务的成本。
性能:SXM 通常胜出的场景
当 GPU 需要协同工作时,SXM 通常更有优势。
例如:
- 多 GPU 预训练或继续预训练。
- 梯度频繁跨 GPU 传输的完整微调。
- 不易完整装入单块 GPU 的大模型张量并行推理。
- 吞吐量较高的服务场景,其中 batching 和通信开销决定每秒 token 数。
- 依赖高速 GPU 点对点流量的科学或 HPC 工作负载。
在这些情况下,狭义的 h100 pcie vs sxm 价格比较可能会误导您。如果一个 SXM 节点每 GPU 小时贵 30%,但能将任务时间缩短 40%,那么按已完成运行计算的有效成本仍可能更低。如果它贵 60%,而您的任务只获得 5% 的提升,那么 PCIe 才是更好的选择。
因此,生产决策应使用工作负载级指标:
| 工作负载 | 比按小时价格更好的指标 |
|---|---|
| 微调 | 每次成功训练运行的成本 |
| 批量推理 | 每百万个接受的 token 或输出的成本 |
| 实时推理 | 在目标延迟下每个已服务请求的成本 |
| Embedding | 每百万个生成向量的成本 |
| 评测框架 | 每个完成的基准测试套件的成本 |
如需更广泛的 GPU 选择权衡,请参阅 Flatkey 关于 H100 vs A100、H200 vs H100 以及 LLM 推理最佳 GPU 的指南。
性能:PCIe 何时已经足够
当工作负载不需要密集的 GPU 间通信时,H100 PCIe 往往是更好的起点。
例如:
- 适合单卡内存的模型进行单 GPU 推理。
- Embedding 生成,其中每块 GPU 都可以处理独立批次。
- 数据预处理、评测或离线批量打分。
- 在扩展规模之前进行早期微调实验。
- 对成本敏感、比起总耗时更关注每小时支出的任务。
这是 H100 SXM vs PCIe 选购中最常见的错误:团队租用了最高端的 SXM 系统,因为它看起来更稳妥,结果却运行了几乎用不到所付拓扑优势的工作负载。
如果您的工作负载可以拆分为独立单元,就先从 PCIe 开始。只有当性能分析显示 GPU 通信、模型切分或多 GPU 利用率正在限制吞吐时,再迁移到 SXM。
租赁成本:2026 年 10 月快照
租赁市场变化很快,因此请把任何 nvidia h100 sxm vs pcie price difference 都视为某一时点快照,而不是永久真理。
在 2026 年 10 月 13 日检查的 Price of Compute API 快照显示:
| SKU | 按需平均价 | 平均价中的提供商数量 | Spot 平均价 | Spot 平均价中的提供商数量 | 快照中观察到的最低挂牌价 |
|---|---|---|---|---|---|
| H100 SXM | $4.0185 / GPU-hour | 8 | $2.157633 / GPU-hour | 3 | Vast 上按需 $1.733333 / GPU-hour |
| H100 PCIe | $2.945 / GPU-hour | 2 | API 响应中没有汇总的 spot 平均价 | n/a | ZA 地区 Vast 上 spot $0.666667 / GPU-hour |
该快照表明,PCIe 的按需平均价更低,而 SXM 的已列出服务商覆盖更广。服务商列表也说明了为什么不能只看平均值来决策:地区、市场供给、spot 中断风险、最低租赁规模、存储、出站流量费用以及支持级别都可能主导最终成本。
如需更多租赁市场背景,请使用 Flatkey 的 GPU 租赁价格指南、GPU 云对比 和 GPU 云隐藏成本。
如何正确比较 H100 SXM 与 PCIe 的成本
不要只看小时单价,而要使用下面这个公式:
有效成本 =
  GPU 小时价格
  x 使用的 GPU 数量
  x 实际运行小时数
  + 存储
  + 数据传输
  + 空闲的配置/调试时间
  + 重试或中断成本
然后按业务产出来归一化:
每个已接受输出的成本 =
  有效成本 / 已接受输出数量
对于训练,已接受输出可能是一个通过评估的 checkpoint。对于推理,它可能是一百万个可用 token、图像、视频片段、embedding 或请求。之所以重要,是因为当你衡量的是已接受输出而不是原始 GPU 小时数时,h100 sxm vs pcie price 可能会反转。
示例决策逻辑:
| 场景 | 需要测试什么 | 可能结果 |
|---|---|---|
| 一个 70B 模型、单 GPU、中等 batch size | PCIe 小时价格、延迟、显存余量 | PCIe 可能更优 |
| 跨多 GPU 切分的 70B+ 模型 | NCCL 带宽、tokens/sec、尾延迟 | SXM 可能更优 |
| 需要频繁同步的微调 | 单步时间和总运行时间 | SXM 往往值得测试 |
| 在大语料上做 embedding | GPU 利用率和队列开销 | PCIe 可能已经足够 |
| 短期概念验证 | 配置时间和可用性 | 最便宜的可用 H100 可能更优 |
| 不需要直接控制 GPU 的生产 API | 模型/API 定价和运维开销 | 托管 API 路线可能优于任一租赁方式 |
最后一行就是 Flatkey 应该进入决策的位置。如果你的团队想要的是模型输出,而不是 GPU 所有权,那么就把直接 GPU 租赁和 API 基线进行比较。Flatkey 帮助团队通过一个密钥和一个计费入口路由到众多模型,减少管理多个供应商账户的运维开销。
采购清单
在租用或预留 H100 容量之前,先问:
- 列表里的是 H100 SXM、普通 H100 PCIe、H100 NVL,还是 HGX H100?
- 每个节点里有多少块 GPU?
- 具体的租赁形态是否暴露 NVLink?如果是,拓扑是什么?
- 是否有 NVSwitch?
- 包含哪些 CPU、RAM、本地 NVMe 和网络?
- 价格是按需、预留、spot、市场还是促销?
- 是否包含存储、快照、公网 IP、支持和 egress?
- 在正式签约前,能否运行 NCCL 和工作负载级基准测试?
- 如果 spot 容量被回收或节点故障,会发生什么?
- 托管模型/API 路线是否能以更少的运维工作满足同样的产品需求?
对于集群级经济性,请使用 Flatkey 的 GPU 集群 TCO 指南 和 GPU 云与模型 API 对比。
推荐的基准测试方案
在签署更长期的预留之前,先在 H100 PCIe 和 H100 SXM 上运行相同测试。
- 从生产中将要使用的精确框架开始,例如 vLLM、SGLang、PyTorch FSDP、DeepSpeed 或 TensorRT-LLM。
- 记录 GPU 利用率、显存利用率、每秒 token 数、单步时间、尾延迟,以及失败/重试作业。
- 如果任务跨多个 GPU,运行如 NCCL tests 之类的通信基准测试。
- 测试真实的 batch size,而不只是合成的最大值。
- 把配置时间、数据准备时间和空闲调试时间计入成本。
- 比较每个已接受输出的成本,而不仅仅是 GPU-小时价格。
- 如果产品不需要直接的 CUDA 控制,请保留模型/API 基线。
这套基准测试方案对于 nvidia h100 sxm vs pcie differences 尤其重要,因为性能差距取决于工作负载。同样的 SXM 系统,对一个多 GPU 训练任务来说可能非常出色,但对一个独立的批量推理队列来说可能又过于强大。
应该选择哪一种?
如果符合以下情况,选择 H100 SXM:
- 你的工作负载跨多个 GPU,且通信开销明显。
- 你需要带有高 GPU 间带宽的 HGX/DGX 风格系统。
- 训练单步时间或多 GPU 推理吞吐量比最低小时价格更重要。
- 你能让 GPU 保持足够高的利用率,以证明溢价合理。
如果符合以下情况,选择 H100 PCIe:
- 你在运行单 GPU 推理、实验或批处理作业。
- 你需要更低的入门成本或更灵活的服务器形态。
- 你的工作负载是通过独立作业并行,而不是通过紧耦合 GPU 并行。
- 你想先验证需求,再为密集的 SXM 容量付费。
如果符合以下情况,选择模型/API 路线:
- 你的产品需要的是输出,而不是底层 GPU 访问。
- 利用率呈突发性或不可预测。
- 你不想在多个 GPU 云之间管理容量、驱动、队列、checkpoint 和计费。
- 你已经需要通过一个统一集成层来使用 GPT、Claude、Gemini、开源权重、图像或视频模型。
对于 h100 pcie vs sxm,实用的答案不是“XMX 永远更快”或“PCIe 永远更便宜”。正确答案是:为你的确切工作负载做基准测试,按已接受输出归一化,并采用满足产品需求的最简单基础设施路径。
常见问题
H100 SXM 比 H100 PCIe 更快吗?
通常是的,尤其对于能从密集 NVLink/NVSwitch 拓扑以及更高 SXM 功率上限中受益的多 GPU 工作负载。但单 GPU 或松耦合工作负载可能得不到足够收益,无法证明更高的租赁成本合理。
H100 SXM 与 PCIe 的主要区别是什么?
主要区别在于围绕 GPU 的系统设计。H100 SXM 面向高密度加速服务器构建,具备更高的 GPU 间带宽。H100 PCIe 是卡式外形,更适合传统服务器设计;某些 PCIe 系列产品,例如 H100 NVL,会增加对 NVLink 桥接的支持,但通用的 PCIe 列表应加以核实。
每个 H100 PCIe 租赁都包含 NVLink 吗?
不。不要假设每个 H100 PCIe 列表都暴露 NVLink 或 NVSwitch。请向提供商询问确切的节点拓扑,并且对于多 GPU 任务,在租赁实例上运行 NCCL 测试。
为什么 H100 SXM 的租赁更贵?
SXM 容量通常作为更密集、更高功耗系统的一部分出售,这些系统具有更强的 GPU 间互连和集群集成。租赁价格还取决于提供商、地区、容量压力、预留条款、支持,以及该列表是按需还是现货。
H100 PCIe 适合 LLM 推理吗?
可以,当模型能放入显存且服务不需要大量多 GPU 通信时,H100 PCIe 适合做 LLM 推理。对于分片大模型推理或单节点最大吞吐量,H100 SXM 值得做基准测试。
我应该如何比较 H100 SXM 与 PCIe 的租赁成本?
比较每个完成任务的成本,或每个已接受输出的成本。把 GPU 小时数、GPU 数量、任务时长、存储、传输、空闲调试、中断和支持都考虑进去。仅看每小时价格无法体现真正的 h100 sxm vs pcie price 权衡。
什么时候我应该跳过 GPU 租赁而使用 API?
当你不需要直接的 CUDA 控制、自定义内核、私有模型权重或完整的集群所有权时,可以使用 API 作为基线。如果工作负载是突发性的,或者团队主要需要模型响应,那么 Flatkey 的统一 API 路径可能比直接租赁并运营 H100 容量更简单。


