
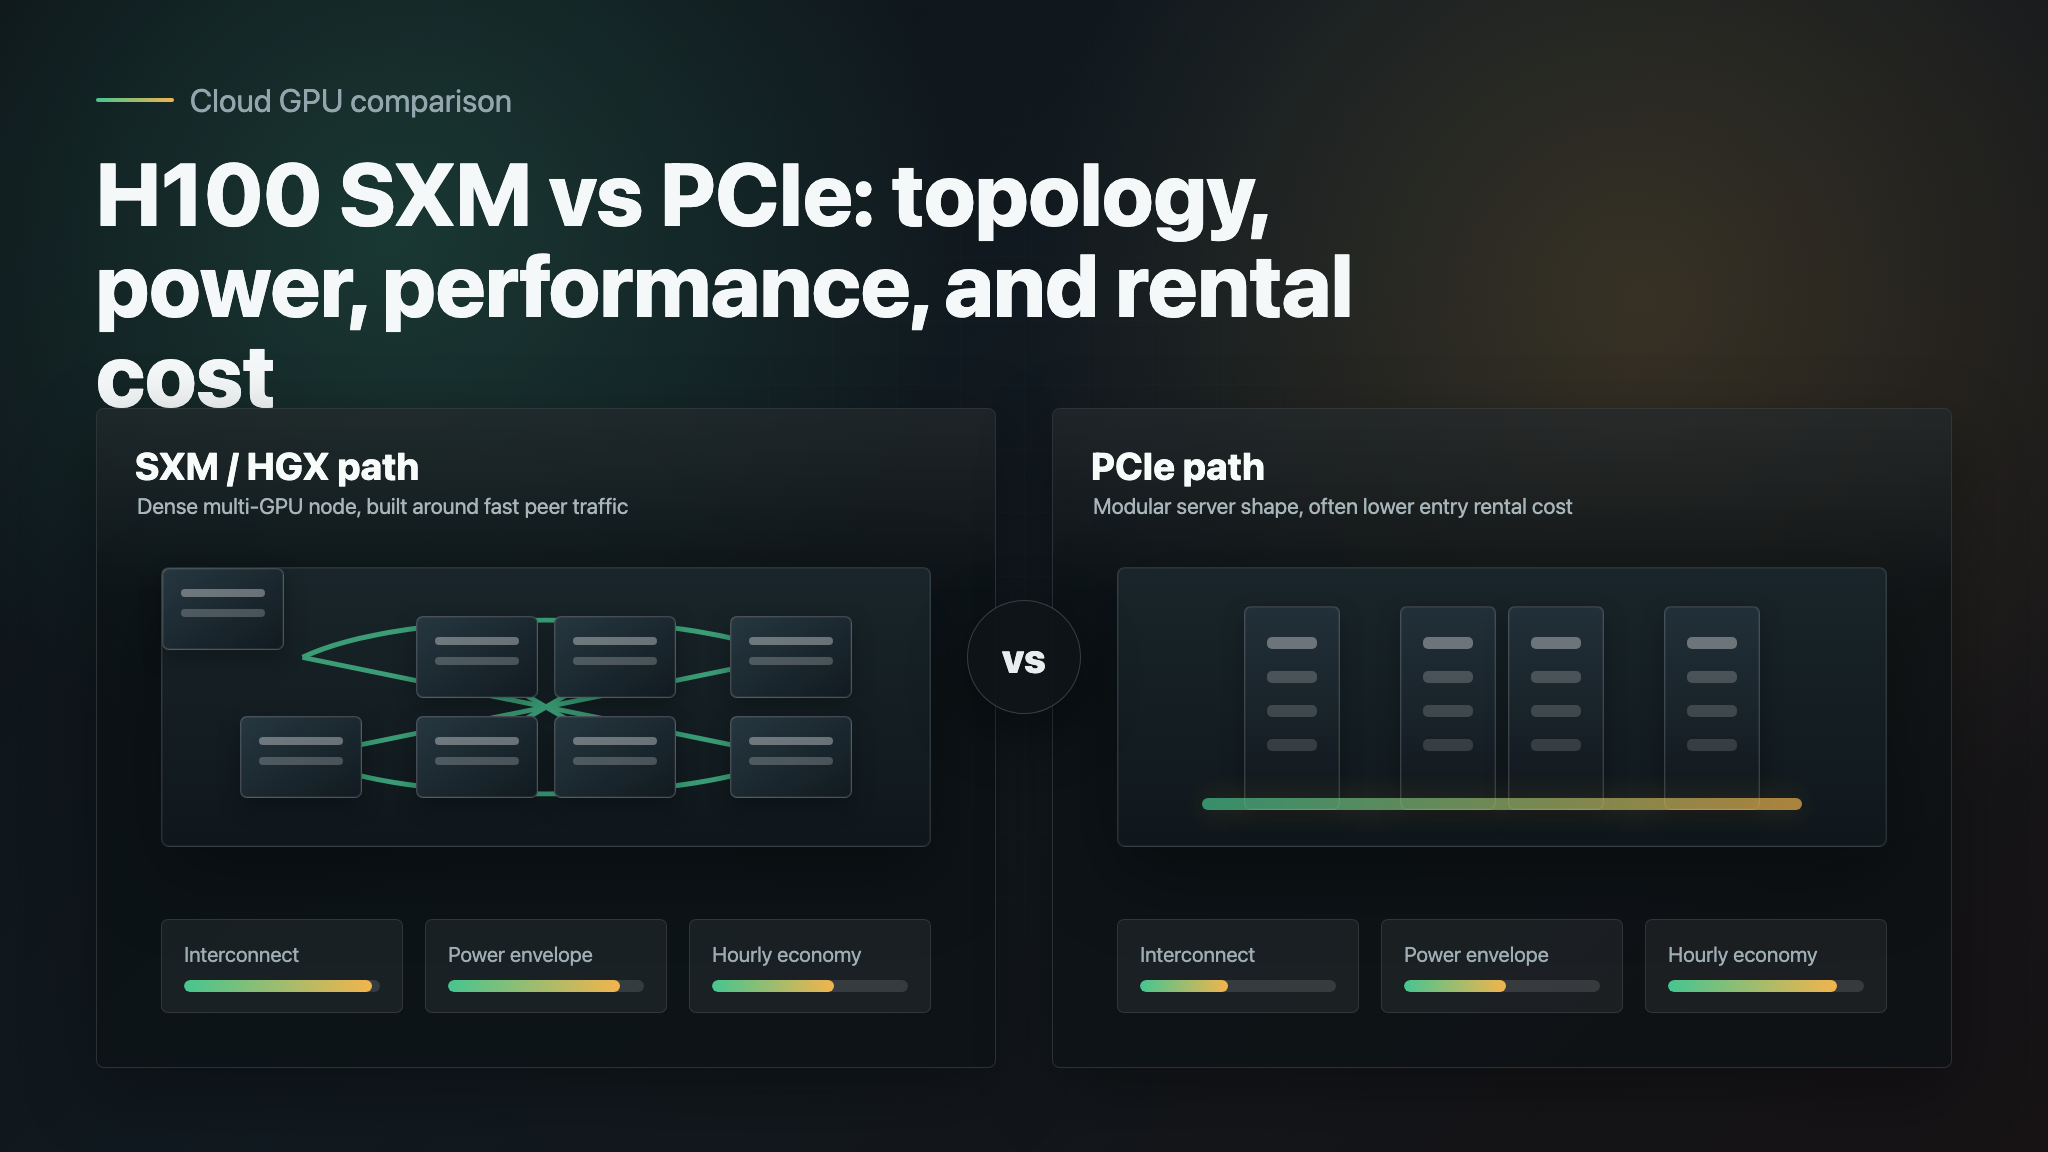
Если вы ищете h100 pcie vs sxm, короткий ответ прост: выбирайте H100 SXM, когда вашей нагрузке полезны плотная многопроцессорная пропускная способность, топология NVLink/NVSwitch и более высокий энергетический бюджет; выбирайте H100 PCIe, когда вам нужна более низкая стоимость аренды, более простой доступ к одной GPU или более простой форм-фактор сервера.
Более сложный ответ — экономический. Более дешёвый час H100 PCIe не обязательно оказывается дешевле, если задача выполняется дольше, больше времени тратится на ожидание межGPU-коммуникации или приходится чрезмерно шардировать модель. Более дорогой час H100 SXM не обязательно лучше, если ваш inference-сервис мало использует память, упирается в CPU или в основном работает на одной GPU.
Это руководство сравнивает H100 SXM vs PCIe по NVLink, энергопотреблению, ожидаемому поведению производительности и стоимости аренды. Оно также отделяет обычные листинги H100 PCIe от H100 NVL — продукта NVIDIA семейства PCIe с поддержкой NVLink bridge, который часто путают с обычной арендой H100 PCIe.
H100 PCIe vs SXM в сравнении
| Критерий выбора | H100 SXM | H100 PCIe / семейство PCIe |
|---|---|---|
| Лучший сценарий | Многопроцессорное обучение, высокопроизводительный inference, задачи, масштабируемые на 4-8 GPU | Эксперименты на одной GPU, небольшие inference-сервисы, более дешёвая аренда, более широкая совместимость с серверами |
| Форм-фактор | Модуль SXM в системах типа HGX/DGX | Платы PCIe с двумя слотами или системы семейства PCIe |
| История межсоединения | Создан для высокоскоростной GPU-to-GPU коммуникации; NVIDIA указывает 900 GB/s NVLink на H100 SXM | Обычный PCIe сильно зависит от конструкции сервера; NVIDIA H100 NVL — это специальный вариант семейства PCIe с поддержкой NVLink bridge |
| Энергетический бюджет | NVIDIA указывает H100 SXM с настраиваемым TDP до 700W | NVIDIA указывает H100 NVL с настраиваемым TDP 350-400W; многие обычные аренды H100 PCIe выбирают ради серверных слотов с более низким энергопотреблением |
| Пропускная способность памяти | NVIDIA указывает H100 SXM на уровне 3.35 TB/s | NVIDIA указывает H100 NVL на уровне 3.9 TB/s, но это не то же самое, что любой типичный листинг H100 PCIe |
| Паттерн аренды | Более высокая средняя цена on-demand в снимке Price of Compute от 13 октября 2026 года, но больше доступных провайдеров | Более низкая средняя цена on-demand в том же снимке, но меньше доступных провайдеров |
| Риск для покупателя | Платить за SXM, когда нагрузка не упирается в межсоединение | Недобрать PCIe, когда нагрузке действительно нужны быстрые коллективные операции между GPU |
Для большинства команд nvidia h100 sxm vs pcie differences сводятся к топологии. SXM обычно лучше подходит, когда GPU должны вести себя как одна тесно связанная машина. PCIe обычно лучше подходит, когда каждая GPU может работать независимо или когда гибкость аренды важнее максимальной эффективности кластера.
Краткое правило
Используйте это правило, прежде чем смотреть на цену:
| Если ваша нагрузка в основном... | Начните с... | Почему |
|---|---|---|
| Распределённое обучение, fine-tuning или крупнопакетный inference на многих GPU | H100 SXM | Топология NVLink/NVSwitch может снизить узкие места коммуникации |
| Inference на одной GPU, embeddings, batch-задачи, прототипы или тесты задержки | H100 PCIe | Возможно, вы не используете межсоединение настолько, чтобы оправдать премию за аренду SXM |
| Подача одной большой модели, которая едва помещается на одной GPU | Проверьте оба варианта | Память, tensor parallelism и форма batch определяют реального победителя |
| Короткие эксперименты, где важна очередь | Доступная аренда, которая соответствует требованиям по памяти | Ожидание идеального форм-фактора может обойтись дороже, чем разница в цене |
| Production inference без необходимости прямого управления CUDA | Сравните аренду GPU с базовой моделью/API | Управляемые API могут быть дешевле в эксплуатации при низкой или скачкообразной загрузке |
Если вам лишь время от времени нужна мощность уровня H100, сравните путь через GPU с управляемым model/API-подходом, прежде чем резервировать оборудование. Flatkey даёт командам один API-ключ, один контур биллинга и совместимый с OpenAI доступ ко многим семействам моделей, что часто является более простым базовым вариантом, когда прямое управление GPU не является целью.
NVLink — главное архитектурное различие
NVLink — основная причина, почему h100 pcie vs sxm — это не просто вопрос форм-фактора слота.
На публичной странице H100 NVIDIA указано NVLink четвёртого поколения с пропускной способностью GPU-to-GPU interconnect 900 GB/s для H100, а в таблице продуктов H100 указано, что H100 SXM с NVIDIA NVLink обеспечивает 900 GB/s плюс PCIe Gen5 на 128 GB/s. Именно за такую топологию обычно и платят арендаторы SXM: за серверную конструкцию, в которой несколько GPU могут обмениваться данными с высокой пропускной способностью и предсказуемой задержкой.
Для распределённого обучения это важно, потому что all-reduce, tensor parallelism, pipeline parallelism и синхронизация оптимизатора могут стать узким местом. Нагрузка, которая выглядит compute-bound на одной GPU, может стать communication-bound, когда она масштабируется на четыре или восемь GPU. В таком случае на вопрос H100 SXM vs PCIe следует отвечать на основе измеренного времени выполнения задачи, а не только по почасовой цене.
PCIe — это другое. Он гибкий, распространённый и проще вписывается во многие серверные конфигурации, но это не означает, что каждая GPU автоматически имеет плотную NVLink-связность с каждой другой GPU в узле. Некоторые системы H100 семейства PCIe действительно включают bridge-опции. Продукт NVIDIA H100 NVL — это специально PCIe dual-slot air-cooled design с поддержкой NVLink bridge и 188 GB HBM3 в paired configuration для LLM inference. Это не означает, что каждый облачный листинг с названием "H100 PCIe" имеет такую же топологию.
Задайте провайдерам аренды эти вопросы, прежде чем считать, что ответ уже известен:
- Это обычный H100 PCIe, H100 NVL, HGX H100 или другая серверная конфигурация?
- Сколько GPU в узле?
- Включён ли NVLink между арендованными вами GPU?
- Присутствует ли NVSwitch?
- Какова измеренная пропускная способность NCCL all-reduce для точно такого типа узла?
- Выделены ли GPU одному клиенту или они используются совместно через маркетплейс-планировщик?
Обычно эти ответы важнее, чем сами по себе слова "PCIe" и "SXM".
Потребление энергии и ограничения дата-центра
Ключевая фраза nvidia h100 sxm vs pcie power consumption обычно указывает на практический вопрос: может ли ваш провайдер, стойка в colo или частный кластер обеспечить нужный профиль питания и охлаждения?
NVIDIA указывает H100 SXM с configurable TDP до 700W. Для H100 NVL, PCIe-устройства с двухслотовым воздушным охлаждением, указаны 350-400W configurable TDP. Проще говоря, SXM рассчитан на высокоплотные ускоренные серверы, где платформа предполагает питание, охлаждение и интеграцию на плате, необходимые для топовых GPU-кластеров. Карты семейства PCIe лучше подходят для более традиционного форм-фактора серверов.
При аренде разница в энергопотреблении проявляется косвенно:
- Вместимость SXM часто продаётся внутри систем HGX, DGX или аналогичных плотных многопроцессорных конфигураций.
- Вместимость PCIe проще найти в более компактных узлах и на маркетплейсах.
- SXM может обеспечивать более высокую пропускную способность на задачу для нагрузок, чувствительных к коммуникациям.
- PCIe может быть доступнее или иметь более низкий порог входа для задач на одном GPU.
Не сравнивайте TDP так, как будто это ваш счёт за электричество. Обычно арендаторы облачных GPU платят комбинированную почасовую цену. Важный экономический вопрос — достаточно ли более мощная система SXM завершает работу быстрее или поддерживает достаточную более высокую batch-пропускную способность, чтобы снизить стоимость одной завершённой задачи.
Производительность: где SXM обычно выигрывает
SXM обычно выигрывает, когда GPU нужно координировать между собой.
Примеры:
- Много-GPU pretraining или continued pretraining.
- Полный fine-tuning, при котором градиенты часто перемещаются между GPU.
- Tensor-parallel inference для больших моделей, которые не помещаются на одном GPU без разбиения.
- Высокопроизводительное обслуживание, где batching и накладные расходы на коммуникации определяют tokens per second.
- Научные или HPC-нагрузки, зависящие от быстрого GPU-трафика peer-to-peer.
В этих случаях узкое сравнение цен h100 pcie vs sxm может ввести в заблуждение. Если узел SXM стоит на 30% дороже в пересчёте на GPU-hour, но сокращает время задачи на 40%, эффективная стоимость одного завершённого запуска всё равно может быть ниже. Если он на 60% дороже, а ваша задача даёт лишь 5% выигрыша, PCIe будет лучшим выбором.
Именно поэтому производственное решение следует принимать на основе метрики уровня нагрузки:
| Нагрузка | Лучшая метрика вместо почасовой цены |
|---|---|
| Fine-tuning | Стоимость одного успешного training run |
| Batch inference | Стоимость за миллион принятых токенов или выходов |
| Realtime inference | Стоимость одного обслуженного запроса при целевой задержке |
| Embeddings | Стоимость за миллион сгенерированных векторов |
| Evaluation harnesses | Стоимость одного завершённого набора бенчмарков |
Для более широкого выбора между GPU см. руководства Flatkey: H100 vs A100, H200 vs H100 и лучший GPU для LLM inference.
Производительность: когда PCIe может быть достаточно
H100 PCIe может быть лучшей отправной точкой, когда нагрузке не требуется плотная коммуникация между GPU.
Примеры:
- Одно-GPU inference для моделей, которые помещаются в память.
- Генерация embeddings, где каждый GPU может обрабатывать независимые пакеты.
- Предобработка данных, оценка или офлайн batch scoring.
- Ранние эксперименты по fine-tuning перед масштабированием.
- Задачи, чувствительные к стоимости, где важнее не wall-clock time, а почасовые расходы.
Это самая распространённая ошибка при выборе между H100 SXM vs PCIe: команды арендуют топовую систему SXM, потому что она кажется безопаснее, а затем запускают нагрузки, которые едва используют топологию, за которую они заплатили.
Начинайте с PCIe, если вашу нагрузку можно разбить на независимые единицы. Переходите на SXM, когда профилирование показывает, что коммуникации между GPU, model sharding или использование нескольких GPU ограничивают throughput.
Стоимость аренды: снимок за октябрь 2026
Рынки аренды быстро меняются, поэтому относитесь к любому nvidia h100 sxm vs pcie price difference как к устаревающему снимку, а не к постоянной истине.
Снимок из API Price of Compute, проверенный 13 октября 2026 года, показал:
| SKU | Среднее on-demand | Провайдеров в среднем | Среднее spot | Провайдеров в среднем spot | Самая низкая наблюдаемая цена из снимка |
|---|---|---|---|---|---|
| H100 SXM | $4.0185 / GPU-hour | 8 | $2.157633 / GPU-hour | 3 | $1.733333 / GPU-hour on-demand на Vast |
| H100 PCIe | $2.945 / GPU-hour | 2 | Нет агрегированного среднего spot в ответе API | n/a | $0.666667 / GPU-hour spot на Vast в ZA |
Этот снимок показывает, что у PCIe средняя on-demand цена была ниже, а у SXM — более широкое покрытие провайдеров в списке. Список провайдеров также показывает, почему нельзя принимать решение только по средним значениям: регион, предложение на маркетплейсе, риск interruption у spot, минимальный размер аренды, хранилище, egress и уровень поддержки могут определять итоговую стоимость.
Для дополнительного контекста по рынку аренды используйте руководство по ценам на аренду GPU, сравнение GPU cloud и скрытые расходы GPU cloud.
Как правильно сравнивать стоимость H100 SXM и PCIe
Используйте эту формулу вместо того, чтобы останавливаться на почасовой цене:
эффективная стоимость =
  почасовая цена GPU
  x используемые GPU
  x часы реального времени
  + хранилище
  + передача данных
  + простои на настройку/отладку
  + стоимость повторных запусков или сбоев
Затем нормализуйте по бизнес-результату:
стоимость за принятый результат =
  эффективная стоимость / принятые результаты
Для обучения принятым результатом может быть один checkpoint, прошедший оценку. Для инференса это могут быть один миллион пригодных токенов, изображений, клипов, эмбеддингов или запросов. Это важно, потому что цена h100 sxm vs pcie может измениться, если измерять принятый результат, а не сырые GPU-часы.
Пример логики принятия решения:
| Сценарий | Что тестировать | Вероятный результат |
|---|---|---|
| Одна модель 70B, один GPU, умеренный размер batch | Почасовая цена PCIe, задержка, запас по памяти | PCIe может выиграть |
| Модель 70B+ с шардингом по нескольким GPU | Пропускная способность NCCL, токенов/с, хвостовая задержка | SXM может выиграть |
| Дообучение с частой синхронизацией | Время шага и общее время выполнения | SXM часто заслуживает теста |
| Эмбеддинги по большому корпусу | Загрузка GPU и накладные расходы очереди | PCIe может быть достаточно |
| Краткий proof of concept | Время настройки и доступность | Может выиграть самый дешевый доступный H100 |
| Production API, где прямой контроль GPU не требуется | Ценообразование модели/API и операционные накладные расходы | Управляемый API может оказаться лучше любого варианта аренды |
Последняя строка — это то место, где в решение вписывается Flatkey. Если вашей команде нужен результат модели, а не владение GPU, сравнивайте прямую аренду GPU с базовым вариантом API. Flatkey помогает командам работать с множеством моделей через один ключ и одну систему биллинга, снижая операционные накладные расходы на управление отдельными аккаунтами провайдеров.
Чек-лист закупки
Перед арендой или резервированием мощности H100 спросите:
- Это H100 SXM, обычный H100 PCIe, H100 NVL или HGX H100?
- Сколько GPU в каждом узле?
- Показывает ли точная конфигурация аренды NVLink? Если да, то какая топология?
- Есть ли NVSwitch?
- Какие CPU, RAM, локальный NVMe и сеть включены?
- Цена по требованию, зарезервированная, spot, на маркетплейсе или промо?
- Включены ли хранилище, snapshots, публичные IP, поддержка и egress?
- Можно ли запустить NCCL и бенчмарки на уровне workload до принятия обязательств?
- Что происходит, если spot-мощность будет изъята или узел выйдет из строя?
- Подойдет ли управляемый маршрут модели/API для той же продуктовой задачи с меньшими операционными затратами?
Для экономики на уровне кластера используйте руководство Flatkey по TCO GPU-кластера и сравнение GPU cloud и model API.
Рекомендуемый план бенчмарка
Запустите один и тот же тест на H100 PCIe и H100 SXM, прежде чем подписывать более длительную аренду.
- Начните с того же фреймворка, который будете использовать в production, например vLLM, SGLang, PyTorch FSDP, DeepSpeed или TensorRT-LLM.
- Запишите загрузку GPU, использование памяти, токены в секунду, время шага, хвостовую задержку и упавшие/повторно запущенные задания.
- Запустите коммуникационный бенчмарк, например тесты NCCL, если задача распределяется по нескольким GPU.
- Тестируйте реалистичные размеры batch, а не только синтетические максимумы.
- Включите в стоимость время настройки, подготовку данных и простои на отладку.
- Сравнивайте стоимость за принятый результат, а не только почасовую цену GPU.
- Сохраните базовый вариант с моделью/API, если продукт не требует прямого контроля CUDA.
Этот план бенчмарка особенно важен для различий nvidia h100 sxm vs pcie, потому что разрыв в производительности зависит от типа workload. Та же система SXM, которая отлично подходит для одной задачи обучения на нескольких GPU, может быть избыточной для независимой очереди batch-инференса.
Что выбрать?
Выбирайте H100 SXM, если:
- Ваш workload распределен по нескольким GPU, и накладные расходы на коммуникацию заметны.
- Вам нужна система в стиле HGX/DGX с высокой пропускной способностью GPU-to-GPU.
- Время шага обучения или throughput много-GPU инференса важнее самой низкой почасовой цены.
- Вы можете загружать GPU достаточно, чтобы оправдать премию.
Выбирайте H100 PCIe, если:
- Вы запускаете одно-GPU инференс, эксперименты или batch-задачи.
- Вам нужен более низкий порог входа или более гибкие формы серверов.
- Ваш workload распараллеливается на независимые задания, а не на тесно связанные GPU.
- Вы хотите подтвердить спрос, прежде чем платить за плотную SXM-мощность.
Выбирайте маршрут model/API, если:
- Вашему продукту нужны результаты, а не низкоуровневый доступ к GPU.
- Нагрузка приходит рывками или непредсказуема.
- Вы не хотите управлять мощностями, драйверами, очередями, checkpoint'ами и биллингом в разных GPU-cloud.
- Вам уже нужны GPT, Claude, Gemini, open-weight, image или video модели через одну точку интеграции.
Практический ответ на h100 pcie vs sxm — не «SXM всегда быстрее» и не «PCIe всегда дешевле». Правильный ответ таков: протестируйте именно ваш workload, нормализуйте по принятому результату и используйте самый простой инфраструктурный путь, который соответствует требованиям продукта.
Часто задаваемые вопросы
H100 SXM быстрее, чем H100 PCIe?
Часто да — для multi-GPU workloads, которым помогает плотная топология NVLink/NVSwitch и более высокий power envelope SXM. Но одно-GPU или слабо параллелизуемые workload'ы могут не дать достаточного выигрыша, чтобы оправдать дополнительную стоимость аренды.
В чем основное различие между H100 SXM и PCIe?
Основное различие — это системная архитектура вокруг GPU. H100 SXM создан для плотных ускоренных серверов с высокой пропускной способностью между GPU. H100 PCIe — это форм-фактор на базе карты, который подходит для более традиционных серверных конфигураций; некоторые продукты семейства PCIe, такие как H100 NVL, добавляют поддержку мостика NVLink, но для обычных PCIe-объявлений это следует проверять.
Включает ли каждая аренда H100 PCIe NVLink?
Нет. Не следует предполагать, что каждое объявление H100 PCIe предоставляет NVLink или NVSwitch. Попросите у провайдера точную топологию узла и для многогPU-задач запустите тесты NCCL на выбранной конфигурации аренды.
Почему аренда H100 SXM дороже?
Емкость SXM обычно продаётся как часть более плотных, более мощных систем с более сильной межсоединительной связью GPU-to-GPU и интеграцией в кластер. Цена аренды также зависит от провайдера, региона, дефицита мощности, условий резервации, поддержки и от того, является ли предложение on-demand или spot.
Подходит ли H100 PCIe для инференса LLM?
Да, H100 PCIe может хорошо подходить для инференса LLM, когда модель помещается в память и сервису не требуется интенсивная межGPU-коммуникация. Для распределённого инференса больших моделей или максимальной пропускной способности на узел H100 SXM заслуживает бенчмарка.
Как сравнивать стоимость аренды H100 SXM и PCIe?
Сравнивайте стоимость за завершённую задачу или стоимость за принятый результат. Учитывайте часы GPU, количество GPU, время выполнения задачи, хранение, передачу данных, простой на отладку, прерывания и поддержку. Почасовая цена сама по себе не отражает реальный компромисс h100 sxm vs pcie price.
Когда стоит отказаться от аренды GPU и использовать API?
Используйте базовый вариант через API, когда вам не нужен прямой контроль CUDA, пользовательские ядра, приватные веса модели или полное владение кластером. Если нагрузка носит всплесковый характер или команде в основном нужны ответы модели, единый API-путь Flatkey может быть проще, чем напрямую арендовать и эксплуатировать мощности H100.


