
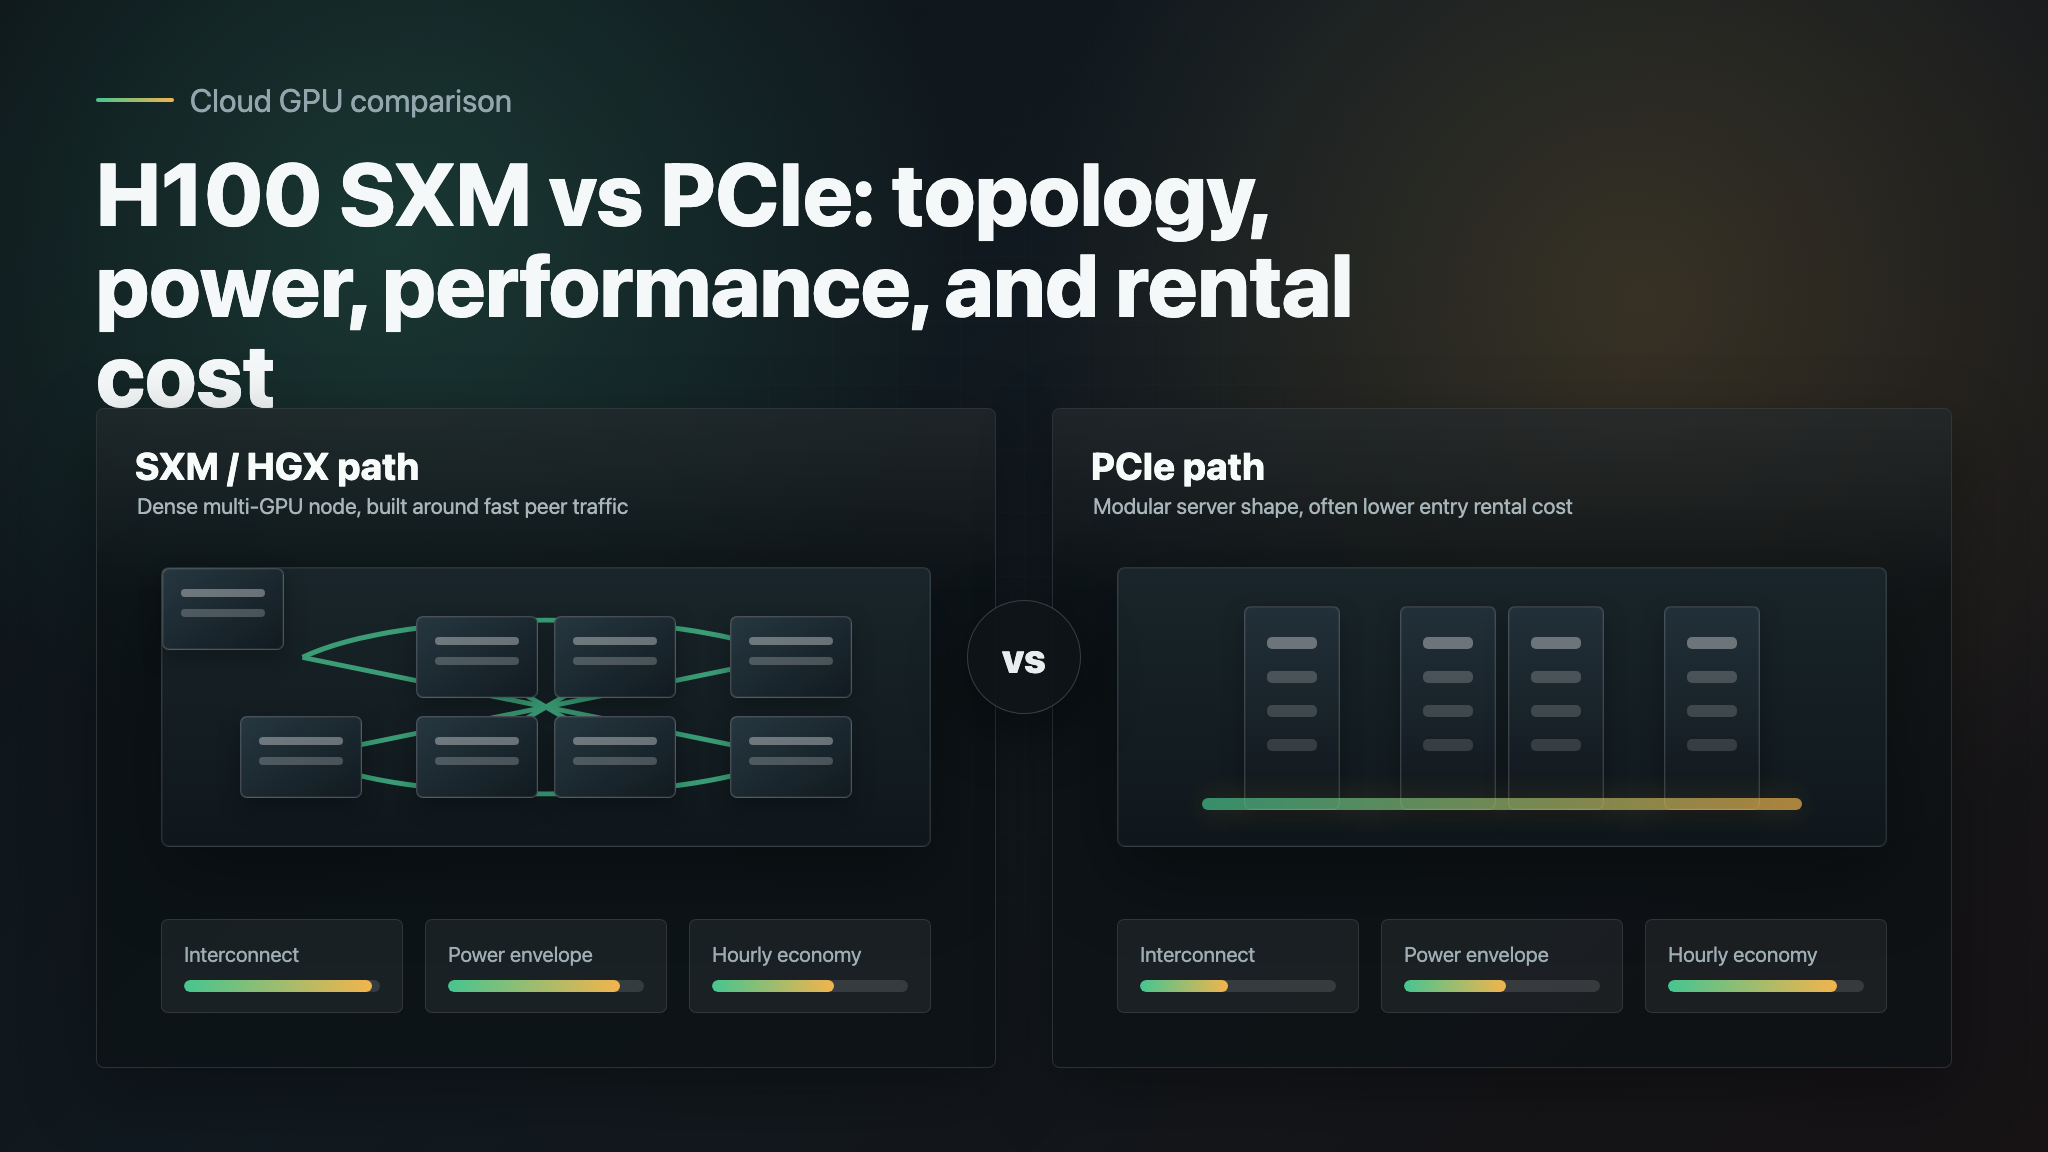
h100 pcie vs sxm を探しているなら、短い答えはシンプルです。ワークロードが高密度なマルチGPU帯域幅、NVLink/NVSwitch トポロジー、そしてより大きな電力枠の恩恵を受けるなら H100 SXM を選びます。より低いレンタルコスト、単一GPUへのアクセスのしやすさ、またはよりシンプルなサーバー構成が必要なら H100 PCIe を選びます。
より難しい答えは経済性です。より安い H100 PCIe の1時間単価が、ジョブが長引いたり、GPU間通信の待ち時間が増えたり、モデルを過度にシャーディングする必要がある場合に、必ずしも安くなるとは限りません。より高価な H100 SXM の1時間単価も、推論サービスがメモリをあまり使わない、CPUボトルネック、またはほぼ単一GPUで完結する場合には、必ずしも優れているとは限りません。
このガイドでは、H100 SXM vs PCIe を NVLink、電力、想定される性能特性、レンタルコストの観点で比較します。また、一般的な H100 PCIe の掲載と、H100 NVL を切り分けます。H100 NVL は NVLink ブリッジ対応を備えた PCIe ファミリーの NVIDIA 製品で、一般的な H100 PCIe のレンタルと混同されがちです。
H100 PCIe と SXM をひと目で比較
| 判断ポイント | H100 SXM | H100 PCIe / PCIe ファミリー |
|---|---|---|
| 最適用途 | マルチGPU学習、高スループット推論、4~8 GPU にまたがってスケールするジョブ | 単一GPUの実験、小規模推論サービス、低コストのレンタル、幅広いサーバー互換性 |
| 物理形式 | HGX/DGX スタイルのシステム内の SXM モジュール | PCIe のデュアルスロットカード、または PCIe ファミリーのシステム |
| 相互接続の特徴 | 高帯域の GPU 間通信向けに設計されている。NVIDIA は H100 SXM に 900 GB/s の NVLink を掲載している | 通常の PCIe はサーバー設計に強く依存する。NVIDIA H100 NVL は NVLink ブリッジ対応の特別な PCIe ファミリー オプション |
| 電力枠 | NVIDIA は H100 SXM を最大 700W の設定可能 TDP として掲載 | NVIDIA は H100 NVL を 350~400W の設定可能 TDP として掲載。多くの一般的な H100 PCIe レンタルは、低消費電力のサーバースロット向けに選ばれる |
| メモリ帯域幅 | NVIDIA は H100 SXM を 3.35 TB/s と掲載 | NVIDIA は H100 NVL を 3.9 TB/s と掲載しているが、それはすべての一般的な H100 PCIe の掲載と同じではない |
| レンタル傾向 | 2026年10月13日の Price of Compute スナップショットでは平均オンデマンド価格は高めだが、掲載プロバイダー数は多い | 同スナップショットでは平均オンデマンド価格は低めだが、掲載プロバイダー数は少ない |
| 購入者リスク | ワークロードが相互接続に依存していないのに SXM に対して支払ってしまうこと | ワークロードが本当に高速なマルチGPU集団通信を必要としているのに PCIe を過小購入してしまうこと |
多くのチームにとって、nvidia h100 sxm vs pcie differences はトポロジーに集約されます。GPU が1つの密結合したマシンのように振る舞う必要がある場合、通常は SXM のほうが適しています。各 GPU が独立して動ける場合、または最大のクラスター効率よりレンタルの柔軟性が重要な場合、通常は PCIe のほうが適しています。
簡単な判断基準
価格を見る前に、次の基準を使ってください。
| ワークロードが主に... | まず検討するのは... | 理由 |
|---|---|---|
| 多数の GPU にまたがる分散学習、ファインチューニング、大規模バッチ推論 | H100 SXM | NVLink/NVSwitch トポロジーにより通信ボトルネックを減らせる可能性がある |
| 単一GPU推論、埋め込み、バッチジョブ、プロトタイプ、レイテンシテスト | H100 PCIe | SXM のレンタルプレミアムを正当化するほど相互接続を使わない可能性がある |
| かろうじて1枚のGPUに収まる大規模モデルを提供する場合 | 両方を試す | メモリ、テンソル並列、バッチ形状が実際の勝者を決める |
| キュー待ちが重要な短い実験 | メモリ要件を満たす利用可能なレンタル | 最適なフォームファクターを待つコストのほうが価格差より大きくなることがある |
| 直接 CUDA 制御を必要としない本番推論 | GPU レンタルとモデル/API のベースラインを比較する | 利用率が低い、またはスパiky な場合、マネージド API のほうが運用上安くなることがある |
H100 クラスの容量が必要なのがたまにだけなら、ハードウェアを確保する前に GPU ルートとマネージドモデル/API ルートを比較してください。Flatkey は、1つの API キー、1つの請求面、そして多くのモデルファミリーへの OpenAI 互換アクセスをチームに提供します。直接 GPU を操作することが目的でないなら、こちらのほうがシンプルな基準になることが多いです。
NVLink が最大のアーキテクチャ上の違い
h100 pcie vs sxm が単なるスロット形式の問題ではない主な理由は NVLink です。
NVIDIA の公開 H100 ページでは、第4世代 NVLink が H100 の GPU 間相互接続として 900 GB/s であることが示されており、H100 の製品表では H100 SXM が NVIDIA NVLink 900 GB/s と PCIe Gen5 128 GB/s を備えているとされています。これが、SXM をレンタルする際に通常支払っているトポロジーです。つまり、複数の GPU が高帯域かつ予測可能なレイテンシで通信できるサーバー設計です。
分散学習では、all-reduce、テンソル並列、パイプライン並列、最適化同期がボトルネックになるため、これは重要です。1枚の GPU では計算ボトルネックに見えるワークロードでも、4枚または8枚の GPU に広がると通信ボトルネックになることがあります。その場合、H100 SXM vs PCIe の判断は、1時間単価だけではなく、ベンチマーク済みのジョブ時間で行うべきです。
PCIe は異なります。柔軟で一般的であり、多くのサーバー設計に組み込みやすい一方で、ノード内の各 GPU が他のすべての GPU と密な NVLink 接続を持つことを自動的には意味しません。PCIe ファミリーの H100 システムにはブリッジオプションを備えたものもあります。NVIDIA の H100 NVL 製品は、特に NVLink ブリッジ対応を備えた PCIe のデュアルスロット空冷設計で、LLM 推論向けにペア構成で 188 GB の HBM3 を提供します。だからといって、「H100 PCIe」と記載されたすべてのクラウド掲載が同じトポロジーを持つわけではありません。
前提として答えを決めつける前に、レンタルプロバイダーに次の質問をしてください:
- それは通常の H100 PCIe ですか、H100 NVL ですか、HGX H100 ですか、それとも別のサーバー設計ですか?
- ノード内には何台の GPU がありますか?
- レンタルする GPU 間で NVLink は有効ですか?
- NVSwitch は搭載されていますか?
- その正確なノードタイプで測定された NCCL の all-reduce 帯域幅はどれくらいですか?
- GPU は 1 人の顧客専用ですか、それともマーケットプレイスのスケジューラを通じて共有されていますか?
通常、これらの答えのほうが、"PCIe" と "SXM" という言葉そのものよりも重要です。
消費電力とデータセンターの制約
nvidia h100 sxm vs pcie power consumption というキーワードは、多くの場合、実務上の懸念を指しています。つまり、プロバイダー、コロケーションラック、またはプライベートクラスタが、その電力・冷却プロファイルをサポートできるかということです。
NVIDIA は H100 SXM を最大 700W の設定可能 TDP として掲載しています。H100 NVL は PCIe のデュアルスロット・空冷製品で、350〜400W の設定可能 TDP として掲載されています。平たく言えば、SXM は、最上位 GPU クラスタに必要な電力、冷却、ボード統合を前提とした高密度アクセラレーテッドサーバー向けに設計されています。PCIe ファミリーのカードは、より一般的なサーバー形状に適しています。
レンタルでは、この電力差は間接的に現れます。
- SXM の容量は、HGX、DGX、または同等の高密度マルチ GPU システム内で販売されることが多いです。
- PCIe の容量は、より小さいノード形状やマーケットプレイスで見つけやすいです。
- 通信負荷の高い処理では、SXM のほうがジョブあたりのスループットが高い場合があります。
- 単一 GPU ジョブでは、PCIe のほうが入手しやすく、初期コストが低い場合があります。
TDP を、請求される電気代のように比較してはいけません。クラウドの GPU レンタルでは、通常はバンドルされた時間単価を支払います。重要なのは、より高電力な SXM システムが十分に速く完了するか、あるいはバッチ処理量を十分に増やして、完了済みジョブ 1 件あたりのコストを下げられるかどうかです。
性能: SXM が通常優位な場面
SXM は、GPU 同士の協調が必要な場合に、通常優位です。
例:
- マルチ GPU の事前学習、または継続事前学習。
- 勾配が GPU 間を頻繁に移動するフルファインチューニング。
- 1 枚の GPU にきれいに収まらない大規模モデル向けのテンソル並列推論。
- バッチ処理と通信オーバーヘッドが tokens per second を左右する高スループットのサービス提供。
- 高速なピアツーピア GPU 通信に依存する科学計算や HPC ワークロード。
これらのケースでは、h100 pcie vs sxm の価格だけを狭く比較すると誤解を招きます。SXM ノードが GPU 時間あたり 30% 高価でも、ジョブ時間が 40% 短縮されるなら、完了済み実行 1 回あたりの実効コストは改善される可能性があります。逆に、60% 高価で、ジョブの改善が 5% にとどまるなら、PCIe のほうが適切です。
そのため、本番導入の判断ではワークロードレベルの指標を使うべきです:
| ワークロード | 時間単価より適切な指標 |
|---|---|
| ファインチューニング | 成功した学習実行 1 回あたりのコスト |
| バッチ推論 | 100 万の受け入れ済みトークンまたは出力あたりのコスト |
| リアルタイム推論 | 目標レイテンシで提供した 1 リクエストあたりのコスト |
| 埋め込み生成 | 100 万ベクトル生成あたりのコスト |
| 評価ハーネス | 完了したベンチマークスイート 1 件あたりのコスト |
より広い GPU 選定のトレードオフについては、Flatkey の H100 vs A100、H200 vs H100、LLM 推論に最適な GPU のガイドを参照してください。
性能: PCIe で十分な場合
ワークロードが高密度な GPU 間通信を必要としないなら、H100 PCIe のほうが適切な出発点になることがあります。
例:
- メモリに収まるモデル向けの単一 GPU 推論。
- 各 GPU が独立したバッチを処理できる埋め込み生成。
- データ前処理、評価、またはオフラインのバッチスコアリング。
- スケールアップ前の初期ファインチューニング実験。
- 実行時間よりも時間単価の支出が重要なコスト重視のジョブ。
これは H100 SXM vs PCIe の購入判断で最もよくあるミスです。チームは最上位の SXM システムを「安全そう」という理由で借り、実際には支払ったトポロジーをほとんど使わないワークロードを実行してしまいます。
ワークロードを独立した単位に分割できるなら、まず PCIe から始めてください。GPU 通信、モデルのシャーディング、またはマルチ GPU の活用がスループットの足かせになっているとプロファイリングで分かったら、SXM に移行します。
レンタルコスト: 2026年10月のスナップショット
レンタル市場は急速に変化するため、nvidia h100 sxm vs pcie price difference は恒久的な真実ではなく、時点のスナップショットとして扱ってください。
2026年10月13日に確認した Price of Compute API のスナップショットでは、次のようになっていました:
| SKU | オンデマンド平均 | 平均に含まれるプロバイダー数 | スポット平均 | スポット平均に含まれるプロバイダー数 | スナップショットで観測された最安掲載価格 |
|---|---|---|---|---|---|
| H100 SXM | $4.0185 / GPU-hour | 8 | $2.157633 / GPU-hour | 3 | Vast のオンデマンドで $1.733333 / GPU-hour |
| H100 PCIe | $2.945 / GPU-hour | 2 | API 応答に集計スポット平均なし | n/a | ZA の Vast で $0.666667 / GPU-hour のスポット |
このスナップショットは、PCIe の平均オンデマンド価格が低く、SXM のほうが掲載プロバイダーのカバー範囲が広いことを示唆しています。また、プロバイダー一覧からも、平均だけで判断すべきではない理由が分かります。地域、マーケットプレイス供給、スポットの中断リスク、最小レンタルサイズ、ストレージ、egress、サポートレベルが、最終コストを大きく左右し得ます。
より詳しいレンタル市場の文脈については、Flatkey の GPU レンタル価格ガイド、GPU クラウド比較、GPU クラウドの隠れたコスト をご覧ください。
H100 SXM と PCIe のコストを正しく比較する方法
時間単価で止めずに、次の式を使ってください:
実効コスト =
  GPU 時間単価
  x 使用した GPU 数
  x 実稼働時間
  + ストレージ
  + データ転送
  + アイドル状態のセットアップ/デバッグ時間
  + 再試行または中断コスト
次に、事業成果で正規化します:
承認済み出力あたりのコスト =
  実効コスト / 承認済み出力数
学習では、承認済み出力は評価を通過した 1 つのチェックポイントかもしれません。推論では、100 万件の利用可能なトークン、画像、クリップ、埋め込み、またはリクエストかもしれません。これは、h100 sxm vs pcie price が、生の GPU 時間ではなく承認済み出力で測ると逆転することがあるため重要です。
意思決定ロジックの例:
| シナリオ | 確認すべきこと | 起こりそうな結果 |
|---|---|---|
| 1つの 70B モデル、1 GPU、中程度のバッチサイズ | PCIe の時間単価、レイテンシ、メモリ余裕 | PCIe が有利かもしれない |
| 複数 GPU に分割された 70B+ モデル | NCCL 帯域幅、tokens/sec、テールレイテンシ | SXM が有利かもしれない |
| 頻繁な同期を伴うファインチューニング | ステップ時間と総実行時間 | SXM を試す価値が高いことが多い |
| 大規模コーパスに対する埋め込み生成 | GPU 利用率とキューのオーバーヘッド | PCIe で十分なことがある |
| 短期の概念実証 | セットアップ時間と可用性 | 最も安く入手できる H100 が有利かもしれない |
| 直接の GPU 制御が不要な本番 API | モデル/API 価格と運用オーバーヘッド | マネージド API の方がどちらのレンタル経路より有利な場合がある |
最後の行が、意思決定における Flatkey の出番です。チームが求めているのが GPU の所有ではなくモデル出力なら、直接の GPU レンタルと API ベースラインを比較してください。Flatkey は、1 つのキーと 1 つの請求面で多数のモデルにまたがるルーティングを支援し、個別のプロバイダーアカウントを管理する運用負荷を軽減します。
調達チェックリスト
H100 のキャパシティを借りる、または予約する前に、次を確認してください:
- 掲載されているのは H100 SXM、通常の H100 PCIe、H100 NVL、それとも HGX H100 ですか?
- 各ノードに GPU は何枚ありますか?
- 正確なレンタル構成で NVLink は利用できますか? できる場合、トポロジーは?
- NVSwitch はありますか?
- 含まれる CPU、RAM、ローカル NVMe、ネットワークは何ですか?
- 価格はオンデマンド、予約、スポット、マーケットプレイス、それともプロモーションですか?
- ストレージ、スナップショット、パブリック IP、サポート、イグレスは含まれますか?
- コミットする前に NCCL とワークロードレベルのベンチマークを実行できますか?
- スポット容量が回収された場合、またはノードが失敗した場合はどうなりますか?
- マネージドのモデル/API 経路で、より少ない運用作業で同じ製品要件を満たせますか?
クラスター全体の経済性については、Flatkey の GPU クラスター TCO ガイド と GPU クラウド vs モデル API 比較 を使用してください。
推奨ベンチマーク計画
より長い予約に署名する前に、H100 PCIe と H100 SXM の両方で同じテストを実行してください。
- 本番で使用するのと同じフレームワーク、たとえば vLLM、SGLang、PyTorch FSDP、DeepSpeed、TensorRT-LLM から始めます。
- GPU 利用率、メモリ利用率、1 秒あたりのトークン数、ステップ時間、テールレイテンシ、失敗/再試行ジョブを記録します。
- ジョブが複数 GPU にまたがる場合は、NCCL テストのような通信ベンチマークを実行します。
- 合成的な最大値だけでなく、現実的なバッチサイズをテストします。
- セットアップ時間、データの配置、アイドル時のデバッグ時間もコストに含めます。
- GPU 時間単価だけでなく、承認済み出力あたりのコストを比較します。
- 製品が直接の CUDA 制御を必要としない場合は、モデル/API ベースラインを保持します。
このベンチマーク計画は、nvidia h100 sxm vs pcie differences にとって特に重要です。性能差はワークロードの形に左右されるためです。1 つのマルチ GPU 学習ジョブに非常に優れた SXM システムでも、独立したバッチ推論キューには過剰になることがあります。
どちらを選ぶべきか?
次の場合は H100 SXM を選びます:
- ワークロードが複数 GPU にまたがり、通信オーバーヘッドが目に見える。
- 高い GPU 間帯域幅を持つ HGX/DGX スタイルのシステムが必要。
- 学習のステップ時間やマルチ GPU 推論スループットが、最安の時間単価より重要。
- プレミアムを正当化できるほど GPU を高稼働に保てる。
次の場合は H100 PCIe を選びます:
- シングル GPU 推論、実験、バッチジョブを実行している。
- より低い初期費用や、より柔軟なサーバー形状が必要。
- ワークロードが密結合 GPU ではなく独立したジョブに並列化される。
- 高密度な SXM キャパシティに費用を払う前に需要を検証したい。
次の場合はモデル/API 経路を選びます:
- 製品に必要なのは出力であり、低レベルの GPU アクセスではない。
- 利用率がバースト的、または予測不能。
- GPU クラウド全体で、キャパシティ、ドライバー、キュー、チェックポイント、請求を管理したくない。
- すでに GPT、Claude、Gemini、オープンウェイト、画像、または動画モデルを 1 つの統合面で扱う必要がある。
h100 pcie vs sxm に対する実践的な答えは、「SXM は常に速い」でも「PCIe は常に安い」でもありません。正しい答えは、実際のワークロードをベンチマークし、承認済み出力で正規化し、製品要件を満たす最もシンプルなインフラ経路を使うことです。
よくある質問
H100 SXM は H100 PCIe より速いですか?
多くの場合はそうです。密な NVLink/NVSwitch トポロジーと、より高い SXM の電力上限が有利に働くマルチ GPU ワークロードでは特にそうです。ただし、シングル GPU や疎に並列化されたワークロードでは、追加のレンタルコストを正当化できるほどの差が出ないことがあります。
H100 SXM と PCIe の主な違いは何ですか?
主な違いは、GPUを取り巻くシステム設計にあります。H100 SXM は、高いGPU間帯域幅を備えた高密度のアクセラレーテッドサーバー向けに設計されています。H100 PCIe は、より一般的なサーバー設計に適合するカード型フォームファクターです。H100 NVL などの一部のPCIe系製品はNVLinkブリッジ対応を追加していますが、一般的なPCIeの掲載情報は確認が必要です。
すべての H100 PCIe のレンタルに NVLink は含まれますか?
いいえ。すべての H100 PCIe の掲載情報で NVLink や NVSwitch が利用できるとは限りません。正確なノードのトポロジーをプロバイダーに確認し、複数GPUジョブではレンタル構成で NCCL テストを実行してください。
なぜ H100 SXM のレンタルは高いのですか?
SXM の容量は通常、より高密度で高電力のシステムの一部として販売され、より強力なGPU間インターコネクトとクラスタ統合を備えています。レンタル価格は、プロバイダー、地域、容量逼迫、予約条件、サポート、そして掲載がオンデマンドかスポットかによっても異なります。
H100 PCIe は LLM 推論に適していますか?
はい。モデルがメモリに収まり、サービスに重いマルチGPU通信が不要であれば、H100 PCIe は LLM 推論に適しています。シャーディングされた大規模モデル推論やノードあたりの最大スループットを狙う場合は、H100 SXM をベンチマークする価値があります。
H100 SXM と PCIe のレンタルコストはどのように比較すべきですか?
完了したジョブあたりのコスト、または受理された出力あたりのコストで比較してください。GPU時間、GPU数、ジョブ時間、ストレージ、転送、アイドル状態でのデバッグ、中断、サポートを含めます。時間単価だけでは、実際の h100 sxm vs pcie price のトレードオフは把握できません。
いつ GPU レンタルをやめて API を使うべきですか?
直接の CUDA 制御、カスタムカーネル、プライベートなモデル重み、またはクラスタ全体の所有が不要な場合は、API を基準にしてください。ワークロードが突発的である場合や、チームが主にモデルの応答を必要とする場合は、Flatkey の統合 API 経由のほうが、H100 容量を直接レンタルして運用するより簡単です。


