
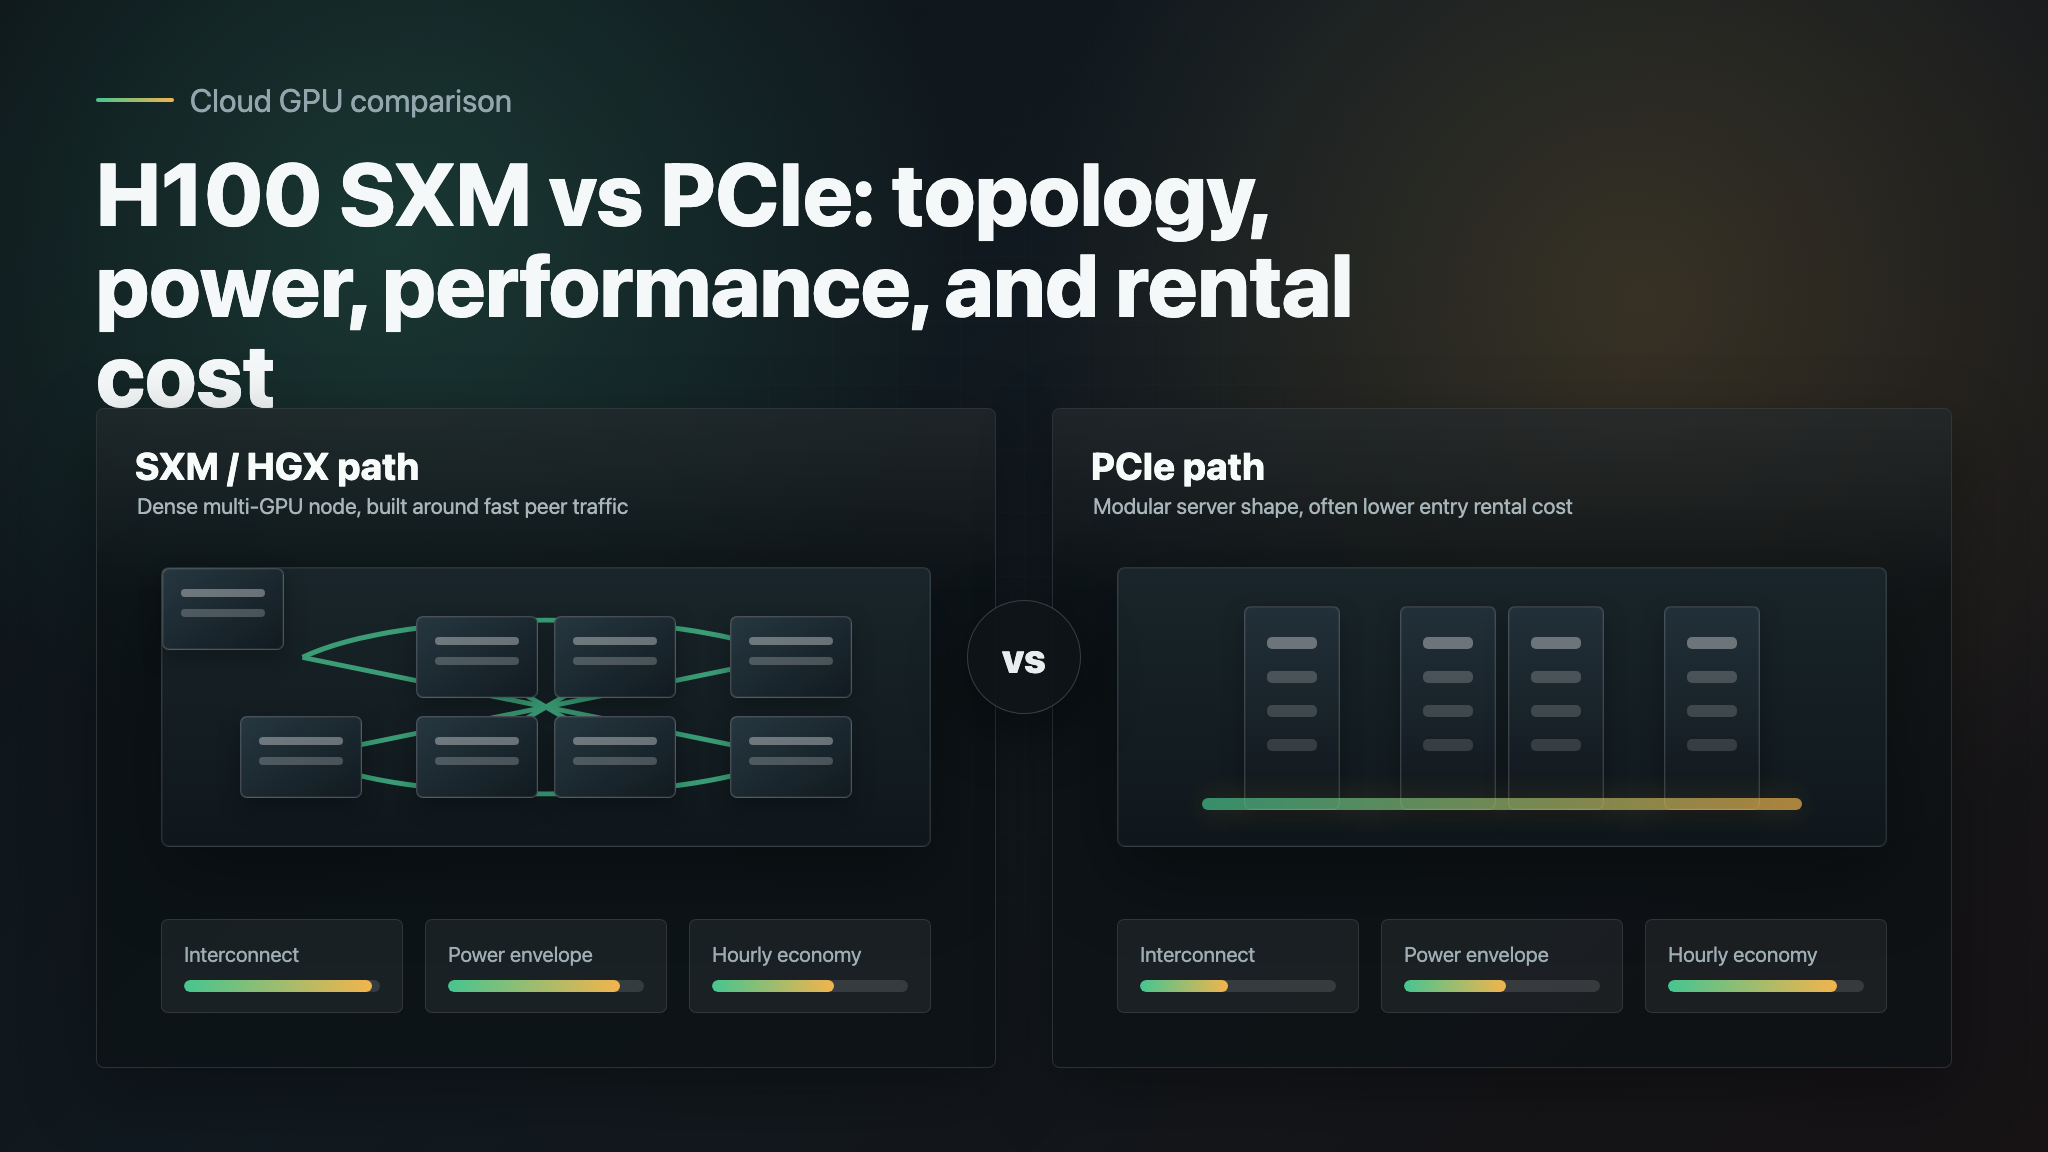
Si vous recherchez h100 pcie vs sxm, la réponse courte est simple : choisissez H100 SXM lorsque votre charge de travail bénéficie d’une bande passante multi-GPU dense, d’une topologie NVLink/NVSwitch et d’une enveloppe de puissance plus élevée ; choisissez H100 PCIe lorsque vous avez besoin d’un coût de location plus faible, d’un accès mono-GPU plus simple ou d’une forme de serveur plus simple.
La réponse plus difficile est économique. Une heure H100 PCIe moins chère n’est pas automatiquement moins coûteuse si le travail s’exécute plus longtemps, passe plus de temps à attendre la communication GPU-à-GPU ou vous oblige à sur-segmenter un modèle. Une heure H100 SXM plus chère n’est pas automatiquement meilleure si votre service d’inférence est peu gourmand en mémoire, limité par le CPU ou fonctionne principalement sur un seul GPU.
Ce guide compare H100 SXM vs PCIe selon NVLink, la puissance, le comportement de performance attendu et le coût de location. Il distingue également les offres H100 PCIe standard du H100 NVL, un produit NVIDIA de la famille PCIe avec prise en charge du pont NVLink, souvent confondu avec une location H100 PCIe générique.
H100 PCIe vs SXM en un coup d’œil
| Point de décision | H100 SXM | H100 PCIe / famille PCIe |
|---|---|---|
| Meilleure adéquation | Entraînement multi-GPU, inférence à haut débit, tâches qui s’étendent sur 4 à 8 GPU | Expériences sur un seul GPU, services d’inférence plus petits, location à moindre coût, compatibilité serveur plus large |
| Format physique | Module SXM dans des systèmes de type HGX/DGX | Cartes PCIe double largeur ou systèmes de la famille PCIe |
| Interconnexion | Conçu pour une communication GPU-à-GPU à large bande passante ; NVIDIA indique 900 GB/s de NVLink sur H100 SXM | Le PCIe standard dépend fortement de la conception du serveur ; NVIDIA H100 NVL est une option spéciale de la famille PCIe avec prise en charge du pont NVLink |
| Enveloppe de puissance | NVIDIA indique H100 SXM avec un TDP configurable pouvant atteindre 700W | NVIDIA indique H100 NVL à 350-400W de TDP configurable ; de nombreuses locations H100 PCIe standard sont choisies pour des emplacements serveur à plus faible consommation |
| Bande passante mémoire | NVIDIA indique H100 SXM à 3.35 TB/s | NVIDIA indique H100 NVL à 3.9 TB/s, mais ce n’est pas la même chose que chaque offre H100 PCIe générique |
| Profil de location | Prix moyen à la demande plus élevé dans l’instantané Price of Compute du 13 octobre 2026, mais davantage de fournisseurs listés | Prix moyen à la demande plus faible dans le même instantané, avec moins de fournisseurs listés |
| Risque pour l’acheteur | Payer pour SXM alors que la charge de travail n’est pas limitée par l’interconnexion | Sous-dimensionner le PCIe alors que la charge de travail a vraiment besoin de collectifs multi-GPU rapides |
Pour la plupart des équipes, les différences nvidia h100 sxm vs pcie se résument à la topologie. SXM est généralement le meilleur choix lorsque les GPU doivent se comporter comme une seule machine étroitement couplée. PCIe est généralement le meilleur choix lorsque chaque GPU peut travailler indépendamment ou lorsque la flexibilité de location compte davantage que l’efficacité maximale du cluster.
La règle rapide
Utilisez cette règle avant de regarder le prix :
| Si votre charge de travail est surtout... | Commencez avec... | Pourquoi |
|---|---|---|
| Entraînement distribué, fine-tuning ou inférence par lots volumineux sur de nombreux GPU | H100 SXM | La topologie NVLink/NVSwitch peut réduire les goulots d’étranglement de communication |
| Inférence sur un seul GPU, embeddings, tâches par lots, prototypes ou tests de latence | H100 PCIe | Vous n’utiliserez peut-être pas assez l’interconnexion pour justifier les primes de location SXM |
| Servir un grand modèle qui tient à peine sur un seul GPU | Tester les deux | La mémoire, le parallélisme tensoriel et la forme des lots déterminent le véritable gagnant |
| Expériences courtes où le temps d’attente dans la file compte | La location disponible qui répond aux besoins mémoire | Attendre le format parfait peut coûter plus cher que l’écart de prix |
| Inférence de production sans besoin de contrôle CUDA direct | Comparer la location GPU à une base de référence modèle/API | Les API managées peuvent être moins chères opérationnellement lorsque l’utilisation est faible ou irrégulière |
Si vous n’avez besoin de capacités de classe H100 qu’occasionnellement, comparez l’option GPU à une option modèle/API managée avant de réserver du matériel. Flatkey donne aux équipes une clé API, une interface de facturation et un accès compatible OpenAI à de nombreuses familles de modèles, ce qui constitue souvent la base de comparaison la plus simple lorsque le contrôle direct du GPU n’est pas l’objectif.
NVLink est la plus grande différence architecturale
NVLink est la principale raison pour laquelle h100 pcie vs sxm n’est pas seulement une question de format de slot.
La page publique H100 de NVIDIA indique NVLink de quatrième génération à 900 GB/s d’interconnexion GPU-à-GPU pour H100, et son tableau produit H100 indique H100 SXM avec NVIDIA NVLink à 900 GB/s plus PCIe Gen5 à 128 GB/s. C’est la topologie pour laquelle les locataires SXM paient généralement : une conception de serveur où plusieurs GPU peuvent communiquer avec une large bande passante et une latence prévisible.
Pour l’entraînement distribué, cela compte parce que le all-reduce, le parallélisme tensoriel, le parallélisme pipeline et la synchronisation de l’optimiseur peuvent devenir le goulot d’étranglement. Une charge de travail qui semble limitée par le calcul sur un seul GPU peut devenir limitée par la communication dès qu’elle s’étend sur quatre ou huit GPU. Dans ce cas, la question H100 SXM vs PCIe doit être tranchée par le temps de travail mesuré en benchmark, et non par le seul prix horaire.
Le PCIe est différent. Il est flexible, courant et plus facile à intégrer dans de nombreuses conceptions de serveurs, mais cela ne signifie pas automatiquement que chaque GPU dispose d’une connectivité NVLink dense vers tous les autres GPU du nœud. Certains systèmes H100 de la famille PCIe incluent des options de pont. Le produit H100 NVL de NVIDIA est précisément une conception PCIe double largeur refroidie par air avec prise en charge du pont NVLink et 188 GB de HBM3 sur une configuration jumelée pour l’inférence LLM. Cela ne signifie pas que chaque offre cloud appelée "H100 PCIe" possède la même topologie.
Posez ces questions aux fournisseurs de location avant de présumer de la réponse :
- S’agit-il d’un H100 PCIe standard, d’un H100 NVL, d’un HGX H100 ou d’un autre design de serveur ?
- Combien de GPU y a-t-il dans le nœud ?
- NVLink est-il activé entre les GPU que vous louez ?
- NVSwitch est-il présent ?
- Quelle est la bande passante mesurée de l’all-reduce NCCL sur ce type exact de nœud ?
- Les GPU sont-ils dédiés à un seul client ou partagés via un ordonnanceur de marketplace ?
Ces réponses comptent généralement plus que les mots « PCIe » et « SXM » pris isolément.
Consommation électrique et contraintes de centre de données
Le mot-clé nvidia h100 sxm vs pcie power consumption renvoie généralement à une préoccupation pratique : votre fournisseur, votre rack de colocation ou votre cluster privé peut-il prendre en charge le profil de consommation électrique et de refroidissement ?
NVIDIA indique jusqu’à 700 W de TDP configurable pour le H100 SXM. Elle indique 350 à 400 W de TDP configurable pour le H100 NVL, un produit PCIe à double emplacement refroidi par air. En termes simples, SXM est conçu pour des serveurs accélérés à haute densité, où la plateforme attend l’alimentation, le refroidissement et l’intégration de carte nécessaires aux clusters GPU haut de gamme. Les cartes de la famille PCIe s’intègrent dans une forme de serveur plus classique.
Pour la location, la différence de consommation apparaît indirectement :
- La capacité SXM est souvent vendue au sein de systèmes multi-GPU denses de type HGX, DGX ou équivalent.
- La capacité PCIe est plus facile à trouver dans des formats de nœuds plus petits et sur les marketplaces.
- SXM peut offrir un meilleur débit par tâche pour les charges de travail intensives en communication.
- PCIe peut offrir une meilleure disponibilité ou un coût d’entrée plus faible pour les tâches sur un seul GPU.
Ne comparez pas le TDP comme s’il s’agissait de votre facture d’électricité. Les locataires de GPU cloud paient généralement un tarif horaire groupé. La question économique pertinente est de savoir si le système SXM, plus énergivore, termine suffisamment plus vite ou permet un débit de batch plus élevé, afin de réduire le coût par tâche terminée.
Performance : là où SXM gagne généralement
SXM l’emporte généralement lorsque les GPU doivent se coordonner.
Exemples :
- Pré-entraînement multi-GPU ou poursuite du pré-entraînement.
- Fine-tuning complet où les gradients circulent fréquemment entre GPU.
- Inférence tensor-parallel pour les grands modèles qui ne tiennent pas proprement sur un seul GPU.
- Service à haut débit où le batching et la surcharge de communication déterminent les tokens par seconde.
- Charges de travail scientifiques ou HPC qui dépendent d’un trafic GPU pair à pair rapide.
Dans ces cas, une comparaison de prix étroite h100 pcie vs sxm peut vous induire en erreur. Si un nœud SXM est 30 % plus cher par GPU-heure mais réduit le temps de travail de 40 %, le coût effectif par exécution terminée peut malgré tout diminuer. S’il est 60 % plus cher et que votre tâche n’obtient qu’un gain de 5 %, PCIe est le meilleur choix.
C’est pourquoi une décision de production devrait utiliser une métrique au niveau de la charge de travail :
| Charge de travail | Métrique meilleure que le prix horaire |
|---|---|
| Fine-tuning | Coût par exécution d’entraînement réussie |
| Inférence par lots | Coût par million de tokens ou de sorties acceptés |
| Inférence en temps réel | Coût par requête servie au niveau de latence cible |
| Embeddings | Coût par million de vecteurs générés |
| Bancs d’évaluation | Coût par suite de benchmark terminée |
Pour des arbitrages plus larges sur le choix de GPU, consultez les guides de Flatkey sur H100 vs A100, H200 vs H100 et le meilleur GPU pour l’inférence LLM.
Performance : là où PCIe peut suffire
Le H100 PCIe peut être un meilleur point de départ lorsque la charge de travail n’a pas besoin d’une communication GPU-à-GPU dense.
Exemples :
- Inférence sur un seul GPU pour des modèles qui tiennent en mémoire.
- Génération d’embeddings où chaque GPU peut traiter des lots indépendants.
- Prétraitement des données, évaluation ou scoring par lots hors ligne.
- Premiers essais de fine-tuning avant passage à l’échelle.
- Tâches sensibles au coût où le temps de mur n’est pas aussi important que la dépense horaire.
C’est l’erreur la plus courante dans l’achat de H100 SXM vs PCIe : les équipes louent le système SXM haut de gamme parce qu’il semble plus sûr, puis exécutent des charges de travail qui utilisent à peine la topologie pour laquelle elles ont payé.
Commencez par PCIe si votre charge de travail peut être divisée en unités indépendantes. Passez à SXM lorsque le profilage montre que la communication GPU, le découpage du modèle ou l’utilisation multi-GPU freinent le débit.
Coût de location : instantané d’octobre 2026
Les marchés de la location évoluent rapidement ; considérez donc toute nvidia h100 sxm vs pcie price difference comme un instantané daté, et non comme une vérité permanente.
L’instantané de l’API Price of Compute consulté le 13 octobre 2026 indiquait :
| SKU | Moyenne à la demande | Fournisseurs dans la moyenne | Moyenne spot | Fournisseurs dans la moyenne spot | Prix affiché le plus bas observé dans l’instantané |
|---|---|---|---|---|---|
| H100 SXM | 4,0185 $ / GPU-heure | 8 | 2,157633 $ / GPU-heure | 3 | 1,733333 $ / GPU-heure à la demande sur Vast |
| H100 PCIe | 2,945 $ / GPU-heure | 2 | Aucune moyenne spot agrégée dans la réponse de l’API | n/a | 0,666667 $ / GPU-heure spot sur Vast en ZA |
Cet instantané suggère que le PCIe avait un prix moyen à la demande plus faible, tandis que le SXM bénéficiait d’une couverture plus large des fournisseurs listés. La liste des fournisseurs montre aussi pourquoi il ne faut pas décider uniquement à partir des moyennes : région, offre du marketplace, risque d’interruption spot, taille minimale de location, stockage, egress et niveau de support peuvent dominer le coût final.
Pour davantage de contexte sur le marché de la location, consultez le guide des prix de location de GPU, la comparaison des clouds GPU et les coûts cachés du cloud GPU.
Comment comparer correctement le coût du H100 SXM par rapport au PCIe
Utilisez cette formule au lieu de vous arrêter au prix horaire :
coût effectif =
  prix horaire du GPU
  x nombre de GPU utilisés
  x heures de temps réel
  + stockage
  + transfert de données
  + temps de configuration/débogage inactif
  + coût des reprises ou des interruptions
Puis normalisez selon la production métier :
coût par résultat accepté =
  coût effectif / résultats acceptés
Pour l’entraînement, le résultat accepté peut être un checkpoint qui passe l’évaluation. Pour l’inférence, il peut s’agir d’un million de tokens utilisables, d’images, de clips, d’embeddings ou de requêtes. Cela compte, car le prix du h100 sxm vs pcie peut s’inverser une fois que vous mesurez le résultat accepté au lieu des seules heures GPU brutes.
Exemple de logique de décision :
| Scénario | Ce qu’il faut tester | Résultat probable |
|---|---|---|
| Un modèle 70B, un GPU, taille de batch modeste | Prix horaire du PCIe, latence, marge mémoire | Le PCIe peut l’emporter |
| Modèle 70B+ réparti sur plusieurs GPU | Bande passante NCCL, tokens/sec, latence en queue de traitement | Le SXM peut l’emporter |
| Affinage avec synchronisation fréquente | Temps d’étape et durée totale d’exécution | Le SXM mérite souvent le test |
| Embeddings sur un grand corpus | Utilisation du GPU et surcharge de file d’attente | Le PCIe peut suffire |
| Preuve de concept courte | Temps de configuration et disponibilité | Le H100 le moins cher disponible peut l’emporter |
| API de production où le contrôle direct du GPU n’est pas requis | Tarification du modèle/API et surcharge opérationnelle | Une API managée peut battre l’une ou l’autre option de location |
La dernière ligne est celle où Flatkey a sa place dans la décision. Si votre équipe veut les sorties du modèle, et non la propriété du GPU, comparez la location directe de GPU avec une base de référence API. Flatkey aide les équipes à router entre de nombreux modèles avec une seule clé et une seule surface de facturation, en réduisant la surcharge opérationnelle liée à la gestion de comptes fournisseurs séparés.
Liste de contrôle pour l’achat
Avant de louer ou de réserver de la capacité H100, demandez :
- L’annonce concerne-t-elle un H100 SXM, un H100 PCIe standard, un H100 NVL ou un HGX H100 ?
- Combien de GPU y a-t-il dans chaque nœud ?
- La configuration de location exacte expose-t-elle NVLink ? Si oui, quelle topologie ?
- NVSwitch est-il présent ?
- Quel CPU, quelle RAM, quel NVMe local et quel réseau sont inclus ?
- Le prix est-il à la demande, réservé, spot, marketplace ou promotionnel ?
- Le stockage, les snapshots, les IP publiques, le support et l’egress sont-ils inclus ?
- Pouvez-vous exécuter NCCL et des benchmarks au niveau de la charge de travail avant de vous engager ?
- Que se passe-t-il si la capacité spot est récupérée ou si le nœud tombe en panne ?
- Une route modèle/API managée répondrait-elle au même besoin produit avec moins de travail opérationnel ?
Pour l’économie au niveau du cluster, utilisez le guide TCO des clusters GPU de Flatkey et la comparaison GPU cloud vs API de modèle.
Plan de benchmark recommandé
Exécutez le même test sur H100 PCIe et H100 SXM avant de signer une réservation plus longue.
- Commencez avec le framework exact que vous utiliserez en production, comme vLLM, SGLang, PyTorch FSDP, DeepSpeed ou TensorRT-LLM.
- Enregistrez l’utilisation du GPU, l’utilisation de la mémoire, les tokens par seconde, le temps d’étape, la latence en queue de traitement et les tâches échouées/rejouées.
- Exécutez un benchmark de communication tel que les tests NCCL si la tâche s’étend sur plusieurs GPU.
- Testez des tailles de batch réalistes, pas seulement des maximums synthétiques.
- Incluez le temps de configuration, la préparation des données et le temps de débogage inactif dans le coût.
- Comparez le coût par résultat accepté, et pas seulement le prix horaire du GPU.
- Conservez une base de référence modèle/API si le produit ne nécessite pas de contrôle CUDA direct.
Ce plan de benchmark est particulièrement important pour les différences nvidia h100 sxm vs pcie, car l’écart de performance dépend de la charge de travail. Le même système SXM, excellent pour une tâche d’entraînement multi-GPU, peut être surdimensionné pour une file d’inférence batch indépendante.
Lequel devriez-vous choisir ?
Choisissez H100 SXM si :
- Votre charge de travail s’étend sur plusieurs GPU et la surcharge de communication est visible.
- Vous avez besoin d’un système de type HGX/DGX avec une bande passante GPU-à-GPU élevée.
- Le temps d’étape d’entraînement ou le débit d’inférence multi-GPU compte plus que le prix horaire le plus bas.
- Vous pouvez garder les GPU suffisamment occupés pour justifier la prime.
Choisissez H100 PCIe si :
- Vous exécutez de l’inférence sur un seul GPU, de l’expérimentation ou des traitements batch.
- Vous avez besoin d’un coût d’entrée plus faible ou de formes de serveur plus flexibles.
- Votre charge de travail se parallélise en tâches indépendantes plutôt qu’en GPU étroitement couplés.
- Vous voulez valider la demande avant de payer une capacité SXM dense.
Choisissez une route modèle/API si :
- Votre produit a besoin de résultats, pas d’un accès GPU de bas niveau.
- L’utilisation est irrégulière ou imprévisible.
- Vous ne voulez pas gérer la capacité, les pilotes, les files d’attente, les checkpoints et la facturation sur plusieurs clouds GPU.
- Vous avez déjà besoin de GPT, Claude, Gemini, de modèles open-weight, d’images ou de vidéos dans une seule surface d’intégration.
La réponse pratique à h100 pcie vs sxm n’est pas « SXM est toujours plus rapide » ni « PCIe est toujours moins cher ». La bonne réponse est : benchmarkez votre charge de travail exacte, normalisez par résultat accepté, et utilisez le chemin d’infrastructure le plus simple qui satisfait l’exigence produit.
Questions fréquemment posées
Le H100 SXM est-il plus rapide que le H100 PCIe ?
Souvent, oui, pour les charges de travail multi-GPU qui bénéficient d’une topologie NVLink/NVSwitch dense et de l’enveloppe de puissance plus élevée du SXM. Mais des charges mono-GPU ou faiblement parallèles peuvent ne pas en tirer assez pour justifier le coût de location supplémentaire.
Quelle est la principale différence entre H100 SXM et PCIe ?
La principale différence réside dans la conception du système autour du GPU. Le H100 SXM est conçu pour des serveurs accélérés denses avec une bande passante GPU à GPU élevée. Le H100 PCIe est un format sur carte qui s’intègre dans des conceptions de serveurs plus conventionnelles ; certains produits de la famille PCIe, comme le H100 NVL, ajoutent la prise en charge du pont NVLink, mais les annonces PCIe génériques doivent être vérifiées.
Chaque location de H100 PCIe inclut-elle NVLink ?
Non. Ne partez pas du principe que chaque annonce H100 PCIe expose NVLink ou NVSwitch. Demandez au fournisseur la topologie exacte du nœud et, pour les travaux multi-GPU, exécutez des tests NCCL sur la configuration louée.
Pourquoi le H100 SXM est-il plus cher à louer ?
La capacité SXM est généralement vendue dans le cadre de systèmes plus denses, à plus forte puissance, avec une interconnexion GPU à GPU plus robuste et une meilleure intégration au cluster. Le prix de location dépend aussi du fournisseur, de la région, de la pression sur la capacité, des conditions de réservation, du support, et du fait que l’annonce soit à la demande ou au spot.
Le H100 PCIe est-il adapté à l’inférence LLM ?
Oui, le H100 PCIe peut être un bon choix pour l’inférence LLM lorsque le modèle tient en mémoire et que le service n’a pas besoin d’une communication multi-GPU intensive. Pour l’inférence de grands modèles fragmentés ou pour un débit maximal par nœud, le H100 SXM mérite un benchmark.
Comment comparer le coût de location H100 SXM vs PCIe ?
Comparez le coût par tâche terminée ou le coût par sortie acceptée. Incluez les heures GPU, le nombre de GPU, la durée du job, le stockage, le transfert, le débogage en attente, les interruptions et le support. Le prix horaire seul ne reflète pas le véritable arbitrage h100 sxm vs pcie price.
Quand faut-il éviter la location de GPU et utiliser une API ?
Utilisez une référence API lorsque vous n’avez pas besoin d’un contrôle CUDA direct, de kernels personnalisés, de poids de modèle privés ou d’une propriété complète du cluster. Si la charge de travail est sporadique ou si l’équipe a surtout besoin de réponses de modèle, la route API unifiée de Flatkey peut être plus simple que de louer et d’exploiter directement de la capacité H100.


