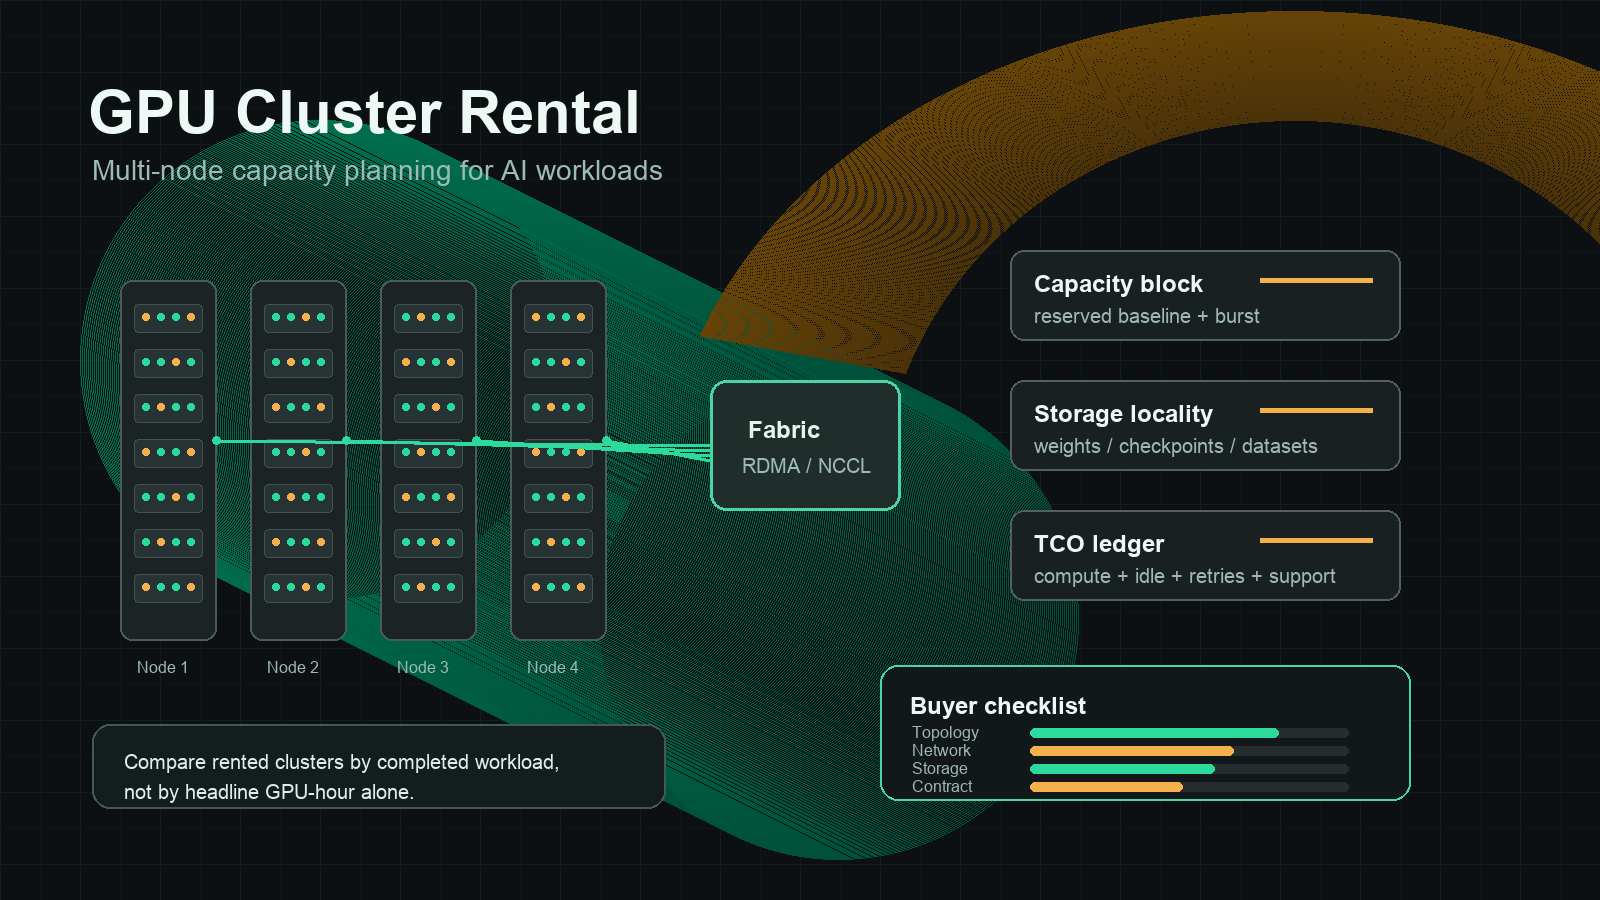
Создание kubernetes gpu cluster — это не то же самое, что подключить GPU к нескольким рабочим узлам. Для обучения и инференса ИИ Kubernetes должен безопасно предоставлять ускорители, размещать задания на нужных узлах, ставить в очередь ограниченные мощности, обеспечивать достаточную близость наборов данных и весов моделей к вычислительным ресурсам, а также сообщать операторам, почему дорогостоящий запуск завершился сбоем.
Практическое правило: создайте минимальный Kubernetes-кластер с GPU, который подтверждает работоспособность нагрузки, и расширяйте его только после того, как планировщик, драйверы, сеть, хранилище, наблюдаемость и модель затрат пройдут приемочные испытания. Кластер, который не может объяснить время ожидания в очереди, использование GPU, время восстановления контрольной точки и причины сбоев, пока не является производственной инфраструктурой.
В этом руководстве рассматриваются архитектура и операционная модель kubernetes gpu cluster, используемого для обучения и инференса ИИ. В нем описаны проектирование узлов, предоставление GPU, очереди, API рабочих нагрузок, наблюдаемость, практическая kubernetes gpu cluster diagram, инструменты управления и вопросы, которые следует задать провайдеру перед арендой или резервированием мощностей.
Если продукту нужны только выходные данные модели, сначала сравните API модели или путь с управляемым инференсом. Если вам нужны пользовательские веса, контроль размещения, приватное обслуживание, распределенное обучение или воспроизводимое владение бенчмарками, Kubernetes-кластер с GPU может стать подходящей плоскостью управления.
Краткий ответ о Kubernetes-кластере с GPU
Производственный kubernetes gpu cluster состоит из шести уровней:
| Уровень | За что отвечает | Что проверить перед запуском в production |
|---|---|---|
| Узлы с GPU | Модель GPU, память GPU, CPU/RAM, локальный NVMe, NIC, образы узлов, драйверы, среда выполнения контейнеров | Конфигурация узла соответствует нагрузке обучения или инференса, а не только заявленной SKU GPU. |
| Предоставление GPU | Плагин устройств, GPU Operator, Dynamic Resource Allocation, политика MIG или совместного использования | Поды предсказуемо запрашивают ускорители и не могут случайно использовать неправильные устройства. |
| Планирование и очереди | Планировщик Kubernetes, Kueue, Volcano, Ray, Kubeflow, пользовательские операторы | Задания ожидают справедливо, политика вытеснения явно определена, а команды могут объяснить время ожидания в очереди. |
| Сеть и хранилище | NVLink/NVSwitch внутри узлов, InfiniBand/RoCE/EFA или Ethernet между узлами, объектное хранилище, общая файловая система, путь контрольных точек | Распределенные задания масштабируются и восстанавливаются, не оставляя GPU без работы. |
| Наблюдаемость | DCGM, Prometheus, журналы, события, трассировки, метрики очередей, метки затрат | Операторы могут видеть использование, память, энергопотребление, сбои, владельца и расходы по рабочей нагрузке. |
| Безопасность и управление | RBAC, пространства имен, квоты, политика образов, секреты, сетевая политика, журналы аудита | Мультитенантный доступ контролируется до того, как кластер станет общей инфраструктурой. |
Ключевой вопрос проектирования — не «Может ли Kubernetes запускать GPU?». Может, при правильном плагине устройств и настройке узлов. Более сложный вопрос заключается в том, может ли ваш ai infrastructure kubernetes gpu cluster обеспечивать эффективное использование GPU при реальных данных, реальных пользователях, реальных сбоях и реальных бюджетных ограничениях.
Схема Kubernetes-кластера с GPU
Используйте эту kubernetes gpu cluster diagram в качестве модели для проверки перед выбором инструментов:
                 разработчики / CI / ноутбуки / API-трафик
                                  |
                                  v
        +--------------------------------------------------+
        | Плоскость управления Kubernetes                  |
        | API-сервер, планировщик, RBAC, допуск, секреты    |
        +--------------------------------------------------+
                                  |
                 +----------------+----------------+
                 |                                 |
                 v                                 v
        +------------------+              +------------------+
        | уровень очередей |              | дополнения        |
        | Kueue / Volcano  |              | платформы:       |
        | квоты, когорты,  |              | GPU Operator,    |
        | типы ресурсов    |              | плагин устройств,|
        |                  |              | DCGM exporter    |
        +------------------+              +------------------+
                 |                                 |
                 +----------------+----------------+
                                  |
                                  v
        +--------------------------------------------------+
        | Пулы рабочих узлов с GPU                         |
        | H100/H200/B200/A100/L40S/etc., CPU, RAM, NVMe,   |
        | NIC, CUDA/runtime, метки, taint, топология       |
        +--------------------------------------------------+
                 |                 |                 |
                 v                 v                 v
        задания обучения    сервисы инференса       пакетные задания
        PyTorch/JAX         vLLM/SGLang/Triton      Ray/Kubeflow
                 \                 |                 /
                  \                |                /
                   v               v               v
        +--------------------------------------------------+
        | сеть и путь данных                               |
        | высокоскоростная сеть, объектное хранилище,       |
        | общая ФС, кэш моделей, контрольные точки,         |
        | журналы, метрики, резервные копии                 |
        +--------------------------------------------------+
Эта схема намеренно упрощена. Реальная архитектура Kubernetes-кластера с GPU будет включать балансировщики нагрузки, частные реестры, границы service mesh, IAM, хранилища артефактов, отслеживание экспериментов и экспорт данных для биллинга. Задача схемы — инициировать один ключевой разговор: какой уровень отвечает за каждый режим отказа?
Шаг 1: определите, подходит ли Kubernetes в качестве плоскости управления GPU
Kubernetes хорошо подходит, когда вашей ИИ-платформе нужны контейнерное развертывание, автоматизация через API, пространства имен для нескольких арендаторов, конечные точки сервисов, политики управления и интеграция с существующими облачно-нативными средствами наблюдаемости.
Обычно Kubernetes подходит для:
- Сервисов онлайн-инференса, которым необходимы поэтапные развертывания, границы автомасштабирования, маршрутизация и проверки работоспособности сервисов.
- Задач пакетного инференса или создания эмбеддингов, запускаемых как Jobs, рабочие нагрузки Ray или пользовательские операторы.
- Задач дообучения и обучения, для которых командам нужна общая инфраструктура вместо отдельных GPU-машин.
- Смешанных платформ, где ноутбуки, задачи обучения, обслуживание моделей и вспомогательные сервисы используют одну операционную модель.
- Команд, которые уже используют Kubernetes и могут расширить существующие системы идентификации, CI/CD, реестров, журналирования и политик.
Kubernetes может быть не лучшим первым выбором, если команде нужен лишь периодический доступ для исследований, разовые пакетные задания в стиле HPC или простое обучение через SSH. В таких случаях Slurm, управляемый сервис обучения, хостинговая среда ноутбуков или прямая аренда GPU могут быстрее дать полезный результат.
Перед созданием Kubernetes-кластера с GPU опишите границы рабочей нагрузки:
| Вопрос | Почему это важно |
|---|---|
| Является ли нагрузка обучением, пакетным инференсом, онлайн-инференсом, ноутбуками или их комбинацией? | Ответ определяет требования к планированию, хранилищу, сети и времени доступности. |
| Нужен ли задаче полный GPU, срез MIG или доступ с разделением по времени? | Совместное использование GPU меняет изоляцию, учет и предсказуемость производительности. |
| Нагрузка одноузловая или многоузловая? | Многоузловое обучение требует проверки сети и размещения, а не только доступности GPU. |
| Каков размер наборов данных, контрольных точек и весов моделей? | Перемещение данных может стать основной составляющей стоимости GPU. |
| Каков бизнес-знаменатель? | Используйте завершенный запуск обучения, принятый результат инференса, задачу генерации медиа или запрос клиента, а не только необработанный GPU-час. |
Для более широкого проектирования системы свяжите этот план реализации с обзором архитектуры GPU-кластера: вычислительные ресурсы, сеть, хранилище и плоскость управления необходимо проектировать совместно.
Шаг 2: проектируйте пулы GPU-узлов вокруг профилей рабочих нагрузок
Kubernetes-кластер с GPU должен иметь продуманные пулы узлов, а не случайный набор машин с ускорителями.
Для каждого пула узлов укажите:
- Модель GPU и объем памяти.
- Количество GPU на узел.
- Сведения о топологии PCIe, SXM, NVLink, NVSwitch или других технологиях, если это применимо.
- Модель CPU, количество CPU, объем RAM и компоновку NUMA.
- Размер и пропускную способность локального NVMe.
- Количество NIC, скорость NIC и тип фабрики.
- Образ ОС, ядро, драйвер, CUDA, среду выполнения контейнеров и процесс обновления.
- Метки Kubernetes, taint'ы, toleration'ы и метки топологии.
- Используют ли рабочие нагрузки полные GPU, MIG, разделение по времени или другой режим совместного использования.
Разделяйте потребности обучения и инференса, если нет веской причины их объединять. Для обучения могут быть важнее производительность all-reduce, пропускная способность контрольных точек и групповое планирование. Для онлайн-инференса могут быть важнее время холодного старта, локальность кэша модели, задержка хвоста распределения и безопасность поэтапного развертывания.
Полезный шаблон именования пула узлов:
gpu-pool:
  accelerator: h100-80gb
  topology: 8gpu-sxm-nvlink
  fabric: infiniband
  workload: distributed-training
  sharing: full-gpu
Эти метки — не просто документация. Они становятся селекторами планирования, измерениями квот, тегами стоимости и контекстом для отладки.
Шаг 3: предоставьте GPU через подходящий механизм Kubernetes
Kubernetes планирует GPU с помощью специализированных механизмов ресурсов. Распространенная базовая конфигурация — предоставляемый вендором плагин устройств, который объявляет GPU-ресурсы kubelet, чтобы pod'ы могли запрашивать их как расширенные ресурсы. Kubernetes описывает модель запросов и ограничения выбора узлов в своем руководстве по планированию GPU. Плагин устройств NVIDIA для Kubernetes является стандартным решением для GPU NVIDIA, а NVIDIA GPU Operator объединяет несколько операционных компонентов, включая управление драйверами и средой выполнения, развертывание плагина устройств, управление MIG и телеметрию GPU.
Для многих команд первым производственным путем является:
node image + kernel prerequisites
  -> NVIDIA driver and container runtime
  -> NVIDIA GPU Operator
  -> Kubernetes device plugin
  -> DCGM exporter metrics
  -> workload namespaces and quotas
Kubernetes Dynamic Resource Allocation также важен для команд, оценивающих более гибкую модель выделения устройств. DRA построен на запросах ресурсов и классах устройств, что может быть полезно, когда простые запросы расширенных ресурсов не позволяют выразить достаточные требования к размещению или конкретным устройствам. Рассматривайте его как осознанный выбор платформы: драйвер, версия Kubernetes, API рабочих нагрузок и подход к наблюдаемости следует тестировать вместе.
Практическое решение заключается в следующем:
| Потребность | Механизм Kubernetes для оценки |
|---|---|
| Базовое планирование подов с целым GPU | Плагин устройств и расширенные ресурсы в стиле nvidia.com/gpu. |
| Управление жизненным циклом NVIDIA GPU | NVIDIA GPU Operator. |
| Телеметрия GPU | Экспортёр DCGM плюс Prometheus/Grafana или ваш стек наблюдаемости. |
| Более выразительные запросы устройств | Kubernetes Dynamic Resource Allocation. |
| Разделение GPU | MIG там, где он поддерживается, с явным учётом ограничений по изоляции и производительности. |
| Доступ для разработки с разделением по времени | Разделение по времени или политика платформы — только после того, как правила изоляции и квот станут ясны. |
Не скрывайте этот уровень от команд разработки приложений. Им необходимо знать, получает ли под целый ускоритель, срез MIG или устройство с разделением по времени, поскольку от этого меняются предположения о производительности и отладке.
Шаг 4: добавьте уровень очередей до того, как команды начнут бороться за GPU
Стандартный планировщик Kubernetes сам по себе не является полноценной многопользовательской очередью для ИИ. Командам ИИ обычно нужны допуск рабочих нагрузок, справедливое распределение, квоты, политика вытеснения и понимание причин, по которым задания ожидают.
Kueue — это Kubernetes-нативный проект, который стоит оценить, когда важна постановка в очередь пакетных задач и задач ИИ/МО. Его ключевые концепции включают рабочие нагрузки, локальные очереди, кластерные очереди, когорты и профили ресурсов. Это позволяет платформенным командам моделировать дефицитные пулы GPU и определять, какие задания будут допущены при наличии ресурсов.
Volcano — ещё один вариант пакетного планирования Kubernetes для ИИ, больших данных и нагрузок в стиле HPC. Его планировщик групповых задач использует условие минимального числа подов по принципу «всё или ничего», которое стоит рассмотреть для распределённых заданий, иначе способных впустую занимать частично выделенные GPU в ожидании остальных участников.
Для кластера Kubernetes с GPU для инфраструктуры ИИ зафиксируйте политику очередей письменно:
| Политика | Решение, которое нужно принять |
|---|---|
| Допуск | Какие задания могут попасть в очередь и какие метаданные обязательны? |
| Справедливое распределение | Как GPU распределяются между командами, проектами или средами? |
| Приоритет | Какие задания производственного инференса или критически важного запуска обучения могут пройти вне очереди? |
| Вытеснение | Можно ли вытеснять задания и как требуется создавать контрольные точки перед вытеснением? |
| Профили ресурсов | Какие пулы GPU взаимозаменяемы, а какие — нет? |
| Заполнение свободных ресурсов | Могут ли выполняться меньшие задания, пока ожидает крупный распределённый запуск? |
| Прозрачность | Могут ли пользователи видеть позицию в очереди и причины отказа, не обращаясь к платформенным инженерам? |
Политика очередей — это механизм контроля затрат. Без неё самая активная команда может потреблять самые дорогие мощности, пока меньшие задания ждут или переносятся в неуправляемую теневую инфраструктуру.
Шаг 5: выберите API рабочих нагрузок для обучения и инференса
Кластер Kubernetes с GPU наиболее полезен, когда команды разработки приложений могут отправлять рабочие нагрузки без необходимости каждый раз вручную писать низкоуровневые спецификации подов.
Для обучения оцените:
- Нативные Kubernetes Jobs для простых запусков на одном узле.
- Kubeflow Trainer для распределённых рабочих процессов обучения в разных фреймворках.
- Ray и KubeRay для распределённого Python, пакетного инференса и паттернов обслуживания.
- Интеграцию с Volcano или Kueue, когда требуется групповое планирование или допуск через очередь.
- Пользовательские операторы — только если у платформы есть стабильные внутренние паттерны, которые не покрывают универсальные инструменты.
Для инференса оцените:
- Deployments или StatefulSets для простых сервисов.
- Контейнеры обслуживания vLLM, SGLang, Triton или TensorRT-LLM в зависимости от модели и целей производительности.
- KServe или другой уровень обслуживания моделей, когда командам нужны абстракции жизненного цикла моделей.
- Правила горизонтального и вертикального масштабирования на основе глубины очереди, задержки, памяти GPU и состава запросов.
- Отдельные пулы узлов для чувствительного к задержкам производственного трафика и пакетных рабочих нагрузок.
На первом этапе API рабочих нагрузок должен быть простым. Понятный шаблон Job с метками, запросами ресурсов, монтированиями хранилища и экспортом логов лучше сложной платформы, которую никто не может отладить.
Шаг 6: проверьте сетевой путь и путь к хранилищу
Разница между работающей демонстрацией и производственной ИИ-инфраструктурой кластера Kubernetes с GPU часто проявляется при тестировании сети и хранилища.
Для распределённого обучения проверьте:
- Размещение между узлами.
- Поведение NCCL all-reduce на всех предполагаемых узлах.
- Ошибки фабрики, повторные передачи, перегрузку и вариативность между узлами.
- Версии драйвера, CUDA, NCCL и образа контейнера.
- Производительность после установки производственного образа контейнера, а не только на чистом образе для бенчмаркинга.
Для хранилища проверьте:
- Время подготовки набора данных.
- Загрузка весов модели и прогрев кэша.
- Частота и длительность записи контрольных точек.
- Время восстановления после сбоя узла или пода.
- Поведение общей файловой системы при одновременном выполнении заданий.
- Регион объектного хранилища, исходящий трафик и правила жизненного цикла.
Минимальный приемочный тест выглядит так:
1. Отправьте в очередь задание на обучение с производственным контейнером.
2. Загрузите реальный образец набора данных и базовые веса модели.
3. Запустите тест производительности многoузловой связи, если нагрузка распределенная.
4. Обучайте или дообучайте в течение фиксированного периода.
5. Запишите контрольную точку, удалите под и восстановитесь из контрольной точки.
6. Экспортируйте метки GPU, сети, хранилища, очереди и стоимости.
7. Сравните полезную работу с базовым вариантом модели/API или аренды GPU.
Этот тест следует провести до оформления долгосрочных резервирований или принятия крупных финансовых обязательств. Обнаружить слабую сетевую фабрику или медленный путь записи контрольных точек во время бенчмарка дешевле, чем в период запуска.
Инструменты управления Kubernetes-кластером с GPU
Выражение kubernetes gpu cluster management tools охватывает несколько разных задач. Не покупайте и не устанавливайте инструменты, пока не определите выполняемую ими задачу.
| Потребность в управлении | Инструменты или проекты для оценки | Как выглядит «хороший» результат |
|---|---|---|
| Жизненный цикл GPU | NVIDIA GPU Operator, device plugin, автоматизация образов узлов | Драйверы, среда выполнения, доступность устройств и телеметрия воспроизводимы на всех узлах. |
| Постановка в очередь | Kueue, Volcano, шаблоны отправки заданий Ray | Пользователи ясно видят состояния: допущено, ожидает, выполняется, не выполнено и завершено. |
| Рабочие процессы обучения | Kubeflow Training Operator, Ray, нативные Jobs | Распределенные задания воспроизводимы и не требуют каждый раз специализированного YAML для подов. |
| Обслуживание инференса | vLLM, SGLang, Triton, KServe, Deployments | Видимы развертывания, проверки работоспособности, задержки и поведение кэша моделей. |
| Наблюдаемость | DCGM exporter, Prometheus, Grafana, журналы, трассировки, события Kubernetes | Метрики GPU связаны с метками задания, команды, модели и стоимости. |
| Политики | RBAC, ResourceQuota, LimitRange, средства контроля допуска, политика образов, сетевая политика | Доступ нескольких арендаторов ограничен без блокирования обычной разработки. |
| Распределение затрат | Метки пространства имен, метки рабочих нагрузок, экспорт использования, панель биллинга | Финансовая команда может сопоставить расходы с командой, средой, моделью и принятым результатом. |
Избегайте платформы, которая сообщает только о выделенных GPU-часах. Полезное управление показывает, почему GPU простаивали, какие неудачные задания потребили ресурсы и оправдали ли расходы результаты инференса или этапы обучения.
Вопросы о Kubernetes-кластере с GPU CoreWeave
Некоторые команды ищут coreweave kubernetes gpu cluster, поскольку хотят получить Kubernetes-нативный доступ к облачным GPU-мощностям, а не к обычным виртуальным машинам. Рассматривайте этот уточненный по провайдеру запрос как повод для комплексной проверки: для CoreWeave или любого аналогичного облачного провайдера GPU подтвердите точную модель доступа к Kubernetes, элементы управления пулами узлов, совместимость операторов, экспорт квот и границы поддержки, прежде чем переносить в производство рабочие нагрузки.
Проводите такую же комплексную проверку для любого провайдера:
| Вопрос | Почему это важно |
|---|---|
| Какие SKU GPU и конфигурации узлов действительно доступны в запрошенном регионе? | Заявленный в маркетинговых материалах инвентарь и доступная для выделения емкость — не одно и то же. |
| Однородны ли узлы в рамках резервирования или пула? | Смешанные узлы могут нарушить предположения о производительности. |
| Какая сетевая фабрика используется между GPU-узлами? | Многоузловое обучение зависит от размещения и поведения сети. |
| Кто отвечает за обновления драйверов, CUDA и Kubernetes? | Границы обновлений влияют на простои и воспроизводимость. |
| Можете ли вы запускать GPU Operator, Kueue, Volcano, Ray или необходимые вам операторы? | Управляемому Kubernetes по-прежнему нужна совместимость с платформой. |
| Как предоставляются квоты, экспорт использования и метки? | Финансовым и платформенным командам необходимо распределение затрат. |
| Какой путь поддержки предусмотрен при сбоях распределенных запусков? | До выхода в производство вам необходимы журналы, идентификация узлов и эскалация. |
| Каков путь выхода для данных, весов моделей и контрольных точек? | Стоимость миграции должна учитываться в архитектурном решении. |
Kubernetes от провайдера не отменяет необходимости приемочного тестирования. Он меняет, какими уровнями вы управляете напрямую, а какие проверяете на основе свидетельств уровня сервиса.
Контрольный список безопасности и мультитенантности
GPU-кластеры часто быстро становятся общей инфраструктурой. Безопасность необходимо спроектировать до того, как кластер начнет использовать вторая команда.
Минимальные меры контроля:
- Пространство имён для каждой команды, среды или границы рабочей нагрузки.
- RBAC, связанный с вашим поставщиком идентификации.
- ResourceQuota и LimitRange для GPU, CPU, памяти и хранилища.
- Явная политика для привилегированных подов, монтирования хоста, сетей хоста и доступа к устройствам.
- Управление секретами и их ротация.
- Политика для частного реестра образов, подпись, сканирование или проверки допуска.
- Сетевая политика для исходящего трафика, доступа к наборам данных и границ сервисов.
- Журналы аудита для отправки заданий, доступа к секретам, использования образов и административных действий.
- Правила очистки данных для локальных NVMe, временных томов, контрольных точек, журналов и неудачных заданий.
Если кластер обрабатывает данные клиентов или проприетарные веса моделей, рассматривайте рабочие узлы как чувствительную инфраструктуру. Под с доступом к GPU также может иметь доступ к ценным данным, артефактам моделей и учётным данным.
Наблюдаемость и модель затрат
Для рабочего kubernetes gpu cluster одновременно необходимы три представления:
- Представление платформы: состояние узлов, состояние GPU, сеть, хранилище, состояние очередей, события Kubernetes.
- Представление рабочей нагрузки: владелец задания, образ, модель, набор данных, среда выполнения, число повторных попыток, причина завершения, качество результата.
- Финансовое представление: выделенное время GPU, полезное время GPU, время простоя, затраты на неудачные задания, стоимость на принятую единицу.
Отслеживайте как минимум:
- Загрузку GPU, память GPU, энергопотребление, температуру и события ошибок.
- Метки подов, заданий, пространств имён, пулов узлов, моделей и команд.
- Время ожидания в очереди и причину допуска.
- Пропускную способность обучения, длительность создания контрольных точек и время восстановления.
- Задержку инференса, пропускную способность, размер батча, долю попаданий в кэш и частоту ошибок.
- Пропускную способность хранилища и время передачи в объектное хранилище.
- Сбои узлов, вытеснения, прерывания и повторные попытки.
Затем нормализуйте затраты:
effective_kubernetes_gpu_cluster_cost =
  (compute + network + storage + support + idle + failed_runs + operations)
  / accepted_workload_units
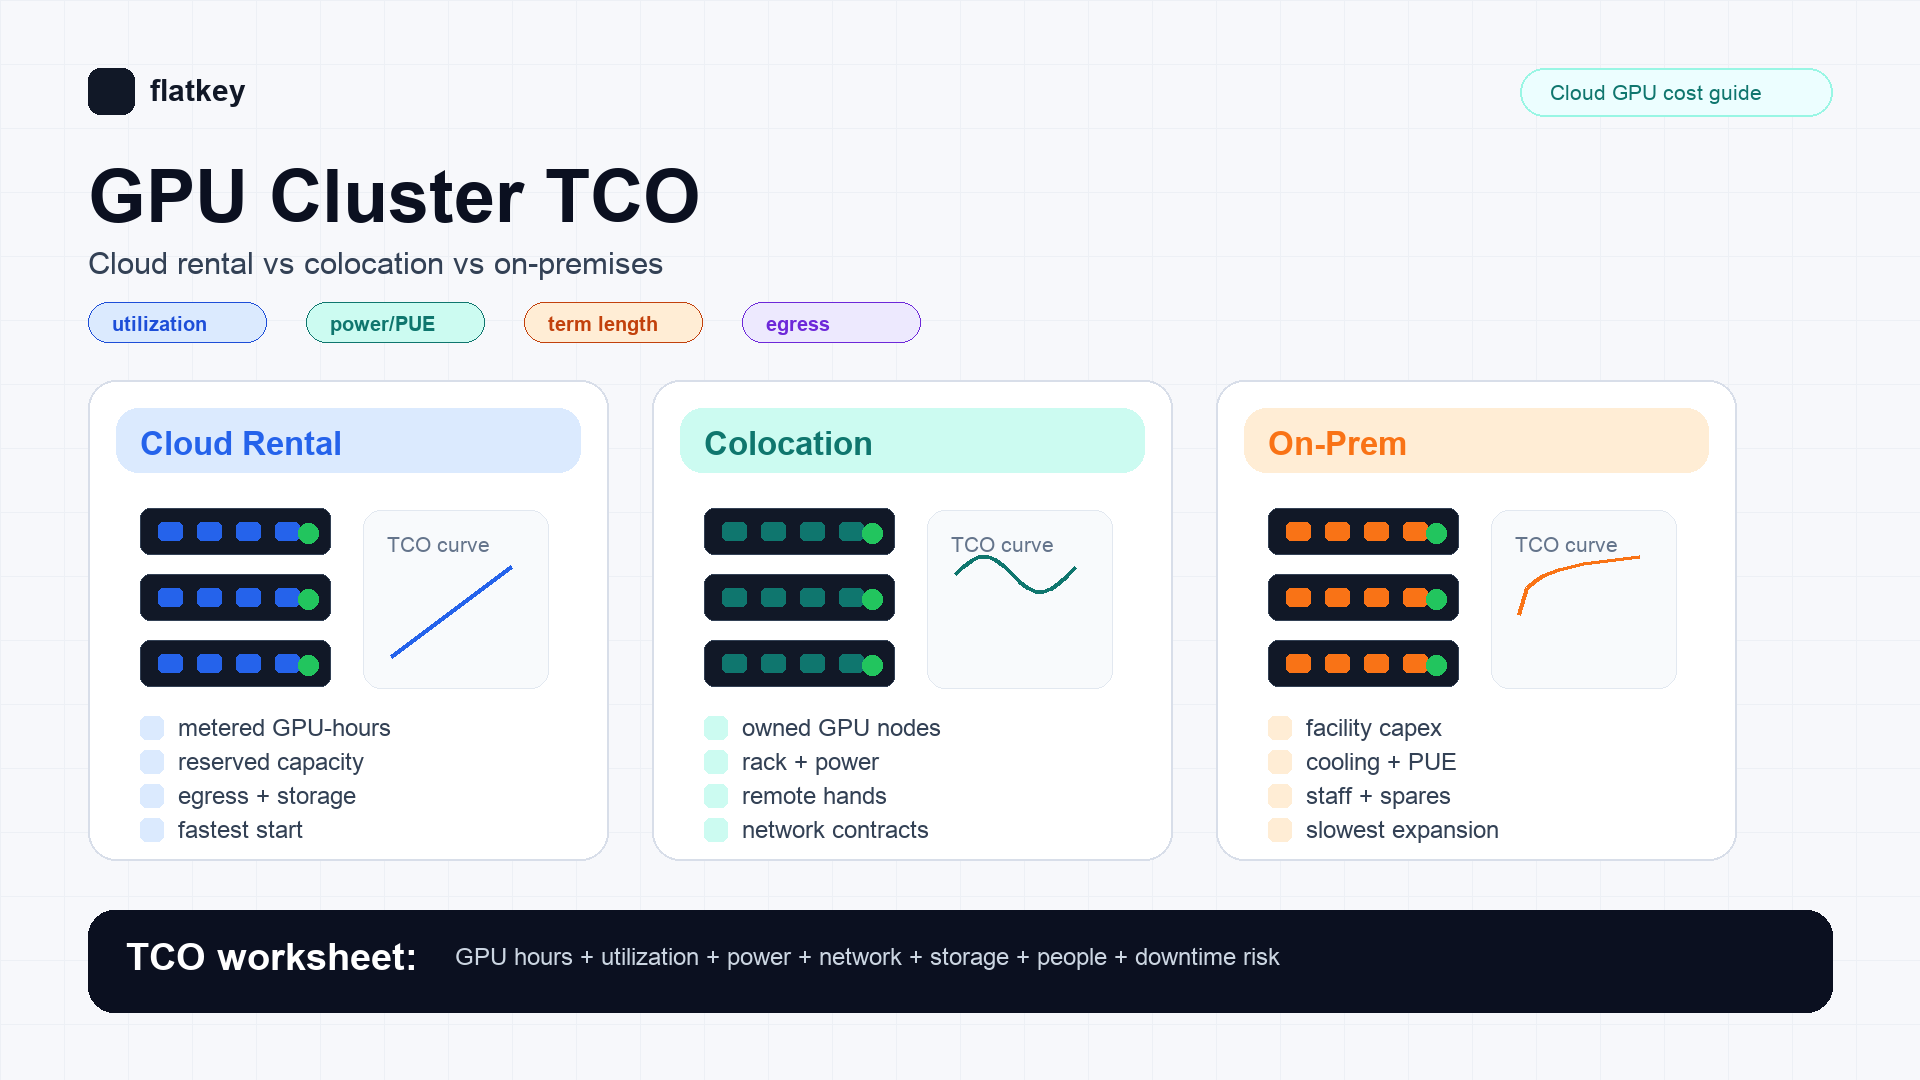
Знаменатель должен соответствовать бизнесу: завершённые запуски обучения, принятые результаты модели, задания по генерации медиа, пакеты индексации или запросы клиентов. Для более глубокого анализа затрат используйте таблицу GPU cluster TCO и сравните с GPU cloud vs model API перед расширением кластера.
Контрольный список реализации
Используйте его как порядок сборки первого производственного этапа:
| Этап | Результат | Условие прохождения |
|---|---|---|
| Описание рабочей нагрузки | Одностраничная спецификация рабочей нагрузки | Команда согласовала модель, фреймворк, данные, масштаб, SLA и знаменатель затрат. |
| Пул узлов | Спецификация и метки GPU-узлов | Документированы конфигурация узлов, топология, драйвер, среда выполнения и политика обновлений. |
| Предоставление GPU | Установлен device plugin или GPU Operator | Поды могут запрашивать GPU, а метрики DCGM доступны. |
| Постановка в очередь | Kueue, Volcano или документированная политика планирования | Пользователи могут отправлять задания и видеть состояние очереди/допуска. |
| Хранилище | Пути к наборам данных, кэшу моделей, контрольным точкам и журналам | Тест восстановления проходит после принудительного сбоя пода или узла. |
| Сеть | Тест фабрики и тест производственного трафика | Распределённый бенчмарк или путь инференса соответствует порогу рабочей нагрузки. |
| Безопасность | RBAC, пространства имён, квоты, секреты, политика образов | Новая команда может подключиться без доступа cluster-admin. |
| Наблюдаемость | Дашборды и экспорт использования | Операторы могут ответить, кто использовал какие GPU и почему задания завершились ошибкой. |
| Приёмка | Сквозной запуск рабочей нагрузки | Полезный результат превосходит или оправдывает базовый вариант с моделью/API или арендой. |
Не масштабируйтесь с 8 GPU до 80 GPU, пока этот контрольный список не станет рутиной. Рутина — это цель: повторяемая отправка заданий, предсказуемое размещение, известное восстановление после сбоев, прозрачные затраты и чёткое распределение ответственности.
Распространённые ошибки
- Покупка GPU-мощностей до проверки перемещения данных и восстановления контрольных точек.
- Рассмотрение device plugin как всей платформы.
- Смешивание обучения и производственного инференса в одном пуле узлов без правил приоритетов и изоляции.
- Разрешение каждой команде писать уникальные спецификации подов без общих меток.
- Отслеживание выделенного времени GPU без отслеживания полезной работы.
- Откладывание политики очередей до тех пор, пока кластер уже не будет перегружен.
- Предположение, что управляемый Kubernetes означает управляемую ИИ-инфраструктуру.
- Запуск бенчмарков на чистом образе, а production — на другом образе.
- Отсутствие плана выхода для наборов данных, весов, контрольных точек и журналов.
Эти ошибки дорого обходятся, поскольку расходуют дефицитное время GPU без получения принятых результатов работы.
Часто задаваемые вопросы
Что такое Kubernetes-кластер с GPU?
Kubernetes-кластер с GPU — это кластер Kubernetes с рабочими узлами, поддерживающими GPU, а также настроенными предоставлением устройств, политикой планирования, хранилищем, сетью и наблюдаемостью, чтобы поды и задания могли использовать ускорители для обучения, инференса, пакетной обработки или исследовательских нагрузок.
Нужен ли NVIDIA GPU Operator?
Не всегда, но многие Kubernetes-платформы с GPU на базе NVIDIA рассматривают его, поскольку он объединяет драйвер, среду выполнения, device plugin, MIG и компоненты телеметрии в управляемый оператором рабочий процесс. Некоторые управляемые поставщики берут на себя части этого стека, поэтому перед самостоятельной установкой уточните границу ответственности.
Нужен ли Kueue для Kubernetes-кластера с GPU?
Kueue нужен не для каждого кластера, но его стоит оценить, когда ограниченные GPU-ресурсы совместно используются командами или пакетными задачами ИИ. Без уровня очередей пользователям часто не хватает прозрачности в отношении того, почему задачи ожидают или почему отклоняются квоты.
Может ли Kubernetes выполнять обучение на нескольких узлах?
Да, но обучение на нескольких узлах требует большего, чем планирование GPU. Вам необходимы размещение, проверка высокоскоростной сети, совместимые контейнеры, контрольные точки и зачастую очереди или поведение gang scheduling. Протестируйте точный пул узлов и производственный образ, прежде чем выделять большие мощности.
Должны ли инференс и обучение использовать один и тот же GPU-кластер?
Могут, но только при наличии четко определенных пулов узлов, правил приоритета, квот и изоляции. У промышленного инференса обычно есть требования к задержке и доступности, которые конфликтуют с крупными задачами обучения. Начинайте с раздельных кластеров, если не можете подтвердить работоспособность общей политики под нагрузкой.
Когда следует использовать API модели вместо Kubernetes-кластера с GPU?
Сначала используйте API модели, если вам нужны только результаты работы модели, набор используемых моделей часто меняется, загрузка низкая или ваша команда не готова эксплуатировать драйверы GPU, очереди, хранилище, мониторинг и устранять инциденты. Создавайте кластер, когда контроль, конфиденциальность, пользовательские веса или экономика рабочих нагрузок оправдывают операционную нагрузку.
Официальные ссылки
- Kubernetes: планирование GPU
- Kubernetes: плагины устройств
- Kubernetes: динамическое выделение ресурсов
- Kubernetes: назначение подов узлам
- NVIDIA GPU Operator
- NVIDIA: установка GPU Operator
- NVIDIA: установка DCGM Exporter
- Концепции Kueue
- Volcano Gang Scheduling
- Обзор Kubeflow Trainer
Итог
kubernetes gpu cluster стоит создавать, когда Kubernetes обеспечивает для вашей ИИ-инфраструктуры лучший контроль над размещением, повторяемостью, безопасностью, наблюдаемостью и затратами, чем разрозненные GPU-машины или управляемые API. Начните с узкой рабочей нагрузки, подтвердите работоспособность пула узлов, корректно предоставьте доступ к GPU, добавьте очереди до начала конкуренции за ресурсы и измеряйте полезный результат, а не простое выделение GPU.
Если кластер не превосходит более простой вариант аренды GPU или использования модели/API по объему принятых задач, не расширяйте его. Если превосходит, Kubernetes становится плоскостью управления, которая превращает дефицитные ускорители в общую ИИ-платформу.