
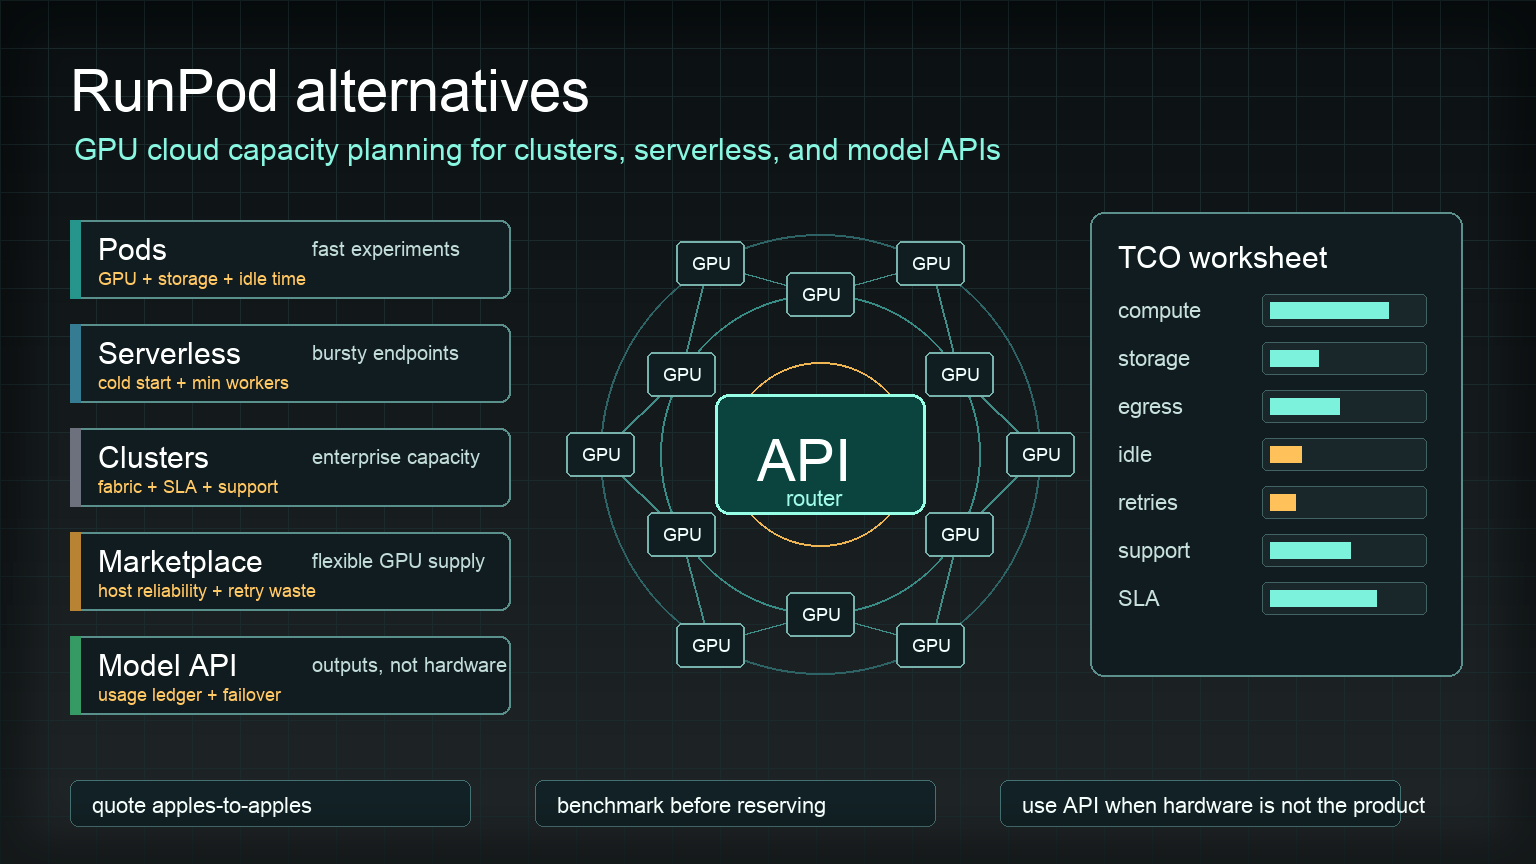
RunPod-Alternativen kommen meist dann ins Gespräch, nachdem der erste Prototyp erfolgreich gelaufen ist. Ein Entwickler bekommt auf RunPod einen ComfyUI-Workflow, ein Fine-Tuning, ein Batch-Inference-Skript oder einen vLLM-Endpunkt zum Laufen; danach stellt das Team eine schwierigere Frage: Kann daraus Produktionskapazität mit planbaren Kosten, Support, Speicher, Netzwerk, Sicherheit und Beschaffungsbedingungen werden?
Die Antwort hängt davon ab, was Sie ersetzen. Ein RunPod-Pod, ein RunPod-Serverless-Endpunkt, eine sichere GPU-Instanz, eine Community-GPU und ein Enterprise-Kapazitätsgespräch sind unterschiedliche Beschaffungsmodelle. Die passenden RunPod-Alternativen für einen ComfyUI-Batch am Wochenende sind nicht dieselben wie die richtigen Alternativen für einen privaten H100-Cluster, einen Multi-Node-Trainingsjob oder einen kundenorientierten Inference-Dienst.
Dieser Leitfaden vergleicht RunPod-Alternativen für Entwickler und kleine bis mittlere KI-Teams, die mehr brauchen als eine billige GPU-Stunde. Er behandelt GPU-Cloud-Anbieter, Marktplätze, Hyperscaler, verwaltete Inference-Plattformen und Model-API-Ansätze und gibt Ihnen dann ein Arbeitsblatt an die Hand, um die Total Cost of Ownership statt der bloßen Stundenpreise zu vergleichen. Wenn Sie zuerst das breitere Preismodell benötigen, beginnen Sie mit Flatkeys Leitfaden zu GPU-Mietpreisen.
Die kurze Antwort: die besten RunPod-Alternativen nach Workload
Nutzen Sie diese Tabelle, um die erste Shortlist zu erstellen. Betrachten Sie sie als Entscheidungskarte, nicht als universelles Ranking.
| Workload | Starke RunPod-Alternativen zur Bewertung | Warum sie passen | Was vor dem Wechsel zu prüfen ist |
|---|---|---|---|
| ComfyUI-Experimente und Bild-Batches | Vast.ai, TensorDock, Hyperstack, Paperspace/DigitalOcean, RunPod Community Cloud, wenn Sie bleiben | Schneller GPU-Zugriff, Marktplatz- oder Self-Service-Ökonomie, gut geeignet für flexible Batch-Arbeiten | Persistenter Speicher, Startzeit, Zuverlässigkeit des Hosts, Bandbreite, Neustart-Workflow, ob die GPU für Produktionsdaten geeignet ist |
| Stabiles Single-Node-Inference | Lambda Cloud, Hyperstack, Massed Compute, Nebius, Vultr, AWS/GCP/Azure GPU-VMs | Saubereres Instanzmodell, breitere Beschaffungswege, besser vorhersehbare Infrastrukturkontrollen | GPU-Verfügbarkeit, Region, Support, Festplatten-/Netzwerkkosten, Quota, Observability, Autoscaling |
| Dedizierte GPU-Cluster | Lambda reservierte Cluster, CoreWeave, Crusoe Cloud, Massed Compute, Nebius, AWS Capacity Blocks, Google Cloud Reservierungen, Azure ND-Serie | Besser geeignet für zugesicherte Kapazität, Support, privates Networking und die Planung von Multi-Node-Clustern | Netzwerk-Fabric, Platzierungsgarantie, Support-SLA, Laufzeit, Upgrade-Pfad, Break-even bei Auslastung |
| Serverless-Inference-Endpunkte | Replicate, dedizierte Endpunkte von Together AI, Plattformen im Stil von Modal, Cloud Functions mit GPU-Unterstützung, RunPod Serverless, wenn Sie bleiben | Gut, wenn Sie eher bereitgestelltes Inference-Verhalten als rohe VM-Kontrolle benötigen | Cold Starts, Mindestanzahl an Workern, nutzungsabhängige Preisgestaltung, Grenzen beim Modell-Packing, Logs, Datenrichtlinie |
| Frontier-Model- oder Multi-Model-API-Nutzung | Flatkey, Router im Stil von OpenRouter, First-Party-Model-APIs | Vermeidet GPU-Betrieb, wenn der Wert im Output liegt und nicht in der Hardwarekontrolle | Modellverfügbarkeit, offizielle Endpunkte, Fallback-Verhalten, Nutzungsprotokoll, Budgetkontrollen, Datenrichtlinie |
Für die meisten Teams sind die besten RunPod-Alternativen nicht ein einzelner Anbieter. Es ist eine aufgeteilte Architektur:
- Nutzen Sie Marketplace-GPUs für Experimente und unregelmäßige Media-Batches.
- Nutzen Sie eine spezialisierte GPU-Cloud oder einen Hyperscaler für stabile Produktionskapazität.
- Nutzen Sie eine Model-API oder einen Router, wenn das Produkt keine direkte Kontrolle über Gewichte, Kernel oder GPU-Platzierung benötigt.
Diese Aufteilung verhindert, dass ein Workload allen anderen Workloads das falsche Infrastrukturmodell aufzwingt.
Wann RunPod immer noch gut passt
Dies ist kein Artikel nach dem Motto „RunPod ist schlecht“. RunPod ist beliebt, weil es die Einrichtungszeit verkürzt. Entwickler können GPU-Pods starten, Notebooks und Container ausführen, mit Community- oder Secure-Kapazität experimentieren und Serverless-Endpunkte nutzen, ohne mit einem Hyperscaler-Beschaffungsprozess zu beginnen.
RunPod ist oft weiterhin eine gute Wahl, wenn:
- Sie schnellen GPU-Zugriff für Experimente benötigen.
- Sie ComfyUI, Stable Diffusion, LoRA-Workflows oder die Generierung von Medien in Batches testen.
- Sie eine einfache Pod-basierte Entwicklung möchten, bevor Sie einen Produktions-Cluster entwerfen.
- Sie während der Erkundungsphase einige Infrastruktur-Variationen tolerieren können.
- Ihr Workload ohne schwerwiegenden Kundenvorfall neu gestartet oder neu aufgebaut werden kann.
Ein Wechsel wird in der Regel dann sinnvoll zu prüfen, wenn der Workload teuer, dauerhaft, sicherheitskritisch, latenzsensitiv oder für die Beschaffung relevant wird. Ab diesem Punkt sollten Sie RunPod-Alternativen nach Workload-Fit und nicht nach Markenvertrautheit vergleichen.
Vergleichsrahmen für RunPod-Alternativen
Beginnen Sie mit dieser normalisierten Formel:
effektive Kosten pro akzeptiertem Workload =
  Compute
  + Speicher
  + Snapshots
  + Bandbreite und Egress
  + Leerlaufzeit
  + Cold Starts
  + fehlgeschlagene Jobs und Retries
  + Support
  + Engineering-Overhead
  / akzeptierte Tokens, Jobs, Bilder, Videos, Fine-Tunes oder Kundenanfragen
Stellen Sie dann sechs Fragen, bevor Sie Anbieter vergleichen.
| Frage | Warum sich dadurch die Antwort ändert |
|---|---|
| Brauchen Sie GPU-Kontrolle oder nur KI-Ausgaben? | Wenn Sie nur generierten Text, Bilder, Embeddings oder Transkriptionen benötigen, kann ein API-Weg operativ günstiger sein als das Mieten von GPUs. |
| Ist die Arbeitslast interaktiv oder batch-orientiert? | Interaktive Inferenz benötigt p95/p99-Latenz und Verfügbarkeit. Batch-Jobs können Warteschlangenzeit gegen geringere Kosten eintauschen. |
| Ist der Job unterbrechbar? | Marketplace- und Spot-ähnliche Kapazitäten können für Jobs mit Checkpoints funktionieren; für lange, zustandsbehaftete Jobs können sie gefährlich sein. |
| Passt das Modell auf eine GPU? | Workloads mit mehreren GPUs und mehreren Knoten erhöhen Risiken bei Topologie, Netzwerk, Scheduler und Platzierung. |
| Ist die Auslastung vorhersehbar? | Reservierte oder dedizierte Kapazität benötigt genügend Basisauslastung, um On-Demand zu schlagen. |
| Wer übernimmt den Betrieb? | GPU-Treiber, CUDA-Images, vLLM/SGLang, Storage-Bereinigung, Observability und Incident Response sind Teil der tatsächlichen Kosten. |
Hier werden viele Vergleiche zu RunPod-Alternativen oberflächlich. Eine Liste von Anbietern reicht nicht aus. Sie brauchen ein Beschaffungsmodell. Für Multi-Node-Kapazität sollten Sie diesen Artikel mit der Checkliste zum GPU-Cluster-Mieten kombinieren.
GPU-Cloud-Alternativen zu RunPod
Lambda Cloud
Lambda Cloud ist eine der klarsten RunPod-Alternativen, wenn Sie eine spezialisierte GPU-Cloud mit veröffentlichten GPU-Instanzoptionen und einem konventionelleren Infrastruktur-Beschaffungsprozess suchen. Sie ist eine sinnvolle Option für H100, H200, B200, A100 und andere NVIDIA-Kapazitäten, wenn sich Ihre Workloads von Experimenten hin zu reproduzierbarem Training oder Inferenz entwickeln.
Nutzen Sie Lambda, wenn Sie Folgendes möchten:
- Unkomplizierte GPU-Cloud-Instanzen.
- Einen spezialisierten KI-Infrastruktur-Anbieter statt eines breiten Hyperscalers.
- Einen Weg von On-Demand-Experimenten hin zu reservierter oder zugesicherter Kapazität.
- Einen Quelleneintrag, den die Beschaffung schnell verstehen kann.
Prüfen Sie die aktuelle Verfügbarkeit der Instanzen, die exakte GPU-Variante, lokalen Speicher, Region, Support und ob das Angebot On-Demand, reserviert oder clusterorientiert ist. Nutzen Sie die offizielle Seite Lambda GPU Cloud als Quellen-Checkpoint und fordern Sie anschließend ein Angebot an, wenn Sie dedizierte Kapazität benötigen. Für Kompromisse zwischen GPU-Familien siehe den Flatkey-Leitfaden beste GPU für LLM-Inferenz.
CoreWeave
CoreWeave ist eine starke RunPod-Alternative für Teams, die über einen einzelnen Pod hinausgewachsen sind und GPU-Cloud-Kapazität in großem Maßstab benötigen. Sie ist für produktive KI-Workloads, dedizierte Umgebungen und Enterprise-GPU-Beschaffung relevanter als für einmalige Hobby-Experimente.
Bewerten Sie CoreWeave, wenn:
- Sie Produktions-GPU-Infrastruktur statt eines einfachen Dev-Pods benötigen.
- Ihnen Kubernetes-native Abläufe, Speicher, Netzwerke und Support wichtig sind.
- Sie nachhaltige Inferenz-, Trainings- oder KI-Medienkapazität planen.
- Sie ein Anbietergespräch über zugesicherte Kapazitäten und Enterprise-Konditionen benötigen.
Der Kompromiss besteht darin, dass CoreWeave normalerweise nicht der leichtgewichtigste Weg für ein kleines Experiment ist. Es gehört auf die Shortlist, wenn Kapazitätsplanung, Support und Produktionszuverlässigkeit wichtiger sind als der schnellstmögliche erste Pod.
Crusoe Cloud
Crusoe Cloud ist einen Vergleich wert für KI-Teams, die dedizierte oder skalierbare GPU-Infrastruktur mit Enterprise-Beschaffung und nachhaltigkeitsorientierter Positionierung suchen. Es gehört häufig in dieselbe Shortlist wie Lambda, CoreWeave, Nebius und Massed Compute für Kapazitätsgespräche.
Nutzen Sie Crusoe als RunPod-Alternative, wenn:
- Sie nach Cluster-Kapazität statt nach einmaliger GPU-Miete fragen.
- Sie ein Anbieterangebot mit Support-, Region- und Kapazitätskonditionen benötigen.
- Sie eine spezialisierte Cloud-Diskussion statt eines Quotenprozesses bei einem Hyperscaler möchten.
Prüfen Sie das exakte GPU-Modell, Interconnect, Speicher, Supportumfang und ob Ihr Workload selbstverwaltetes Kubernetes, Slurm oder eine verwaltete Umgebung benötigt.
Massed Compute
Massed Compute ist ein nützlicher Vergleichspunkt für Käufer, die veröffentlichte GPU-Preise plus einen Weg zu reservierter oder dedizierter Kapazität suchen. Es ist eine praktische RunPod-Alternative für Teams, die einfache GPU-Cloud-Ökonomie benötigen, aber bereits Enterprise-Fragen stellen.
Bewerten Sie Massed Compute, wenn:
- Sie H100-/A100-/L40S-Kapazität mit einem klaren öffentlichen Ausgangspunkt benötigen.
- Sie On-Demand-GPU-Raten mit längerfristigen Verpflichtungen vergleichen möchten.
- Sie ein Beschaffungs-Worksheet für einen dedizierten Cluster oder einen Basis-Inferenzpool erstellen.
Nutzen Sie die offizielle Preisseite von Massed Compute als aktuelle Quelle und fragen Sie dann nach, was in Support, Netzwerken, Speicher und reservierten Konditionen enthalten ist.
Nebius AI Cloud
Nebius ist eine glaubwürdige RunPod-Alternative, wenn der Käufer eine KI-native Cloud mit verwalteten Infrastrukturdiensten rund um GPUs möchte, nicht nur rohe Server. Sie ist besonders relevant, wenn Ihr Team eine Cloud-Plattform für Modellentwicklung, Inferenz, Daten und Orchestrierung statt isolierter Instanzen sucht.
Bewerten Sie Nebius, wenn:
- Sie eine breitere KI-Cloud-Umgebung benötigen.
- Ihnen Kubernetes, verwaltete Dienste, Speicher und Netzwerke rund um GPU-Workloads wichtig sind.
- Sie Alternativen außerhalb der üblichen US-Hyperscaler-Shortlist möchten.
Für die TCO sollten Sie Regionverfügbarkeit, Support, Speicher, Network Egress, Kontingent, Reservierungsmechanik und GPU-Generation prüfen.
Hyperstack
Hyperstack ist eine direkte RunPod-Alternative für Teams, die GPU-Cloud-Anbieter nach Instanztyp, Stundenpreis und Self-Service-Deployment vergleichen. Es ist nützlich für schnellen Zugriff auf NVIDIA-GPU-Instanzen, ohne sich auf eine große Cloud-Plattform einzulassen.
Verwenden Sie Hyperstack, wenn:
- Sie einen einfachen GPU-Cloud-Anbieter für Experimente, Inferenz oder Batch-Jobs möchten.
- Sie die Verfügbarkeit von H100, H200, A100, L40S, RTX-Klasse oder neueren GPUs vergleichen.
- Sie vor dem Gespräch mit dem Vertrieb einen öffentlichen Preis-Abgleich benötigen.
Verwenden Sie die offizielle Seite Hyperstack GPU pricing als Quellen-Abgleich. Prüfen Sie trotzdem Speicher, Bandbreite, Verfügbarkeitsanforderungen, Support und ob Ihre genaue GPU/Region verfügbar ist, wenn der Job startet.
Vultr Cloud GPU
Vultr gehört auf die Liste der RunPod-Alternativen, wenn Ihr Team einen bekannten Cloud-Anbieter mit GPU-Optionen, globalen Regionen und einer einfacheren Infrastrukturpaketierung als ein reiner GPU-Marktplatz sucht. Das kann für Teams attraktiv sein, die bereits Cloud-VMs nutzen und GPU-Kapazität ohne ein neues Betriebsmodell einführen möchten.
Bewerten Sie Vultr, wenn:
- Ihre Workload eher einer herkömmlichen VM als einem komplexen Cluster entspricht.
- Sie globale Cloud-Infrastruktur plus GPU-Beschleunigung benötigen.
- Sie einen Anbieter möchten, der zu bestehenden Cloud-Betriebsabläufen passt.
Prüfen Sie Kontingent, GPU-Familie, Region, persistente Speicherung, Egress, Support und ob die Workload eine High-End-Interconnect-Lösung benötigt, die eine einfache GPU-VM nicht bereitstellen kann.
Marktplatz-Alternativen zu RunPod
Vast.ai
Vast.ai ist eine der gängigsten RunPod-Alternativen für Entwickler, die flexible GPU-Verfügbarkeit und niedrige Einstiegskosten suchen. Es ist ein Marktplatz, daher ist der Anbieter-Vergleich nicht nur Vast.ai gegen RunPod. Es ist jeder Host, jede GPU, jeder Standort, jeder Zuverlässigkeitswert, jeder Datenträger, jedes Netzwerk und jedes Unterbrechungsprofil im Vergleich zu Ihrer Workload.
Vast.ai passt oft gut für:
- ComfyUI-Experimente.
- Batch-Bilderzeugung.
- Kurzzeitige Forschungsjobs.
- Flexible Inferenztests.
- Workloads, die Checkpoints speichern und erneut versuchen können.
Es ist schwächer bei Workloads, die vorhersehbaren Support, Compliance, private Netzwerke oder strikte Verfügbarkeit für Kunden benötigen. Verwenden Sie die offizielle Seite Vast.ai pricing als aktuellen Marktplatz-Abgleich, aber vergleichen Sie niemals nur den stündlichen GPU-Preis.
TensorDock
TensorDock ist eine weitere RunPod-Alternative im Marktplatz-Stil. Die offizielle GPU-Cloud-Seite beschreibt einen Marktplatz unabhängiger Hosts, die konkurrieren und Preise festlegen, was bedeutet, dass Käufer jede Bereitstellungsoption einzeln bewerten sollten, anstatt TensorDock als eine einzige Cloud mit festem Tarif zu behandeln.
TensorDock kann nützlich sein, wenn:
- Sie flexible GPU-VM-Optionen möchten.
- Sie RTX-Klasse oder Rechenzentrums-GPU-Optionen für kurze Projekte benötigen.
- Sie Host-Details, Speicher, Bandbreite und Zuverlässigkeit vor dem Start bewerten können.
Verwenden Sie die offizielle Seite TensorDock GPU cloud als Quellen-Abgleich. Fragen Sie in der Produktion, ob die ausgewählte Kapazität den Support, die Isolation und die betrieblichen Garantien bietet, die Ihre Kunden-Workload benötigt.
Hyperscaler-Alternativen zu RunPod
AWS, Google Cloud und Azure sind nicht immer günstigere RunPod-Alternativen. Sie sind oft betrieblich vollständigere Alternativen.
AWS
AWS ist relevant, wenn die Workload eine Unternehmensidentität, Vernetzung, Compliance, Beschaffung und Integration in bestehende AWS-Systeme benötigt. Für Workloads der H100-Klasse sind AWS P5-Instanzen der wichtigste Quellen-Abgleich, und EC2 Capacity Blocks sind relevant, wenn Sie reservierte ML-Kapazität für ein definiertes Zeitfenster benötigen.
AWS kann passen, wenn:
- Sie Daten-, Sicherheits- und Bereitstellungssysteme bereits auf AWS betreiben.
- Sie unternehmensweite Beschaffung und Support benötigen.
- Sie ein definiertes Reservierungsmodell für ein Trainings- oder Startfenster brauchen.
- Sie mit Cloud-Komplexität und Kontingentverwaltung umgehen können.
Prüfen Sie AWS P5 instances und EC2 Capacity Blocks for ML und beziehen Sie dann EBS, Datentransfer, Support, NAT, Observability und Engineering-Zeit in die TCO ein. Wenn es bei der Entscheidung speziell um ältere versus neuere NVIDIA-Kapazität geht, verwenden Sie die Vergleiche H100 vs A100 und H200 vs H100 als ergänzende Lektüre.
Google Cloud
Google Cloud ist eine RunPod-Alternative, wenn Ihr Team auf Beschleuniger optimierte Maschinenfamilien, Enterprise-Kontrollen und eine cloudnative Umgebung rund um Daten, Netzwerk und Kubernetes möchte. Sie ist besonders relevant für Organisationen, die bereits die Google-Cloud-Dateninfrastruktur nutzen.
Verwenden Sie Google Cloud, wenn:
- Ihre Workload eine Cloud-Datenlokalität mit BigQuery, GCS, GKE oder Vertex AI benötigt.
- Sie Unternehmensidentität sowie Prüf- und Beschaffungskontrollen brauchen.
- Sie Planung für Kontingent, Regionen, Speicher und Netzwerkpreise einbeziehen können.
Verwenden Sie die Google Cloud accelerator-optimized machine documentation und die Compute Engine GPU pricing als Quellen-Abgleich. Normalisieren Sie Annahmen zu GPU, Maschine, Speicher, Netzwerk und committed use, bevor Sie sie mit spezialisierten GPU-Clouds vergleichen.
Azure
Azure ist eine praktische RunPod-Alternative für Unternehmen, die bereits auf Microsoft Cloud-, Identity-, Security-, Beschaffungs- oder Datensysteme standardisiert sind. Die ND H100 v5-Serie von Azure ist ein wichtiger Source-Checkpoint für H100-Workloads im Cluster-Stil.
Verwenden Sie Azure, wenn:
- Ihr Unternehmen bereits über Microsoft-Verträge einkauft.
- Sie Enterprise-Sicherheit, Compliance und Netzwerkkontrollen benötigen.
- Sie GPU-VMs benötigen, die an eine breitere Azure-Daten- oder Anwendungsinfrastruktur gekoppelt sind.
Prüfen Sie die Azure ND H100 v5-Serie und validieren Sie dann regionale Verfügbarkeit, Kontingente, InfiniBand-Anforderungen, Speicher, Support und die Komplexität der Bereitstellung.
Serverless- und verwaltete Inferenzalternativen
Nicht jede RunPod-Alternative sollte eine gemietete GPU sein. Wenn Ihr Team einen Endpunkt statt einer Maschine möchte, kann verwaltete Inferenz einen Großteil der Betriebsarbeit entfernen.
Replicate
Replicate eignet sich besonders, wenn das Team Modelle über eine API ausführen, Modellversionen bereitstellen und die direkte Verwaltung von GPU-Hosts vermeiden möchte. Es ist besonders nützlich für Produktteams, denen es wichtig ist, modellgestützte Funktionen schnell auszuliefern.
Replicate kann passen für:
- Inferenz für Bilder, Video, Audio und Open-Source-Modelle.
- Produktprototypen, die schnell eine API benötigen.
- Teams, die Bereitstellungs-Ergonomie gegenüber Low-Level-GPU-Kontrolle bevorzugen.
Nutzen Sie die Replicate-Preise als Source-Checkpoint und verifizieren Sie dann Hardware-Optionen, Bereitstellungsverhalten, Cold Starts, Protokolle, Datenverarbeitung und ob der Workload benutzerdefinierte Kernel oder private Netzwerke benötigt.
Together AI
Together AI ist eine RunPod-Alternative, wenn der Workload eher in Richtung LLM-Inferenz und Fine-Tuning als allgemeine GPU-VM-Miete geht. Es gehört auf die Shortlist für Teams, die verwaltete Inferenz, dedizierte Endpunkte und Modell-Serving-Infrastruktur möchten, ohne den gesamten Stack zu betreiben.
Together AI kann passen für:
- LLM-Inferenz-Endpunkte.
- Fine-Tuning- und Evaluierungs-Workflows.
- Teams, die Modell-Serving-Infrastruktur statt reiner Pod-Verwaltung wollen.
Nutzen Sie die Together AI-Preise als aktuellen Preis-Checkpoint und prüfen Sie, ob der Workload zu serverloser Inferenz, dedizierten Endpunkten, Batch-APIs oder einer kundenspezifischen Enterprise-Vereinbarung gehört. Wenn Sie selbst hosten, vergleichen Sie Serving-Stacks separat mit vLLM vs SGLang.
Model-API- und Router-Alternativen
Die am meisten übersehenen RunPod-Alternativen sind Model-APIs und Router. Wenn Ihr Produkt keine benutzerdefinierten Gewichte, benutzerdefinierte CUDA-Kernels, private GPU-Platzierung oder Low-Level-Serving-Kontrolle benötigt, kann das Mieten von GPUs die falsche Abstraktion sein.
Flatkeys Positionierung ist für diese Entscheidung nützlich: ein Key, ein Guthaben, eine Rechnung, OpenAI-kompatibles Routing, offizielle Modellendpunkte, Nutzungsprotokolle, Budgetkontrollen und Fallback-Pfade über viele Modelle und Tools hinweg. Das ersetzt keinen dedizierten GPU-Cluster, wenn Sie den Serving-Stack selbst besitzen müssen. Es ersetzt den Cluster jedoch dann, wenn Sie zuverlässige KI-Ausgaben mit nachvollziehbaren Ausgaben benötigen. Für die Budgetierung auf Modellebene vergleichen Sie das GPU-Arbeitsblatt mit KI-Modellpreisvergleich und KI-API-Ausgabenmanagement.
Verwenden Sie eine Model-API oder einen Router, wenn:
- Sie Zugriff auf viele Text-, Bild- oder Videomodelle benötigen.
- Der Traffic spitzenartig ist und reservierte GPUs nicht rechtfertigt.
- Sich die Modellauswahl häufig ändert.
- Sie keine Gewichte, Treiber, CUDA oder Serving-Kernels verwalten müssen.
- Kostentransparenz, Fallback und zusammengeführte Abrechnung wichtiger sind als rohe GPU-Kontrolle.
Verwenden Sie dedizierte GPUs, wenn:
- Sie private oder benutzerdefinierte Gewichte bereitstellen.
- Sie benutzerdefinierte Kernel, Quantisierung, Adapter oder Serving-Logik benötigen.
- Datenresidenz oder Isolation Ihre eigene Umgebung erfordern.
- Das Inferenzvolumen stabil genug ist, um gebundene Kapazität zu rechtfertigen.
- Sie GPU-Betriebspersonal haben können.
Das ist die zentrale Beschaffungsfrage: Kaufen Sie Hardwarezugang oder akzeptierte Ergebnisse?
RunPod-Alternativen für ComfyUI
Suchen nach runpod alternatives comfyui entstehen meist aus einem praktischen Problem: Der Workflow läuft, aber Speicher, Startzeit, Image-Versionen und Reproduzierbarkeit werden lästig.
Vergleichen Sie für ComfyUI diese Optionen:
| Option | Am besten geeignet für | Zu beachten |
|---|---|---|
| RunPod-Pods | Vertrauter Weg, wenn Sie bereits Templates und Volumes haben | Bereinigung persistenter Volumes, Leerlaufkosten, Image-Drift |
| Vast.ai oder TensorDock | Flexible GPU-Verfügbarkeit für Batch-Bildaufträge | Host-Zuverlässigkeit, Speicher, Bandbreite, Neustarts |
| Hyperstack oder Lambda | Konventionelleres GPU-Cloud-Instanzenmodell | Verfügbarkeit, Stundenkosten, Verantwortung für das Setup |
| Replicate-ähnliche APIs | Produktfunktionen, die Bilder über eine API benötigen | Weniger Kontrolle über Low-Level-Workflows |
| Flatkey-/Model-API-Pfad | Experimente mit Bild-/Videomodellen über mehrere Anbieter hinweg | Kein Ersatz für benutzerdefinierte ComfyUI-Graphs, die direkte Node-Kontrolle erfordern |
Vergleichen Sie bei ComfyUI nicht nur GPU-Modell und Stundenrate. Messen Sie auch:
- Zeit zum Abrufen von Images und Modellgewichten.
- Kosten für persistenten Speicher.
- Ob benutzerdefinierte Nodes Rebuilds überstehen.
- Leerlaufzeit nach Abschluss eines Batch-Jobs.
- Kosten für den Output-Transfer.
- Fehlerrate durch fehlende Modelle, fehlerhafte Images oder Host-Neustarts.
- Ob der Workflow eine UI, einen API-Endpunkt oder eine automatisierte Queue benötigt.
Die besten RunPod-Alternativen für ComfyUI sind in der Regel die, die die Rebuild-Zeit und verwaisten Speicher reduzieren, nicht die mit dem niedrigsten sichtbaren GPU-Stundenpreis.
Checkliste für dedizierte GPU-Cluster
Wenn der Grund für den Wechsel Enterprise-Kapazität ist, nutzen Sie diese Checkliste, bevor Sie ein Term Sheet unterzeichnen.
| Anforderung | Was Sie jeden Anbieter fragen sollten |
|---|---|
| GPU-Formfaktor | Exaktes GPU-Modell, Speicher, PCIe/SXM/NVL, GPUs pro Node, CPU, RAM, lokales NVMe |
| Netzwerk | InfiniBand, RoCE, EFA, NVLink/NVSwitch, Platzierungsgarantie, Oversubscription, NCCL-Testnachweis |
| Speicher | Lokaler Scratch-Speicher, gemeinsames Dateisystem, Region des Object Storage, Checkpoint-Durchsatz, Snapshot-Preise |
| Scheduler | Kubernetes, Slurm, Ray, Managed Service, Benutzerzugriff, Quota, Abschaltung bei Inaktivität |
| Zuverlässigkeit | Richtlinie zum Ersetzen von Nodes, Wartungsfenster, Eskalation von Incidents, SLA, Retry-Richtlinie |
| Sicherheit | Mandantentrennung, Audit-Logs, Umgang mit Secrets, privates Networking, Datenlöschung |
| Kostenkontrolle | Tags pro Team, Nutzungs-Exports, Budgetwarnungen, Erkennung von Inaktivität, Chargeback |
| Vertrag | Mindestlaufzeit, Mindestumsatz, Burst-Optionen, Upgrade-Pfad, Kündigung, Support-Umfang |
Führen Sie mindestens einen Akzeptanztest aus, bevor der Vertrag nur schwer zu beenden ist:
cluster acceptance test =
  production container bereitstellen
  Modellgewichte und Dataset abrufen
  repräsentativen Benchmark ausführen
  NCCL All-Reduce ausführen, falls Multi-Node
  Checkpoint schreiben und wiederherstellen
  einen fehlgeschlagenen Job simulieren
  Kosten- und Auslastungslogs exportieren
Wenn ein Anbieter keinen repräsentativen Benchmark unterstützen kann, betrachten Sie das als Kauf-Risiko.
Replicate vs Together AI vs RunPod-Alternativen
Die Suchanfrage replicate vs together ai vs runpod alternatives mischt drei Kategorien, also vergleichen Sie sie nach Abstraktionsebene.
| Plattformtyp | Sie verwalten | Anbieter verwaltet | Am besten geeignet für |
|---|---|---|---|
| RunPod-ähnliche GPU-Cloud | Container, Images, Speicher, GPU-Lifecycle, Serving-Stack | GPU-Infrastruktur und Plattform-Grundbausteine | Entwickler, die direkte GPU-Kontrolle benötigen |
| Replicate-ähnliches Model Deployment | Modellpaketierung und API-Nutzung | Ein großer Teil der Serving-Infrastruktur und die ergonomische Bereitstellung für Nutzer | Produktteams, die Modell-Endpunkte schnell ausliefern |
| Together AI-ähnliche Inference-Plattform | Modellauswahl, Endpunktwahl, Workload-Design | LLM-Serving-Infrastruktur und Endpunktbetrieb | Teams mit Fokus auf LLM-Inference/Fine-Tuning |
| Flatkey-ähnlicher Model Router | API-Aufrufe, Budgets, Model-Routing-Policy | Multi-Model-Zugriffsschicht, einheitliche Abrechnung, Nutzungs-Ledger | Teams, die offizielle Modellausgaben brauchen, nicht GPU-Besitz |
Wählen Sie nicht die günstigste einzelne Position. Wählen Sie das niedrigste Betriebsrisiko für die Aufgabe.
Vergleichsarbeitsblatt für RunPod-Alternativen
Verwenden Sie dieses Arbeitsblatt beim Vergleich von GPU-Cloud-Anbietern.
| Feld | Anbieter A | Anbieter B | Anbieter C |
|---|---|---|---|
| Produktmodus | Pod / VM / serverless / reservierter Cluster / API | ||
| GPU-Modell und Speicher | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| Region oder Host | |||
| Abrechnungseinheit | Sekunde, Minute, Stunde, monatlich, Kapazitätsblock | ||
| Mindestbindung | keine, monatlich, jährlich, reservierter Block | ||
| Speicherkosten | Volumes, Snapshots, Object Storage, lokales NVMe | ||
| Netzwerkkosten | Egress, Private Link, regionsübergreifend, öffentliche IP | ||
| Start-Overhead | Image-Pull, Gewichts-Download, Kaltstart | ||
| Leerlaufrate | abrechenbare Minuten ohne nützliche Arbeit | ||
| Fehler-/Retry-Multiplikator | Evictions, OOM, fehlerhafte Hosts, Kaltstartfehler | ||
| Support | Self-Service, Ticket, dedizierter Support, SLA | ||
| Sicherheit | Mandantentrennung, Audit-Logs, Secrets, Löschung | ||
| Akzeptierte Outputeinheit | 1 Mio. Tokens, Bild, Video, Fine-Tune, Trainingslauf | ||
| Effektive Kosten pro akzeptiertem Output | berechnet, nicht geschätzt |
Dann berechnen Sie:
effektive Stundenkosten =
  GPU-Stundenkosten
  + Speicher pro Stunde
  + Netzwerk pro Stunde
  + Support pro Stunde
  + Leerlaufverschwendung
  + Retry-Verschwendung
  + Engineering-Overhead

Kosten pro akzeptiertem Output =
  effektive Stundenkosten / akzeptierte Outputs pro Stunde
So entscheiden Sie auch, ob dedizierte Kapazität APIs schlägt. Wenn die API-Kosten pro akzeptiertem Output niedriger sind, nachdem Sie GPU-Betriebskosten einbezogen haben, mieten Sie den Cluster nicht nur deshalb, weil der GPU-Stundenpreis attraktiv aussieht.
Quellen-Checkliste für aktuelle Preise
Preise und GPU-Verfügbarkeit ändern sich häufig. Bevor Sie eine Kaufentscheidung treffen, prüfen Sie die Quellzeilen erneut und notieren Sie das Datum. Für diesen Entwurf wurde die Quellen-Checkliste am 12. Oktober 2026 auf Seitenverfügbarkeit überprüft.
| Anbieter/Kategorie | Quell-Checkpoint | Was zu erfassen ist |
|---|---|---|
| RunPod | RunPod-Preise, RunPod-Pod-Speicherdokumentation | Pod-Modus, Serverless-Modus, sichere/Community-Kapazität, Speicher, Netzwerkvolumen, Annahmen zu Leerlauf |
| Lambda | Lambda GPU Cloud | GPU-Modell, Instanzform, Verfügbarkeit, reservierte oder Cluster-Bedingungen |
| Vast.ai | Vast.ai-Preise | Host, Zuverlässigkeit, GPU, Speicher, Bandbreite, Marktplatz-Bedingungen |
| Massed Compute | Massed Compute-Preise | On-Demand-Tarife, Reservierungsweg, Support- und Cluster-Bedingungen |
| Hyperstack | Hyperstack GPU-Preise | GPU-SKU, Region, Speicher, Netzwerk, Support |
| TensorDock | TensorDock GPU-Cloud | Marktplatz-Host, GPU, RAM/vCPU, Speicher, Preis zum Bereitstellungszeitpunkt |
| Replicate | Replicate-Preise | Bereitstellungspreise, Hardware, Kaltstarts, Protokolle, Datenrichtlinie |
| Together AI | Together AI-Preise | Serverless, dedizierte Endpunkte, Fine-Tuning, Batch-Ökonomie |
| AWS | EC2 P5-Instanzen, EC2 Capacity Blocks | Region, Kontingent, Instanzfamilie, Reservierungsfenster, EBS, Datentransfer, Support |
| Google Cloud | Beschleuniger-optimierte Maschinen, GPU-Preise | Maschinenfamilie, GPU-Preis, Festplatte, Netzwerk, Rabatte bei zugesicherter Nutzung |
| Azure | ND H100 v5-Serie | VM-Größe, Region, Kontingent, InfiniBand, Support, Speicher |
Abschließende Empfehlung
Wählen Sie RunPod-Alternativen nach Betriebsmodell aus:
- Nutzen Sie Marktplätze wie Vast.ai oder TensorDock für flexible Experimente, ComfyUI-Batches und Workloads, die Wiederholungen tolerieren.
- Nutzen Sie spezialisierte GPU-Clouds wie Lambda, CoreWeave, Crusoe, Massed Compute, Nebius, Hyperstack oder Vultr, wenn Sie planbarere GPU-Kapazität und Support benötigen.
- Nutzen Sie Hyperscaler, wenn Unternehmensidentität, Beschaffung, Compliance und bestehende Cloud-Datenattraktivität wichtiger sind als Einfachheit.
- Nutzen Sie verwaltete Inferenzplattformen wie Replicate oder Together AI, wenn das Verhalten des Endpunkts wichtiger ist als die VM-Steuerung.
- Nutzen Sie Flatkey oder einen anderen Model-API-Router, wenn Sie offizielle KI-Modellausgaben, Nutzungsübersicht, Fallback und einheitliche Abrechnung benötigen statt direktem GPU-Besitz.
Die besten RunPod-Alternativen sind diejenigen, die die Kosten der akzeptierten Arbeit senken. Wenn Ihnen ein Anbieter eine günstigere GPU-Stunde bietet, aber dadurch Leerlaufzeit, Startaufwand, fehlgeschlagene Jobs, Speicherverlust oder Engineering-Aufwand steigen, ist er nicht wirklich günstiger.
Häufig gestellte Fragen
Welche Alternativen gibt es zu RunPod?
Zu den gängigen RunPod-Alternativen gehören Lambda Cloud, CoreWeave, Crusoe Cloud, Massed Compute, Nebius AI Cloud, Hyperstack, Vultr Cloud GPU, Vast.ai, TensorDock, Replicate, Together AI, AWS, Google Cloud, Azure und Model-API-Router wie Flatkey. Die richtige Wahl hängt davon ab, ob Sie Pods, Serverless-Endpunkte, dedizierte Cluster, Marktplätze oder API-basierten Modellzugang benötigen.
Was ist die beste RunPod-Alternative für ComfyUI?
Für ComfyUI-Experimente sind Vast.ai, TensorDock, Hyperstack, Lambda und GPU-Clouds im Paperspace-Stil häufige Kandidaten. Vergleichen Sie persistenten Speicher, Cache für Modellgewichte, Startzeit, Verwaltung benutzerdefinierter Knoten, Abschaltung bei Leerlauf, Ausgabeübertragung und Host-Zuverlässigkeit, bevor Sie die stündlichen GPU-Preise vergleichen.
Sind RunPod-Alternativen günstiger?
Manchmal, aber nur, nachdem Sie die effektiven Kosten pro akzeptierter Ausgabe berechnet haben. Ein niedrigerer GPU-Stundensatz kann zum Nachteil werden, wenn der Workload mehr Zeit mit dem Herunterladen von Modellen, im Leerlauf, mit Wiederholungen fehlgeschlagener Jobs oder mit Datenbewegung verbringt. Vergleichen Sie fertige Bilder, Tokens, Videos oder Jobs und nicht nur GPU-Stunden.
Sollte ich Replicate oder Together AI statt RunPod verwenden?
Nutzen Sie Replicate oder Together AI, wenn Sie verwaltete Modell-Endpunkte möchten und keine GPU-Steuerung auf niedriger Ebene benötigen. Nutzen Sie RunPod-ähnliche GPU-Clouds, wenn Sie benutzerdefinierte Container, benutzerdefinierte Workflows, direkten GPU-Zugriff oder Kontrolle über den Serving-Stack benötigen.
Wann sollte ich Flatkey statt gemieteter GPUs verwenden?
Verwenden Sie Flatkey, wenn Ihr Team offizielle Modell-APIs, Multi-Model-Routing, einen Schlüssel, ein Guthaben, Nutzungsprotokolle, Fallback und Budgetkontrollen benötigt. Mieten Sie GPUs, wenn benutzerdefinierte Gewichte, benutzerdefinierte Kernel, private Platzierung oder eine stabile hohe Auslastung die direkten Infrastrukturkontrollen den betrieblichen Aufwand wert machen.


