
Fiabilidad y enrutamiento
Últimos artículos en Fiabilidad y enrutamiento.
Acceso a la API de Claude fuera de configuraciones de una sola región: una guía centrada en el cumplimiento
Una guía centrada en el cumplimiento para el acceso a la API de Claude entre regiones, que cubre Anthropic directo, Bedrock, Vertex AI, gateways, pruebas, observabilidad y failover aprobado.
Seedance 2.0 API en 2026: acceso, precios y enrutamiento de respaldo
Una guía actualizada sobre el acceso a la API de Seedance 2.0, la verificación de precios, los trabajos asíncronos y el enrutamiento de respaldo seguro entre versiones cambiantes de modelos de video.
Lista de verificación de producción de Seedance API para equipos de texto a video
Una lista de verificación práctica para operar trabajos de texto a video de Seedance con colas duraderas, estados normalizados, reintentos seguros, almacenamiento y controles de costos.
Gemini API para agentes de IA: lista de verificación para integración en producción
Una lista de verificación para agentes impulsados por Gemini que cubre endpoints estables, cambio controlado de modelo, seguridad de herramientas, reintentos, enrutamiento de respaldo y visibilidad de costes.
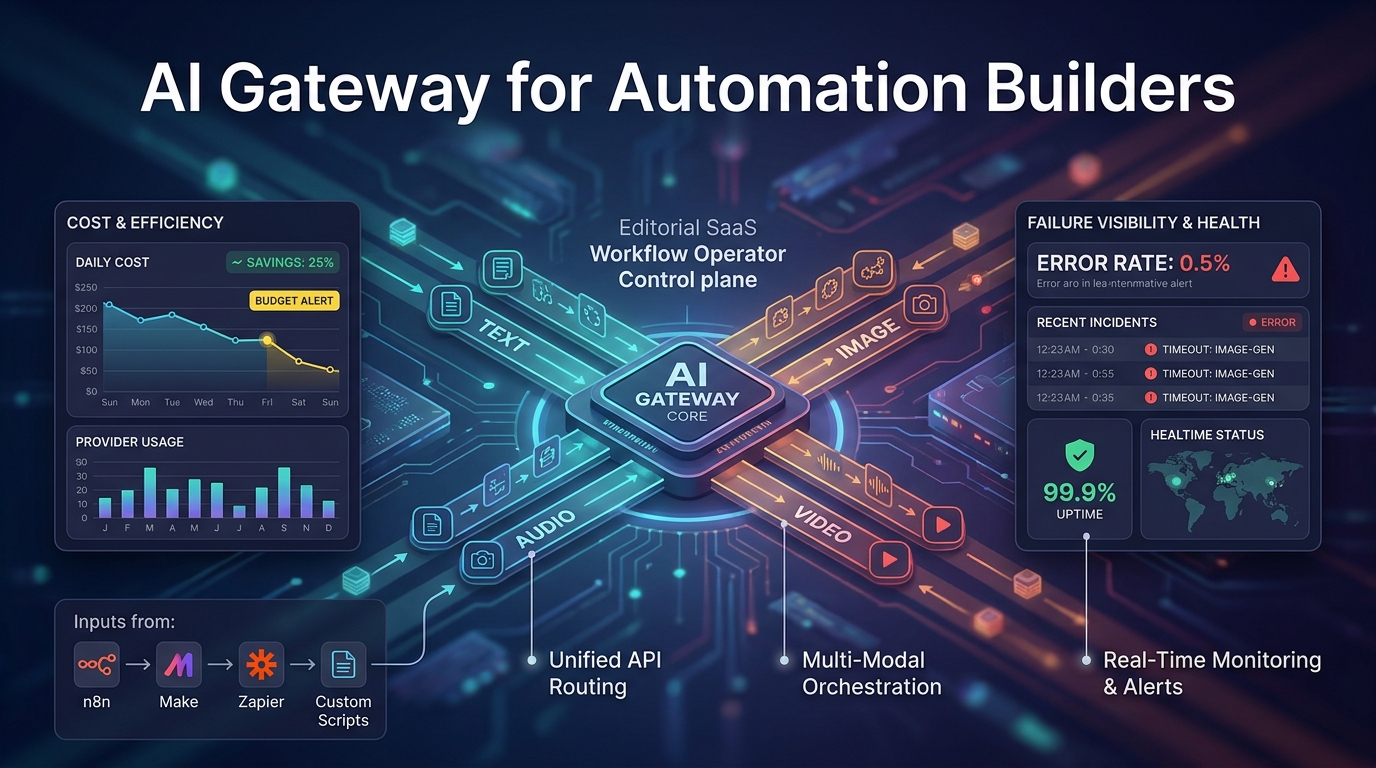
AI Gateway para constructores de automatizaciones: enrutamiento de fallback, visibilidad de costos y una sola URL base
Por qué los constructores de automatizaciones necesitan una sola puerta de enlace de IA para URLs base estables, enrutamiento de fallback más seguro y una revisión de costos más sencilla en flujos de trabajo de alto volumen.

Pruebas de calidad de fallback de modelos: cuando los modelos más baratos o rápidos no son equivalentes
Un plan práctico de pruebas de calidad de fallback de modelos para demostrar que los modelos de respaldo más baratos o rápidos preservan la calidad, el costo, las herramientas, la política y la observabilidad antes del enrutamiento en producción.

Agrupación de cuentas multiupstream: comprobaciones de fiabilidad antes de compartir el tráfico de modelos
Una lista de verificación de producción para una agrupación segura de cuentas multiupstream en cuentas de modelos de IA, con comprobaciones de estado, cuotas, evidencia de facturación y reglas de enrutamiento de fallo cerrado.

LLM router: cómo funciona el enrutamiento de modelos, estrategias y canary seguros (2026)
Guía completa del LLM router: cómo funciona, diferencias con un LLM gateway, cinco estrategias (reglas, cascadas, clasificadores), ahorro real por diferencias de precio, código funcional y un runbook de despliegue canary.

Estrategia de colas para API de IA: Protege los flujos de trabajo de cara al usuario durante las interrupciones del proveedor
Una guía de fiabilidad en producción para proteger los flujos de trabajo de IA de cara al usuario con líneas de cola, contrapresión, contratos de respaldo, reglas de mensajes fallidos y evidencia de ruta.

Taxonomía de Errores de Gateway de LLM: Separar Fallos de Autenticación, Cuota, Proveedor y Seguridad
Una guía de fiabilidad en producción para clasificar los fallos de un gateway de LLM en rutas de autenticación, cuota, proveedor, solicitud, seguridad y cancelación antes de un reintento o fallback.

Límite de solicitudes de API superado: qué significa y cómo solucionarlo (2026)
Qué significa superar el límite de solicitudes de una API, cómo aplican los límites las principales API en 2026 y soluciones paso a paso: Retry-After, código de espera exponencial en Python y Node, limitadores, caché, colas y niveles superiores.

Estrategia de timeouts para API de IA: Límites para conectar, leer, transmitir y encolar
Establece límites de timeout para API de IA en producción para conectar, leer, transmitir, encolar, reintentar, fallback y observabilidad antes de que los incidentes se vuelvan costosos.
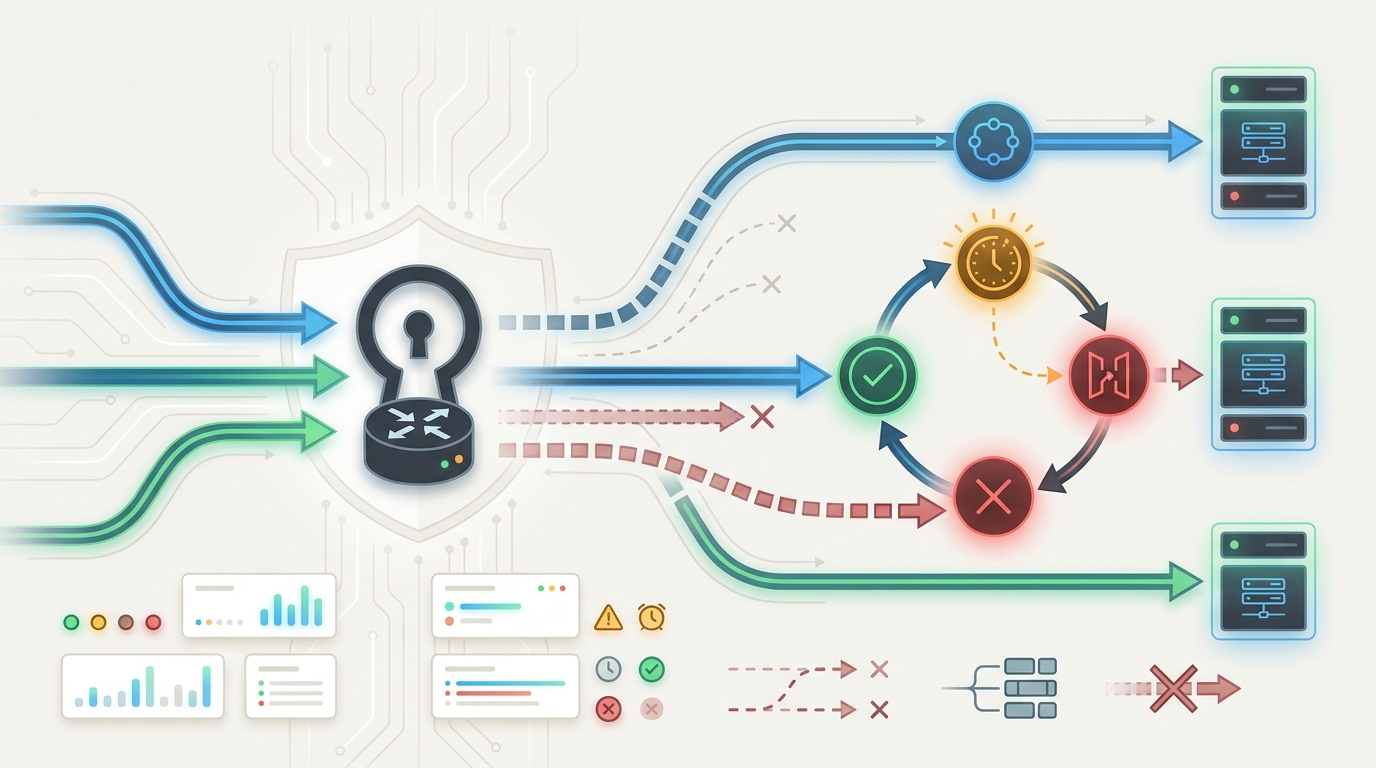
Disyuntores para gateways de API de LLM: protege las aplicaciones de bucles de fallo del proveedor
Usa un disyuntor en tu gateway de API de LLM para detener los bucles de fallo del proveedor, clasificar errores, proteger los reintentos y enrutar a una opción de respaldo, una cola o un cierre seguro.
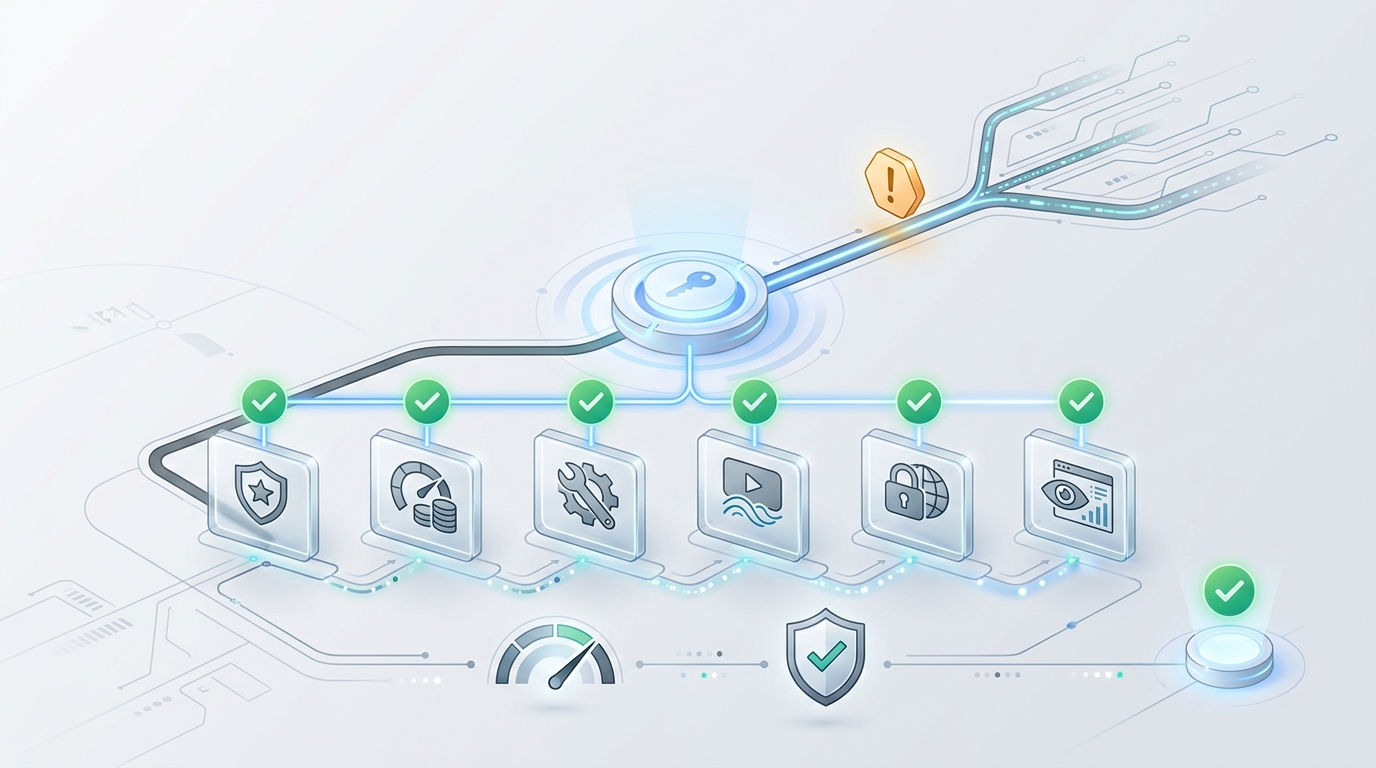
Lista de verificación de fallback de modelos: calidad, coste, herramientas y límites de cumplimiento
Usa esta lista de verificación de fallback de modelos para evaluar calidad, coste, herramientas, streaming, cumplimiento, registros y rollback antes del fallback automático del AI gateway.
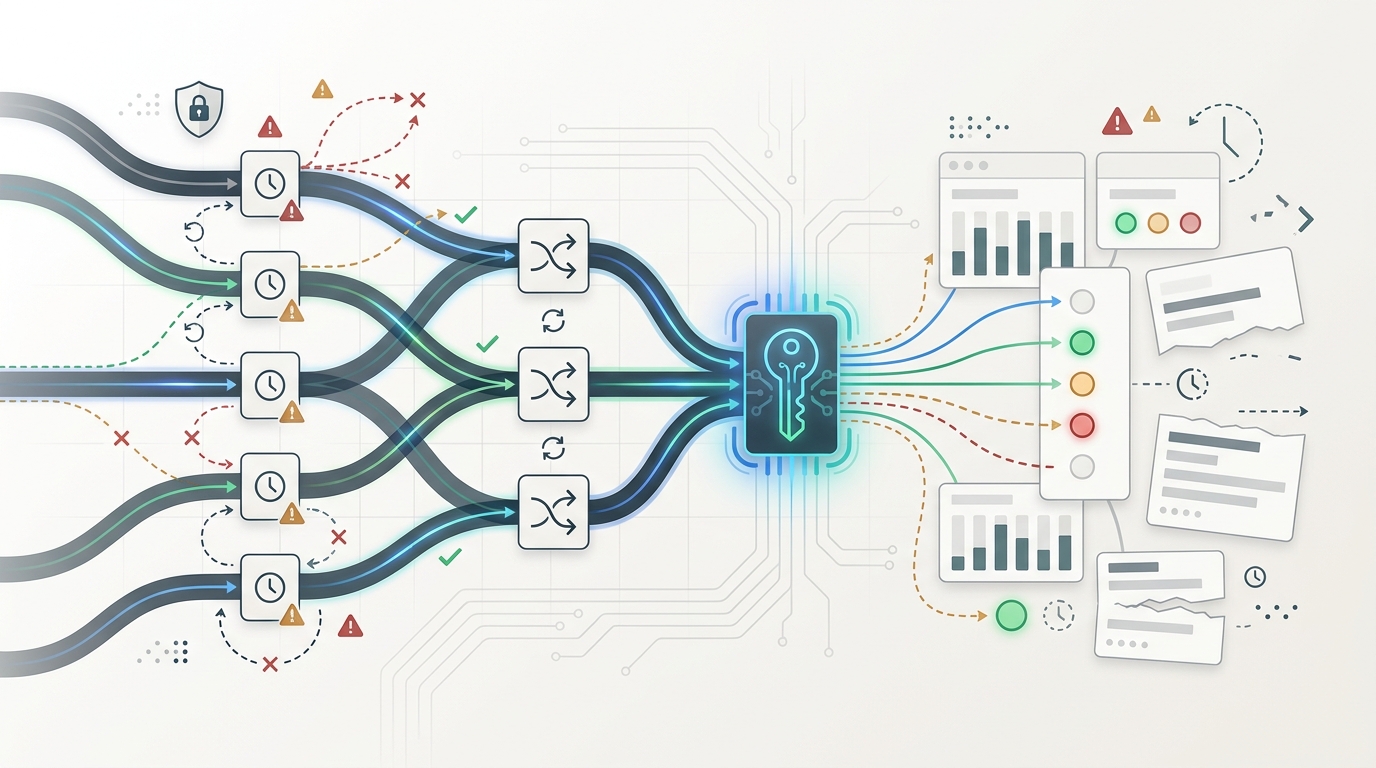
Confiabilidad de API de IA en streaming: SSE, timeouts y modos de fallo a nivel de router
Usa pruebas de confiabilidad de API de IA en streaming para detectar bloqueos de SSE, timeouts de proxy, salidas parciales, riesgos de reintentos y fallos de failover del router antes de producción.
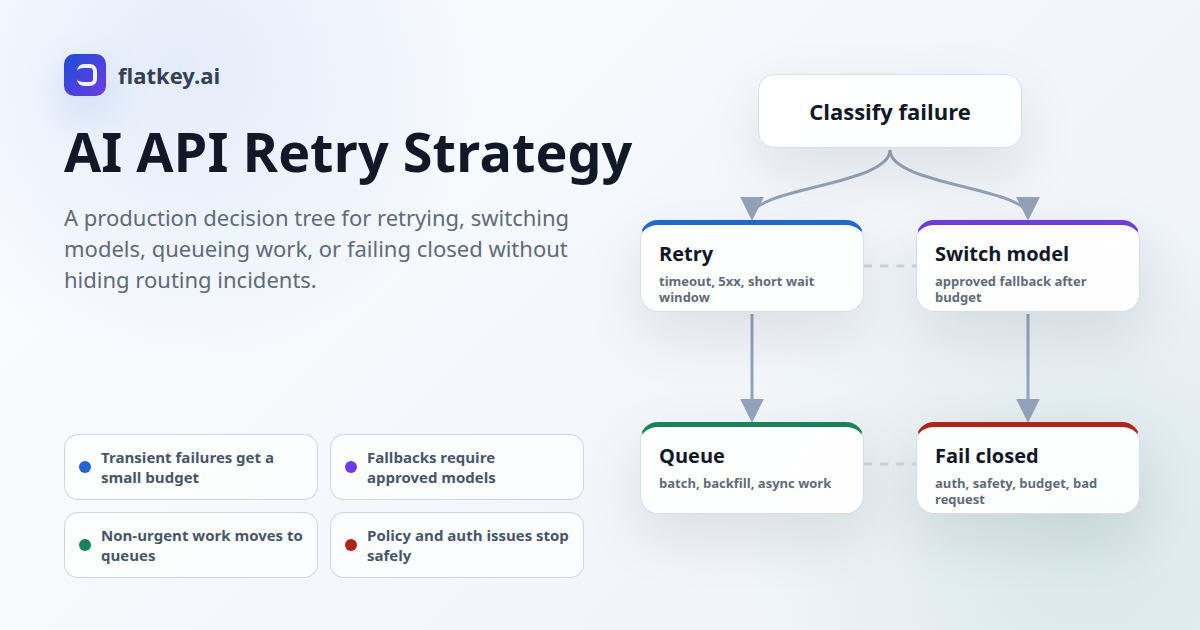
Estrategia de reintento para API de IA: cuándo reintentar, cambiar de modelo, poner en cola o fallar en cerrado
Use una estrategia de reintento para API de IA para decidir cuándo reintentar, cambiar de modelo, poner trabajo en cola o fallar en cerrado sin ocultar incidentes de cuota, autenticación o enrutamiento.
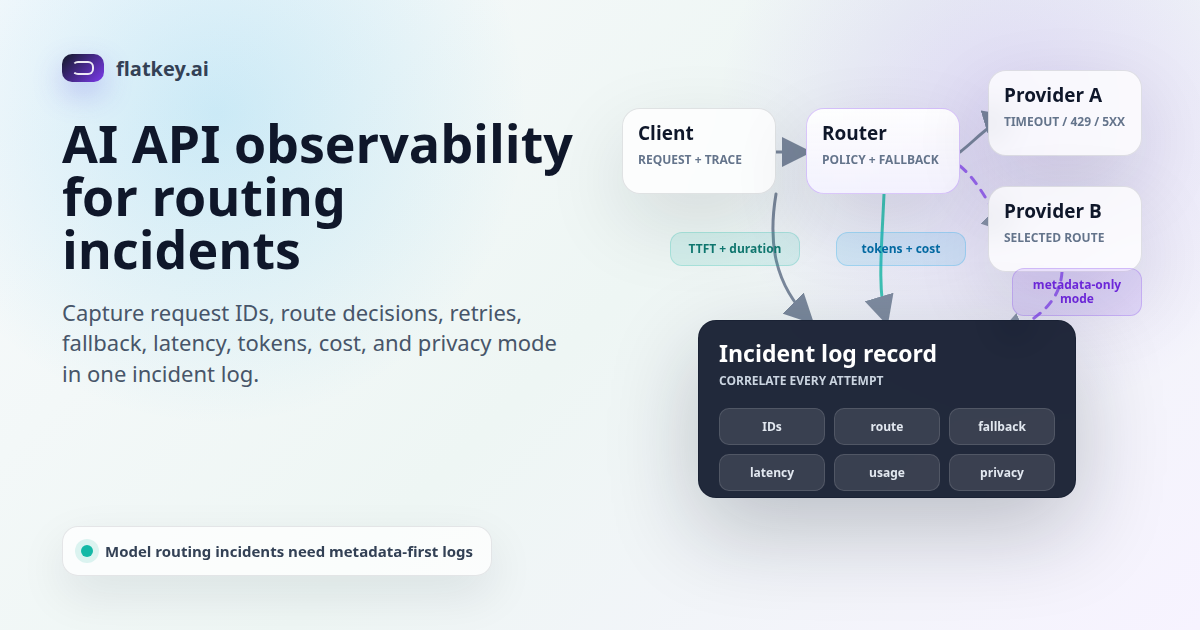
Plataformas de observabilidad de IA: qué hacen y cómo elegir (2026)
Las plataformas de observabilidad de IA registran prompts, tokens, costes, pasos de agentes y puntuaciones de calidad. Compara Langfuse, LangSmith, Arize, Datadog, Helicone, Braintrust y Logfire en funciones y precios de octubre de 2026, con código OpenTelemetry.
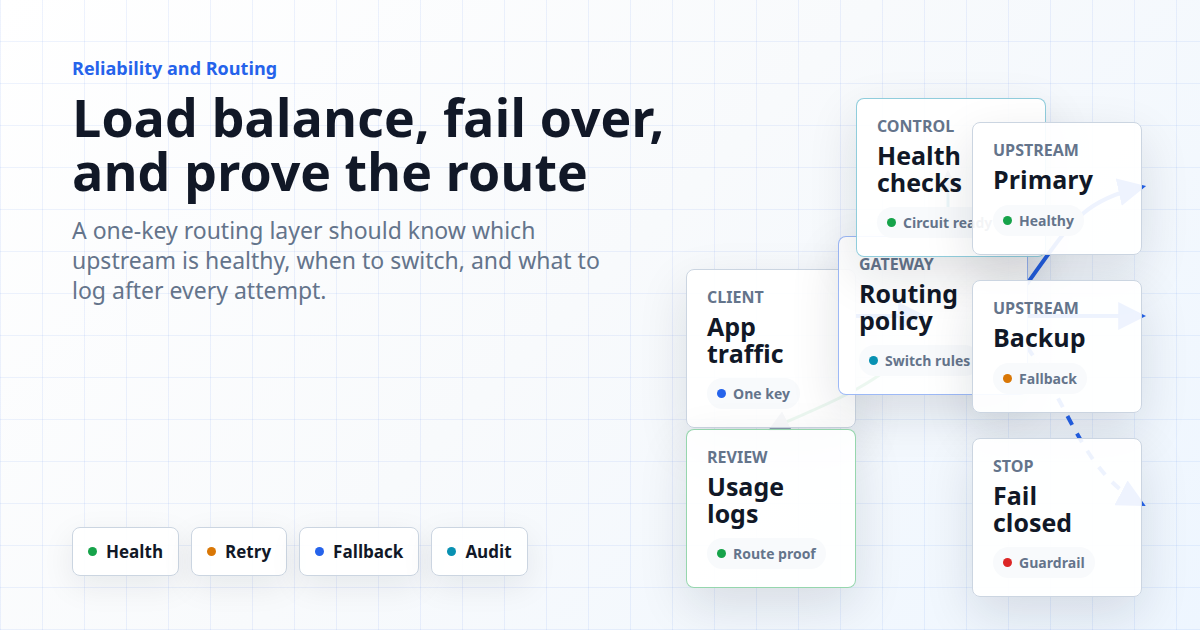
Balanceo de carga y failover de API de IA detrás de una sola clave
Planifique el balanceo de carga y el failover de API de IA con reglas de enrutamiento, comprobaciones de estado, rutas de reintento, registros de uso, cuotas, pruebas de reversión y gateways de una sola clave.
Crea más rápido con una sola pasarela de IA.
Usa flatkey.ai para gestionar modelos, claves, facturación y observabilidad desde una plataforma API.
Empezar