
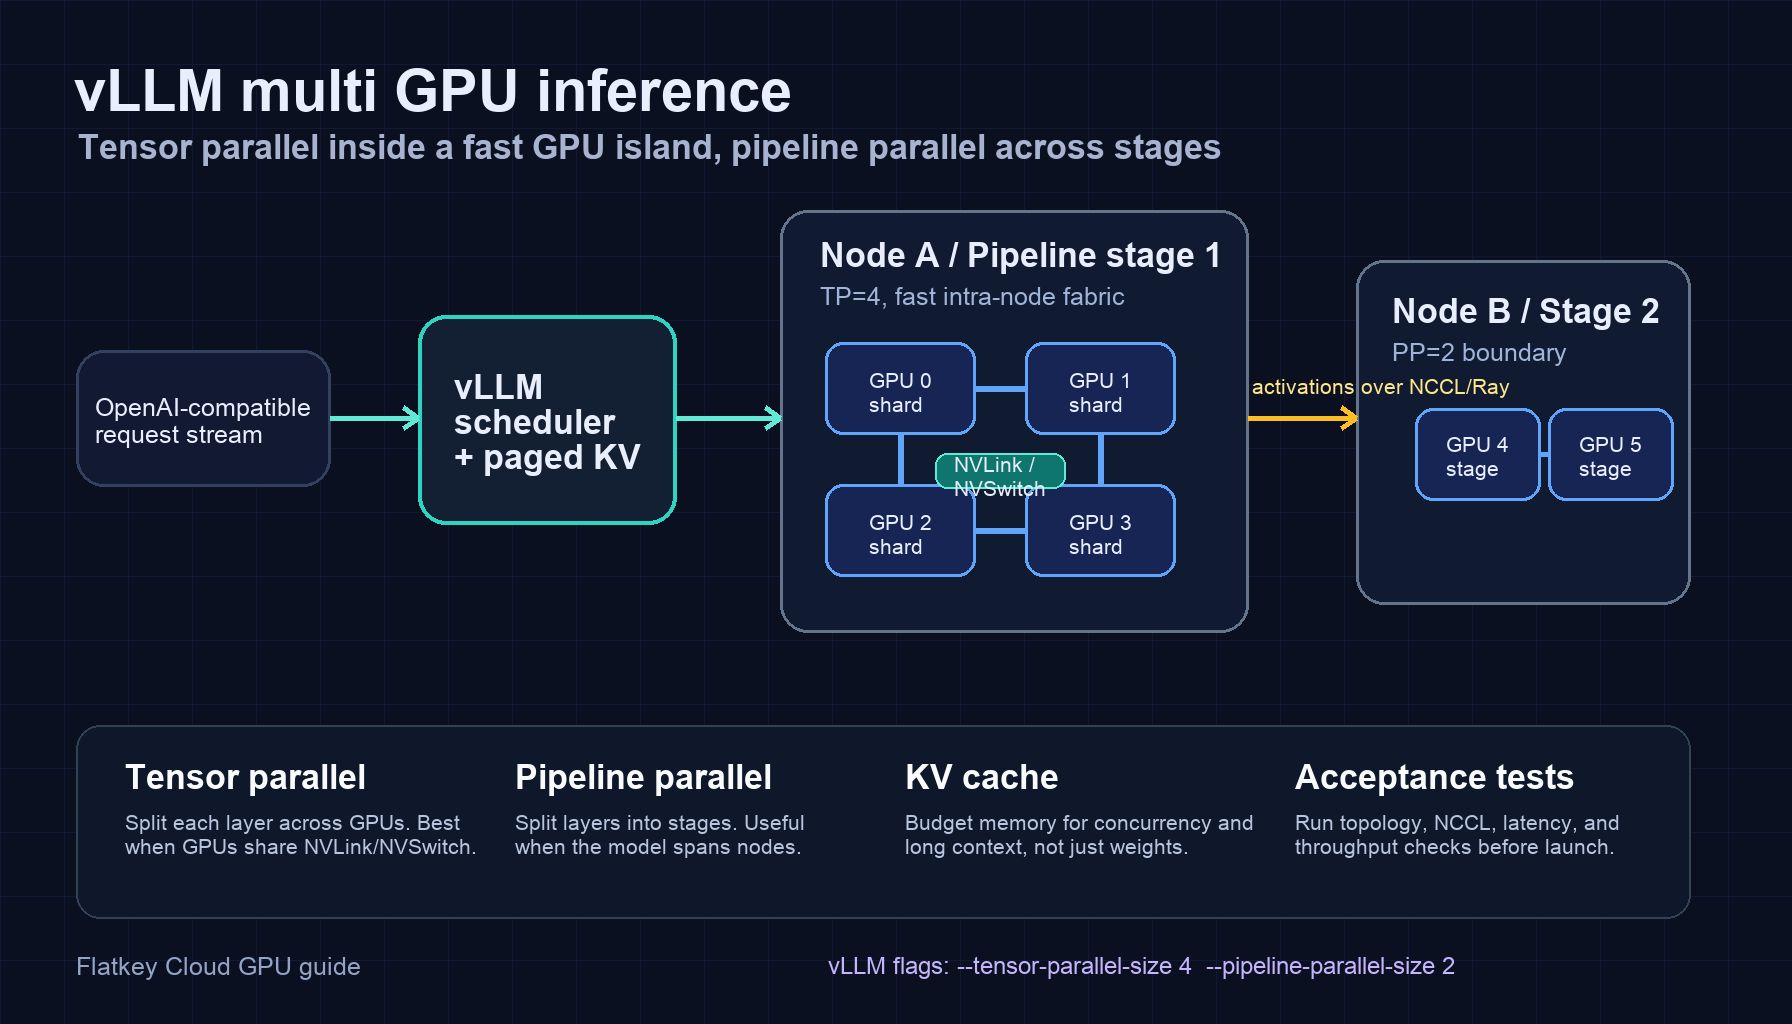
La inferencia multi GPU con vLLM suele empezar por una de tres razones: los pesos del modelo no caben en una sola GPU, la caché KV para el contexto y la concurrencia requeridos no cabe en una sola GPU, o una sola GPU no puede ofrecer el objetivo de tokens por segundo y tiempo hasta el primer token que necesitas. La configuración no es solo una decisión de --tensor-parallel-size. También necesitas alinear el paralelismo tensorial, el paralelismo de canalización, el backend del ejecutor y la topología física de la GPU.
La versión corta:
- Usa primero el paralelismo tensorial cuando el modelo cabe repartido entre GPUs dentro del mismo clúster rápido de GPUs, especialmente en un nodo H100/H200/B200 de 8 GPUs con NVLink o NVSwitch.
- Añade paralelismo de canalización cuando el modelo debe abarcar varios nodos o cuando el paralelismo tensorial por sí solo genera demasiada comunicación entre nodos.
- Considera
tp * ppcomo el número de trabajadores de GPU utilizados por una réplica de vLLM. - Haz pruebas de rendimiento con la longitud real de tus prompts, la longitud de salida, la forma del lote y la cuantización del modelo antes de dar por lista la configuración para producción.
- Si tu equipo solo necesita un endpoint compatible con OpenAI y no control directo del hardware, compara la ruta de GPU con una base de referencia de modelo/API gestionado como Flatkey antes de alquilar y operar un clúster.
Esta guía ofrece un ejemplo práctico de inferencia multi GPU con vLLM, un diagrama de arquitectura, comandos de inicio y las comprobaciones que suelen detectar las malas configuraciones multi-GPU antes de que lo hagan los usuarios.
Arquitectura de inferencia multi-GPU de vLLM
En vLLM, el paralelismo tensorial divide el trabajo de cada capa transformer entre varios trabajadores de GPU. El paralelismo de canalización divide las capas del modelo en etapas, de modo que distintos grupos de GPU ejecutan partes diferentes del modelo. Para el serving en producción, esas decisiones afectan a algo más que la memoria: cambian la comunicación colectiva, la planificación de solicitudes, el radio de impacto ante fallos y si la red para escalar horizontalmente se convierte en el cuello de botella.
Una arquitectura de partida habitual es:
| Layer | Practical choice | Why it matters |
|---|---|---|
| API surface | vllm serve con el servidor compatible con OpenAI |
Permite que los equipos de aplicación mantengan clientes al estilo OpenAI mientras cambian el backend de serving. |
| Tensor parallel group | Un nodo o una isla NVLink/NVSwitch | Las capas con paralelismo tensorial se comunican con frecuencia, así que los enlaces lentos entre nodos perjudican rápidamente. |
| Pipeline stages | División a nivel de nodo o de rack cuando el modelo no cabe en un solo nodo | El paralelismo de canalización puede reducir la cantidad de comunicación entre nodos en comparación con poner un grupo tensor-parallel en cada GPU. |
| Distributed backend | Multiprocessing para un nodo, Ray cuando necesitas orquestación multi-nodo | Mantén el serving de un solo nodo simple; usa Ray cuando los trabajadores deban abarcar varias máquinas. |
| KV cache plan | Presupuesta para longitud del prompt, longitud de salida y concurrencia | Los pesos son solo el punto de partida; el serving de contexto largo puede estar limitado por la caché KV. |
| Acceptance test | Topología, NCCL, carga en frío, TTFT, throughput y reinicio tras fallo | La mayoría de los despliegues defectuosos parecen correctos hasta que llega tráfico realista. |
Para una visión de infraestructura adyacente, consulta la guía de arquitectura de clústeres GPU. Para el dimensionamiento de memoria, usa la hoja de cálculo de requisitos de memoria GPU para LLM cuando esté disponible.
Paralelismo tensorial vs paralelismo de canalización en vLLM
La regla de decisión más útil es sencilla:
Usa paralelismo tensorial dentro de una isla rápida de GPU. Usa paralelismo de canalización para cruzar límites más lentos.
El paralelismo tensorial es una buena primera opción cuando:
- el modelo es demasiado grande para una sola GPU, pero cabe repartido entre 2, 4 u 8 GPUs en un solo nodo;
- tu nodo GPU tiene enlaces GPU a GPU de gran ancho de banda;
- la latencia importa y quieres que cada solicitud pase por una réplica lógica del modelo sin una burbuja de canalización larga;
- la familia de modelos está bien soportada por la ejecución tensor-parallel de vLLM.
El paralelismo de canalización resulta útil cuando:
- el modelo no cabe en un solo nodo incluso después de cuantización o con menor precisión;
- un grupo tensor-parallel, de otro modo, cruzaría Ethernet o InfiniBand con demasiada frecuencia;
- quieres que cada nodo sea dueño de una etapa del modelo en lugar de que cada capa participe en colectivas entre nodos;
- puedes tolerar la sobrecarga de planificación y burbujas que conllevan las etapas de canalización.
No asumas que tp=8 es siempre mejor que tp=4, o que pp=2 mejora automáticamente el throughput. Para la inferencia multi GPU con vLLM, la forma correcta depende del tamaño del modelo, la presión de memoria, la interconexión, las longitudes de secuencia y la concurrencia de lotes que tu carga de trabajo pueda sostener.
Ejemplo de inferencia multi-GPU de vLLM en un solo nodo
Empieza con un solo nodo cuando puedas. Es más fácil de depurar, más barato para hacer benchmarks y evita la red multi-nodo como primer dominio de fallo.
Ejemplo: un servidor de 4 GPU, una réplica de vLLM, tamaño de paralelismo tensorial 4.
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
Usa esta configuración cuando un modelo encaje limpiamente en cuatro GPUs y el nodo tenga una comunicación GPU a GPU rápida. Para un nodo de 8 GPUs, prueba tanto --tensor-parallel-size 4 como --tensor-parallel-size 8; el grupo más grande puede mejorar el margen de memoria, pero puede añadir sobrecarga de comunicación.
Prueba básica de humo:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "Dame una comprobación de salud de la GPU en una sola frase."}],
    "max_tokens": 64
  }'
Si esto falla, no pases aún al modo multinodo. Primero corrige la descarga del modelo, la visibilidad de CUDA, la visibilidad de NCCL, la compatibilidad entre driver y runtime, y la presión de memoria de la GPU.
Ejemplo multinodo con paralelismo tensorial y de canalización
Cuando necesites más GPUs de las que puede proporcionar un solo nodo, mantén el grupo de paralelismo tensorial dentro de cada nodo si es posible, y luego usa paralelismo de canalización entre nodos.
Forma objetivo de ejemplo:
- dos nodos;
- cuatro GPUs por nodo;
- tamaño de paralelismo tensorial 4;
- tamaño de paralelismo de canalización 2;
- trabajadores totales:
4 * 2 = 8.
Lanzamiento conceptual:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
En un clúster real, inicia Ray en el nodo principal, une los nodos trabajadores a ese clúster de Ray, haz que el almacenamiento del modelo sea accesible desde todos los nodos y confirma que todos los trabajadores ven el recuento de GPU previsto antes de lanzar el servidor vLLM. Fija tu versión exacta de vLLM, la imagen CUDA, la rama del driver y la revisión del modelo en el runbook para que una recompilación posterior no cambie el comportamiento de forma silenciosa.
Este es el punto en el que la calidad de la infraestructura se convierte en calidad del producto. Si el segundo nodo está conectado mediante una red débil, si NCCL elige la interfaz incorrecta o si la ruta de caché del modelo es lenta, los usuarios lo perciben como variación de latencia, arranques en frío largos o fallos de solicitud.
Elección del backend: multiproceso o Ray
Para la inferencia multi-GPU de vLLM, usa el backend de ejecución más simple que se adapte al despliegue:
| Despliegue | Backend sugerido | Notas |
|---|---|---|
| Una máquina, múltiples GPUs | Multiproceso o el valor predeterminado de vLLM para tu versión | Más fácil de operar; menos piezas móviles. |
| Múltiples máquinas | Ray | Necesario cuando los trabajadores abarcan nodos y requieren coordinación a nivel de clúster. |
| Servicio multinodo en Kubernetes | Ray más planificación explícita de pods/red/almacenamiento | Haz visibles la programación, la colocación y las comprobaciones de salud en lugar de esperar que el proceso de servicio encuentre las GPUs correctas. |
La elección del backend no debe aislarse de la topología. Si necesitas Ray solo porque el modelo es demasiado grande para un servidor, la siguiente pregunta es si el paralelismo de canalización puede mantener la mayor parte de la comunicación de alta frecuencia dentro de cada nodo.
Dimensionamiento de memoria antes de elegir TP y PP
Un plan de inferencia multi-GPU de vLLM debería presupuestar la memoria en este orden:
- Pesos: parámetros del modelo después del dtype o la cuantización.
- Caché KV: longitud del prompt, longitud de salida, concurrencia del lote y dtype de la caché.
- Overhead de ejecución: CUDA graphs, comportamiento del asignador, buffers de comunicación, overhead del tokenizador/servidor y margen de seguridad.
- Margen operativo: reinicios graduales, recarga del modelo, telemetría y picos ocasionales de prompts.
El paralelismo tensorial distribuye los pesos del modelo y parte del trabajo de cálculo entre GPUs, pero no hace que el tráfico sea gratis. El paralelismo de canalización puede reducir la presión de memoria por etapa, pero introduce cuestiones de equilibrio entre etapas. Una etapa de canalización con más presión de memoria o kernels más lentos se convierte en el limitador de rendimiento de toda la réplica.
Opciones prácticas iniciales:
| Situación del modelo/runtime | Primer formato TP/PP a probar |
|---|---|
| Modelo de 7B u 8B, contexto normal | tp=1, una GPU, escala las réplicas horizontalmente |
| Modelo de 32B, alta concurrencia | tp=2 o tp=4 en un nodo |
| Modelo clase 70B, BF16/FP16 | tp=4 o tp=8 en un nodo de gran memoria |
| Modelo denso muy grande que abarca nodos | tp=4, pp=2 o tp=8, pp=2, según el tamaño del nodo |
| Modelo MoE | Consulta por separado la guía de paralelismo de expertos de vLLM; no trates MoE como un modelo denso por defecto |
La tabla es un punto de partida, no un resultado de benchmark. El coste de salida aceptado depende de prompts reales, salidas reales, tasa de reintentos, comportamiento de colas y aceptación de calidad.
Comprobaciones de topología que importan
Antes de publicar un endpoint multi-GPU, recoge estos datos del proveedor o de la máquina:
- salida de
nvidia-smi topo -mpara cada nodo; - si las GPUs comparten NVLink o NVSwitch dentro del nodo;
- la estructura de red entre nodos, incluyendo InfiniBand, RoCE, EFA o Ethernet;
- interfaces visibles para NCCL y si el tráfico está usando la ruta prevista;
- ruta de almacenamiento para los pesos del modelo y si varios nodos cargan desde un disco compartido lento;
- memoria GPU, estado de MIG, límites de energía y versiones de driver/CUDA.
Los sistemas NVIDIA DGX H100/H200, por ejemplo, están documentados como sistemas de ocho GPUs con conectividad GPU a GPU NVSwitch/NVLink y opciones de red de 400 Gb/s. Los nodos PCIe de uso general aún pueden servir bien a vLLM, pero deberías esperar un perfil de comunicación diferente y hacer benchmarks en consecuencia.
Para información básica sobre interconexión, consulta NVLink vs NVSwitch. Para el lenguaje de compra y topología de clústeres, la guía de alquiler de clústeres GPU es un complemento útil.
Prueba de aceptación en producción
Ejecute una prueba por etapas en lugar de un único prompt de ruta feliz.
- Prueba de topología: guarde
nvidia-smi topo -m, el inventario de NIC y el entorno de NCCL. - Prueba de carga en frío: mida el tiempo desde el inicio del contenedor hasta el primer token exitoso.
- Prueba de prompt corto: longitud de prompt baja, longitud de salida moderada, carga de trabajo de chat esperada.
- Prueba de prompt largo: longitud de contexto realista cercana a su requisito de producto.
- Barrido de concurrencia: incremente las solicitudes concurrentes hasta que el p95 del tiempo hasta el primer token o la latencia p95 entre tokens supere su límite.
- Prueba con salida intensa: use cargas de trabajo que generen completaciones largas, no solo prompts de clasificación.
- Prueba de fallo: elimine un proceso trabajador o un nodo y verifique que el equilibrador de carga retire la réplica.
- Prueba de reinicio: reinicie el proceso de vLLM y confirme que la caché del modelo, el estado de Ray y las comprobaciones de salud se recuperan correctamente.
Rastree al menos estas métricas:
| Métrica | Por qué importa |
|---|---|
| Tiempo hasta el primer token | Los usuarios lo perciben de inmediato en chat y en flujos de trabajo de agentes. |
| Latencia entre tokens | Muestra la estabilidad de decodificación después de que comienza la generación. |
| Tokens por segundo por réplica | Ayuda a comparar las configuraciones de TP/PP. |
| Margen de memoria de GPU | Predice si los picos de contexto largo provocarán OOM. |
| Tiempo en cola | Separa la capacidad de servicio de la latencia de la aplicación. |
| Tasa de error y reintento | Convierte la inestabilidad de la infraestructura en coste real. |
| Tasa de salida aceptada | Evita optimizar para tokens baratos que los usuarios rechazan. |
Patrones de solución de problemas
El modelo carga, pero el rendimiento es peor con más GPU.
Es posible que el grupo de TP sea demasiado grande para la topología, o que la carga de trabajo no tenga suficiente concurrencia para amortizar la comunicación. Prueba con un TP más pequeño, más réplicas o una forma de lote/concurrencia diferente.
El arranque multi-nodo se queda bloqueado.
Comprueba la membresía de Ray, las reglas del cortafuegos, la selección de interfaz de NCCL, la red del contenedor y si todos los nodos pueden الوصول al mismo path del modelo. No depures esto primero desde la capa de API.
Una GPU se queda sin memoria (OOM) mientras las demás tienen margen.
Busca etapas de canalización desiguales, distintos SKU de GPU, fragmentación de memoria o un problema de asignación de rank. Confirma que cada worker esté usando la GPU visible prevista.
La latencia aumenta de forma repentina con prompts largos.
La presión sobre la caché KV, el coste de prefill y la puesta en cola del scheduler son los sospechosos más probables. Prueba primero con buckets separados por longitud de prompt antes de cambiar el hardware.
El endpoint funciona en una terminal, pero falla detrás de un balanceador de carga.
Comprueba el timeout de streaming, el timeout de inactividad, la ruta de health-check, los límites del cuerpo de la solicitud y si el balanceador de carga envía tráfico a una réplica antes de que el modelo esté listo.
Cuándo no ejecutar tú mismo la inferencia multi-GPU de vLLM
Ejecutar vLLM es la opción adecuada cuando necesitas control a nivel de modelo, weights privados, kernels personalizados, cuantización personalizada o experimentos a nivel de hardware. No es automáticamente la opción correcta cuando el requisito de negocio es simplemente "dar a nuestra app una API fiable compatible con OpenAI".
Antes de alquilar un clúster de GPU multinodo, compara la ruta autohospedada con una ruta de modelo/API gestionada:
| Requisito | Autohospedar vLLM en GPU | Línea base de modelo/API gestionada |
|---|---|---|
| Weights personalizados/privados | Muy buena opción | Normalmente no es suficiente |
| Experimentos de hardware | Muy buena opción | No es el objetivo |
| Integración rápida del producto | Más trabajo operativo | Muy buena opción |
| Cambio entre varios modelos | Tú operas cada stack | Una sola gateway puede simplificar el acceso |
| Facturación y visibilidad del uso | Debes construirlo o integrarlo | A menudo incluido |
| Gestión de fallos | Es tu responsabilidad | El proveedor/la gateway gestiona más parte de ello |
Flatkey es el punto de comparación cuando quieres una sola clave compatible con OpenAI, un solo saldo y acceso a endpoints oficiales de modelos sin operar tú mismo la capa de serving en GPU. Si el control directo del hardware no es el requisito del producto, compara con una línea base de modelo/API antes de comprometerte con operaciones de clúster.
Preguntas frecuentes
¿vLLM admite inferencia multi-GPU?
Sí. vLLM admite inferencia multi-GPU mediante paralelismo tensorial y paralelismo de canalización, con opciones de executor que cubren serving en un solo nodo y multinodo. La ruta exacta de compatibilidad depende de tu versión de vLLM, la arquitectura del modelo, la topología de GPU y el backend de despliegue.
¿Cuál es el mejor tamaño de paralelismo tensorial para vLLM?
El mejor tamaño de paralelismo tensorial es el valor de TP más pequeño que proporcione suficiente margen de memoria y rendimiento para tu carga de trabajo. Empieza con las GPU de un nodo rápido y luego compara tp=2, tp=4 o tp=8 con longitudes reales de prompt y de salida.
¿Cuándo debo usar paralelismo de canalización en vLLM?
Usa el paralelismo de canalización cuando el modelo o el requisito de caché KV te obliguen a ir más allá de un nodo, o cuando mantener la comunicación de paralelismo tensorial dentro de cada nodo sea mejor que construir un grupo TP que abarque varios nodos.
¿Ray es necesario para el serving multi-GPU de vLLM?
Ray suele ser la opción práctica para el serving multinodo de vLLM. Para un solo nodo, un backend multiproceso o el backend predeterminado de tu versión de vLLM puede ser más sencillo.
¿Cómo sé si una configuración de inferencia multi GPU de vLLM está lista para producción?
Solo está lista para producción después de comprobar la topología, hacer pruebas de carga en frío, realizar benchmarks realistas de prompt/concurrencia, y documentar health checks, pruebas de reinicio y el comportamiento ante fallos. Una sola solicitud curl exitosa no basta.


