
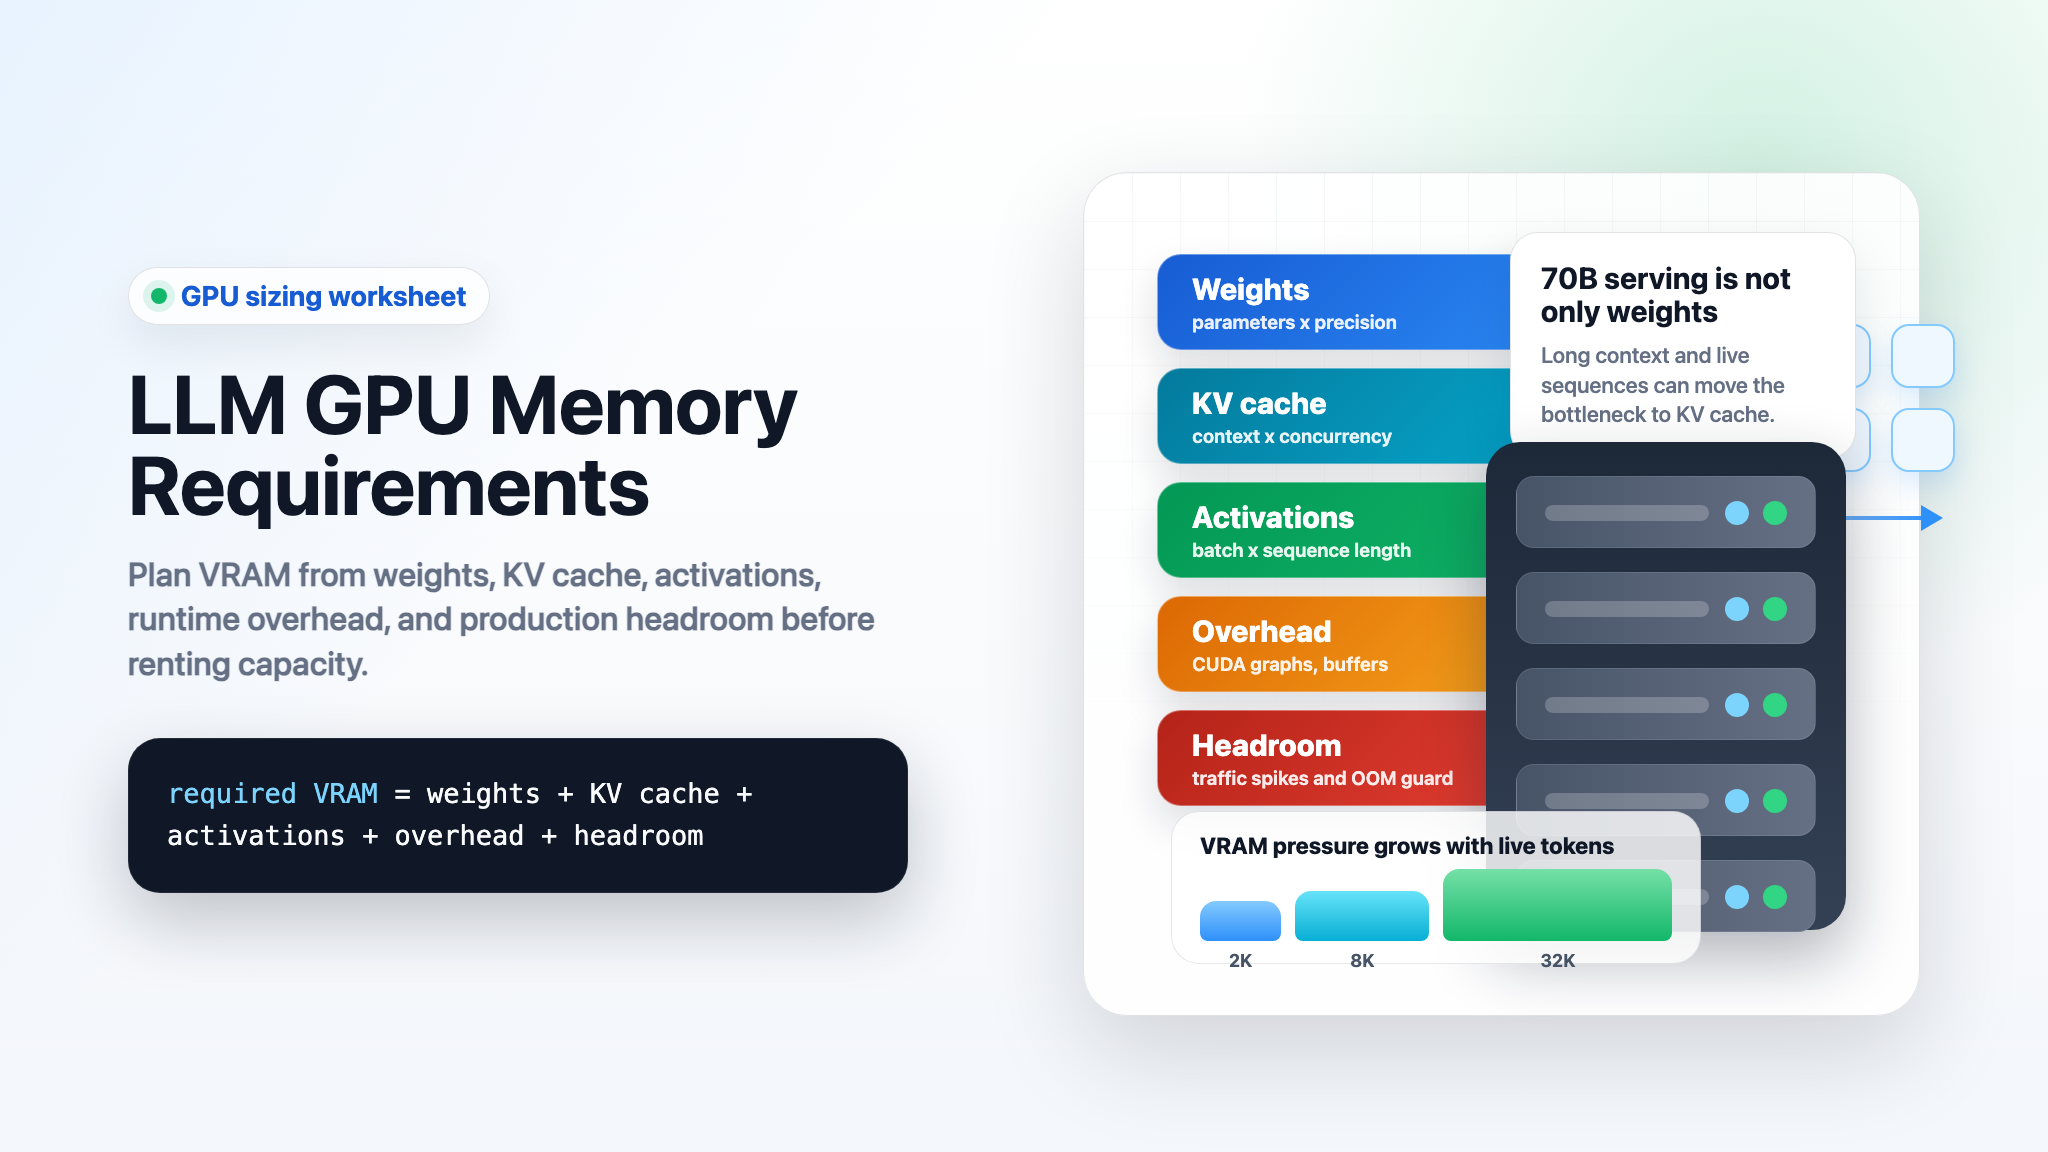
Los requisitos de memoria GPU para LLM no son solo "tamaño del modelo más un poco de margen". Un trabajo de serving o entrenamiento tiene varios compartimentos de memoria separados: pesos del modelo, caché KV, activaciones, áreas de trabajo del framework, gráficos CUDA, buffers temporales y margen operativo.
La regla rápida de planificación es esta:
required VRAM =
  model weights
+ KV cache for live tokens
+ activation and workspace memory
+ training state, if training or full fine-tuning
+ allocator and safety headroom
Por eso dos equipos pueden ejecutar el mismo modelo 70B en la misma clase de GPU y ver resultados distintos. Uno usa prompts cortos, un stream, caché KV FP8 y batching conservador. El otro usa contexto largo, muchas solicitudes concurrentes, captura de gráficos CUDA y una configuración alta de gpu_memory_utilization. El primer trabajo encaja. El segundo falla con errores de memoria insuficiente o consume latencia mientras descarga trabajo en otro sitio.
Esta guía ofrece una hoja de cálculo práctica para los requisitos de memoria GPU para llm en inferencia, serving con vLLM, ajuste fino y entrenamiento. Úsela antes de alquilar una GPU, elegir capacidad H100 frente a H200 frente a B200, o decidir si una API de modelo es más simple que operar su propio endpoint GPU.
Respuesta rápida sobre los requisitos de memoria GPU para LLM
Para inferencia, comience con los pesos y luego dimensione la caché KV según la longitud del contexto y la concurrencia. Para entrenamiento, los pesos son solo el comienzo; los estados del optimizador, los gradientes y las activaciones guardadas dominan la planificación de memoria.
| Carga de trabajo | Qué suele dominar la VRAM | Regla rápida de planificación |
|---|---|---|
| Inferencia de una sola solicitud | Pesos | parameters x bytes_per_weight, y luego añada caché KV para el prompt y los tokens generados. |
| Inferencia de alto rendimiento | Caché KV y margen del planificador | Dimensione por concurrent sequences x tokens per sequence, no solo por el recuento de parámetros del modelo. |
| Serving de contexto largo | Caché KV | Duplicar la longitud del contexto aproximadamente duplica la memoria de caché KV para el mismo modelo y lote. |
| Ajuste fino completo | Estados del optimizador, gradientes, activaciones | AdamW en precisión mixta puede requerir muchas veces la memoria de los pesos del modelo antes de las activaciones. |
| Ajuste LoRA o de adaptadores | Pesos base más activaciones y estado del adaptador | Mucho más pequeño que el ajuste fino completo, pero el contexto largo y el tamaño del lote siguen importando. |
| Preentrenamiento | Estado de entrenamiento más activaciones más sobrecarga distribuida | Planifique a partir de una ejecución medida del framework; las fórmulas son solo el primer paso. |
Si solo necesita salidas del modelo, compare primero el serving directo en GPU con una referencia base de API de modelo. Las GPUs directas tienen sentido cuando necesita pesos personalizados, control de ubicación, política de runtime privada o una carga de trabajo que resulta más barata después de medir la utilización. Si principalmente necesita respuestas API fiables, una ruta de modelo gestionada puede evitar semanas de dimensionamiento de GPU, colas y trabajo operativo.
Hoja de cálculo de requisitos de memoria GPU para LLM
Use esta hoja de cálculo antes de elegir una instancia.
| Compartmento | Fórmula o comprobación | Notas |
|---|---|---|
| Pesos | parameter_count x weight_bytes |
BF16/FP16 usan aproximadamente 2 bytes por parámetro. INT8 usa aproximadamente 1 byte. 4 bits usan aproximadamente 0.5 bytes antes de los metadatos de cuantización. |
| Caché KV | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
El 2 es para claves y valores. La atención de consulta agrupada reduce kv_heads frente a la atención multi-cabeza completa. |
| Activaciones | Inferencia: normalmente modestas. Entrenamiento: escala con el lote, la longitud de secuencia, el tamaño oculto, las capas y las opciones de checkpointing. | La anatomía de memoria del modelo de Hugging Face destaca pesos, estados del optimizador, gradientes, activaciones guardadas, buffers temporales y memoria específica de la funcionalidad para entrenamiento. |
| Reserva del framework de serving | vLLM, TensorRT-LLM, SGLang, PyTorch, gráficos CUDA, kernels de atención, colas de programación | vLLM expone controles de memoria como gpu_memory_utilization, kv_cache_memory_bytes, kv_cache_dtype, max_model_len y max_num_seqs. |
| Margen de seguridad | 10-20% para producción, más durante los primeros benchmarks | Deje espacio para la fragmentación del asignador, picos de tráfico, prompts más largos, recargas del modelo y agentes de observabilidad. |
El error más común es hacer caber los pesos y olvidar los tokens activos. Para una estimación de requisitos de memoria GPU de inferencia LLM, la caché KV puede marcar la diferencia entre un endpoint estable y un bucle de OOM.
Paso 1: calcular la memoria de los pesos del modelo
Los pesos son la parte más simple de los requisitos de memoria GPU para cargas de trabajo LLM.
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Tamaño del modelo | Pesos BF16 / FP16 | Pesos INT8 | Pesos de 4 bits antes de metadatos |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
Esta tabla es un límite inferior. Los despliegues reales añaden escalas de cuantización, buffers no paramétricos, estado del tokenizador/entorno de ejecución, espacios de trabajo temporales y sobrecarga de servicio.
Para una estimación de requisitos de memoria GPU vLLM para un modelo 70B de VRAM, los pesos BF16/FP16 por sí solos ya superan un único H100 de 80 GB. Un solo H200 tiene 141 GB de HBM3e según la página de H200 de NVIDIA, por lo que los pesos pueden caber en principio, pero la caché KV restante y el margen de ejecución aún pueden obligar a un contexto menor, menor concurrencia, cuantización de la caché KV o paralelismo tensorial. NVIDIA indica H100 SXM con 80 GB, H200 con 141 GB y DGX B200 como ocho GPU Blackwell con 1,440 GB totales de HBM3e, lo que equivale efectivamente a 180 GB por GPU B200 en ese sistema.
Paso 2: calcular la memoria de la caché KV para los requisitos de memoria GPU de LLM
La caché KV es la memoria utilizada para almacenar las claves y valores de atención de los tokens ya procesados. Permite que el modelo genere sin volver a calcular todo el prefijo cada vez.
Para la inferencia de un transformer solo-decoder:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
Donde:
| Variable | Significado |
|---|---|
active_tokens |
Suma de tokens del prompt y generados que residen actualmente en la caché a través de las solicitudes activas. |
num_layers |
Número de capas del transformer. |
num_kv_heads |
Cabeceras KV, no siempre cabeceras de atención. La atención de consulta agrupada puede hacer que esto sea mucho menor. |
head_dim |
Dimensión por cabecera. |
2 |
Tensor de clave más tensor de valor. |
bytes_per_kv_element |
2 para BF16/FP16, 1 para FP8, menor para modos de caché de menor bit admitidos. |
Como ejemplo, una forma 70B al estilo Llama con 80 capas, 8 cabeceras KV y dimensión de cabecera 128 usa:
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes por token
Eso es aproximadamente 0.3125 MiB por token activo en la caché KV BF16/FP16.
| Contexto activo por secuencia | Caché KV aproximada para una secuencia | Caché KV aproximada para 16 secuencias activas |
|---|---|---|
| 2,048 tokens | ~0.6 GiB | ~10.0 GiB |
| 4,096 tokens | ~1.3 GiB | ~20.0 GiB |
| 8,192 tokens | ~2.5 GiB | ~40.0 GiB |
| 16,384 tokens | ~5.0 GiB | ~80.0 GiB |
| 32,768 tokens | ~10.0 GiB | ~160.0 GiB |
La cifra exacta cambia según la arquitectura del modelo. Un modelo con más cabeceras KV usa más memoria KV. Un modelo con atención multi-consulta o de consulta agrupada puede usar mucha menos memoria KV que un diseño de atención multi-cabecera completo.
vLLM documenta varios parámetros importantes aquí: --gpu-memory-utilization controla la fracción de memoria GPU utilizada por el ejecutor del modelo, --kv-cache-memory-bytes puede dimensionar explícitamente la caché KV, --kv-cache-dtype puede seleccionar la precisión de la caché, y la guía de ahorro de memoria recomienda reducir max_model_len y max_num_seqs cuando la memoria es ajustada. vLLM también documenta la caché KV FP8 como una forma de reducir la huella de la caché KV y admitir un contexto más largo o mayor rendimiento, aunque sigue siendo necesaria la validación de precisión.
Paso 3: añadir activaciones y sobrecarga de ejecución
Para inferencia, la memoria de activación suele ser menor que la de los pesos y la caché KV, pero no es cero. El prefill, CUDA graphs, kernels de atención, buffers temporales, procesadores multimodales, decodificación especulativa y la programación por lotes pueden reservar memoria adicional.
Para entrenamiento, la memoria de activación se convierte en un término de primer orden. La anatomía de memoria de modelos de Hugging Face enumera los componentes de memoria de entrenamiento como pesos del modelo, estados del optimizador, gradientes, activaciones de avance guardadas para el cálculo de gradientes, buffers temporales y memoria específica de la funcionalidad. También señala que la memoria de activación depende de la longitud de secuencia, el tamaño oculto y el tamaño del lote.
Una división útil para la planificación es:
| Escenario | Postura de activación y sobrecarga |
|---|---|
| Inferencia simple, lote 1 | Deje al menos un 10% de margen después de pesos y caché KV. |
| Servicio vLLM con CUDA graphs y batching | Empiece con un 15-20% de margen, luego ajuste gpu_memory_utilization, max_model_len y max_num_seqs. |
| Servicio de contexto largo | Trate la caché KV como la variable principal y reserve más margen para picos de prefill. |
| Fine-tuning | Mida una ejecución pequeña con la longitud de secuencia objetivo antes de escalar; las activaciones pueden dominar una vez que crecen el lote y el contexto. |
| Modelos multimodales | Añada caché del procesador y memoria de entrada de medios; la guía de ahorro de memoria de vLLM señala la caché multimodal y los controles de límite de entrada. |
No ejecute producción al 99% de memoria solo porque una solicitud de prueba cabe. Eso no deja espacio para prompts más largos, recargas en caliente, captura de CUDA graph, comportamiento del asignador o una mezcla de tráfico diferente del benchmark.
Paso 4: estimar la memoria de entrenamiento y fine-tuning
La memoria de entrenamiento es mayor porque la GPU debe albergar más que los pesos del pase hacia adelante.
Para el ajuste fino completo con precisión mixta y AdamW, la anatomía de memoria de Hugging Face ofrece un desglose práctico: el entrenamiento con precisión mixta puede mantener copias de pesos FP32 y FP16/BF16, estados del optimizador AdamW, gradientes, activaciones guardadas, buffers temporales y memoria específica de la funcionalidad. La misma página resume una configuración típica de AdamW con precisión mixta como 18 bytes por parámetro del modelo más memoria de activación.
Eso significa:
| Tamaño del modelo | 18 bytes por parámetro antes de activaciones |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1,173 GiB |
Por eso las consultas sobre requisitos de memoria GPU para el entrenamiento de LLM necesitan una respuesta distinta de las consultas de inferencia. Un modelo de 70B que puede servirse con paralelismo de tensores y caché KV cuantizada no es automáticamente práctico para un ajuste fino completo en un pequeño número de GPU.
Las formas de reducir la memoria de entrenamiento incluyen:
| Técnica | Qué reduce | Compromiso |
|---|---|---|
| LoRA / QLoRA | Memoria de parámetros entrenables y del optimizador | No es lo mismo que el ajuste fino completo; aún necesita memoria del modelo base y activaciones. |
| Checkpointing de activaciones | Memoria de activaciones guardadas | Más recomputación y menor rendimiento de entrenamiento. |
| ZeRO / FSDP / paralelismo de tensores | Memoria por GPU de optimizador, gradientes, parámetros o cómputo | Mayor complejidad distribuida y sensibilidad a la comunicación. |
| Longitud de secuencia más corta | Memoria de activación y de atención | Puede reducir la calidad de la tarea si la carga de trabajo necesita contexto largo. |
| Micro-batch más pequeño | Memoria de activación | Puede requerir acumulación de gradientes para conservar el tamaño efectivo del batch. |
Para el entrenamiento completo, las fórmulas te llevan a una primera forma de clúster. No sustituyen una ejecución medida del framework.
Paso 5: mapear los requisitos de memoria GPU para LLM a tamaños comunes de memoria GPU
Usa la capacidad de memoria de la GPU como una restricción, no como el único criterio de compra. El ancho de banda de memoria, la topología NVLink, la red, el almacenamiento, la programación y la utilización pueden importar tanto como la VRAM bruta.
| Clase de GPU | Ancla pública de memoria | Qué suele significar para los requisitos de memoria GPU de LLM |
|---|---|---|
| H100 SXM | 80 GB HBM3 | Opción base sólida para servir modelos de 7B-34B y muchos trabajos de ajuste fino. BF16 de 70B normalmente necesita paralelismo de tensores o cuantización. |
| H100 NVL | 94 GB por GPU, 188 GB por pareja en la página de NVIDIA de H100 | Diseñada para inferencia de LLM más grandes en racks empresariales con restricciones de energía; aun así, valida la topología y el SKU del proveedor. |
| H200 | 141 GB HBM3e | Más cómoda para pesos de modelos grandes y contextos más largos que H100, pero el servicio de 70B con alta concurrencia aún puede estar limitado por la caché KV. |
| B200 en DGX B200 | 1,440 GB totales en 8 GPU | Gran pool de memoria para sistemas empresariales de entrenamiento e inferencia, con requisitos operativos que van más allá de la especificación de una sola GPU. |
Si tu hoja de cálculo dice que una sola H200 "apenas encaja" con un modelo de 70B, eso no es un plan de despliegue. Es una señal para hacer pruebas de estos ajustes:
| Ajuste | Por qué importa |
|---|---|
max_model_len |
Establece un límite superior al contexto y, por tanto, a la caché KV. |
max_num_seqs |
Establece un límite superior al número de secuencias concurrentes y a la presión del scheduler. |
kv_cache_dtype |
Puede reducir la memoria de la caché KV, pero requiere comprobaciones de calidad. |
| Tamaño de paralelismo de tensores | Divide el trabajo del modelo entre GPU; también cambia las necesidades de comunicación. |
| Formato de cuantización | Reduce pesos y, a veces, la caché KV; puede afectar a la calidad y al soporte de kernels. |
| Latencia p95 objetivo | Las configuraciones de mayor throughput pueden perjudicar la latencia incluso cuando la memoria encaja. |
Para detalles de selección de hardware, usa esta hoja de cálculo junto con las guías de Flatkey sobre la mejor GPU para inferencia de LLM, H200 vs H100 y B200 vs H200.
Ejemplo: dimensionamiento de inferencia de 70B en vLLM
Esta es una forma conservadora de razonar sobre los requisitos de memoria GPU de vllm para un modelo de 70B en VRAM antes de alquilar capacidad.
Supongamos:
| Entrada | Valor |
|---|---|
| Pesos del modelo | 70B parámetros |
| Precisión de pesos | BF16 / FP16 |
| Memoria de pesos | ~130.4 GiB |
| Forma de la caché KV | 80 capas, 8 cabezas KV, dimensión de cabeza 128 |
| Precisión KV | BF16 / FP16 |
| KV por token activo | ~0.3125 MiB |
Luego compara algunas configuraciones de servicio:
| Objetivo de servicio | Caché KV aproximada | Por qué importa |
|---|---|---|
| 1 secuencia activa, 4K tokens | ~1.3 GiB | Los pesos dominan. Una sola GPU de gran memoria puede caber solo con poco margen libre. |
| 8 secuencias activas, 4K tokens | ~10.0 GiB | Requiere margen libre real más allá de los pesos. |
| 16 secuencias activas, 8K tokens | ~40.0 GiB | Un plan de una sola GPU suele ser frágil a menos que los pesos o la caché KV estén cuantizados. |
| 16 secuencias activas, 16K tokens | ~80.0 GiB | Solo la caché KV equivale aproximadamente a la memoria de una H100 SXM. |
En la práctica, un plan vLLM de 70B suele encajar en una de estas rutas:
| Ruta | Encaje |
|---|---|
| Pesos BF16, baja concurrencia, contexto más corto | La memoria de clase H200 puede funcionar tras las comprobaciones de sobrecarga. |
| Pesos BF16, concurrencia de producción | Use paralelismo tensorial y verifique la red/topología. |
| Pesos cuantizados, caché KV BF16/FP16 | Buen primer benchmark cuando la calidad permite la cuantización de pesos. |
| Pesos cuantizados más caché KV FP8 | Puede desbloquear más contexto o más concurrencia, pero requiere validación de precisión y latencia. |
| Sin requisito de control de hardware | Compare una ruta de API de modelo antes de comprometerse con operaciones en GPU. |
Esta es la respuesta práctica a los requisitos de memoria GPU para LLM en servicio: el conteo de parámetros te dice si el modelo puede cargarse; la caché KV y la reserva de tiempo de ejecución te dicen si puede atender tráfico útil.
Por qué la longitud de contexto cambia la respuesta
El contexto largo es caro porque la caché crece con los tokens activos. Si duplicas el contexto de 8K a 16K, la caché KV aproximadamente se duplica para el mismo modelo, precisión y concurrencia. Si duplicas la concurrencia con el mismo contexto, la caché KV aproximadamente se duplica de nuevo.
Para equipos que comparan planes de requisitos de memoria GPU de hardware llm, esto crea un patrón sencillo de dimensionamiento:
más usuarios x prompts más largos x más tokens de salida = más caché KV
Antes de alquilar una GPU más grande, pregúntate si el producto realmente necesita el contexto máximo para cada solicitud. Muchos sistemas pueden enrutar:
| Tipo de solicitud | Política de ahorro de memoria |
|---|---|
| Chat corto o extracción | Límite de contexto más pequeño, mayor concurrencia. |
| Análisis de documentos largos | Límite de contexto más grande, grupo de concurrencia más bajo. |
| Trabajos por lotes | Cola por presupuesto de tokens, no solo por número de solicitudes. |
| Cargas de trabajo premium | Grupo dedicado con contexto máximo explícito y objetivo p95. |
Esto suele ser más barato y más estable que ejecutar un único endpoint enorme con un único ajuste global de memoria.
Qué medir en el primer benchmark
Ejecuta un benchmark que se parezca al tráfico de producción, no un único prompt de camino feliz.
| Métrica | Por qué debe estar en el primer benchmark |
|---|---|
| VRAM máxima asignada y reservada | Detecta el margen libre del asignador y del framework, no solo las matemáticas de tensores. |
| Latencia de prefill | Los prompts largos someten a presión el ancho de banda de memoria y los kernels de atención. |
| Tokens por segundo en decode | Muestra el rendimiento de generación en estado estable. |
| Latencia p95 y p99 | Evita que una configuración optimizada solo para throughput perjudique a los usuarios. |
| Tasa de OOM | Realiza el seguimiento de fallos de memoria bajo una mezcla real de tráfico. |
| Uso de caché KV | Explica si el cuello de botella es el contexto/concurrencia o los pesos. |
| Coste del resultado aceptado | Conecta el coste del alquiler de GPU con completions útiles, no con tokens brutos. |
Para despliegues multinodo, combina esto con las listas de verificación de arquitectura de clúster GPU y TCO de clúster GPU. Un modelo que encaja en memoria aún puede ser caro si la red, el almacenamiento, la cola o la utilización son deficientes.
Errores comunes
| Error | Mejor enfoque |
|---|---|
| Dimensionar solo a partir del conteo de parámetros | Agrega caché KV, activaciones, reserva del framework y margen libre. |
| Tratar "encaja una vez" como listo para producción | Prueba el contexto objetivo, la concurrencia, la longitud de salida y el comportamiento de reintento. |
| Ignorar la precisión de la caché KV | Valida FP8 u otros formatos de caché cuando la memoria sea el cuello de botella. |
| Usar el nombre de la GPU del proveedor sin el SKU exacto | Confirma la capacidad de memoria, la interconexión, la política MIG, la pila de controladores y si las GPU se comparten. |
| Asumir que la memoria de entrenamiento equivale a la memoria de inferencia | El entrenamiento añade estados del optimizador, gradientes, activaciones guardadas y sobrecarga distribuida. |
Ejecutar gpu_memory_utilization de forma demasiado agresiva |
Deja suficiente reserva para CUDA graphs, buffers, picos de tráfico y el comportamiento del asignador. |
Guía de decisión: ¿alquilar GPUs o usar una API de modelo?
La capacidad directa de GPU es la dirección correcta cuando necesitas una o más de estas:
| Elija GPUs directas cuando... | Elija una base de API de modelo cuando... |
|---|---|
| Sirve pesos personalizados o fine-tunes privados. | Utiliza modelos alojados comunes y principalmente necesita resultados fiables. |
| Necesita ubicación, aislamiento o control del tiempo de ejecución. | No quiere gestionar colas, autoescalado, imágenes, drivers y fallos de GPU. |
| Su utilización medida es lo bastante alta como para superar la economía de la API. | El tráfico es intermitente, incipiente o difícil de predecir. |
| Puede encargarse de la evaluación comparativa y la respuesta ante incidentes. | Su equipo prefiere dedicar el tiempo de ingeniería a la lógica del producto. |
Flatkey es útil como ruta base cuando el control del hardware no es el requisito del producto. Ofrece a los equipos un único equilibrio entre modelos y herramientas oficiales, de modo que pueda comparar el coste de alquiler de GPU frente al coste de salida de la API del modelo antes de comprometerse con un clúster de larga duración. Si la evaluación comparativa demuestra que las GPUs directas ganan, use la hoja de cálculo de memoria anterior para alquilar la configuración más pequeña y fiable en lugar de la más grande e impresionante.
Preguntas frecuentes
¿Cuánta memoria GPU necesita un LLM de 70B?
Los pesos BF16 o FP16 para un modelo de 70B requieren unos 130 GiB antes de la caché KV y la sobrecarga del tiempo de ejecución. Los pesos INT8 son unos 65 GiB antes de los metadatos. Los pesos de 4 bits son unos 33 GiB antes de los metadatos de cuantización. Para inferencia en producción, añada la caché KV para contexto y concurrencia, la reserva del framework de servicio y un margen de seguridad.
¿Por qué un modelo carga pero falla con tráfico?
La prueba de carga puede ajustarse solo a los pesos. El tráfico real añade caché KV para los prompts activos y los tokens generados, sobrecarga de batching, buffers temporales y reservas del framework. Prompts más largos y más secuencias concurrentes pueden llevar el mismo modelo a OOM.
¿Qué afecta más a los requisitos de memoria GPU para la inferencia de LLM?
Las variables más importantes son el tamaño del modelo, la precisión de los pesos, la longitud del contexto, las secuencias concurrentes, la precisión de la caché KV y la configuración del framework de servicio. Para el servicio con contexto largo, la caché KV a menudo se convierte en el cuello de botella.
¿Qué afecta a los requisitos de hardware de LLM para memoria GPU durante el entrenamiento?
El entrenamiento añade estados del optimizador, gradientes, activaciones guardadas, buffers temporales y sobrecarga del framework distribuido. El tamaño del lote, la longitud de la secuencia, el checkpointing de activaciones, la elección del optimizador y la estrategia de sharding pueden cambiar drásticamente el número de GPUs.
¿vLLM reduce los requisitos de memoria GPU?
vLLM ofrece controles de memoria útiles y una gestión eficiente de la caché KV, pero no elimina el presupuesto de memoria subyacente. Aun así necesita suficiente VRAM para pesos, caché KV, activaciones, reserva de ejecución y margen. Sus controles de memoria le ayudan a elegir el equilibrio entre longitud de contexto, concurrencia, precisión y rendimiento.
¿Puede la caché KV FP8 resolver la presión de memoria de contexto largo?
Puede reducir la huella de la caché KV, y vLLM documenta la compatibilidad con caché KV FP8. Trátelo como una configuración de benchmark, no como un interruptor gratis: valide la calidad de salida, la latencia, las rutas compatibles de hardware/software y el comportamiento ante fallos antes de usarlo en producción.
Lista de verificación final
Antes de alquilar capacidad, responda estas preguntas:
- ¿Qué tamaño de modelo y precisión de pesos está sirviendo?
- ¿Cuál es la longitud máxima de contexto que los usuarios realmente pueden enviar?
- ¿Cuántas secuencias concurrentes deben caber con carga p95?
- ¿Qué longitud de salida reserva para la generación?
- ¿La caché KV es BF16/FP16, FP8 u otro formato compatible?
- ¿Qué margen queda después de los pesos y la caché KV?
- ¿Está usando paralelismo de tensor, cuantización, LoRA, FSDP o ZeRO?
- ¿Qué SKU exacta de GPU, capacidad de memoria y topología asignará el proveedor?
- ¿Qué umbrales de OOM, latencia y coste por salida aceptada definen el éxito?
- Si no necesita control del hardware, ¿cuál es el coste de la base de API del modelo?
La mejor estimación de requisitos de memoria GPU para llm es la que sobrevive a un benchmark con forma de producción. Use la hoja de cálculo para rechazar rápidamente configuraciones de GPU imposibles, y luego valide la lista corta con longitudes de contexto reales, concurrencia real y suficiente margen para mantenerse en línea.
Fuentes
- Argumentos del motor de vLLM:
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtypey controles de caché relacionados: https://docs.vllm.ai/en/latest/configuration/engine_args.html - Guía de ahorro de memoria de vLLM: paralelismo de tensor, cuantización, longitud de contexto, tamaño de lote, memoria de CUDA graph y controles de memoria multimodal: https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- Guía de caché KV cuantizada de vLLM: opciones y compensaciones de la caché KV FP8: https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Anatomía de la memoria de modelos en Hugging Face Transformers: bloques de memoria de entrenamiento, estados del optimizador, gradientes, activaciones y notas de memoria de precisión mixta: https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- Página de producto NVIDIA H100: memoria H100, ancho de banda, H100 NVL y posicionamiento para LLM: https://www.nvidia.com/en-us/data-center/h100/
- Página de producto NVIDIA H200: 141 GB de HBM3e y ancho de banda de memoria: https://www.nvidia.com/en-us/data-center/h200/
- Página de producto NVIDIA DGX B200: ocho GPUs B200 y 1.440 GB de HBM3e total: https://www.nvidia.com/en-us/data-center/dgx-b200/


