
Coûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
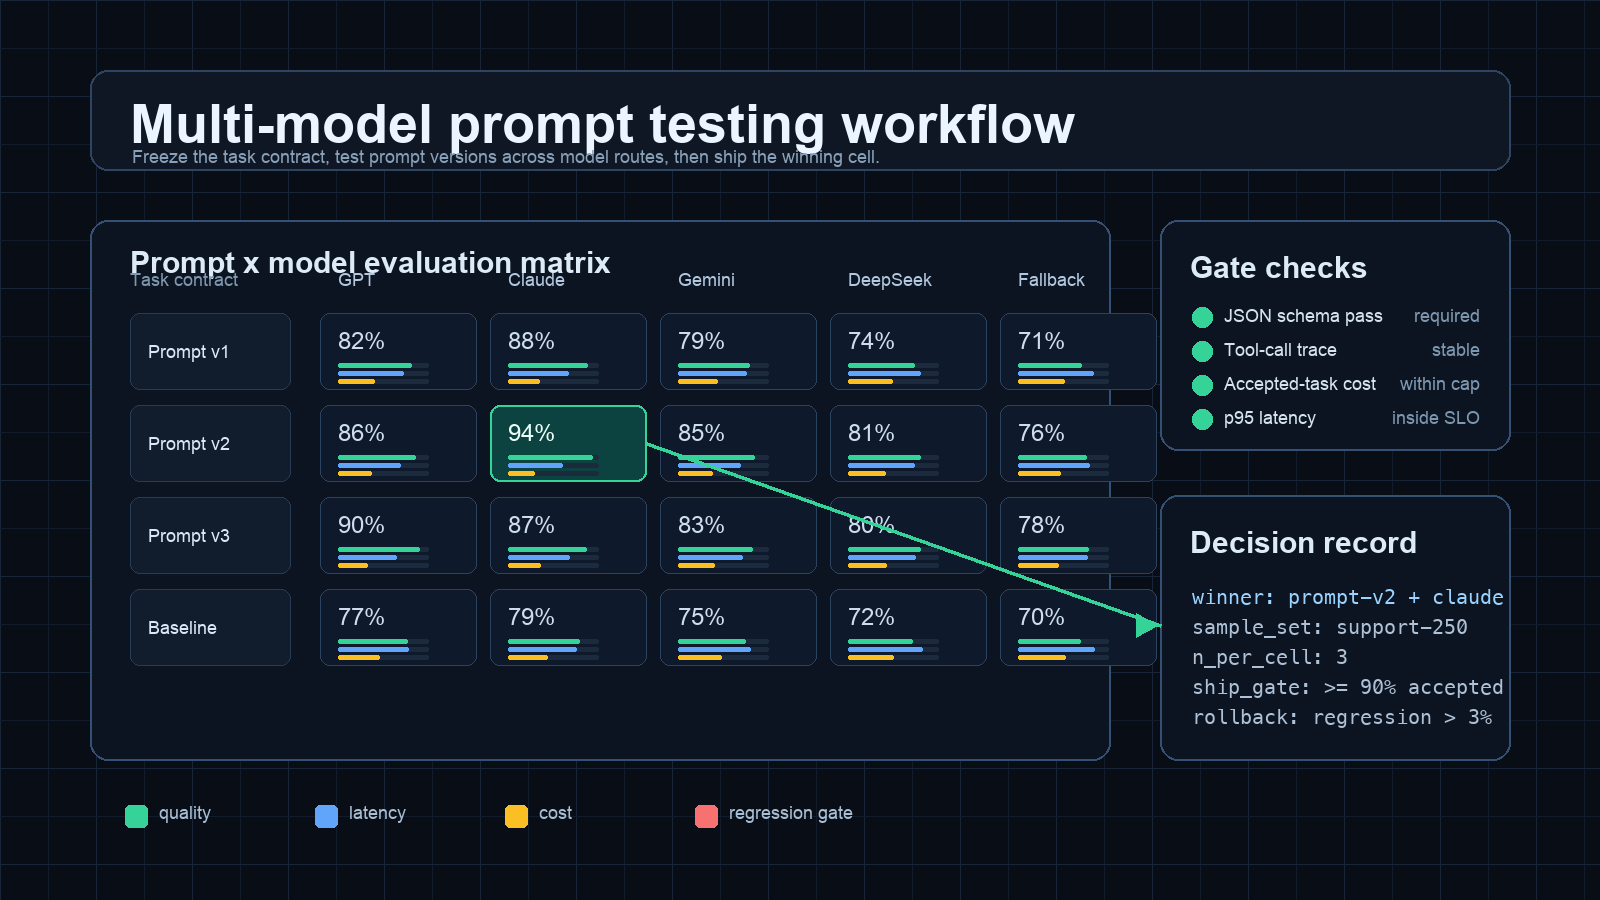
Flux de travail de test de prompts multi-modèles : matrice d’évaluation pour les équipes produit IA
Menez un flux de travail de test de prompts multi-modèles avec des matrices prompt/modèle, des validateurs, le coût par tâche acceptée, des seuils de latence et des journaux de déploiement.
Comment comparer les prix des modèles d’IA avant de changer de fournisseur d’API
Comparez les prix des modèles d’IA en tenant compte du comportement du cache, de la qualité des résultats acceptés, de la latence, des tentatives de reprise et du coût effectif par tâche réussie avant de changer de fournisseur d’API.
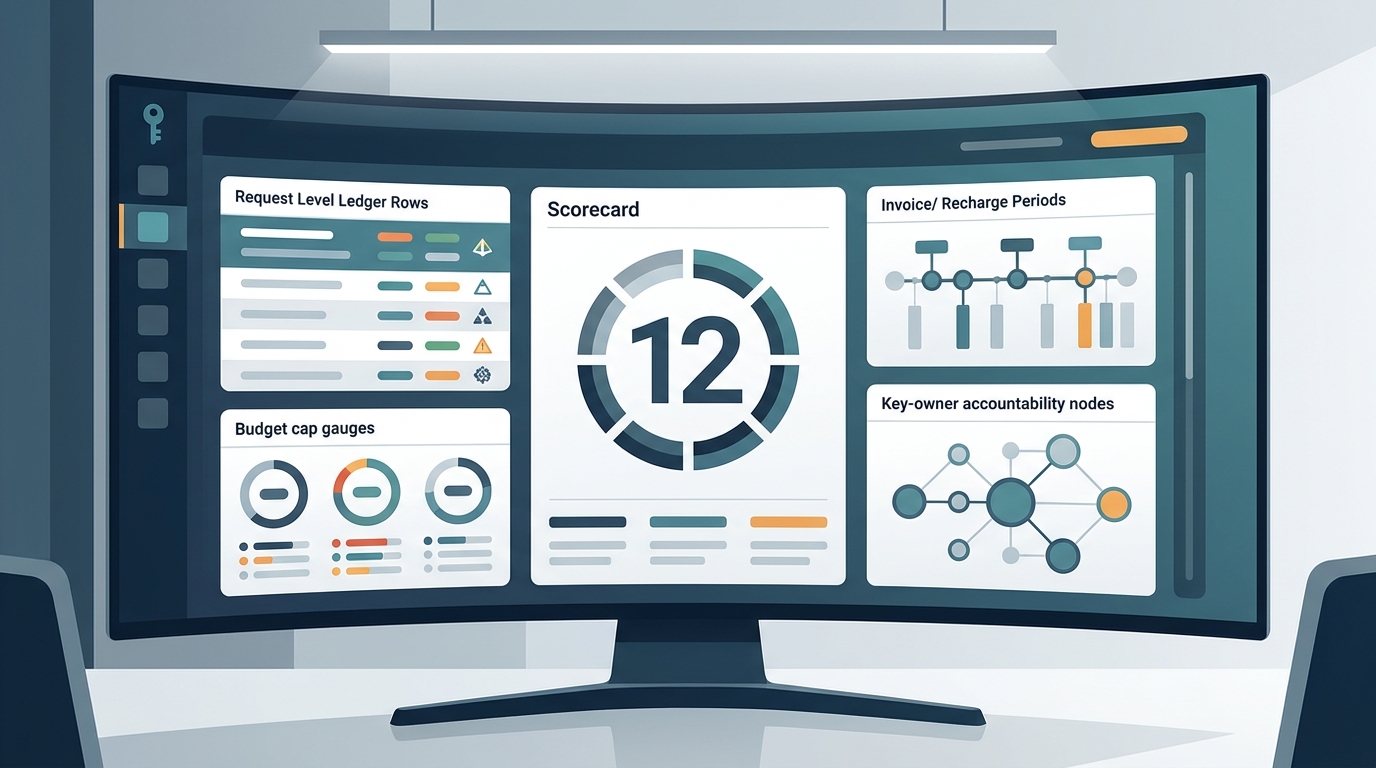
Tableau de bord de facturation IA unifié : 12 questions à poser avant d’acheter
Un cadre d’achat en 12 questions pour évaluer les tableaux de bord de facturation IA unifiés, couvrant les registres d’utilisation, les clés API, les quotas, les historiques de recharge, les exports, les factures et la responsabilité.
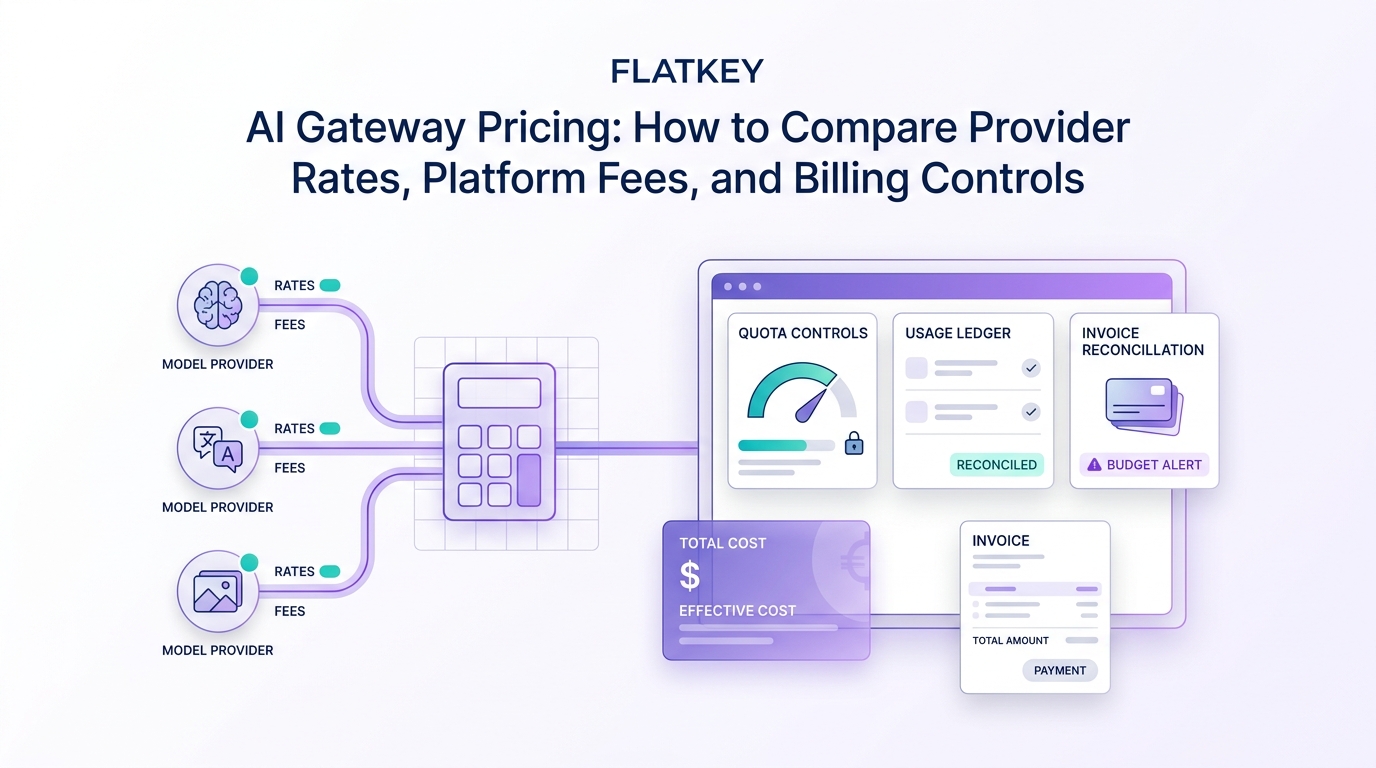
Tarifs des passerelles IA (octobre 2026) : comparatif de Vercel, Cloudflare, OpenRouter, Portkey, LiteLLM, Helicone et Flatkey
Ce que facturent réellement les passerelles IA en octobre 2026 : absence de majoration et options Vercel AI Gateway, Unified Billing de Cloudflare, frais sur les crédits OpenRouter, offres Portkey et Helicone, LiteLLM et recharges Flatkey, avec des exemples de coûts totaux.

Tarifs de l'API OpenAI (octobre 2026) : GPT-6, GPT-5.6 et chaque tarif par token expliqué
Tous les tarifs actuels par token de l'API OpenAI pour GPT-6 et GPT-5.6, avec Batch, Flex, entrée en cache, règles de contexte long, exemples de coûts et code.
Tarifs de l'API Gemini (octobre 2026) : tous les modèles, l'offre gratuite et des coûts réels
Les prix actuels de l'API Gemini pour chaque modèle, les modèles gratuits, limites et usage des données de l'offre gratuite, remises batch et cache, et exemples de coûts.
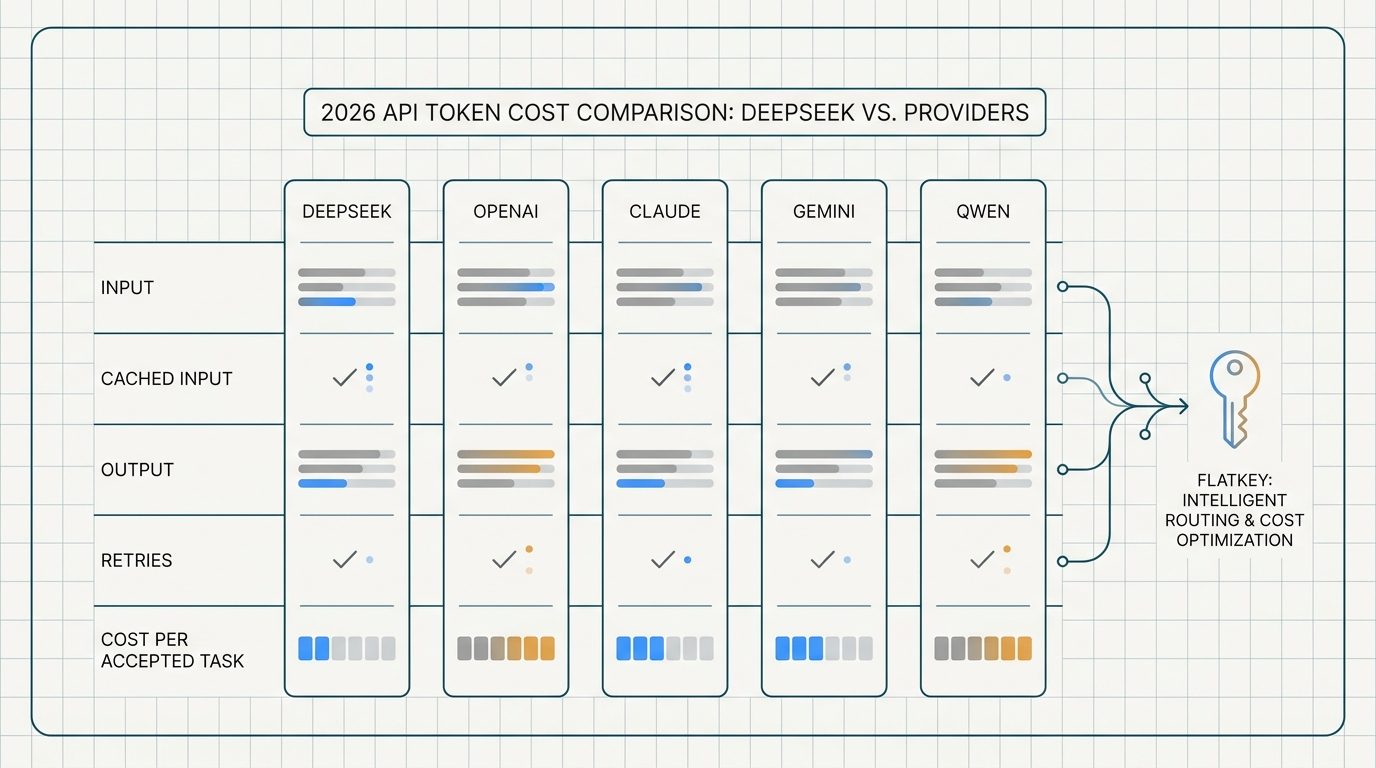
Tarifs de l'API DeepSeek (octobre 2026) : Flash vs V4 Pro, heures de pointe et cache
Tarifs DeepSeek par 1M tokens pour Flash et V4 Pro, heures de pointe et creuses en heure américaine, calcul des hits de cache, un calculateur de coûts et du code.
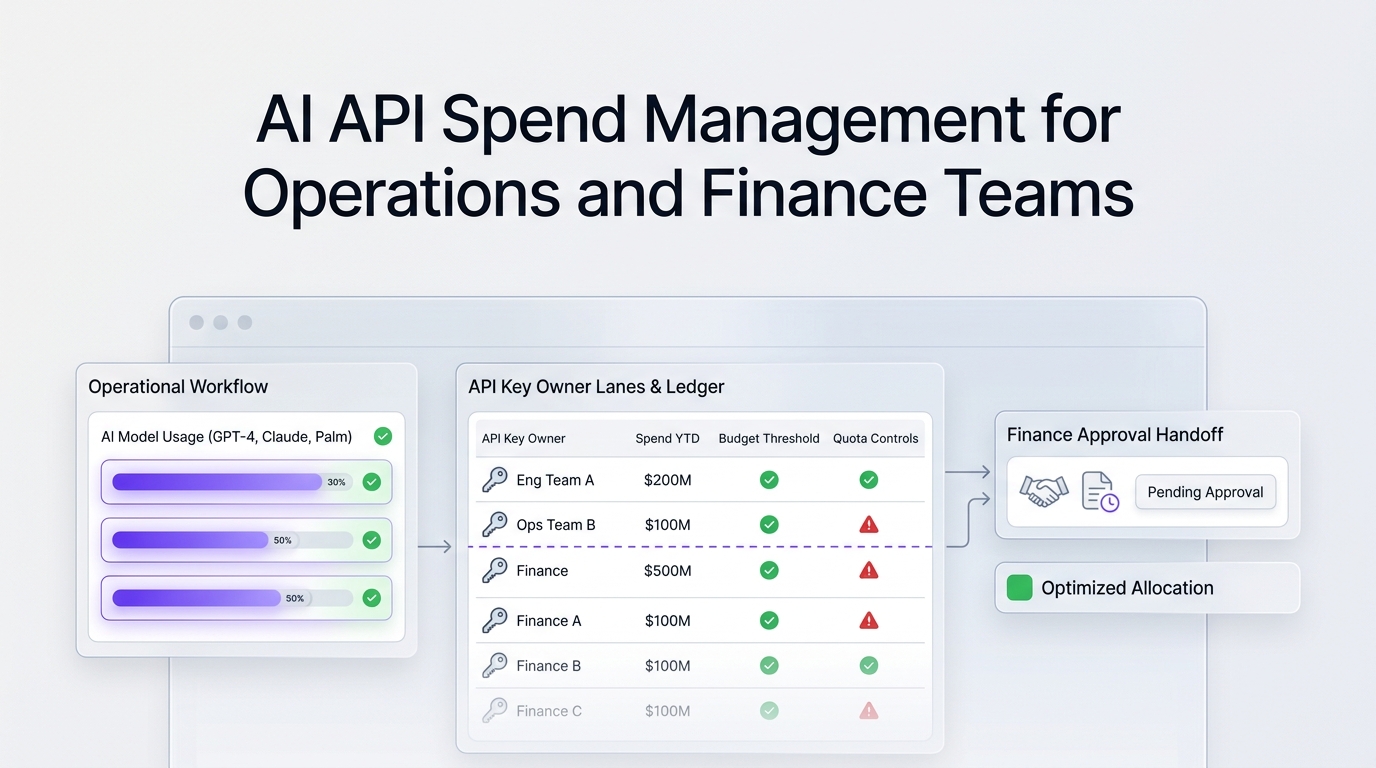
Gestion des dépenses d’API IA pour les équipes opérations et finance
Un guide pratique de gestion des dépenses d’API IA pour les équipes opérations et finance, couvrant les responsables, quotas, registres, factures, soldes et workflows de revue mensuelle.
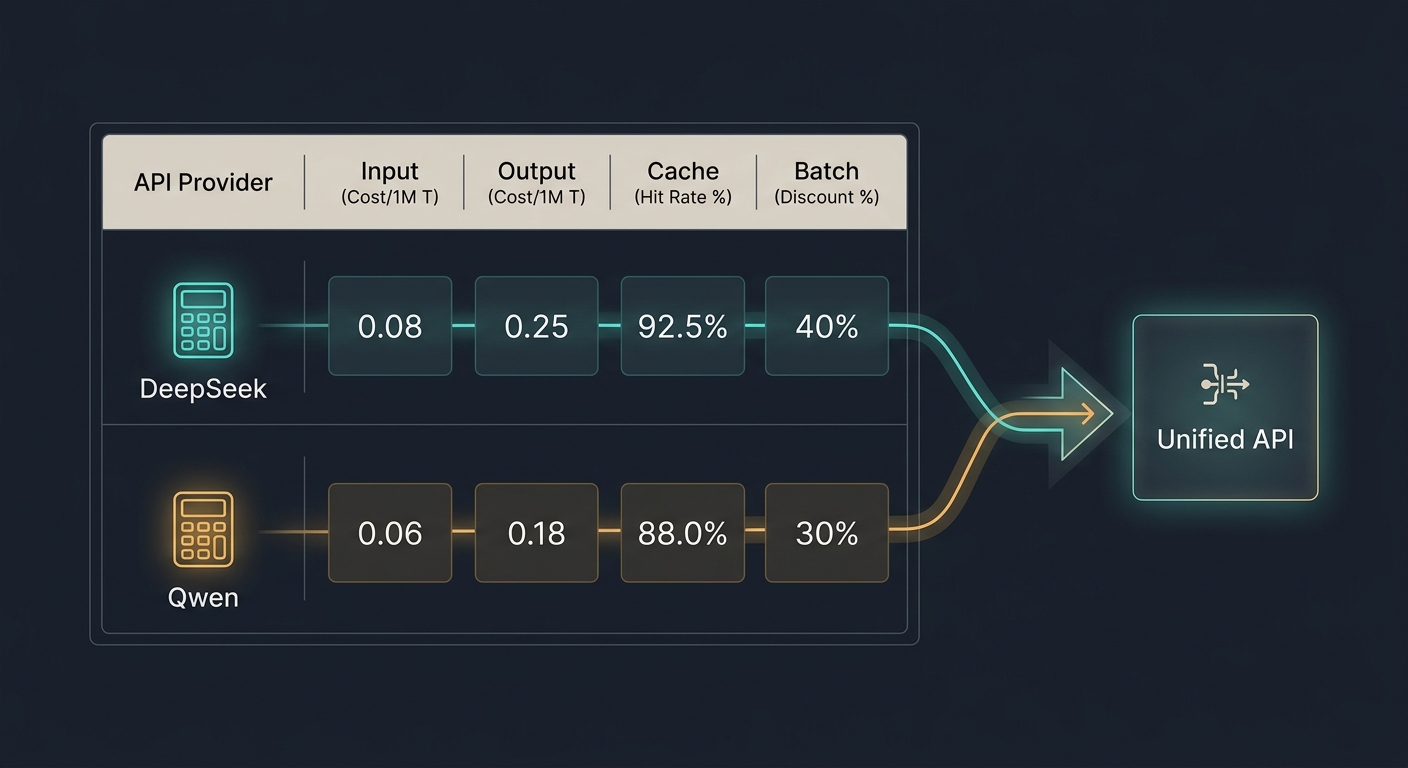
DeepSeek API vs Qwen API pour les flux de travail sensibles aux coûts : guide des coûts 2026
Comparez les coûts de DeepSeek API et Qwen API pour les flux de travail riches en cache, par lots et de chat court, avec des vérifications de prix 2026 et un calculateur de coût par tâche acceptée.
Optimisation des coûts IA (2026) : 9 façons de réduire vos dépenses en API LLM sans perdre en qualité
Optimiser les coûts IA, c’est réduire le coût de chaque tâche réussie. Neuf stratégies illustrées par des calculs aux tarifs officiels d’octobre 2026 : routage, mise en cache des prompts, traitement par lots, allègement des prompts, plafonds de sortie, maîtrise des nouvelles tentatives, budgets, vérification mensuelle des tarifs et passerelles.

Mise en cache des prompts OpenAI (octobre 2026) : fonctionnement, tarifs et ROI
La mise en cache des prompts OpenAI est automatique et facture l'entrée en cache à environ 0,1 fois le tarif normal. Découvrez les tarifs d'écriture et de lecture d'octobre 2026, les TTL de 30 minutes et 12 heures, les breakpoints explicites, un exemple de ROI chiffré et la comparaison avec Claude et Gemini.
Comparatif des offres gratuites : limites des API gratuites d’OpenAI, Claude, Gemini et DeepSeek
Comparez les limites des API gratuites, les offres gratuites, les paliers de facturation et les risques de limitation de débit d’OpenAI, Claude, Gemini et DeepSeek avant de vous lancer.
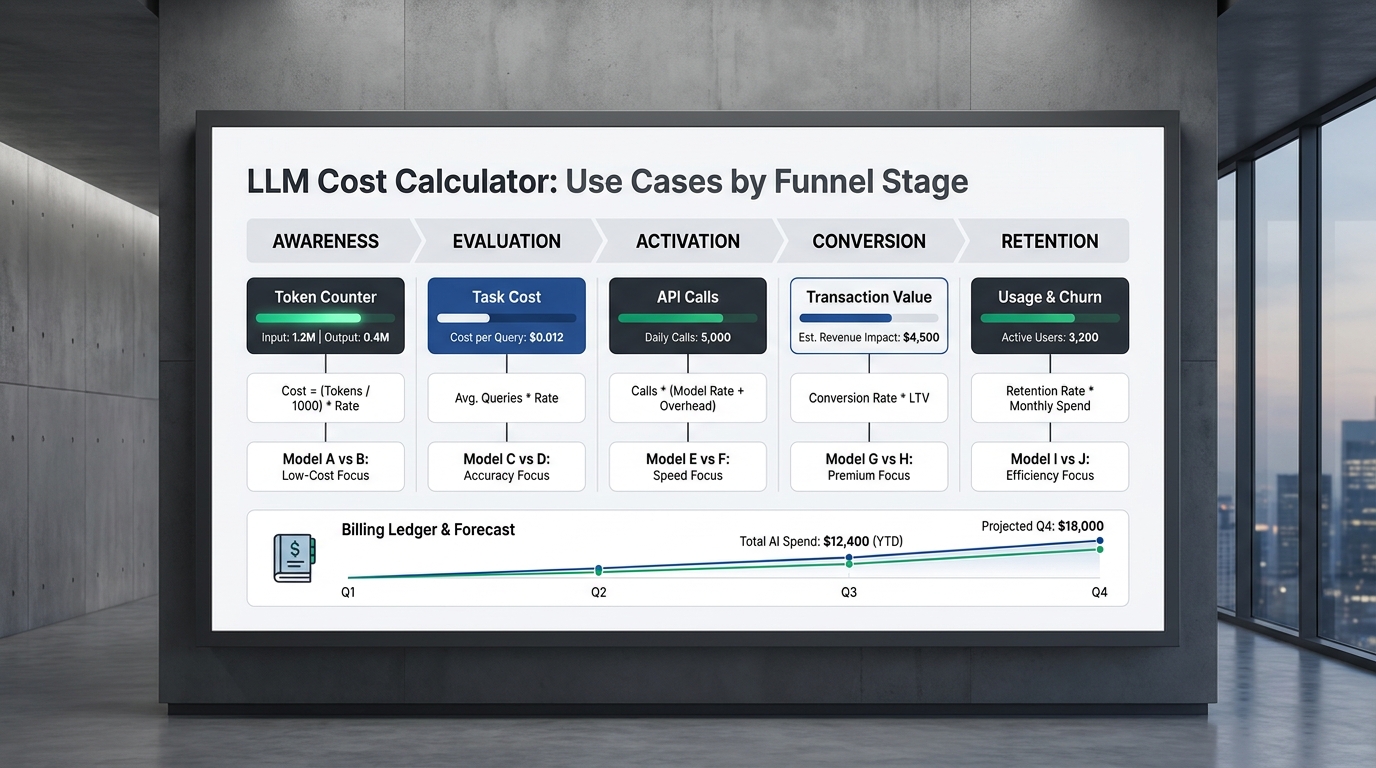
Cas d’usage d’un calculateur de coût LLM par étape du funnel
Découvrez quelle métrique du calculateur de coût LLM correspond à chaque étape du funnel, du chiffrage approximatif des opportunités au coût par tâche acceptée, en passant par les budgets d’activation, les contrôles de marge et les alertes de dérive de rétention.
Tarification des agents IA et statistiques sur les coûts des LLM à connaître en 2026
Un tour d’horizon sourcé de la tarification des agents IA et des statistiques sur les coûts des LLM pour 2026, avec les dépenses des entreprises, l’adoption, le ROI et l’économie des tokens.
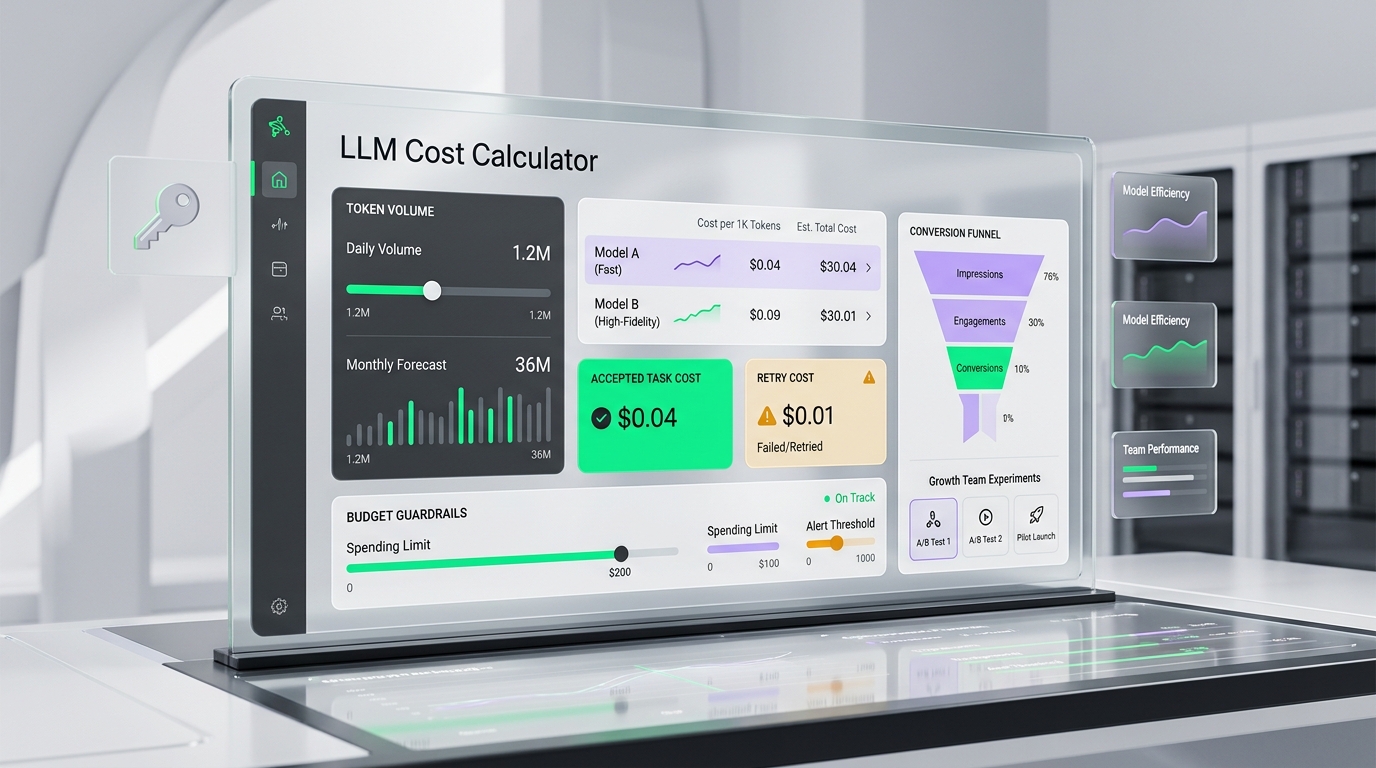
Calculateur de coût LLM pour les équipes growth : un workflow pratique
Découvrez comment créer un calculateur de coût LLM qui suit le coût par tâche acceptée, compare les modèles de manière équitable et maintient les expériences des équipes growth dans le budget.
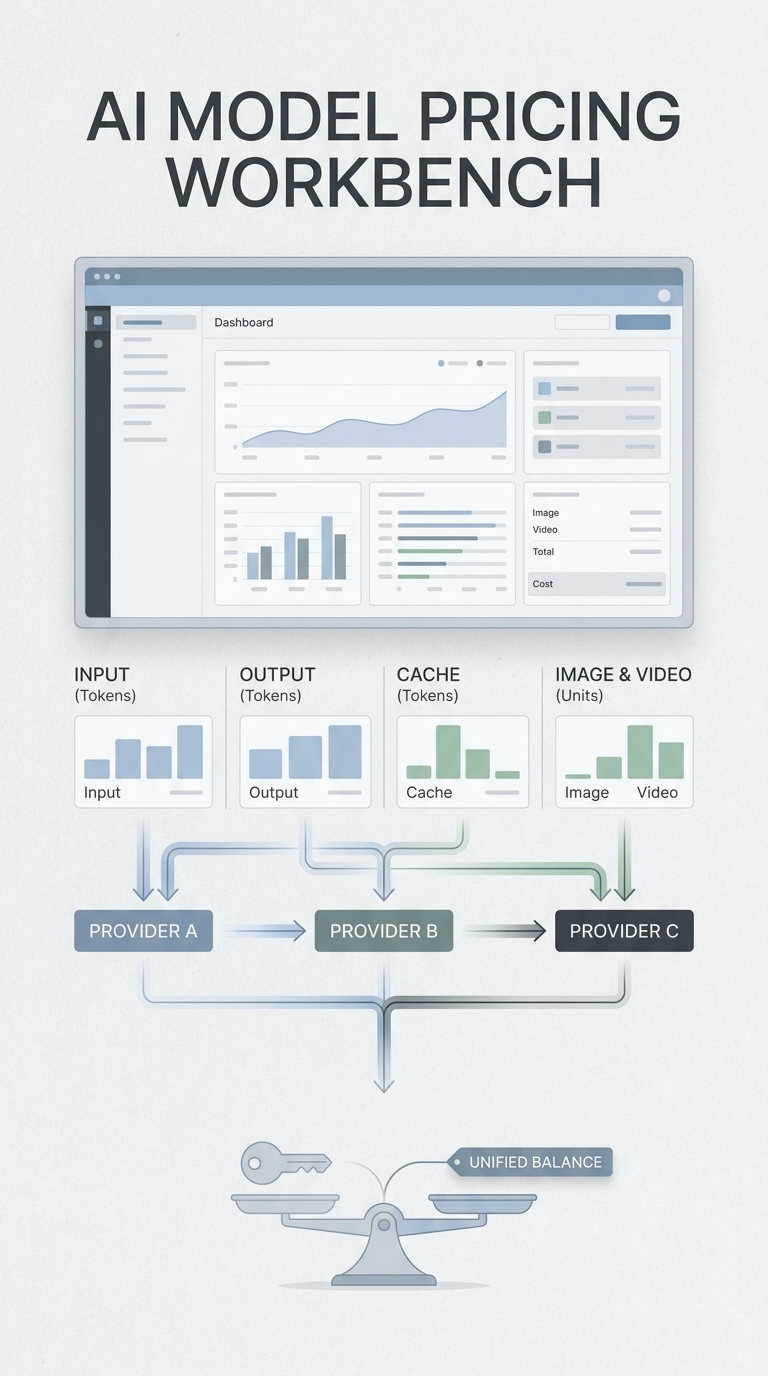
Qu’est-ce que la tarification des modèles d’IA et quand est-ce important ?
Découvrez comment fonctionne la tarification des modèles d’IA, ce qui influence réellement le coût, et quand une passerelle aide les équipes à comparer les charges de travail en tokens, images et vidéos.

Comparatif des tarifs des API d’IA (octobre 2026) : OpenAI vs Claude vs Gemini vs Qwen vs DeepSeek vs Kimi
Un tableau daté des tarifs officiels des API d’OpenAI, Claude, Gemini, Qwen, DeepSeek et Kimi en octobre 2026, avec les remises, les dates de fin des promotions, des exemples de budgets mensuels et un calculateur de coûts.
Limites de quota des API IA : comparer les prix d’OpenAI, Claude, Gemini et Qwen
Comparez les prix des tokens d’OpenAI, Claude, Gemini et Qwen, puis transformez les estimations de coût par requête en quotas pour les équipes, les environnements, les clés et les charges de travail.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer