
Coûts, facturation et exploitation
Derniers articles dans Coûts, facturation et exploitation.
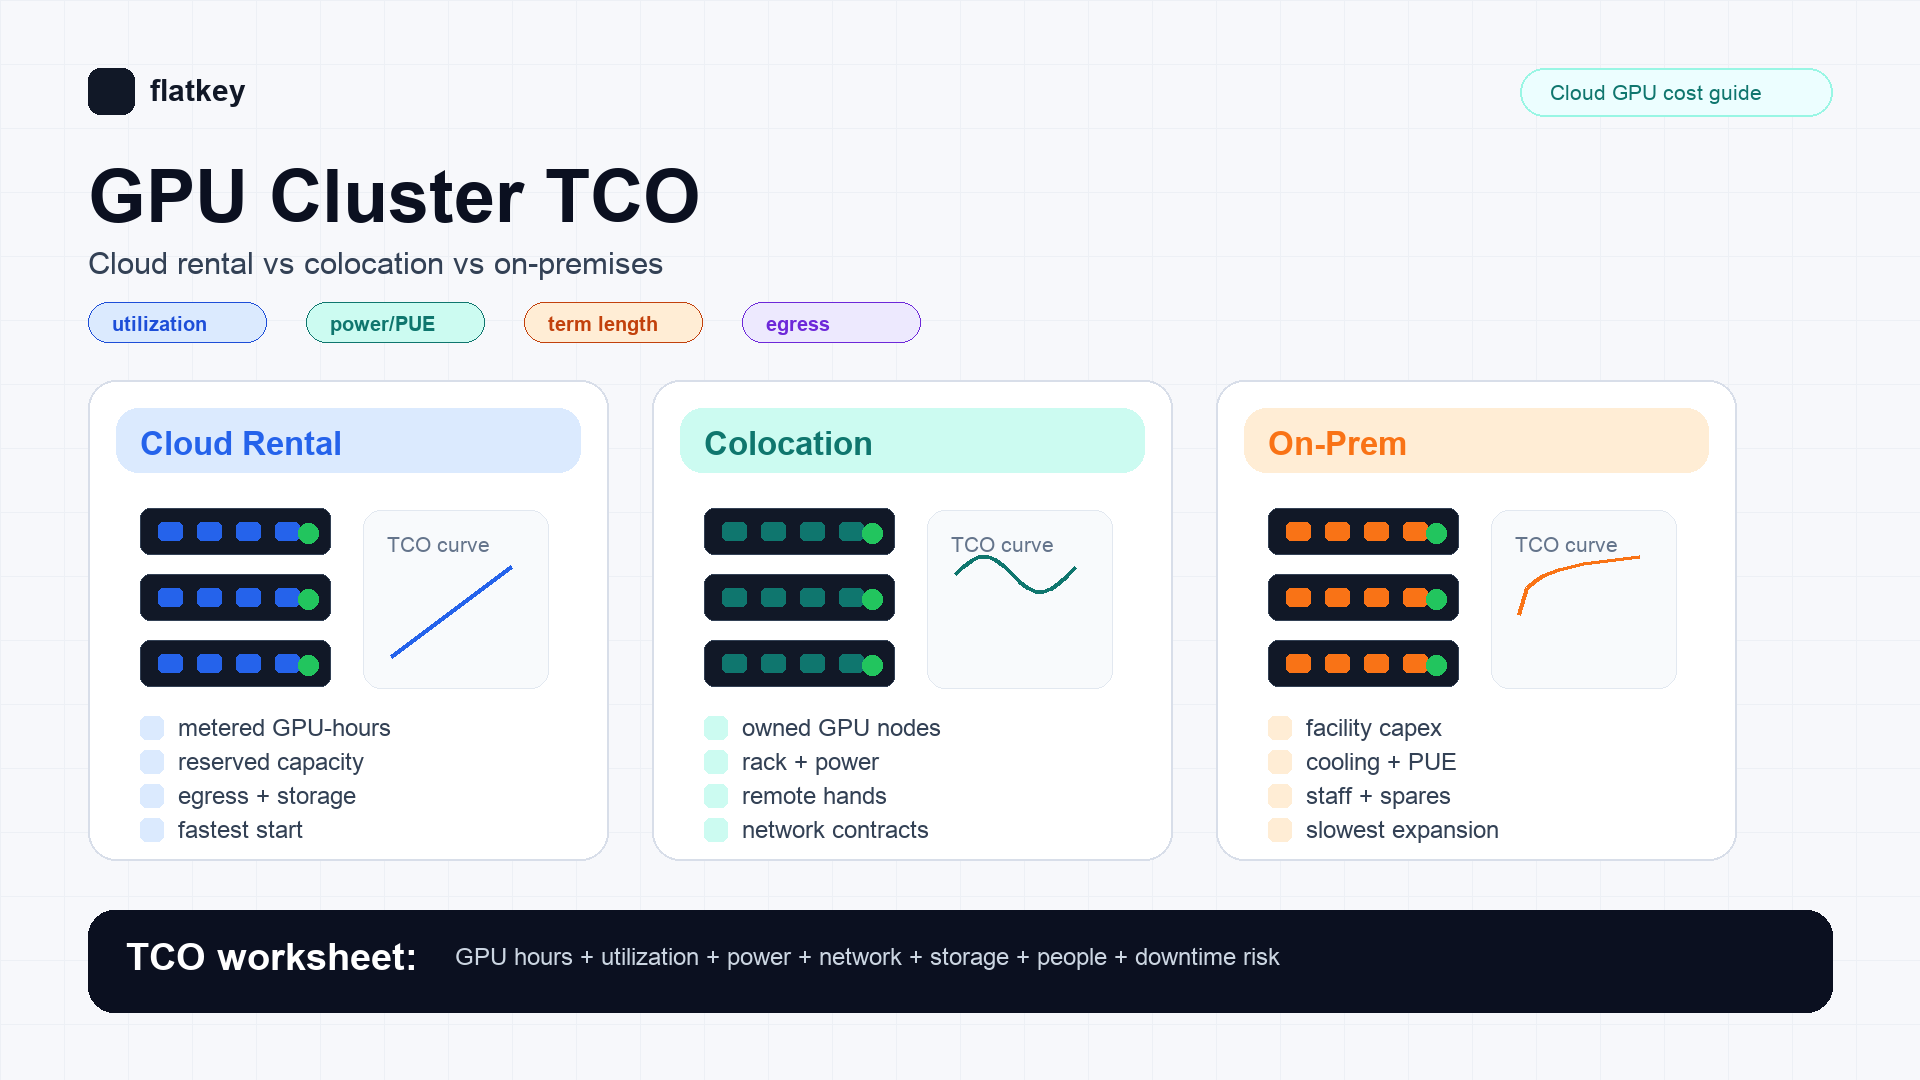
TCO d’un cluster GPU : location cloud vs colocation vs on-premises
Comparez le TCO d’un cluster GPU entre location cloud, colocation et on-premises avec une feuille de calcul FinOps pratique pour les acheteurs d’infrastructure IA.
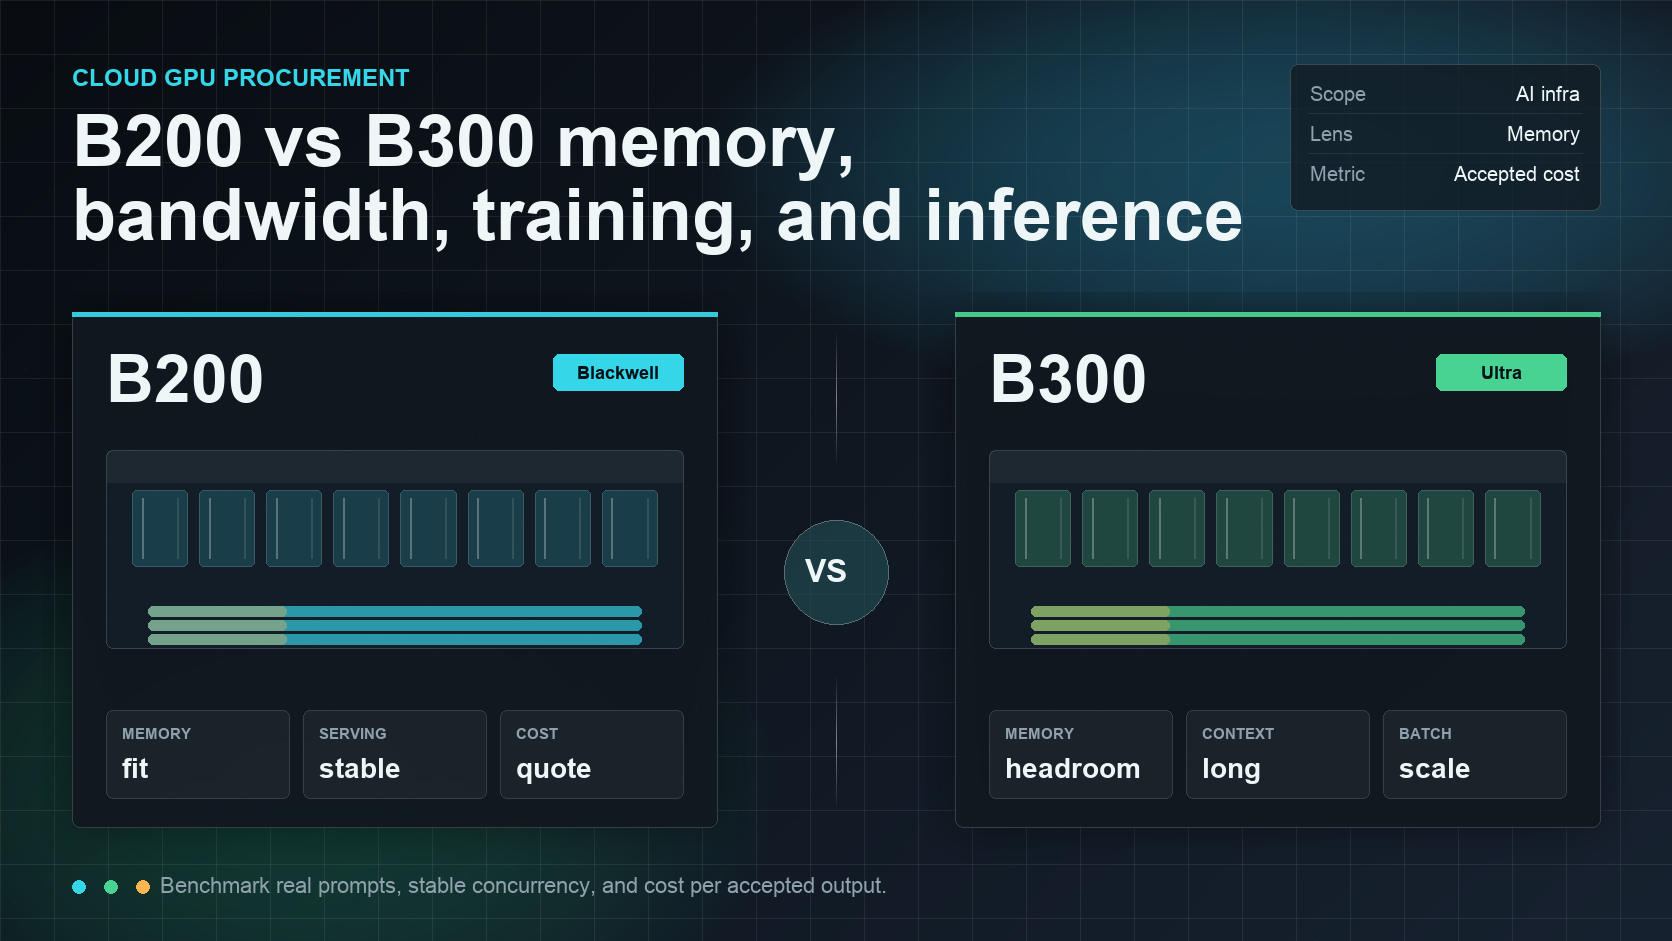
NVIDIA B300 vs B200 : mémoire, bande passante, entraînement et inférence
Une comparaison pratique B200 vs B300 pour les équipes d’infrastructure ML évaluant la mémoire GPU NVIDIA Blackwell, la bande passante, l’entraînement, l’inférence et l’économie d’approvisionnement.
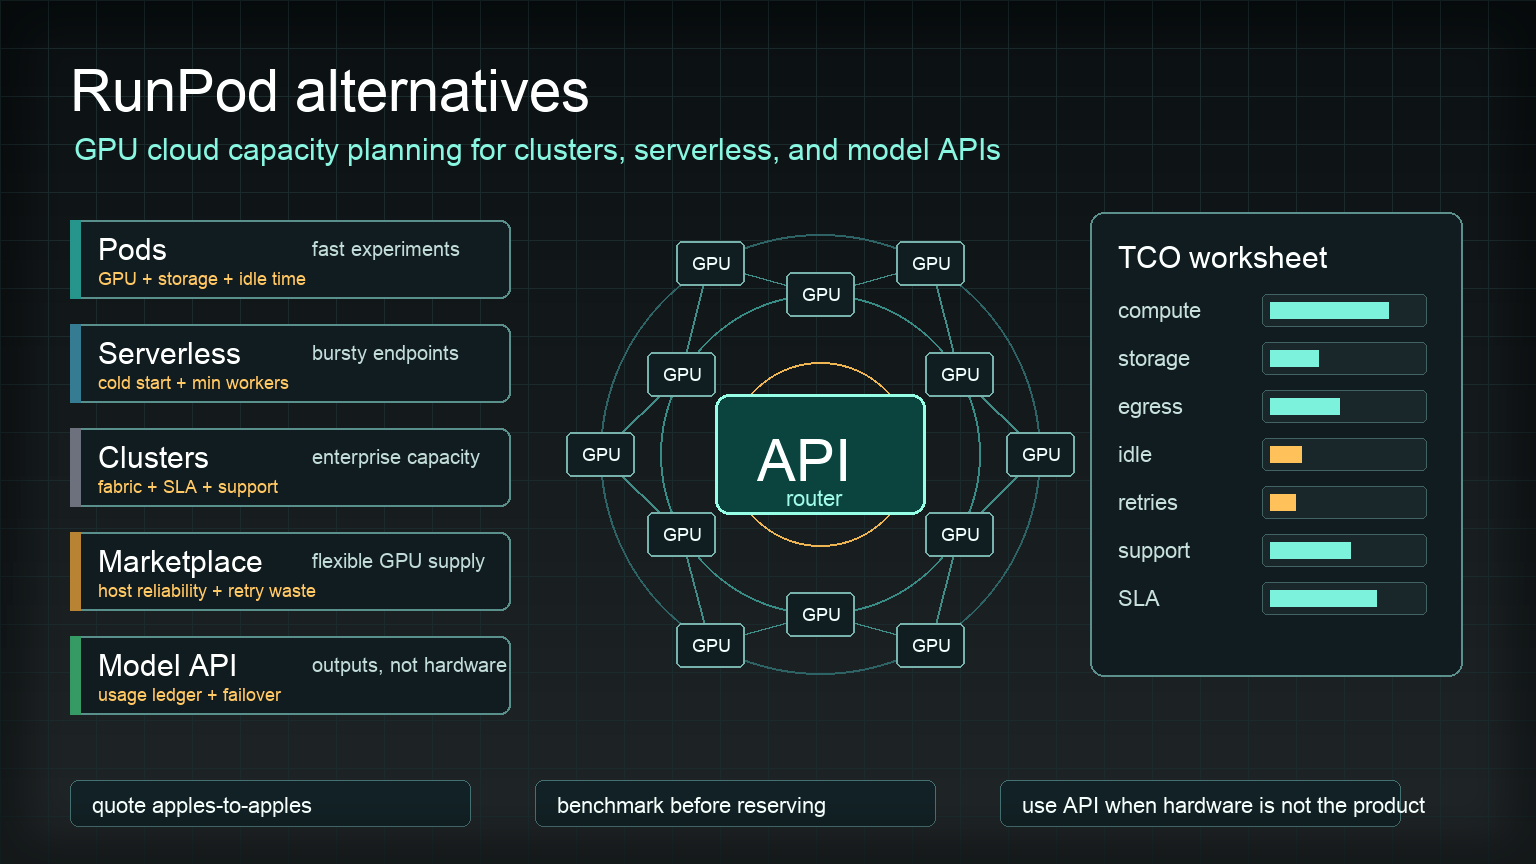
Les 10 meilleures alternatives à RunPod en 2026 : prix, avantages et conseils pour choisir
Comparez 10 alternatives à RunPod avec les prix GPU d’octobre 2026 : places de marché les moins chères, clouds GPU stables, plateformes serverless et API de modèles, avec un comparatif Vast.ai et RunPod, un point sur la fiabilité et une liste de vérification pour migrer.
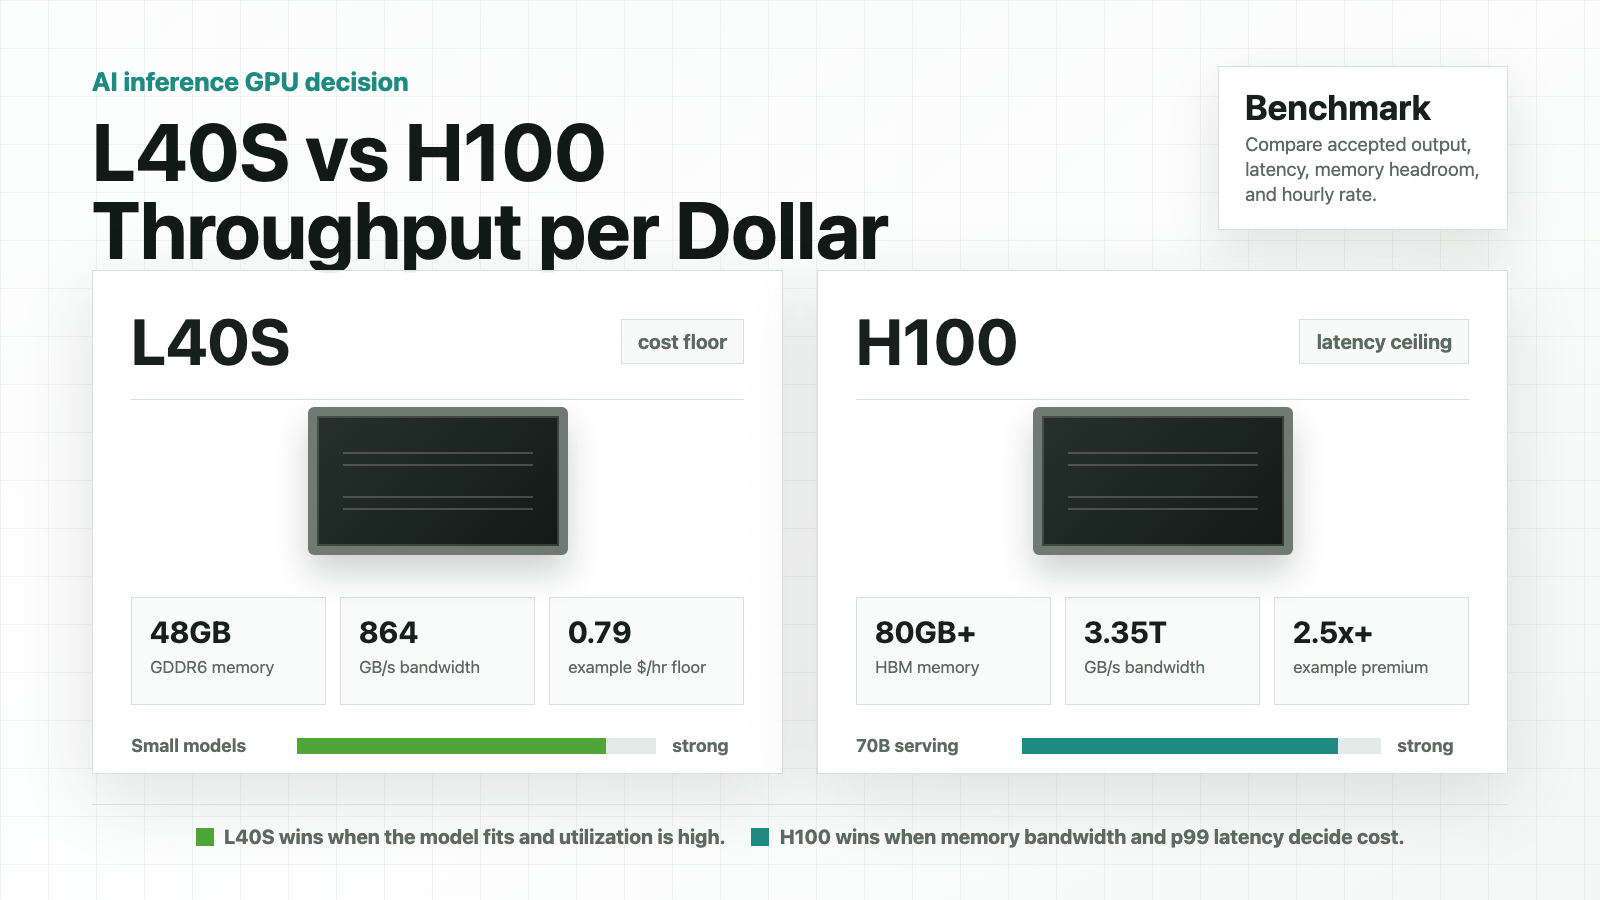
NVIDIA L40S vs H100 pour l’inférence IA : débit par dollar
Une तुलना pratique entre L40S et H100 pour les équipes IA qui évaluent le débit d’inférence, la latence, l’adéquation mémoire et le coût cloud du GPU par sortie acceptée.
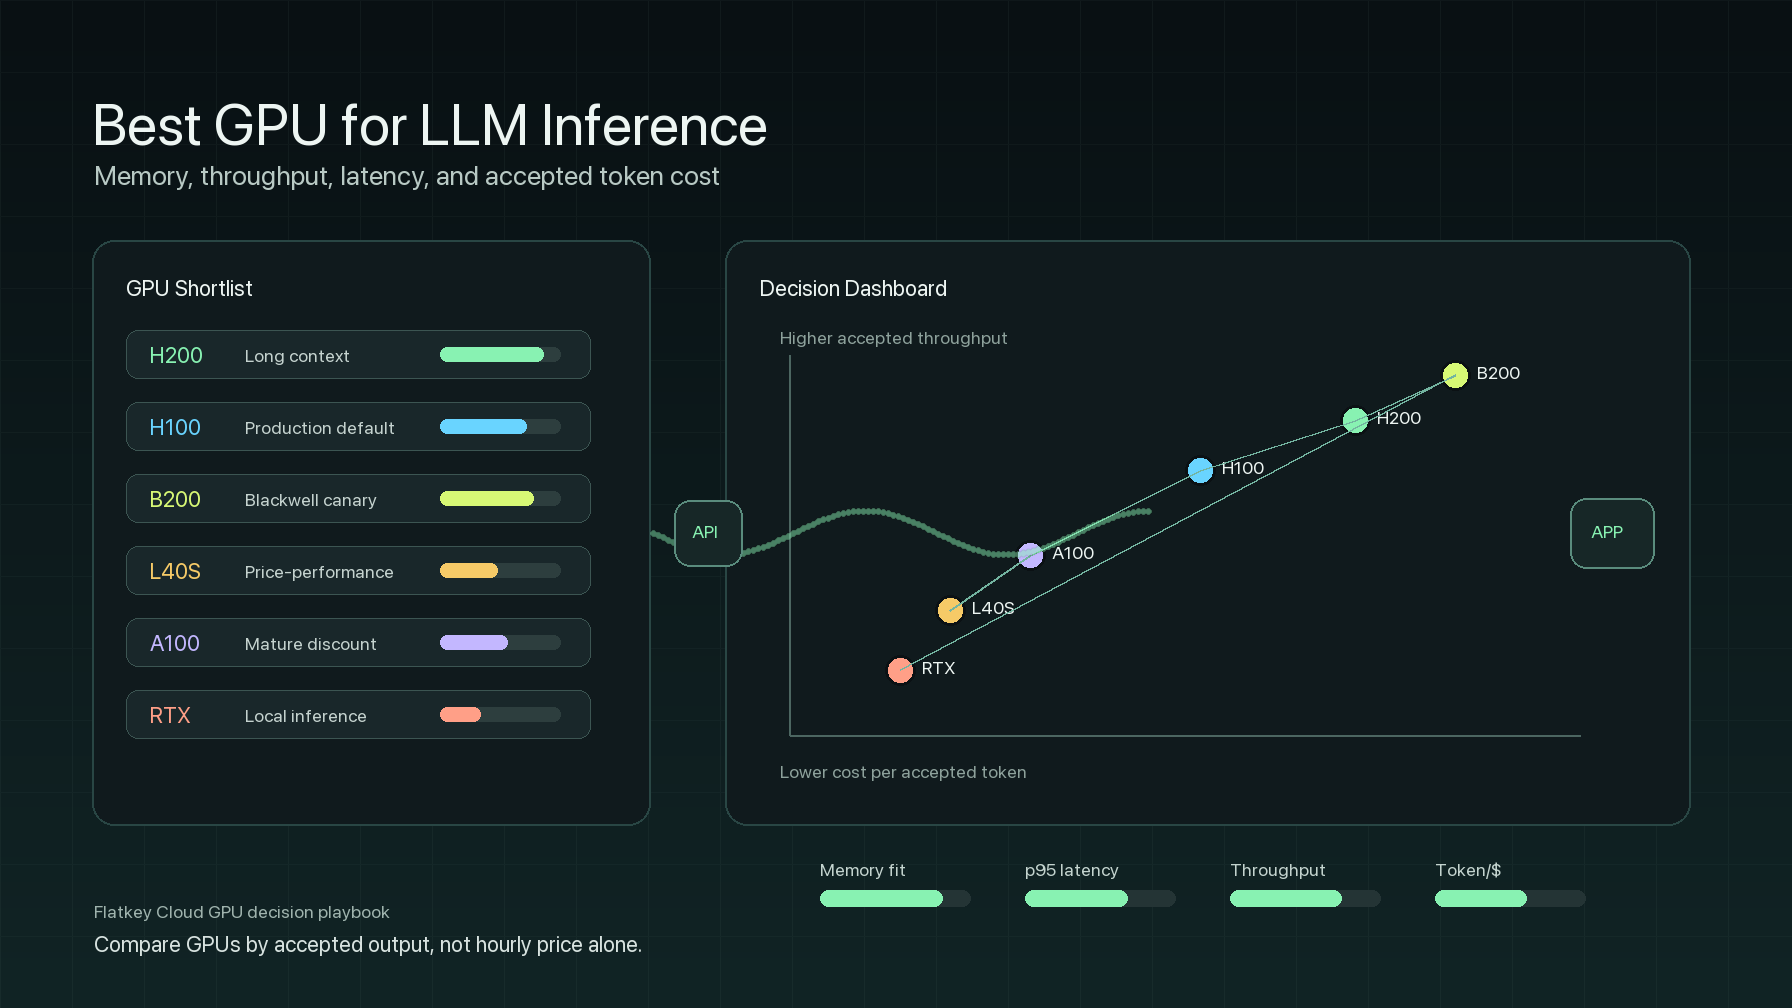
Meilleur GPU pour l’inférence de LLM : mémoire, débit, latence et coût
Un guide pratique de sélection de GPU pour les équipes d’entreprise chargées de l’inférence de LLM, comparant H100, H200, B200, A100, L40S, les GPU locaux de classe RTX, les tokens par dollar, la latence p95, l’adéquation mémoire et le coût par token accepté.
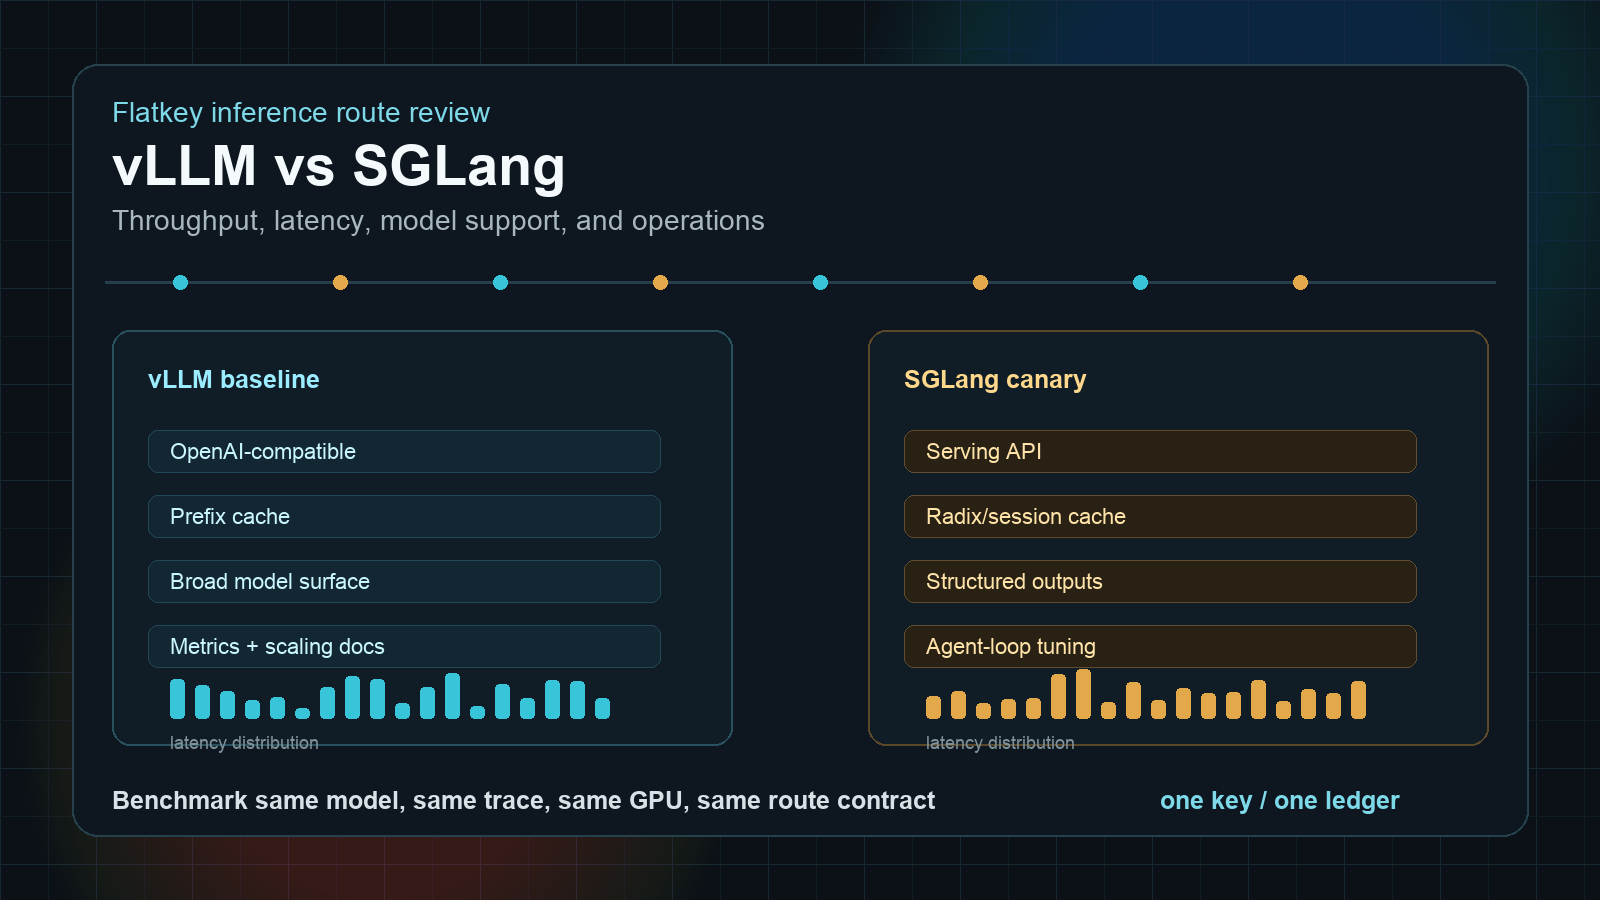
vLLM vs SGLang : débit, latence, prise en charge des modèles et opérations
Comparez SGLang et vLLM pour l’inférence sur GPU cloud : débit, latence, prise en charge des modèles, opérations, benchmarks, et quand Ollama convient pour les tests locaux.
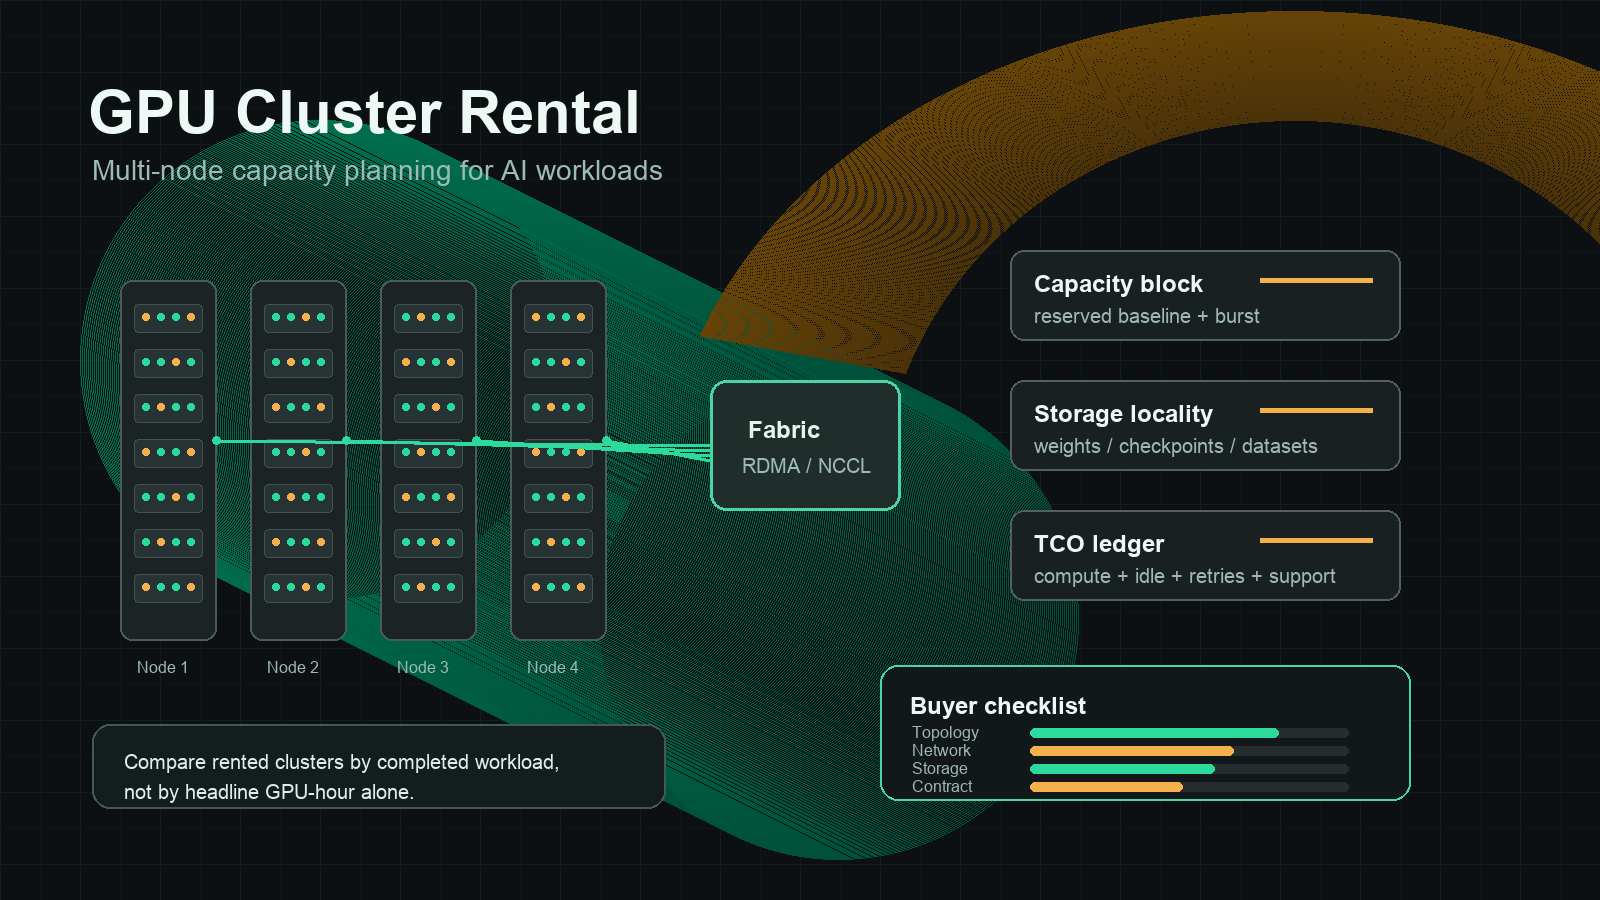
Location de cluster GPU : guide d’achat pour la capacité IA multi-nœuds
Guide d’achat destiné aux équipes IA d’entreprise qui évaluent la location de clusters GPU multi-nœuds, les fournisseurs cloud, la capacité réservée, le réseau, le stockage et le TCO.

H200 vs H100 (2026) : caractéristiques, performances réelles, prix à l’heure et choix en location
NVIDIA H200 vs H100 en 2026 : caractéristiques officielles, intérêt des 141GB pour l’inférence de modèles 70B, tarifs horaires réels de Flatkey Compute, RunPod et Lambda, alternatives Blackwell et choix selon la charge de travail.
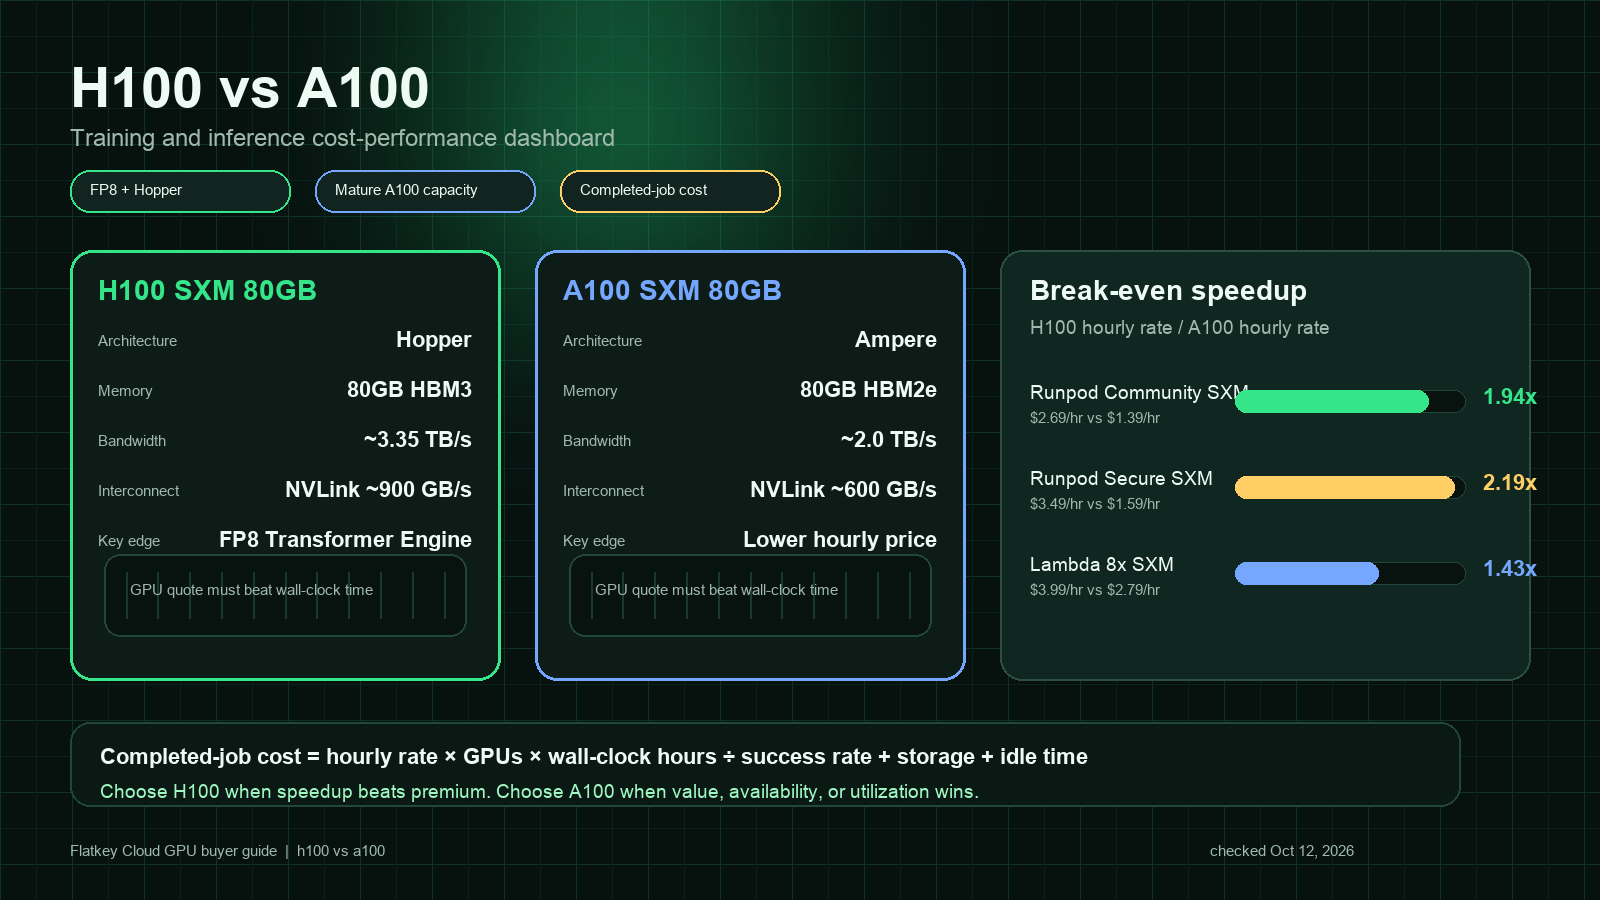
NVIDIA H100 vs A100 : rapport coût-performance pour l’entraînement et l’inférence
Une comparaison pratique entre H100 et A100 pour aider les équipes IA à choisir entre les performances Hopper et la valeur d’Ampere pour l’entraînement, l’inférence et la location de GPU cloud.
Explication des prix de location de GPU : à la demande, spot, réservé et coûts cachés
Un guide pratique pour comparer les prix de location de GPU selon le coût du travail terminé, et non seulement les tarifs horaires, avec des vérifications de sources pour les modèles à la demande, spot, réservés, sur marketplace et à coûts cachés.
API LLM gratuite (2026) : 10 options comparées selon les vraies limites, les modèles et les pièges
Dix API LLM gratuites vérifiées dans la documentation officielle en octobre 2026 : ce qui est gratuit, les limites exactes, les pièges cachés et du code pour basculer de l'une à l'autre.

Comparaison des prix des modèles d’IA : coûts des tokens, des images et des vidéos dans un seul tableau de bord
Comparez les tarifs des modèles d’IA sur les parcours texte, image, vidéo et API multi-fournisseurs avec un tableau de bord pour le coût par résultat accepté.
Comparaison des tarifs des API IA : coûts des modèles, du cache, des lots et de la passerelle
Un cadre pratique de comparaison des tarifs des API IA pour les développeurs, les équipes produit et les équipes achats, en comparant les coûts des modèles, du cache, des lots, de la passerelle, des retries et des résultats acceptés.
Quel modèle Claude choisir pour coder ? Opus 5.5 vs Sonnet 5.5 vs Haiku 5.5 vs Fable 5.1 (2026)
Quel modèle Claude utiliser pour coder en 2026 ? Un guide par type de tâche pour choisir entre Opus 5.5, Sonnet 5.5, Haiku 5.5 et Fable 5.1, avec les tarifs officiels, le calcul du coût des sessions, les alias de Claude Code et des exemples d’API exécutables.
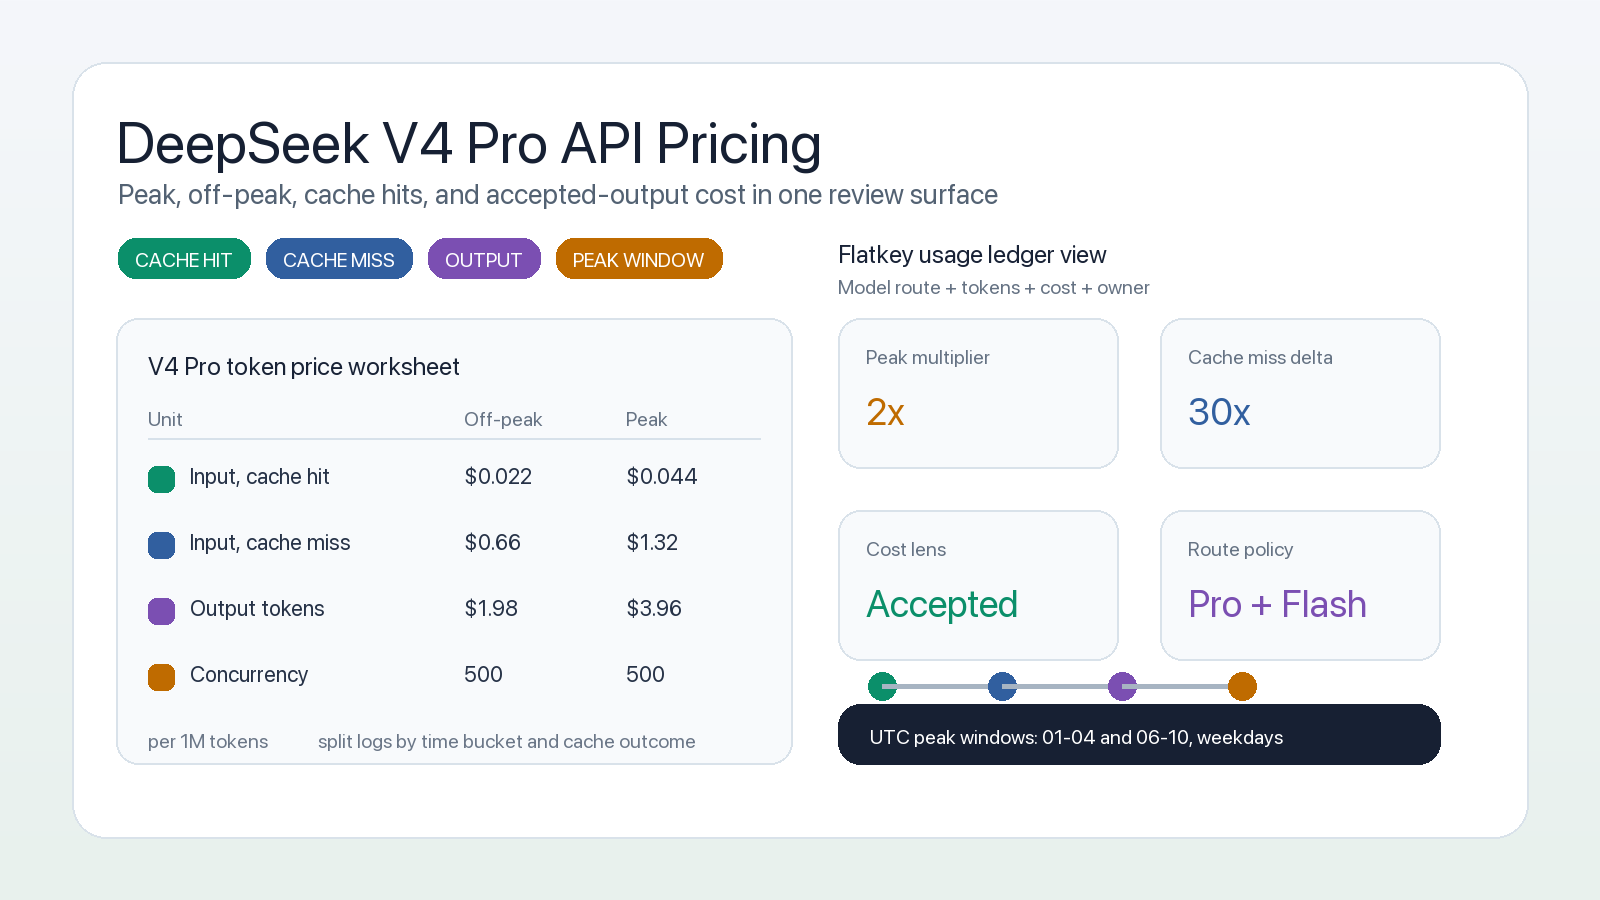
Tarification de l’API DeepSeek V4 Pro : heures de pointe, hors pointe et coûts du cache
Tarification actuelle de l’API DeepSeek V4 Pro avec les tarifs en heures de pointe et hors pointe, le calcul du taux de cache hit, et une feuille de calcul pour maîtriser les coûts destinée aux développeurs et aux équipes achats.
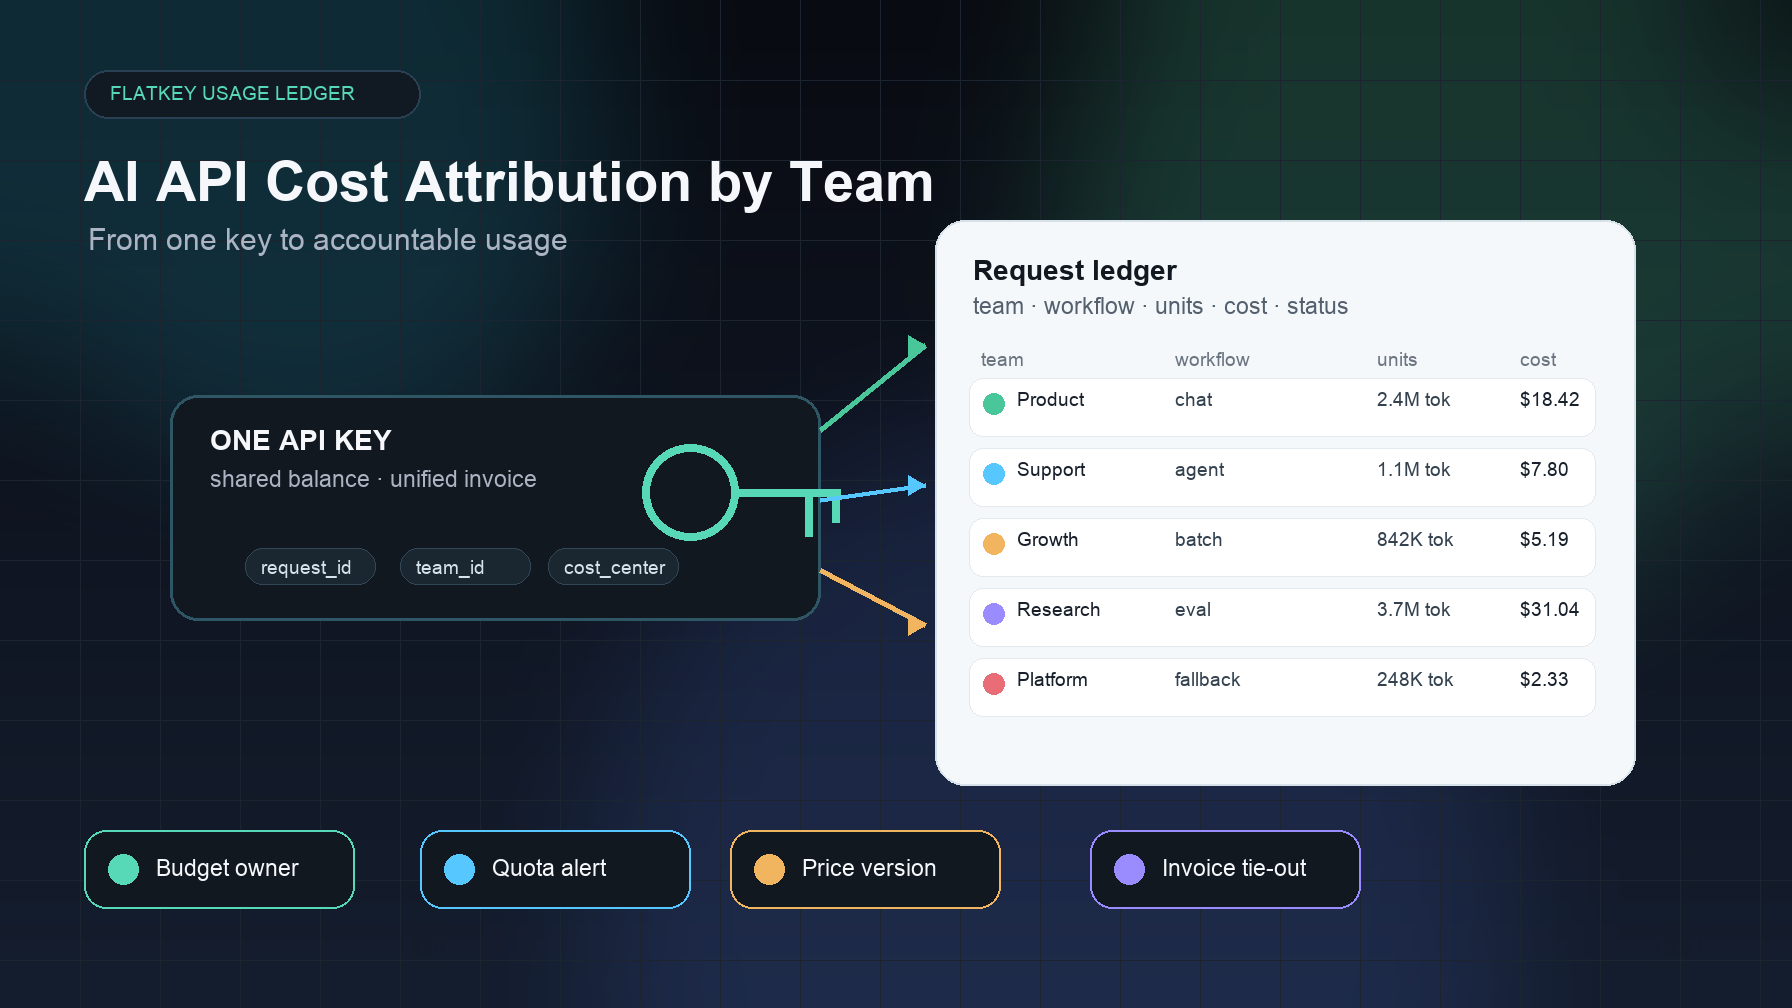
Attribution des coûts des API IA par équipe : d’une seule clé à une utilisation responsable
Mettez en place l’attribution des coûts des API IA par équipe avec des balises de requête, des limites par sous-clé, des journaux d’utilisation, des quotas et une revue financière mensuelle.
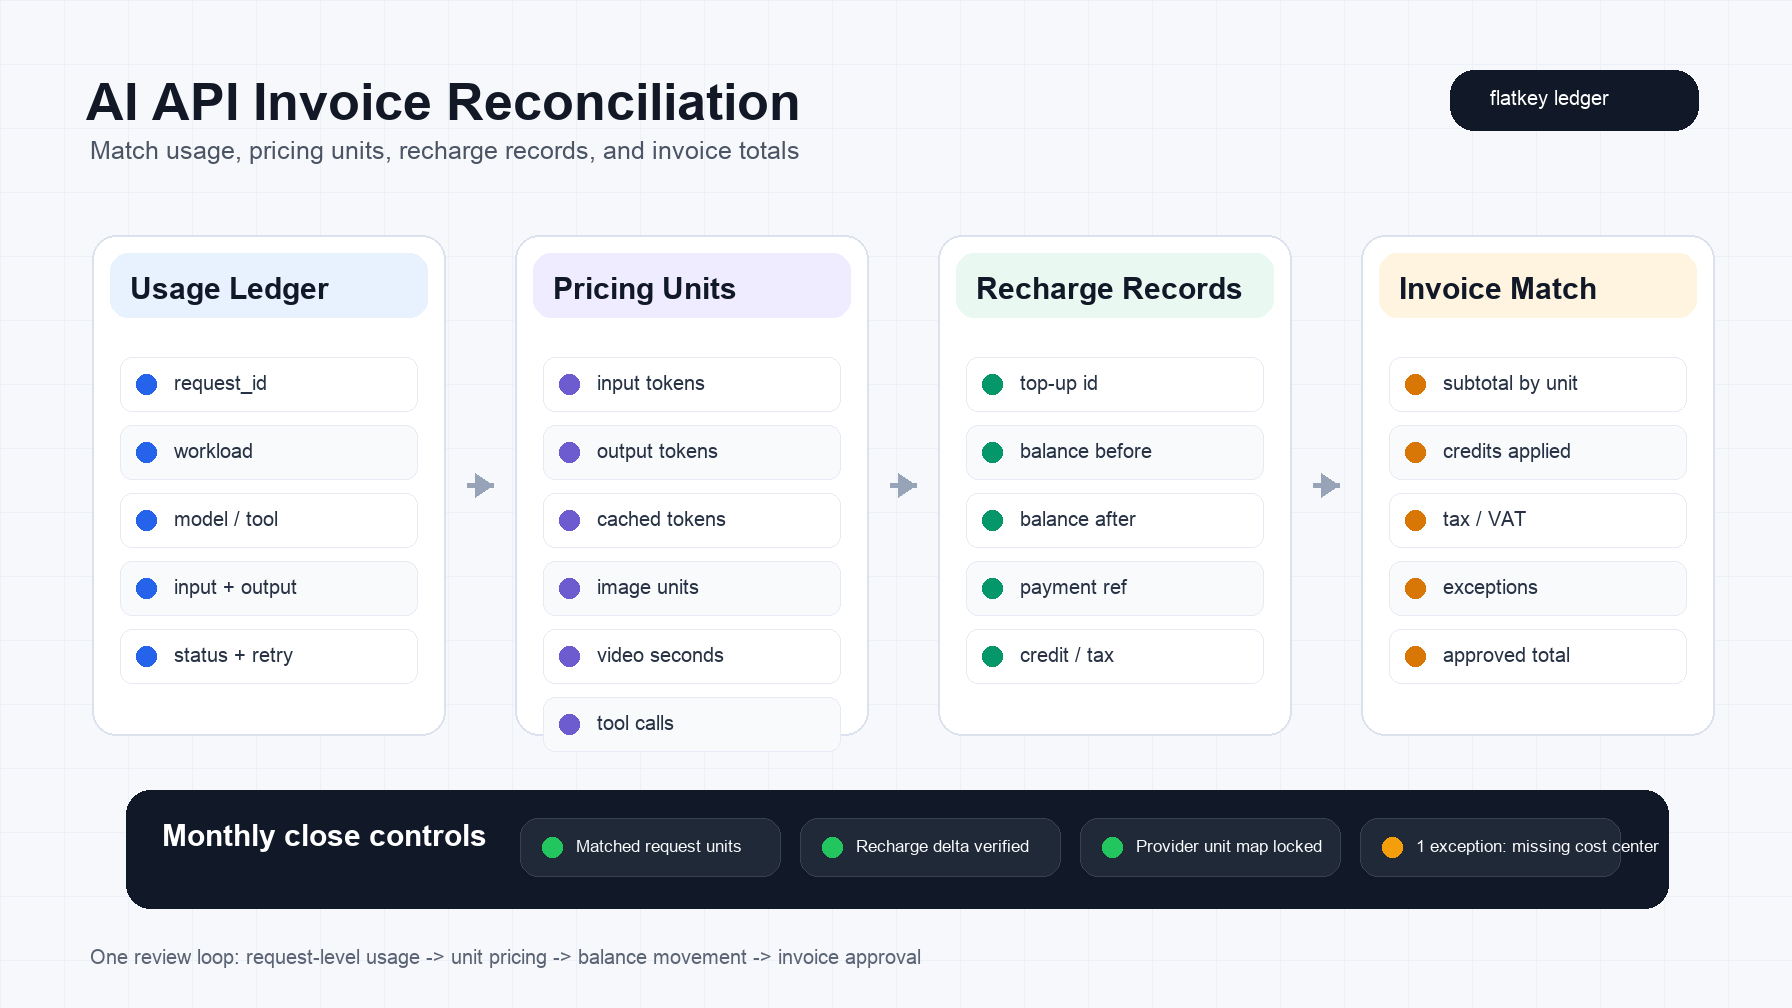
Rapprochement des factures d’API IA : faire correspondre l’utilisation, les unités tarifaires et les recharges
Rapprochez les factures d’API IA en faisant correspondre les journaux d’utilisation, les unités tarifaires, les recharges, les mouvements de solde, les crédits, les taxes et les totaux de facture.

Tarifs de l’API Anthropic (octobre 2026) : chaque modèle Claude, cache, Batch et calcul des coûts
Tous les tarifs de l’API Anthropic en octobre 2026, de Haiku 5.5 à 0,10 $/0,50 $ à Fable 5.1 à 10 $/50 $, avec cache, Batch API, résidence des données, mode rapide, plafonds et budgets mensuels.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer