LLMゲートウェイとは?仕組み・主要機能・7製品比較(2026年)
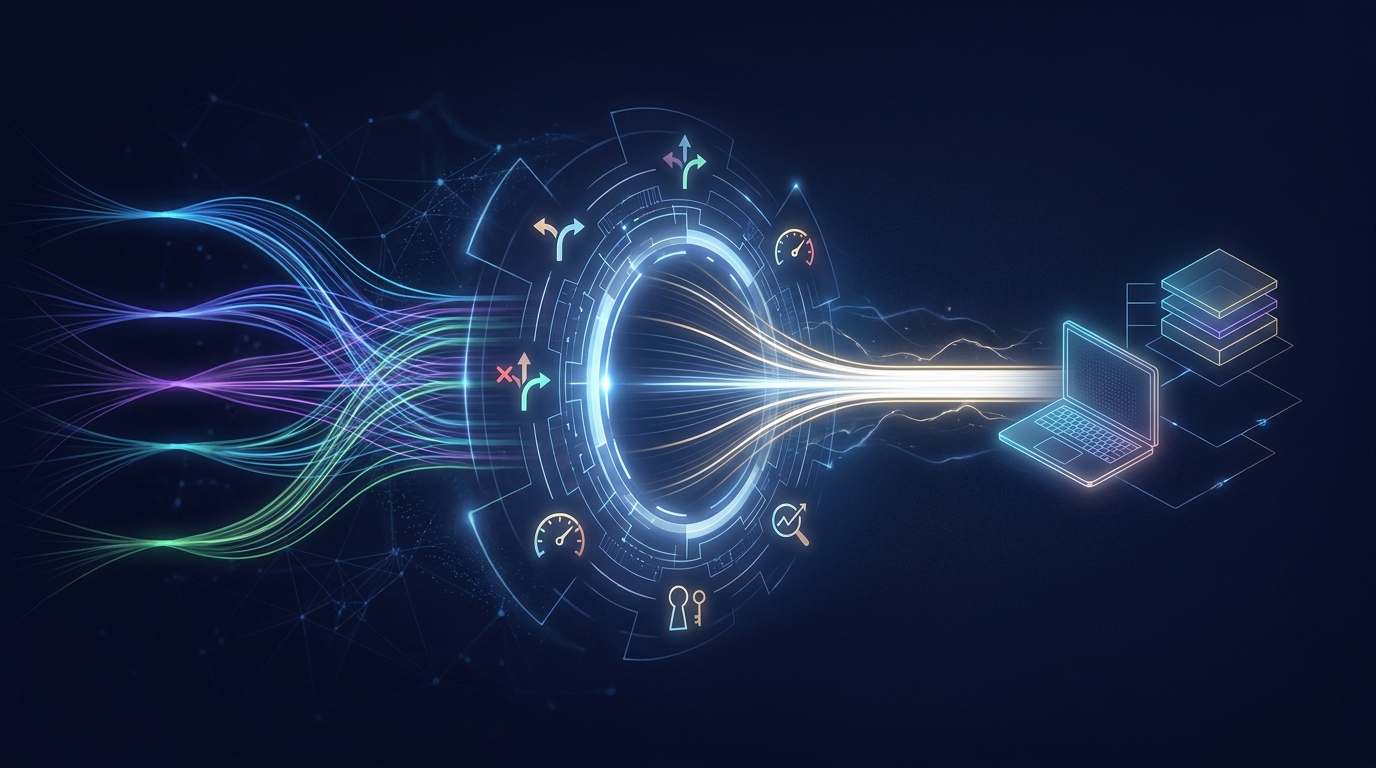
LLMゲートウェイとは、アプリケーションと1つ以上のモデルプロバイダーの間に置く統一APIレイヤーです。認証、ルーティング、フォールバック、レート制限、コスト追跡、ログ記録を担うため、コードはプロバイダーごとに個別連携する代わりに1つのエンドポイントを呼ぶだけで済みます。 多くのゲートウェイはOpenAI互換APIを提供しています。そのため、GPTからClaude、Gemini、Qwenへの切り替えは、新しいSDK連携をリリースするのではなく、model の文字列を1つ変えるだけになります。
このガイドでは、LLMゲートウェイの仕組みをステップごとに説明し、重要な9つの機能、APIゲートウェイ・モデルルーター・MCPゲートウェイとの違い、必要な場合と不要な場合、人気の7製品の比較を紹介します。製品情報は 2026年10月20日 に各ベンダーの公式ドキュメントで確認しました。
LLMゲートウェイの定義
LLMゲートウェイ(AIゲートウェイ、LLM APIゲートウェイとも呼ばれます)は、アプリケーションからのモデルリクエストを受け取り、共通の制御を適用したうえで、各リクエストを適切なモデルエンドポイントに転送し、一貫した形式でレスポンスを返します。
Your apps ──► LLM gateway ──┬──► OpenAI
                            ├──► Anthropic
  one key                   ├──► Google
  one API shape             ├──► Alibaba (Qwen)
  one usage ledger          └──► fallback provider
ゲートウェイ自体がモデルをホストするわけではありません。モデルへのアクセスを制御する役割です。
チームがLLMゲートウェイを導入する理由
ゲートウェイがないと、サービスごとにプロバイダーのキーを保管し、リトライを個別に実装し、利用状況を独自の形式で記録することになります。プロバイダーが増えるほど問題も増えます。
| ゲートウェイなし | ゲートウェイあり |
|---|---|
| サービス×プロバイダーごとにキーが1つ | サービスごとにゲートウェイキー1つ、ローテーションは一元管理(キーローテーションガイド) |
| SDKもエラー形式もバラバラ | API形式は1つ、通常はOpenAI互換 |
| 障害が起きるとコード変更が必要 | フォールバックは設定で対応 |
| 支出が複数の請求書に分散 | チーム・キー・モデル別に1つの利用台帳 |
| 共有のレート制限がない | キー単位でクォータと予算を設定 |
プロバイダー間の価格差も大きく、ルーティングの価値は十分にあります。2026年10月20日時点で、Flatkeyのモデルページに掲載された出力の定価は、100万トークンあたり0.47ドル(qwen3.8-flash)から10.00ドル(gpt-6-sol、claude-sonnet-5-5)、さらに15.00ドル(kimi-k3)まで幅があります。ゲートウェイを使えば、コードを書き換えずにこの価格差を活用できます。
LLMゲートウェイの仕組み(ステップごと)
- アプリがリクエストを送信:ゲートウェイキーを付けて、ゲートウェイのBase URLに送ります。
- 認証:ゲートウェイがキーを検証し、そのポリシー(許可モデル、予算、レート制限)を読み込みます。
- リクエスト前のポリシー:クォータを確認し、必要に応じてコンテンツをマスク・ブロックし、チーム・環境・機能などのメタデータを付与します。
- ルーティング:要求されたモデルのプロバイダーエンドポイント、またはフォールバックチェーン内の次の正常なルートを選びます。
- プロバイダー呼び出し:必要ならリクエストをプロバイダーの形式に変換し、レスポンスをストリーミングで返します。
- 記録:モデル、レイテンシ、トークン数、コスト、ステータス、リクエストIDを、可観測性と課金のために記録します。
LLMゲートウェイで重要な9つの機能
| 機能 | 確認ポイント |
|---|---|
| 統一API | OpenAI互換の /v1/chat/completions。ResponsesやMessagesを使うならその対応も |
| モデルカタログ | どのモデルが利用可能か、新モデルがどれだけ早く追加されるか |
| フォールバックとフェイルオーバー | 順序付きチェーンと発動条件(429、5xx、タイムアウト) |
| 負荷分散 | キー間、リージョン間、プロバイダー間 |
| レート制限と予算 | キー・チーム・モデル単位で、ハードキャップ付き |
| 可観測性 | リクエストログ、トークン使用量、レイテンシ、エラー。OpenTelemetry GenAIセマンティック規約でエクスポートできると理想的 |
| コスト追跡 | キー・チーム・環境単位(コスト配分ガイド) |
| キャッシュ | 完全一致またはセマンティックなレスポンスキャッシュ、プロバイダーのプロンプトキャッシュのパススルー |
| セキュリティとポリシー | キーのスコープ、個人情報のマスキング、データ保持条件、SOC 2やDPAの証跡 |
LLMゲートウェイ・APIゲートウェイ・モデルルーター・MCPゲートウェイの違い
| レイヤー | 制御対象 | トークンやモデルを理解するか | 例 |
|---|---|---|---|
| APIゲートウェイ | 一般的なHTTP API | いいえ | Kong、AWS API Gateway |
| LLMゲートウェイ | 複数プロバイダーへのモデルトラフィック | はい | LiteLLM、Portkey、Flatkey |
| モデルルーター | どのモデルが各プロンプトに答えるか | はい | RouteLLM、ルールエンジン |
| MCPゲートウェイ | Model Context Protocol経由のエージェントのツール呼び出し | ツール単位 | MCPプロキシ、レジストリ |
MCPゲートウェイとLLMゲートウェイの違いは? LLMゲートウェイはモデルへの呼び出しを管理します。MCPゲートウェイは、Model Context Protocolを通じたエージェントからツールやデータソースへの呼び出しを管理します。エージェント基盤では両方が必要になることが多く、モデルの支出はLLMゲートウェイで、ツールの権限はMCPゲートウェイで管理します。AIエージェントのゲートウェイ制御とAI APIゲートウェイとAPI管理の違いも参照してください。
LLMゲートウェイ7製品の比較(2026年)
| ゲートウェイ | デプロイ形態 | オープンソース | 強み | 注意点 |
|---|---|---|---|---|
| LiteLLM | セルフホストのプロキシまたはSDK | はい | 100以上のプロバイダー、ルーティング、予算管理 | 運用・スケーリング・パッチ適用は自分で |
| Portkey | ホスト型またはセルフホスト | ゲートウェイのコアはオープンソース | ガードレール、可観測性 | 高度な機能は有料プラン |
| Cloudflare AI Gateway | エッジでのホスト型 | いいえ | キャッシュ、分析、レート制限 | プロバイダーのキー管理は引き続き必要 |
| Kong AI Gateway | セルフホストまたはKonnect | コアはオープンソース | 既存のKong API管理に組み込める | プラグイン設定の手間 |
| Vercel AI Gateway | ホスト型 | いいえ | VercelやAI SDKとの緊密な統合 | Vercelのエコシステム内で使うのが最適 |
| OpenRouter | ホスト型 | いいえ | 非常に幅広いモデルカタログ、クレジット制 | マーケットプレイス型の共有ルーティング |
| Flatkey | ホスト型 | いいえ | 1つのキーと残高でGPT、Claude、Gemini、Qwen、DeepSeek、Kimi、GLM、さらに画像・動画モデルも利用可能 | ニッチなモデルはカタログを確認 |
詳しい比較:LLMゲートウェイの選び方ガイド、OpenRouterの代替サービス、Portkeyの代替サービス、Vercel AI Gatewayの代替サービス、マネージドゲートウェイとセルフホストプロキシの比較。
コードで見るLLMゲートウェイ
OpenAI互換のゲートウェイなら、アプリはOpenAI SDKをそのまま使い、Base URLとキーの2つの値を変えるだけです。以降、プロバイダーの切り替えは文字列の変更で済みます。
curl
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "claude-sonnet-5-5", "messages": [{"role": "user", "content": "What is an LLM gateway?"}]}'
Python:1つのクライアントで複数プロバイダー、自動フォールバック
import os
from openai import OpenAI, APIError

gw = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

def complete(prompt, chain=("gpt-6-sol", "claude-sonnet-5-5", "gemini-3.5-flash")):
    for model in chain:
        try:
            r = gw.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
            return model, r.choices[0].message.content, r.usage.total_tokens
        except APIError as err:
            print(f"{model} -> {err.__class__.__name__}, trying next")
    raise RuntimeError("no route available")

print(complete("Give me one sentence on why gateways log token usage."))
Node.js
import OpenAI from "openai";
const gw = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

const models = ["qwen3.8-max", "gpt-6-luna"];
const results = await Promise.all(models.map((model) =>
  gw.chat.completions.create({ model, messages: [{ role: "user", content: "Define 'fallback' in 8 words." }] })
));
results.forEach((r, i) => console.log(models[i], r.usage.total_tokens, r.choices[0].message.content));
ゲートウェイがなければ、3つのSDK、3つのキー、3種類のエラー形式が必要になります。最初の呼び出しはFlatkeyクイックスタートを参考にしてください。
OpenAI互換で保証されること・されないこと
「OpenAI互換」とは、リクエストとレスポンスの形式がOpenAIのChat Completions APIと一致するという意味です。すべてのモデルがすべての機能に対応しているという保証ではありません。移行前に、モデルごとに次の点をテストしてください。
- ストリーミングのチャンクと
finish_reasonの値 - ツール/関数呼び出しと並列ツール呼び出し
- 構造化出力またはJSONモード
- 画像やファイルの入力
- キャッシュトークンを含む
usageフィールド - レート制限やコンテキスト超過時のエラーコード(エラー分類)
LLMゲートウェイが必要なとき(不要なとき)
導入したほうがよいケース: - 2社以上のモデルプロバイダーを使っている、または使う予定がある。 - 複数のチームやサービスがAIの費用を共有し、チームごとの予算が必要。 - プロバイダー障害時のフェイルオーバーが必要。 - 経理が5枚の請求書ではなく1つの台帳を求めている。
まだ不要かもしれないケース: - 1つのモデルを使うプロトタイプが1つだけで、トラフィックも少ない。 - プロバイダーとの契約で、仲介なしの直接アクセスが求められている。
半日でLLMゲートウェイを評価する方法
- 契約テスト:よく使う20種類のリクエスト(ストリーミング、ツール、JSON)をゲートウェイ経由で実行する。
- 障害テスト:存在しないモデルIDとタイムアウトを意図的に発生させ、フォールバックが動くか、エラーが分かりやすいかを確認する。
- オーバーヘッドテスト:プロバイダーへの直接呼び出しとP50・P95レイテンシを比較する。
- 台帳テスト:記録されたトークン数がプロバイダーの
usageと一致するか、キー単位でコストが見えるかを確認する。 - セキュリティレビュー:キーのスコープ、ログの保持期間、データ処理条件を確認する(DPAチェックリスト)。
- 離脱テスト:Base URLを元に戻すだけで移行できるかを確認する。
よくある質問
LLMゲートウェイとは何ですか?
LLMゲートウェイは、アプリケーションとモデルプロバイダーの間に置く中間APIです。認証、ルーティング、フォールバック、レート制限、ログ記録、コスト追跡を、通常はOpenAI互換の1つのエンドポイントの背後に集約します。
人気のLLMゲートウェイは?
2026年によく使われているのは、LiteLLM(オープンソース、セルフホスト)、Portkey、Cloudflare AI Gateway、Kong AI Gateway、Vercel AI Gateway、OpenRouter、そしてFlatkeyのようなホスト型ルーターです。
LLMゲートウェイは無料ですか?
LiteLLMのようなオープンソースのゲートウェイは無料で動かせますが、ホスティングと運用の費用がかかります。ホスト型ゲートウェイはプラットフォーム料金を取るか、独自の価格でモデル利用料を請求します。いずれにせよ、モデルのトークン自体には費用がかかります。
MCPゲートウェイとLLMゲートウェイの違いは?
LLMゲートウェイは言語モデルへのリクエストを管理します。MCPゲートウェイは、Model Context Protocolを通じたエージェントからツールやデータソースへのリクエストを管理します。解決する課題が異なり、併用されることもよくあります。
LLMゲートウェイとAIゲートウェイは同じものですか?
たいていは同じです。「AIゲートウェイ」はより広いマーケティング用語で、画像・動画・音声モデルも含むことが多く、「LLMゲートウェイ」はテキストモデルに重点を置いた呼び方です。
LLMゲートウェイでレイテンシは増えますか?
わずかに増えます。ネットワークのホップが1つ増え、ポリシーチェックも加わるためです。自分のリージョンでP95のオーバーヘッドを測定してください。障害時には、フェイルオーバーによって節約できる時間のほうがはるかに大きいのが普通です。
LLMゲートウェイでコストを削減できますか?
間接的にはできます。安価なモデルへのルーティング、キャッシュ、予算上限を一貫して適用しやすくなるからです。ただし、ゲートウェイ自体が割引料金を提供していない限り、特定モデルのトークン単価が下がるわけではありません。
まとめ
LLMゲートウェイは、多数のプロバイダー連携を1つの管理されたエンドポイントにまとめます。キーは1つ、API形式も1つ、台帳も1つで、フォールバックは設定で済みます。完全なコントロールを望み、運用もできるならセルフホスト(LiteLLM、Kong)を、インフラを運用したくないならホスト型(Portkey、Cloudflare、Vercel、OpenRouter、Flatkey)を選びましょう。ホスト型を試すなら、Flatkeyのモデル一覧と料金ページをご覧ください。
最終更新:2026年10月20日・Flatkey Team。製品情報は本文中にリンクした公式ドキュメントをもとにまとめています。