什么是 LLM 网关?工作原理、核心功能与 7 款产品对比(2026)
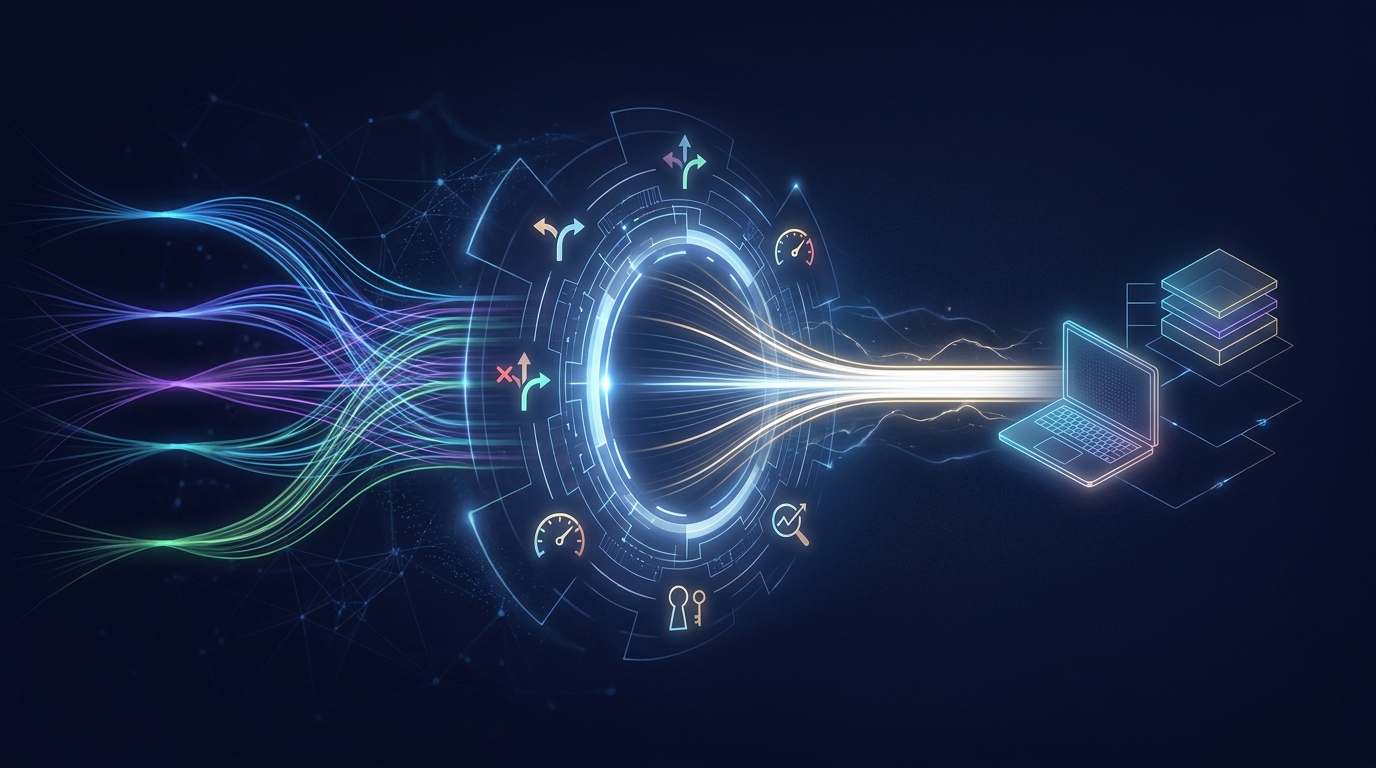
LLM 网关是位于应用和一个或多个模型厂商之间的统一 API 层。它负责鉴权、路由、故障切换、限流、成本追踪和日志记录,你的代码只需调用一个端点,而不用逐个对接每家厂商。 大多数网关提供兼容 OpenAI 的 API。从 GPT 切换到 Claude、Gemini 或 Qwen,只需改一个 model 字符串,而不用上线一套新的 SDK 集成。
本文会逐步讲解 LLM 网关的工作原理、最重要的九项功能、它与 API 网关、模型路由和 MCP 网关的区别、什么时候需要(以及不需要)网关,并对比七款主流网关。产品信息已于 2026 年 10 月 20 日 对照各厂商官方文档核实。
LLM 网关的定义
LLM 网关(也叫 AI 网关或 LLM API 网关)接收来自应用的模型请求,执行统一的管控策略,把每个请求转发到合适的模型端点,再以一致的格式返回响应。
Your apps ──► LLM gateway ──┬──► OpenAI
                            ├──► Anthropic
  one key                   ├──► Google
  one API shape             ├──► Alibaba (Qwen)
  one usage ledger          └──► fallback provider
网关本身不托管模型,它管的是对模型的访问。
团队为什么要用 LLM 网关
没有网关时,每个服务都要保存自己的厂商 key、自己实现重试、用自己的格式记录用量。每多接一家厂商,问题就更多一些:
| 没有网关 | 有网关 |
|---|---|
| 每个服务、每家厂商各一把 key | 每个服务一把网关 key,集中轮换(key 轮换指南) |
| SDK 和错误格式各不相同 | 统一的 API 格式,通常兼容 OpenAI |
| 厂商宕机就得改代码 | 故障切换只是配置 |
| 开销分散在多张账单里 | 按团队、key 和模型统一记账 |
| 没有共享的限流 | 按 key 设置配额和预算 |
各厂商的价格差距也足够大,路由的价值很明显。2026 年 10 月 20 日,Flatkey 模型页 上的输出标价从每百万 token 0.47 美元(qwen3.8-flash)到 10.00 美元(gpt-6-sol、claude-sonnet-5-5),再到 15.00 美元(kimi-k3)。有了网关,不用重写代码就能利用这种价差。
LLM 网关如何工作:分步说明
- 应用发送请求:携带网关 key 发往网关的 Base URL。
- 鉴权:网关校验 key,并加载对应策略(允许的模型、预算、限流)。
- 请求前策略:检查配额,可能对内容做脱敏或拦截,并附加团队、环境、功能等元数据。
- 路由:为请求的模型选择厂商端点,或在故障切换链中选下一个健康的路由。
- 调用厂商:必要时把请求转换成厂商格式,并把响应流式返回。
- 记录:记录模型、延迟、token、成本、状态和请求 ID,用于可观测性和计费。
LLM 网关最重要的 9 项功能
| 功能 | 需要检查什么 |
|---|---|
| 统一 API | 兼容 OpenAI 的 /v1/chat/completions,如果你在用 Responses 或 Messages,也要支持 |
| 模型目录 | 哪些模型可用,新模型上线有多快 |
| 故障切换 | 是否支持有序的切换链,以及触发条件(429、5xx、超时) |
| 负载均衡 | 跨 key、跨区域或跨厂商 |
| 限流与预算 | 按 key、团队和模型设置,并有硬上限 |
| 可观测性 | 请求日志、token 用量、延迟和错误,最好能按 OpenTelemetry GenAI 规范 导出 |
| 成本追踪 | 按 key、团队和环境统计(成本归因指南) |
| 缓存 | 精确或语义级响应缓存,以及对厂商提示词缓存的透传 |
| 安全与策略 | key 权限范围、PII 脱敏、数据留存条款、SOC 2 或 DPA 证明 |
LLM 网关、API 网关、模型路由与 MCP 网关的区别
| 层 | 管控对象 | 是否理解 token 和模型? | 例子 |
|---|---|---|---|
| API 网关 | 通用 HTTP API | 否 | Kong、AWS API Gateway |
| LLM 网关 | 跨厂商的模型流量 | 是 | LiteLLM、Portkey、Flatkey |
| 模型路由 | 每个提示由哪个模型回答 | 是 | RouteLLM、规则引擎 |
| MCP 网关 | 智能体通过 Model Context Protocol 发起的工具调用 | 工具层面 | MCP 代理与注册中心 |
MCP 网关和 LLM 网关有什么区别? LLM 网关管控的是对模型的调用;MCP 网关管控的是智能体对工具和数据源的调用,基于 Model Context Protocol。智能体平台通常两者都需要:用 LLM 网关管模型开销,用 MCP 网关管工具权限。参见 AI 智能体网关管控 和 AI API 网关与 API 管理的区别。
7 款 LLM 网关对比(2026)
| 网关 | 部署方式 | 是否开源 | 优势 | 需要注意 |
|---|---|---|---|---|
| LiteLLM | 自托管代理或 SDK | 是 | 100+ 厂商,路由、预算 | 需要自己运维、扩容和打补丁 |
| Portkey | 托管或自托管 | 网关核心开源 | 护栏、可观测性 | 高级功能需付费 |
| Cloudflare AI Gateway | 边缘托管 | 否 | 缓存、分析、限流 | 仍需自己管理厂商 key |
| Kong AI Gateway | 自托管或 Konnect | 核心开源 | 契合现有 Kong API 管理 | 插件配置成本较高 |
| Vercel AI Gateway | 托管 | 否 | 与 Vercel 和 AI SDK 深度集成 | 在 Vercel 生态内最好用 |
| OpenRouter | 托管 | 否 | 模型目录非常广,按额度计费 | 共享的市场化路由 |
| Flatkey | 托管 | 否 | 一把 key、一个余额调用 GPT、Claude、Gemini、Qwen、DeepSeek、Kimi、GLM,以及图像和视频模型 | 小众模型请先查目录 |
更深入的对比:LLM 网关选型指南、OpenRouter 替代方案、Portkey 替代方案、Vercel AI Gateway 替代方案,以及 托管网关与自托管代理对比。
LLM 网关在代码里是什么样子
使用兼容 OpenAI 的网关,应用继续用 OpenAI SDK,只改两个值:Base URL 和 key。之后切换厂商只是改一个字符串。
curl
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Authorization: Bearer $FLATKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "claude-sonnet-5-5", "messages": [{"role": "user", "content": "What is an LLM gateway?"}]}'
Python:一个客户端、多家厂商、自动故障切换
import os
from openai import OpenAI, APIError

gw = OpenAI(api_key=os.environ["FLATKEY_API_KEY"], base_url="https://router.flatkey.ai/v1")

def complete(prompt, chain=("gpt-6-sol", "claude-sonnet-5-5", "gemini-3.5-flash")):
    for model in chain:
        try:
            r = gw.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
            return model, r.choices[0].message.content, r.usage.total_tokens
        except APIError as err:
            print(f"{model} -> {err.__class__.__name__}, trying next")
    raise RuntimeError("no route available")

print(complete("Give me one sentence on why gateways log token usage."))
Node.js
import OpenAI from "openai";
const gw = new OpenAI({ apiKey: process.env.FLATKEY_API_KEY, baseURL: "https://router.flatkey.ai/v1" });

const models = ["qwen3.8-max", "gpt-6-luna"];
const results = await Promise.all(models.map((model) =>
  gw.chat.completions.create({ model, messages: [{ role: "user", content: "Define 'fallback' in 8 words." }] })
));
results.forEach((r, i) => console.log(models[i], r.usage.total_tokens, r.choices[0].message.content));
没有网关的话,这需要三套 SDK、三把 key 和三种错误格式。第一次调用可参考 Flatkey 快速入门。
兼容 OpenAI 能保证什么、不能保证什么
"兼容 OpenAI"指请求和响应的格式与 OpenAI 的 Chat Completions API 一致,并不保证每个模型都支持每项功能。迁移前,请逐个模型测试:
- 流式分块和
finish_reason取值 - 工具/函数调用与并行工具调用
- 结构化输出或 JSON 模式
- 图像和文件输入
usage字段,包括缓存 token- 限流和上下文超长的错误码(错误分类)
什么时候需要 LLM 网关(什么时候不需要)
你很可能需要,如果: - 你正在或计划调用两家及以上的模型厂商。 - 多个团队或服务共享 AI 开销,需要按团队设预算。 - 厂商宕机时需要故障切换。 - 财务需要一本账,而不是五张发票。
你可能暂时不需要,如果: - 你只有一个原型、只用一个模型,而且流量很小。 - 你和厂商的合同要求直接访问、不经中间层。
一个下午评估一款 LLM 网关
- 契约测试:把你最常用的 20 个请求(流式、工具、JSON)走一遍网关。
- 故障测试:故意用错误的模型 ID 并制造超时,看故障切换是否触发、错误信息是否清楚。
- 开销测试:对比经网关和直连厂商的 P50、P95 延迟。
- 账本测试:记录的 token 是否与厂商返回的
usage一致?能否按 key 查看成本? - 安全审查:检查 key 权限范围、日志留存和数据处理条款(DPA 检查清单)。
- 退出测试:把 Base URL 改回去,能否顺利迁出?
常见问题
什么是 LLM 网关?
LLM 网关是位于应用和模型厂商之间的中间层 API。它把鉴权、路由、故障切换、限流、日志和成本追踪集中到一个端点后面,这个端点通常兼容 OpenAI。
最流行的 LLM 网关有哪些?
2026 年常用的有 LiteLLM(开源、自托管)、Portkey、Cloudflare AI Gateway、Kong AI Gateway、Vercel AI Gateway、OpenRouter,以及 Flatkey 这类托管路由。
LLM 网关免费吗?
LiteLLM 这类开源网关可以免费运行,但你要承担托管和运维成本。托管网关要么收平台费,要么按自己的价格计费模型用量。无论哪种方式,模型 token 本身都要花钱。
MCP 网关和 LLM 网关有什么区别?
LLM 网关管理对语言模型的请求;MCP 网关管理智能体通过 Model Context Protocol 对工具和数据源的请求。两者解决不同的问题,常常一起部署。
LLM 网关和 AI 网关是一回事吗?
通常是。"AI 网关"是更宽泛的营销说法,往往还涵盖图像、视频和音频模型;"LLM 网关"更强调文本模型。
LLM 网关会增加延迟吗?
会增加一点:多一跳网络加上策略检查。请在你所在的区域实测 P95 开销。发生宕机时,故障切换节省的时间通常远超这一跳的成本。
LLM 网关能降低成本吗?
能,但是间接的。它让路由到更便宜的模型、缓存和预算上限更容易统一落地。除非网关本身提供折扣价,否则它不会让某个模型的 token 变便宜。
结论
LLM 网关把众多厂商集成变成一个受控端点:一把 key、一种 API 格式、一本账,故障切换只是配置。想要完全掌控、也有能力运维,就选自托管(LiteLLM、Kong);不想维护基础设施,就选托管(Portkey、Cloudflare、Vercel、OpenRouter、Flatkey)。想试试托管方案,可以看看 Flatkey 模型目录 和 价格页。
最后更新:2026 年 10 月 20 日 · Flatkey Team。产品信息整理自文中链接的官方文档。