
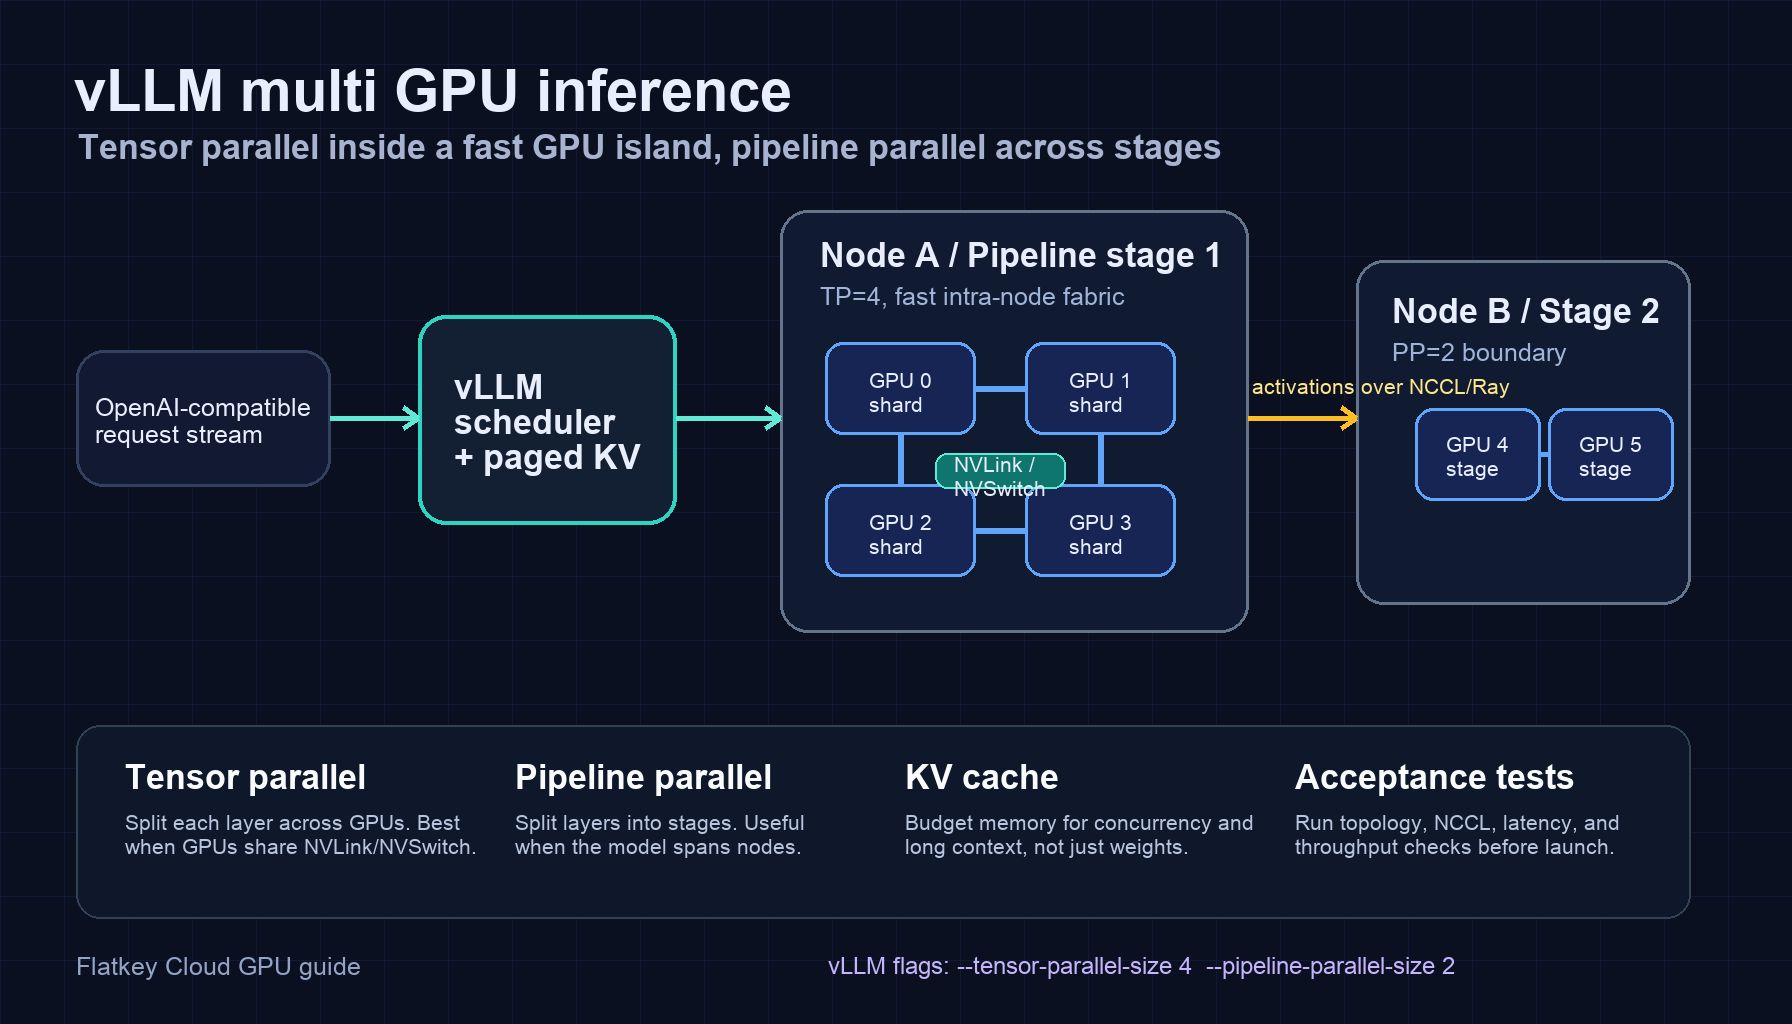
Inferensi multi GPU vLLM biasanya dimulai karena salah satu dari tiga alasan: bobot model tidak muat pada satu GPU, cache KV untuk konteks dan konkurensi yang dibutuhkan tidak muat pada satu GPU, atau satu GPU tidak dapat menghasilkan target token-per-detik dan time-to-first-token yang Anda perlukan. Penyiapannya bukan hanya keputusan --tensor-parallel-size. Anda juga perlu mencocokkan paralelisme tensor, paralelisme pipeline, backend executor, dan topologi GPU fisik.
Versi singkatnya:
- Gunakan paralelisme tensor terlebih dahulu ketika model muat di beberapa GPU dalam satu island GPU cepat yang sama, terutama node H100/H200/B200 8-GPU dengan NVLink atau NVSwitch.
- Tambahkan paralelisme pipeline ketika model harus menjangkau beberapa node atau ketika tensor parallel saja menimbulkan terlalu banyak komunikasi antar-node.
- Anggap
tp * ppsebagai jumlah worker GPU yang digunakan oleh satu replika vLLM. - Lakukan benchmark dengan panjang prompt, panjang output, bentuk batch, dan kuantisasi model yang nyata sebelum menyebut setup tersebut siap produksi.
- Jika tim Anda hanya membutuhkan endpoint yang kompatibel dengan OpenAI dan bukan kontrol hardware langsung, bandingkan jalur GPU dengan baseline model/API terkelola seperti Flatkey sebelum Anda menyewa dan mengoperasikan klaster.
Panduan ini memberikan contoh praktis inferensi multi GPU vLLM, diagram arsitektur, perintah peluncuran, dan pemeriksaan yang biasanya menangkap setup multi-GPU yang buruk sebelum pengguna melakukannya.
Arsitektur inferensi multi GPU vLLM
Di vLLM, paralelisme tensor membagi pekerjaan untuk setiap layer transformer di antara beberapa worker GPU. Paralelisme pipeline membagi layer model ke dalam tahap-tahap, sehingga grup GPU yang berbeda menjalankan bagian model yang berbeda. Untuk serving produksi, pilihan-pilihan tersebut memengaruhi lebih dari sekadar memori: mereka mengubah komunikasi kolektif, penjadwalan permintaan, radius dampak kegagalan, dan apakah networking scale-out menjadi bottleneck.
Arsitektur awal yang umum adalah:
| Layer | Pilihan praktis | Mengapa itu penting |
|---|---|---|
| Permukaan API | vllm serve dengan server yang kompatibel dengan OpenAI |
Memungkinkan tim aplikasi tetap memakai klien bergaya OpenAI sambil mengubah backend serving. |
| Grup paralel tensor | Satu node atau satu island NVLink/NVSwitch | Layer paralel tensor sering berkomunikasi, jadi link antar-node yang lambat cepat merugikan. |
| Tahap pipeline | Pembagian di level node atau rack ketika model tidak muat dalam satu node | Paralelisme pipeline dapat mengurangi jumlah komunikasi antar-node dibanding menempatkan satu grup tensor-parallel di setiap GPU. |
| Backend terdistribusi | Multiprocessing untuk satu node, Ray saat Anda membutuhkan orkestrasi multi-node | Jaga serving satu node tetap sederhana; gunakan Ray ketika worker harus tersebar di beberapa mesin. |
| Rencana cache KV | Anggarkan untuk panjang prompt, panjang output, dan konkurensi | Bobot hanyalah titik awal; serving konteks panjang bisa dibatasi cache KV. |
| Uji penerimaan | Topologi, NCCL, pemuatan dingin, TTFT, throughput, dan restart kegagalan | Kebanyakan deployment yang buruk tampak baik-baik saja sampai traffic realistis datang. |
Untuk pandangan infrastruktur yang berdekatan, lihat panduan arsitektur klaster GPU. Untuk sizing memori, gunakan lembar kerja kebutuhan memori GPU LLM setelah tersedia.
Tensor parallel vs pipeline parallel di vLLM
Aturan keputusan yang paling berguna sederhana:
Gunakan paralelisme tensor di dalam island GPU cepat. Gunakan paralelisme pipeline untuk melintasi batas yang lebih lambat.
Paralelisme tensor adalah langkah awal yang baik ketika:
- model terlalu besar untuk satu GPU, tetapi muat di 2, 4, atau 8 GPU dalam satu node;
- node GPU Anda memiliki link GPU-ke-GPU berbandwidth tinggi;
- latensi penting dan Anda ingin setiap permintaan melewati satu replika model logis tanpa bubble pipeline yang panjang;
- keluarga model didukung dengan baik oleh eksekusi paralel tensor vLLM.
Paralelisme pipeline menjadi berguna ketika:
- model tidak dapat muat dalam satu node bahkan setelah kuantisasi atau presisi yang lebih rendah;
- grup tensor-parallel jika tidak akan terlalu sering melintasi Ethernet atau InfiniBand;
- Anda ingin setiap node memiliki satu tahap model alih-alih setiap layer ikut serta dalam kolektif antar-node;
- Anda dapat menoleransi overhead penjadwalan dan bubble yang datang bersama tahap pipeline.
Jangan menganggap bahwa tp=8 selalu lebih baik daripada tp=4, atau bahwa pp=2 secara otomatis meningkatkan throughput. Untuk inferensi multi GPU vLLM, bentuk yang tepat bergantung pada ukuran model, tekanan memori, interkoneksi, panjang urutan, dan seberapa besar konkurensi batch yang dapat dipertahankan workload Anda.
Contoh inferensi multi GPU vLLM pada satu node
Mulailah dengan satu node jika bisa. Ini lebih mudah di-debug, lebih murah untuk di-benchmark, dan menghindari networking multi-node sebagai domain kegagalan pertama.
Contoh: satu server 4-GPU, satu replika vLLM, ukuran tensor parallel 4.
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
Gunakan bentuk ini ketika model muat dengan rapi di empat GPU dan node memiliki komunikasi GPU-ke-GPU yang cepat. Untuk node 8-GPU, uji baik --tensor-parallel-size 4 maupun --tensor-parallel-size 8; grup yang lebih besar mungkin meningkatkan ruang headroom memori tetapi dapat menambah overhead komunikasi.
Smoke test dasar:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "Berikan saya pengecekan kesehatan GPU dalam satu kalimat."}],
    "max_tokens": 64
  }'
Jika ini gagal, jangan beralih ke multi-node dulu. Perbaiki pengunduhan model, visibilitas CUDA, visibilitas NCCL, kompatibilitas driver/runtime, dan tekanan memori GPU terlebih dahulu.
Contoh multi-node dengan parallelisme tensor dan pipeline
Ketika Anda membutuhkan lebih banyak GPU daripada yang dapat disediakan satu node, pertahankan grup tensor-parallel di dalam setiap node jika memungkinkan, lalu gunakan pipeline parallelism lintas node.
Contoh bentuk target:
- dua node;
- empat GPU per node;
- ukuran tensor parallel 4;
- ukuran pipeline parallel 2;
- total worker:
4 * 2 = 8.
Peluncuran konseptual:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
Dalam klaster nyata, mulai Ray di node head, gabungkan node worker ke klaster Ray tersebut, pastikan penyimpanan model dapat diakses oleh semua node, dan konfirmasi bahwa semua worker melihat jumlah GPU yang diinginkan sebelum meluncurkan server vLLM. Kunci versi vLLM, image CUDA, cabang driver, dan revisi model secara tepat di runbook agar rebuild berikutnya tidak mengubah perilaku secara diam-diam.
Inilah titik ketika kualitas infrastruktur menjadi kualitas produk. Jika node kedua terhubung melalui jaringan yang lemah, jika NCCL memilih antarmuka yang salah, atau jika path cache model lambat, pengguna akan merasakannya sebagai variasi latensi, cold start yang lama, atau kegagalan request.
Pilihan backend: multiprocessing atau Ray
Untuk dukungan inferensi multi-gpu vLLM, gunakan backend executor paling sederhana yang sesuai dengan deployment:
| Deployment | Backend yang disarankan | Catatan |
|---|---|---|
| Satu mesin, beberapa GPU | Multiprocessing atau default vLLM untuk versi Anda | Lebih mudah dioperasikan; lebih sedikit komponen bergerak. |
| Beberapa mesin | Ray | Diperlukan ketika worker tersebar di beberapa node dan membutuhkan koordinasi tingkat klaster. |
| Serving multi-node di Kubernetes | Ray plus perencanaan pod/jaringan/penyimpanan yang eksplisit | Buat penjadwalan, penempatan, dan health check terlihat alih-alih berharap proses serving menemukan GPU yang tepat. |
Pilihan backend tidak boleh dipisahkan dari topologi. Jika Anda membutuhkan Ray hanya karena model terlalu besar untuk satu server, pertanyaan berikutnya adalah apakah pipeline parallelism dapat menjaga sebagian besar komunikasi frekuensi tinggi tetap di dalam setiap node.
Perhitungan memori sebelum Anda memilih TP dan PP
Rencana inferensi multi gpu vLLM harus menganggarkan memori dalam urutan berikut:
- Bobot: parameter model setelah dtype atau quantization.
- KV cache: panjang prompt, panjang output, concurrency batch, dan cache dtype.
- Overhead runtime: CUDA graphs, perilaku allocator, buffer komunikasi, overhead tokenizer/server, dan ruang aman.
- Ruang aman operasional: rolling restart, pemuatan ulang model, telemetry, dan lonjakan prompt sesekali.
Tensor parallelism menyebarkan bobot model dan sebagian pekerjaan komputasi di seluruh GPU, tetapi itu tidak membuat lalu lintas menjadi gratis. Pipeline parallelism dapat mengurangi tekanan memori per stage, tetapi ia menimbulkan pertanyaan keseimbangan stage. Stage pipeline dengan tekanan memori lebih besar atau kernel yang lebih lambat menjadi penghambat throughput untuk seluruh replika.
Pilihan awal yang praktis:
| Kondisi model/runtime | Bentuk TP/PP pertama untuk diuji |
|---|---|
| Model 7B atau 8B, konteks biasa | tp=1, satu GPU, skalakan replika secara horizontal |
| Model 32B, concurrency tinggi | tp=2 atau tp=4 pada satu node |
| Model kelas 70B, BF16/FP16 | tp=4 atau tp=8 pada satu node dengan memori besar |
| Model dense sangat besar yang melintasi node | tp=4, pp=2 atau tp=8, pp=2, tergantung ukuran node |
| Model MoE | Periksa panduan expert-parallel vLLM secara terpisah; jangan perlakukan MoE sebagai model dense secara default |
Tabel ini adalah titik awal, bukan hasil benchmark. Biaya output yang Anda terima bergantung pada prompt nyata, output nyata, tingkat retry, perilaku antrean, dan penerimaan kualitas.
Pemeriksaan topologi yang penting
Sebelum Anda memublikasikan endpoint multi-GPU, kumpulkan fakta-fakta ini dari penyedia atau dari mesin:
- output
nvidia-smi topo -muntuk setiap node; - apakah GPU berbagi NVLink atau NVSwitch di dalam node;
- fabric jaringan antar node, termasuk InfiniBand, RoCE, EFA, atau Ethernet;
- antarmuka yang terlihat oleh NCCL dan apakah lalu lintas menggunakan jalur yang dimaksud;
- jalur penyimpanan untuk bobot model dan apakah beberapa node memuat dari disk bersama yang lambat;
- memori GPU, status MIG, power cap, dan versi driver/CUDA.
Sistem NVIDIA DGX H100/H200, misalnya, didokumentasikan sebagai sistem delapan GPU dengan konektivitas GPU-ke-GPU NVSwitch/NVLink dan opsi jaringan 400 Gb/s. Node PCIe komoditas masih dapat melayani vLLM dengan baik, tetapi Anda harus mengharapkan profil komunikasi yang berbeda dan melakukan benchmark sesuai itu.
Untuk latar belakang interconnect, lihat NVLink vs NVSwitch. Untuk bahasa pembelian klaster dan topologi, panduan sewa klaster GPU adalah pendamping yang berguna.
Uji penerimaan produksi
Jalankan pengujian bertahap alih-alih satu prompt happy-path.
- Uji topologi: simpan
nvidia-smi topo -m, inventaris NIC, dan lingkungan NCCL. - Uji cold load: ukur waktu dari container mulai hingga token pertama berhasil.
- Uji prompt pendek: panjang prompt rendah, panjang output sedang, beban kerja chat yang diharapkan.
- Uji prompt panjang: panjang konteks realistis mendekati kebutuhan produk Anda.
- Uji concurrency: tingkatkan permintaan bersamaan sampai p95 time-to-first-token atau p95 latensi antar-token melewati batas Anda.
- Uji output-heavy: gunakan beban kerja yang menghasilkan completion panjang, bukan hanya prompt klasifikasi.
- Uji kegagalan: hentikan satu proses worker atau satu node dan verifikasi load balancer menghapus replika.
- Uji restart: lakukan rolling pada proses vLLM dan konfirmasi cache model, state Ray, dan health check pulih dengan bersih.
Lacak setidaknya metrik berikut:
| Metrik | Mengapa penting |
|---|---|
| Waktu ke token pertama | Pengguna langsung merasakannya dalam alur kerja chat dan agent. |
| Latensi antar-token | Menunjukkan stabilitas decode setelah generasi dimulai. |
| Token per detik per replika | Membantu membandingkan bentuk TP/PP. |
| Headroom memori GPU | Memprediksi apakah lonjakan konteks panjang akan OOM. |
| Waktu antrean | Memisahkan kapasitas serving dari latensi aplikasi. |
| Rasio error dan retry | Mengubah ketidakstabilan infrastruktur menjadi biaya nyata. |
| Tingkat output yang diterima | Menghindari optimasi untuk token murah yang ditolak pengguna. |
Pola pemecahan masalah
Model dimuat, tetapi throughput malah lebih buruk dengan lebih banyak GPU.
Grup TP mungkin terlalu besar untuk topologi, atau beban kerja mungkin tidak memiliki cukup concurrency untuk mengamortisasi komunikasi. Uji TP yang lebih kecil, lebih banyak replika, atau bentuk batch/concurrency yang berbeda.
Peluncuran multi-node macet.
Periksa membership Ray, aturan firewall, pemilihan interface NCCL, networking container, dan apakah setiap node dapat menjangkau path model yang sama. Jangan debug ini dari layer API terlebih dahulu.
Satu GPU OOM sementara yang lain masih punya headroom.
Cari stage pipeline yang tidak seimbang, SKU GPU yang berbeda, fragmentasi memori, atau masalah assignment rank. Pastikan setiap worker menggunakan GPU visible yang dimaksud.
Latensi melonjak saat prompt panjang.
Tekanan KV cache, biaya prefill, dan antrean scheduler kemungkinan menjadi penyebabnya. Uji bucket panjang prompt secara terpisah sebelum mengubah hardware.
Endpoint berfungsi di terminal tetapi gagal di balik load balancer.
Periksa timeout streaming, idle timeout, path health-check, batas ukuran request body, dan apakah load balancer mengirim traffic ke replika sebelum model siap.
Kapan sebaiknya Anda tidak menjalankan inferensi multi GPU vLLM sendiri
Menjalankan vLLM adalah pilihan yang tepat ketika Anda membutuhkan kontrol di level model, private weights, custom kernel, custom quantization, atau eksperimen di level hardware. Itu tidak otomatis menjadi pilihan yang tepat ketika kebutuhan bisnisnya hanya "beri aplikasi kami API yang andal dan kompatibel dengan OpenAI."
Sebelum menyewa cluster GPU multi-node, bandingkan jalur self-hosted dengan jalur model/API terkelola:
| Persyaratan | Self-host vLLM di GPU | Baseline model/API terkelola |
|---|---|---|
| Custom/private weights | Cocok kuat | Biasanya tidak cukup |
| Eksperimen hardware | Cocok kuat | Bukan fokusnya |
| Integrasi produk cepat | Lebih banyak pekerjaan operasional | Cocok kuat |
| Beralih antar model | Anda mengoperasikan setiap stack | Satu gateway dapat menyederhanakan akses |
| Visibilitas billing dan usage | Bangun atau integrasikan sendiri | Sering sudah termasuk |
| Penanganan kegagalan | Menjadi tanggung jawab Anda | Provider/gateway menangani lebih banyak bagiannya |
Flatkey adalah titik pembanding ketika Anda menginginkan satu key yang kompatibel dengan OpenAI, satu saldo, dan akses ke endpoint model resmi tanpa mengoperasikan sendiri layer serving GPU. Jika kontrol hardware langsung bukan kebutuhan produk, benchmark terhadap baseline model/API sebelum berkomitmen pada operasi cluster.
Pertanyaan Umum
Apakah vLLM mendukung inferensi multi-GPU?
Ya. vLLM mendukung inferensi multi-GPU melalui tensor parallelism dan pipeline parallelism, dengan pilihan executor yang mencakup serving single-node dan multi-node. Jalur dukungan yang tepat bergantung pada versi vLLM Anda, arsitektur model, topologi GPU, dan backend deployment.
Apa ukuran tensor parallel terbaik untuk vLLM?
Ukuran tensor parallel terbaik adalah nilai TP terkecil yang memberi cukup headroom memori dan throughput untuk workload Anda. Mulailah dengan GPU dalam satu node cepat, lalu benchmark tp=2, tp=4, atau tp=8 terhadap panjang prompt dan output yang nyata.
Kapan saya harus menggunakan pipeline parallelism di vLLM?
Gunakan pipeline parallelism ketika model atau kebutuhan KV-cache memaksa Anda melewati satu node, atau ketika menjaga komunikasi tensor-parallel di dalam setiap node lebih baik daripada membangun satu grup TP lintas node.
Apakah Ray diperlukan untuk serving multi-GPU vLLM?
Ray biasanya merupakan pilihan praktis untuk serving vLLM multi-node. Untuk satu node, backend multiprocessing atau backend default untuk versi vLLM Anda mungkin lebih sederhana.
Bagaimana saya tahu apakah setup inferensi multi GPU vLLM siap produksi?
Setup tersebut siap produksi hanya setelah pemeriksaan topologi, tes cold-load, benchmark prompt/concurrency yang realistis, health check, tes restart, dan perilaku saat gagal didokumentasikan. Satu request curl yang berhasil tidaklah cukup.


