
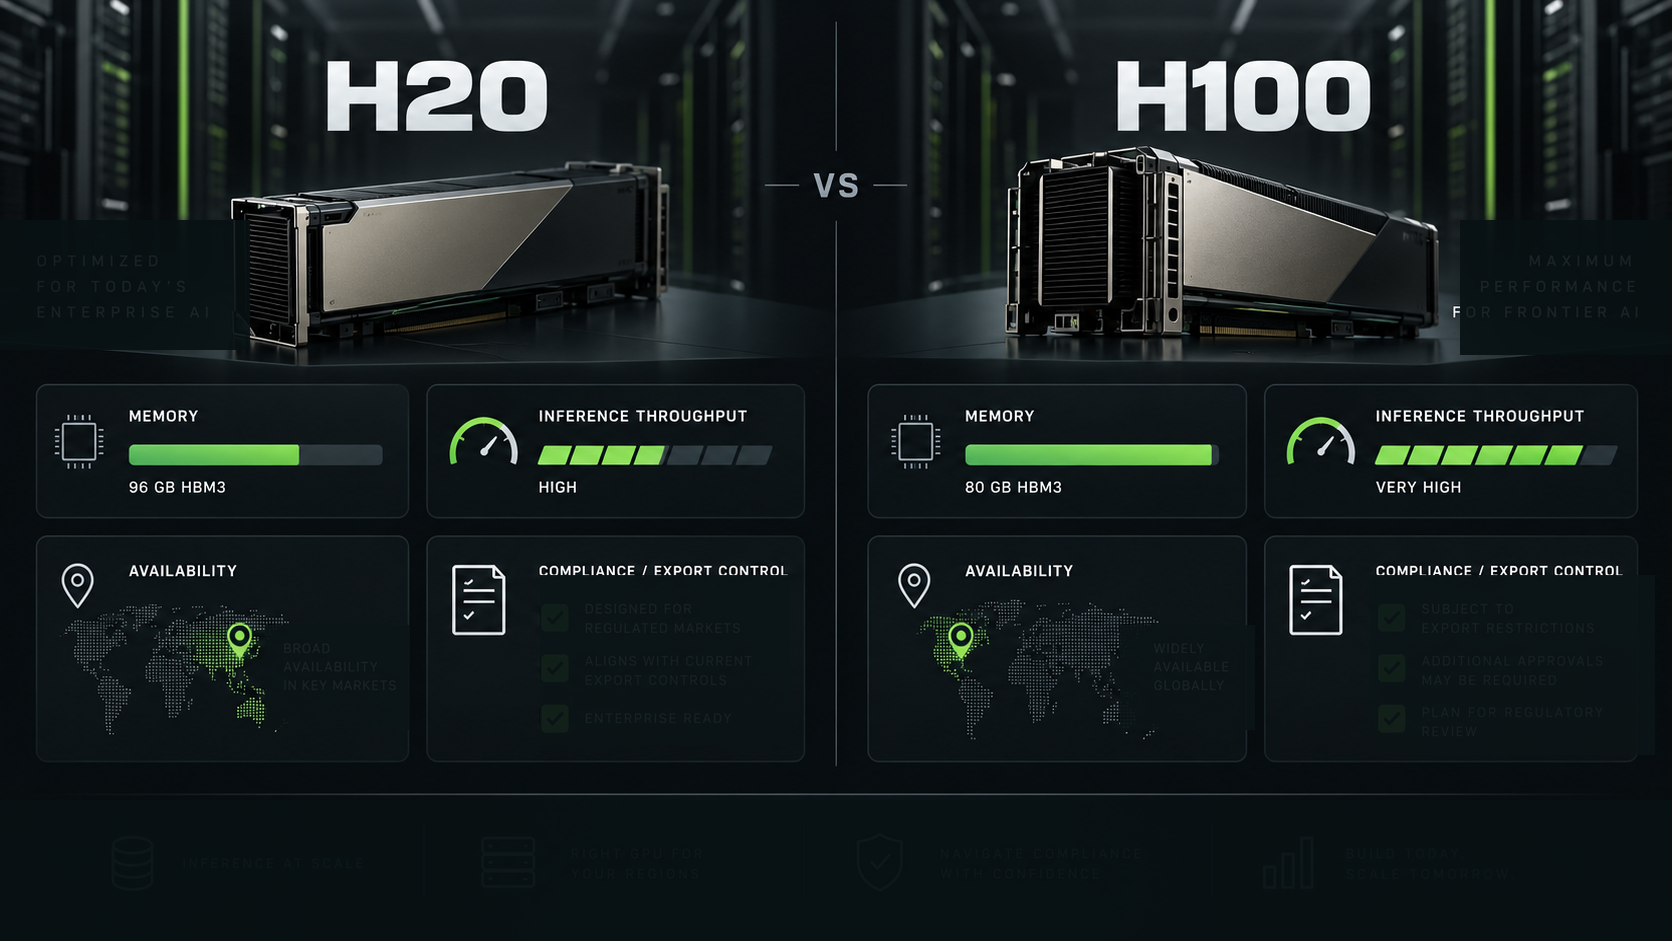
Se você está comparando H20 vs H100, a versão curta é esta: a H100 é a opção padrão mais forte quando você pode adquiri-la legalmente, obtê-la de forma confiável e mantê-la em uso. A H20 só se torna atraente quando restrições de controle de exportação, disponibilidade no mercado chinês ou regras locais de закупação tornam a H100 impraticável.
Isso faz com que NVIDIA H20 vs H100 se pareça menos com uma comparação normal de tabela de especificações e mais com uma decisão de capacidade consciente de conformidade. A H100 é a GPU Hopper mais conhecida para treinamento e inferência. A H20 é uma rota restrita da família Hopper que compradores avaliam quando o contexto de aquisição é moldado por licenciamento de exportação, regras do mercado da RPC e disponibilidade de SKU específica do provedor.
Para equipes de IA corporativa, a pergunta útil de h20 vs h100 não é "qual GPU é mais rápida?" É: qual opção pode entregar saída de inferência aceita com o menor risco total após considerar ajuste de memória, tempo de fila, aprovação de conformidade e disponibilidade?
H20 vs H100: resposta rápida
Escolha H100 quando:
- Você pode adquirir ou alugar capacidade H100 na região de implantação sem bloqueios de controle de exportação.
- Sua carga de trabalho precisa de uma base Hopper madura para treinamento, ajuste fino ou inferência de alto throughput.
- Você precisa de forte maturidade de software, amplo suporte em nuvem e referências de benchmark previsíveis.
- Seu modelo não exige um caminho de aquisição de GPU específico para a China.
Escolha H20 apenas quando:
- A implantação precisa se encaixar em um mercado restrito ou em uma localização de cliente onde a H100 está indisponível ou difícil de licenciar.
- O provedor pode mostrar o SKU exato da H20, tamanho de memória, interconexão, imagem de driver e termos comerciais.
- Conformidade, localização do cliente, revenda e verificações de uso final já fazem parte do processo de compra.
- Você está fazendo benchmark de uma carga de trabalho real de inferência, e não confiando em tabelas de especificações de pico de terceiros.
Para a maioria das equipes, H20 vs H100 é decidido por disponibilidade e conformidade antes do desempenho bruto de inferência. Se ambas estiverem disponíveis em termos legais e comerciais aceitáveis, a H100 é a opção padrão mais segura.
Especificações da NVIDIA H20 vs H100 que importam
A parte difícil de uma comparação de especificações NVIDIA H20 vs H100 é que a H100 tem uma página pública de produto, enquanto os dados públicos da H20 são mais fragmentados. A página pública da H100 da NVIDIA lista a GPU H100 Tensor Core como uma GPU de data center Hopper com opções de memória HBM e números máximos publicados de IA/HPC. A documentação do NVIDIA AI Enterprise lista publicamente variantes da H20 na matriz de suporte de vGPU Hopper, incluindo perfis H20 SXM5 com entradas de framebuffer de 96GB e 141GB.
Trate esta tabela como uma lista de verificação de aquisição, não como uma cotação final.
| Área de especificação | H100 | H20 |
|---|---|---|
| Posicionamento público | GPU de data center Hopper principal para IA, HPC, treinamento e inferência | Rota de GPU de data center da família Hopper avaliada em contextos de aquisição restritos |
| Página pública de produto NVIDIA | Sim, a H100 tem uma página dedicada de produto | Não há uma página pública ampla equivalente da H20 usada para especificações finais do comprador |
| Sinal público de memória | H100 SXM é comumente avaliada em torno de 80GB HBM3; a H100 NVL aparece em contextos de serviço de LLM com memória maior | Os docs de vGPU do NVIDIA AI Enterprise listam perfis H20 SXM5 de 96GB e 141GB |
| Conclusão para inferência | Opção padrão mais forte para desempenho bruto, suporte ao ecossistema, treinamento e inferência geral | Avalie apenas com benchmarks do SKU exato; a capacidade de memória pode ser atraente, mas conformidade e disponibilidade dominam |
| Risco de aquisição | Disponibilidade e preço em nuvem variam, mas o produto é amplamente suportado | Licenciamento de exportação, regras do mercado da RPC e fornecimento específico do provedor podem determinar se uma cotação é utilizável |
A maneira correta de ler nvidia h20 vs h100 specs é separar três camadas:
- Fatos públicos confirmados da NVIDIA, como a documentação do produto H100 e as entradas de suporte H20 do NVIDIA AI Enterprise.
- Fatos da cotação do provedor, como memória exata da H20, interconexão, driver, formato do nó, região e garantia.
- Fatos da sua carga de trabalho, como tokens por segundo, tempo até o primeiro token, atraso na fila, taxa de falha e custo por saída aceita.
Não misture essas camadas em uma única pontuação sintética de "vencedor".
Desempenho NVIDIA H20 vs H100: o que muda na inferência
Para desempenho nvidia h20 vs h100, faça benchmark de inferência em duas fases: prefill e decode.
O prefill é sensível ao comprimento do prompt, à estratégia de batch, à implementação de atenção e à largura de banda de memória. O decode é sensível à concorrência, à pressão do KV cache, ao comportamento do agendador e à eficiência da pilha de serving. Uma equipe de aquisição que pedir apenas números máximos de tensor core perderá os verdadeiros fatores de custo.
Use a H100 como base quando:
- Você está atendendo modelos de 7B a 70B com vLLM, TensorRT-LLM, SGLang ou imagens gerenciadas do Kubernetes maduras.
- Você precisa de uma comparação limpa com a capacidade em nuvem H100, H200 ou B200 existente.
- Você planeja reutilizar o trabalho de benchmark de frotas H100 mais amplas.
- Treinamento ou ajuste fino continuam fazendo parte do mix de carga de trabalho.
Use a H20 somente após um teste ao vivo quando:
- A H100 não pode ser comprada, importada, implantada ou aprovada para o ambiente-alvo.
- O nó H20 tem memória suficiente para o modelo e o comprimento de contexto sem compromissos forçados de qualidade.
- O provedor pode comprovar drivers estáveis, imagens de contêiner e suporte à sua framework de serving.
- A revisão de conformidade aceita o usuário final, o uso final, a região e o caminho de transferência.
Na prática, H20 vs H100 raramente é um benchmark de laboratório justo. Normalmente é "H100 em uma região sem restrições" versus "H20 ou outra opção local em um ambiente de aquisição restrito." Por isso, o benchmark precisa incluir disponibilidade legal e tempo de fila, não apenas tokens por segundo.
Memória: quando o H20 pode parecer interessante
A memória é a única área em que o H20 merece verificação cuidadosa. A documentação do NVIDIA AI Enterprise lista perfis vGPU H20 SXM5 com entradas de framebuffer de 96GB e 141GB. Essas entradas públicas são úteis porque mostram que conversas sobre o H20 não devem assumir um único tamanho fixo de memória.
Para inferência de LLM, a memória afeta:
- Se o modelo cabe sem quantização agressiva.
- Quanta cache KV pode ser mantida por réplica.
- Se contexto mais longo ou maior concorrência é viável.
- Se uma carga de trabalho precisa de paralelismo de tensor em várias GPUs.
- Com que frequência prompts de produção disparam novas tentativas por falta de memória.
Isso significa que uma configuração H20 com maior memória às vezes pode ser operacionalmente interessante, mesmo que o H100 seja o acelerador geral mais forte. Mas um número maior de memória não torna automaticamente o H20 mais rápido ou mais barato. O nó ainda precisa passar em benchmarks de inferência, verificações de disponibilidade, revisão de conformidade e modelagem de custo total.
Se a carga de trabalho for limitada por memória e o H100 estiver disponível, compare o H100 também com o H200. A decisão mais ampla H200 vs H100 muitas vezes é um caminho de atualização de memória mais limpo do que depender de uma via de fornecimento do H20 construída em torno de restrições de exportação.
Disponibilidade e conformidade são requisitos de primeira ordem
Para NVIDIA H20 vs H100, conformidade não é um rodapé. O mais recente registro público da NVIDIA na SEC descreve uma série de restrições de controle de exportação que afetam produtos das classes A100, H100, H20, H200, B200, GB200 e sistemas relacionados. Ele afirma que os produtos H100 foram impactados por restrições anteriores relacionadas à China, que as exportações do H20 para a China e para países D:5 passaram a exigir licenciamento em abril de 2025, e que licenças posteriores não se traduziram em vendas irrestritas do H20 porque restrições do lado da RPC também afetaram as vendas.
Para compradores, isso cria três regras práticas:
- Não trate a disponibilidade do H20 como uma questão normal de estoque.
- Não presuma que uma licença, cotação ou anúncio de marketplace seja suficiente para o cliente final.
- Não modele a capacidade do H20 sem um caminho alternativo.
Faça estas perguntas aos fornecedores antes de aceitar uma cotação de H20:
- Qual SKU exato do H20 está sendo cotado?
- Qual país, região, data center e entidade jurídica hospedarão as GPUs?
- O comprador, usuário final, carga de trabalho, empresa-mãe ou localização do cliente está sujeito a alguma análise de controle de exportação?
- Restrições de revenda, transferência, acesso remoto ou serviço em nuvem são relevantes?
- A GPU está disponível agora, reservada, pendente de licença, pendente de importação ou dependente de uma alocação futura?
- O que acontece se uma licença, tarifa, inspeção ou regra governamental mudar antes da implantação?
- A mesma carga de trabalho pode rodar em H100, H200, L40S, alternativas locais ou uma API de modelo se o H20 atrasar?
Essa lista importa mais do que outra comparação sintética de nvidia h20 vs h100 performance comparison.
H20 vs H100 vs H200
Muitas equipes pesquisam h20 vs h100 vs h200 porque a decisão real não é binária. Use este enquadramento mais simples:
| Caminho de GPU | Melhor uso padrão | Pergunta principal do comprador |
|---|---|---|
| H100 | Base Hopper madura para treinamento, fine-tuning e inferência | Conseguimos obter capacidade suficiente a um preço e em uma região que possamos usar? |
| H200 | Inferência intensiva em memória, contexto mais longo, lote maior, HPC limitado por memória | Mais memória HBM3e reduz GPUs, sharding ou retries o suficiente para justificar o prêmio? |
| H20 | Contextos de aquisição restrita em que H100/H200 não são diretos | Essa implantação específica de H20 pode passar por conformidade, disponibilidade e benchmarks de carga de trabalho? |
Se a equipe só precisa da saída do modelo, adicione um quarto caminho: uma API de modelo gerenciada. A posse do hardware se justifica quando você precisa de pesos privados, kernels personalizados, capacidade dedicada fixa ou controle de serving em baixo nível. Se não precisar disso, uma linha de base de API de modelo pode superar o aluguel de GPU quando o tempo ocioso, a gestão de filas, o trabalho de drivers e jobs com falha são incluídos.
O Flatkey é útil para essa linha de base: uma chave, um saldo, roteamento compatível com OpenAI, visibilidade de uso e acesso a muitas APIs oficiais de modelos sem operar servidores GPU. Ele não substitui o H20 ou o H100 para equipes que precisam possuir a camada de hardware, mas oferece à área de compras uma comparação realista de "precisamos mesmo de GPUs?".
Guias de planejamento relacionados:
- Preços de aluguel de GPU explicados
- Custos ocultos de nuvem de GPU
- TCO de cluster de GPU
- Nuvem de GPU vs API de modelo
- Melhor GPU para inferência de LLM
- Comparação de nuvem de GPU 2026
Lista de verificação de benchmark para inferência em H20 vs H100
Execute a mesma carga de trabalho na forma exata de implantação que você planeja comprar. Para inferência em h20 vs h100, use prompts com características de produção e meça a saída aceita.
| Métrica | Por que isso importa |
|---|---|
| Tempo até o primeiro token | Captura a latência visível para o usuário e o comportamento de prefill |
| Latência entre tokens | Mostra a سرعت de decodificação sob concorrência real |
| Tokens por segundo por GPU | Útil, mas incompleto sem utilização e taxa de aceitação |
| Concorrência máxima estável | Expõe a pressão sobre o cache KV e o scheduler |
| Memória alocada e reservada | Mostra se o modelo realmente cabe com os prompts de produção |
| Atraso na fila | Transforma capacidade escassa em latência real para o usuário |
| Taxa de OOM e de retentativas | Converte limites de memória em impacto de custo e confiabilidade |
| Custo por saída aceita | Normaliza hora de GPU, utilização, falhas e tempo de engenharia |
| Tempo de aprovação de conformidade | Crítico para H20 e qualquer implantação em região restrita |
| Caminho de fallback | Protege datas de lançamento quando a oferta ou o licenciamento mudam |
A métrica de procurement importante não é "pico de desempenho do H20 vs H100." É o custo do workload concluído após incluir disponibilidade, tentativas malsucedidas, enfileiramento, revisão de conformidade e operações.
Matriz de decisão de procurement
Use esta matriz na reunião de compra.
| Se isso for verdadeiro | Preferir | Por quê |
|---|---|---|
| O H100 está legalmente disponível, a capacidade é real e o preço é aceitável | H100 | É a base Hopper mais limpa, com amplo suporte |
| O workload é limitado por memória e o H200 está disponível | Testar H200 contra H100 | A atualização de memória pode ser mais direta do que usar H20 |
| A implantação deve atender a um mercado restrito onde H100/H200 são bloqueados | Testar H20 com fallback | O caminho de conformidade pode ditar a escolha do hardware |
| O modelo é pequeno ou médio e o tráfego é em rajadas | API de modelo ou GPU serverless | Evite capacidade dedicada ociosa de GPU |
| A equipe precisa de kernels customizados, pesos privados e utilização sustentada | Capacidade direta de GPU | O controle de hardware pode justificar o ônus operacional |
| Regras de oferta, licenciamento ou geopolítica podem mudar antes do lançamento | Mantenha dois caminhos ativos | Não comprometa o roadmap do produto com um único SKU restrito |
Erros comuns no planejamento NVIDIA H20 vs H100
O primeiro erro é tratar o H20 como "apenas um H100 mais lento." A diferença real é o contexto de procurement. Se suas restrições legais, de conformidade e disponibilidade não exigem H20, a base H100 geralmente é mais simples.
O segundo erro é copiar as especificações do nvidia h20 vs h100 públicas sem verificar o SKU exato. As referências ao H20 podem variar conforme o tamanho da memória e o formato de implantação. Seu orçamento deve declarar a GPU, a memória, a interconexão, o design do nó, a imagem do driver, os termos de serviço e a região.
O terceiro erro é ignorar o H200. Se o problema é pressão de memória no H100, o H200 pode ser a comparação mais natural. Use o H20 quando o contexto de procurement obrigar esse caminho, não apenas porque um número de memória parece atraente.
O quarto erro é esquecer a base da API de modelo. Se o workload só precisa de saídas confiáveis do modelo, e não de controle direto da GPU, o caminho mais simples pode ser uma API com rastreamento de uso, fallback e economia pay-per-call.
Recomendação final
Para H20 vs H100, escolha H100 quando ele estiver disponível e em conformidade com sua implantação. Ele continua sendo a base Hopper mais segura para a maioria dos trabalhos de treinamento, fine-tuning e inferência.
Escolha H20 apenas quando o ambiente de procurement tornar isso necessário e a implantação exata de H20 passar em três testes: o modelo cabe, o benchmark de inferência funciona sob carga semelhante à de produção e a conformidade pode aprovar o usuário final, a região e o caminho de transferência.
Depois, compare ambos com o H200 e com uma base de API de modelo. O caminho vencedor é o que produz saída aceita de forma confiável, não o que tem a tabela de especificações mais interessante.
Perguntas frequentes
O H20 é melhor que o H100 para inferência?
Geralmente não. O H100 é a opção padrão mais forte quando está disponível e em conformidade. O H20 pode ser relevante quando o H100 é bloqueado por procurement, controle de exportação ou restrições de disponibilidade regional. Faça benchmark do SKU exato do H20 antes de assumir que ele é um bom substituto para inferência.
Qual é a principal diferença entre NVIDIA H20 e H100?
A principal diferença é o contexto de procurement. O H100 é uma GPU de data center Hopper amplamente suportada. O H20 é avaliado em contextos de procurement restrito, onde licenciamento de exportação, regras do mercado da RPC, disponibilidade exata do SKU e revisão de conformidade podem determinar se a capacidade pode ser usada.
Como devo comparar as especificações do NVIDIA H20 vs H100?
Compare SKU exato, memória, interconexão, formato do nó, imagem do driver, região, garantia e status de conformidade. Não confie apenas em tabelas de especificações de terceiros. Em produção, valide com prompts reais, concorrência-alvo e custo por saída aceita.
Devo comparar H20 vs H100 vs H200?
Sim. Se o workload é limitado por memória e o H200 está disponível, o H200 pode ser uma atualização mais limpa em relação ao H100. O H20 é mais relevante quando conformidade ou procurement regional bloqueiam H100/H200.
Quando devo usar uma API de modelo em vez de H20 ou H100?
Use uma API de modelo quando você não precisa de kernels customizados, pesos privados ou capacidade dedicada fixa. Para tráfego de produto em rajadas, uma API de modelo pode reduzir o gasto com GPU ociosa e o trabalho de operações, preservando a visibilidade de uso e a flexibilidade de roteamento.


