Запустить ComfyUI в облаке несложно. Настоящая работа — сделать это воспроизводимым, приватным и недорогим.
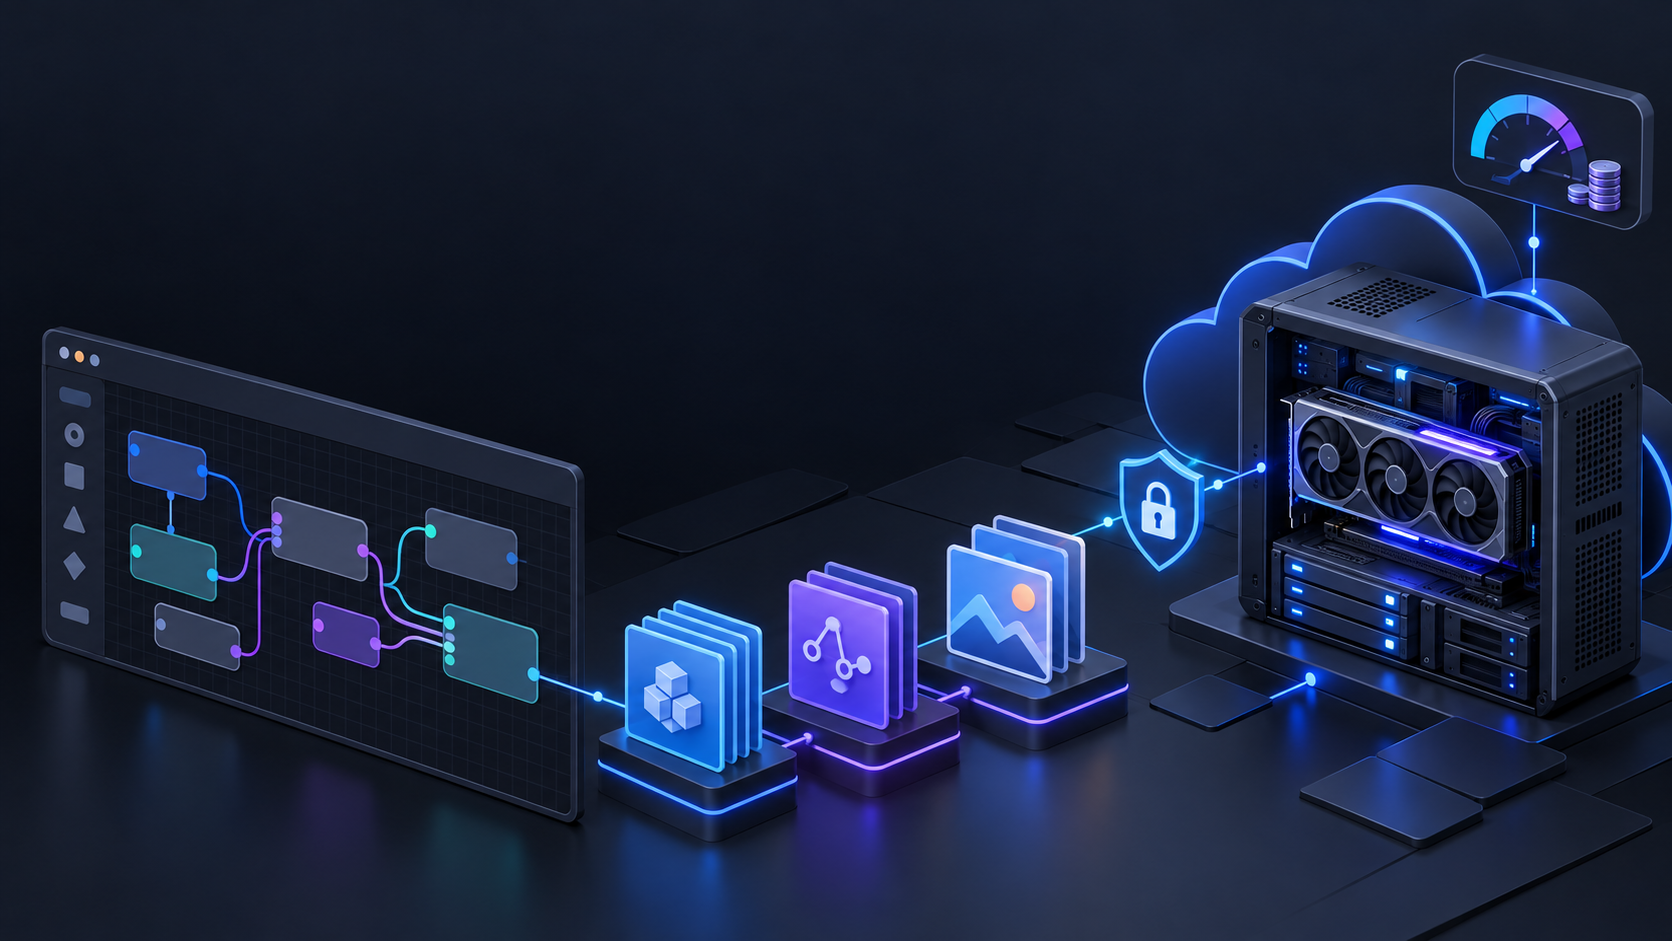
Полезная конфигурация ComfyUI cloud GPU разделяет четыре аспекта: временные вычислительные ресурсы, постоянные файлы, приватный доступ и правило остановки. Считайте GPU-инстанс заменяемым; размещайте модели, рабочие процессы, входные данные и результаты в хранилище, которое переживает его. Так вы получите конфигурацию, которую можно перезапустить без повторной загрузки стека рабочих процессов и без вопроса о том, куда делись вчерашние изображения.
Это руководство не привязано к конкретному провайдеру. Оно показывает, как настроить ComfyUI cloud GPU для интерактивной работы, как планировать хранилище и как рассчитывать расходы, не делая вид, что одна почасовая ставка за GPU отражает всю картину.
Краткая версия
Для большинства независимых разработчиков и небольших AI-команд начните со следующей схемы развертывания:
- Выберите интерактивную GPU VM или pod с достаточным объёмом VRAM для одного реального рабочего процесса, а не для теоретического бенчмарка.
- Подключите постоянное хранилище до загрузки моделей или установки пользовательских узлов.
- По умолчанию держите веб-процесс ComfyUI приватным; используйте аутентифицированный рабочий стол, туннель или прокси провайдера вместо открытого публичного порта.
- Сохраняйте каждый рабочий граф, ревизию модели и результат в постоянной точке монтирования.
- Измерьте показательную генерацию, затем остановите GPU сразу после завершения рабочей сессии.
Ключевой принцип прост: ComfyUI cloud GPU должен легко заменяться, а ваше рабочее состояние — нет.
1. Выберите подходящий тип облачного ресурса до установки чего-либо
Для практической сессии ComfyUI выберите GPU VM, pod или среду удалённого рабочего стола, предоставляющую браузер, терминал и постоянную точку монтирования. Обычно её проще отлаживать, чем конечную точку, работающую только с запросами, поскольку в одной сессии можно проверить логи, протестировать граф, добавить модель и выполнить итерации.
Переходите к развертыванию, ориентированному на запросы, только после стабилизации рабочего процесса и когда вы знаете, как он будет получать входные данные, возвращать результаты, аутентифицировать вызывающих пользователей и восстанавливаться после сбоев. Интерактивный ComfyUI cloud GPU service — правильная отправная точка, когда цель состоит в разработке рабочего процесса, а не в готовом API продукта.
Перед развертыванием ответьте на следующие вопросы, специфичные для провайдера:
| Вопрос | Почему это важно |
|---|---|
| Можно ли подключить хранилище, которое переживает перезапуск или замену? | Модели и результаты дорого воссоздавать или загружать повторно. |
| Можно ли ограничить входящий сетевой доступ? | ComfyUI не должен превратиться в публичную панель управления без аутентификации. |
| Можно ли использовать терминал и просматривать логи? | Большинство проблем с установкой и пользовательскими узлами быстрее диагностировать из командной оболочки. |
| Что продолжает тарифицироваться после остановки GPU? | Вычисления, диск, снимки, IP-адреса и исходящий трафик часто являются отдельными статьями расходов. |
| Привязан ли том к региону или зоне доступности? | Это может ограничить место запуска следующего GPU. |
Не выбирайте best cloud GPU for ComfyUI только по названию модели. Начните с пикового потребления памяти рабочим процессом: checkpoint, текстовые энкодеры, VAE, модели управления, LoRA, размер пакета, разрешение, а также любые этапы видео или апскейлинга — всё конкурирует за VRAM. Запустите один показательный граф и зафиксируйте его пиковое поведение, прежде чем переходить на более крупную машину или оставлять её работать дольше.
Более широкое сравнение платформ см. в руководствах Flatkey по платформам аренды облачных GPU, выбору GPU и бессерверным и выделенным GPU-ресурсам.
2. Сначала подключите постоянное хранилище
Самая распространённая ошибка в облаке — загружать всё во временную файловую систему инстанса. Когда эта машина останавливается, пересобирается или заменяется, вместе с ней могут исчезнуть кэш моделей, результаты, рабочие процессы и локальные изменения.
Создайте и подключите постоянный том до первой установки. На этом томе используйте небольшую, простую структуру каталогов:
/workspace/comfy-data/
├── models/
│   ├── checkpoints/
│   ├── vae/
│   ├── loras/
│   ├── controlnet/
│   └── upscale_models/
├── input/
├── output/
├── workflows/
├── custom-node-notes/
└── run-notes/
Вам не нужны все папки в первый же день. Суть в том, чтобы размещать повторно используемые ресурсы и итоговую работу на постоянной точке монтирования, оставляя временные файлы и среды, которые можно пересобрать, на диске инстанса, когда это удобнее.
ComfyUI предоставляет полезные средства управления каталогами через флаги запуска. --base-directory изменяет базовое расположение моделей, пользовательских узлов, входных и выходных данных, временных файлов и пользовательских данных; --input-directory, --output-directory и --extra-model-paths-config позволяют задать параметры точнее. Прежде чем фиксировать пути в шаблоне, проверьте актуальный справочник флагов запуска ComfyUI.
В качестве конкретного примера облачного хранилища RunPod документирует, что файловая система его контейнера является временной, тогда как тома сохраняются за пределами жизненного цикла контейнера. Другие провайдеры используют другие термины, поэтому, прежде чем полагаться на это, проверьте точное поведение при остановке, перезапуске и завершении работы в собственной документации провайдера по хранилищу. Руководство RunPod по сохранению данных хорошо объясняет это различие.
3. Установите ComfyUI с воспроизводимой базовой конфигурацией
Используйте основной проект как авторитетный источник для установки. В актуальном руководстве ComfyUI по ручной установке описаны поддерживаемые платформы, варианты PyTorch для конкретных GPU, установка зависимостей, каталоги моделей и вариант с comfy-cli. Начните с официального README ComfyUI, а затем зафиксируйте любые дополнения, специфичные для вашей команды, в собственных заметках.
Для облачной машины Linux последовательность верхнего уровня выглядит так:
git clone https://github.com/Comfy-Org/ComfyUI.git
cd ComfyUI

python -m venv .venv
source .venv/bin/activate

# Install the PyTorch build that matches this GPU/driver environment.
# Follow the current upstream ComfyUI and PyTorch instructions rather than
# copying a CUDA wheel command from an old image.
pip install -r requirements.txt

python main.py \
  --base-directory /workspace/comfy-data \
  --input-directory /workspace/comfy-data/input \
  --output-directory /workspace/comfy-data/output \
  --disable-auto-launch
Это намеренно базовый вариант, а не универсальный установщик, который можно просто скопировать и вставить. Облачные образы различаются драйверами, версиями Python, совместимостью с CUDA, точками монтирования и разрешениями. Проверьте python main.py --help на работающей машине и после успешного запуска запишите проверенную команду запуска в run-notes/.
Если вы используете общую библиотеку моделей с другим интерфейсом или размещаете модели за пределами стандартных каталогов ComfyUI, применяйте предусмотренный в основном проекте механизм extra_model_paths.yaml, а не создавайте случайные символьные ссылки на папки. Это делает связь явной и значительно упрощает последующую пересборку.
4. Настройте безопасный удалённый доступ перед использованием --listen
По умолчанию ComfyUI слушает на 127.0.0.1 и использует порт 8188. Параметры запуска также поддерживают другой адрес привязки, порт, файлы TLS-сертификата/ключа и настраиваемый заголовок CORS. Точное поведение описано в актуальных аргументах CLI.
Эта гибкость не означает, что можно размещать неаутентифицированную консоль генерации изображений в публичном интернете. Для интерактивной работы обычно безопаснее использовать схему защищённого облачного GPU-рабочего стола ComfyUI:
- Открывайте браузер внутри аутентифицированного сеанса удалённого рабочего стола, оставляя ComfyUI на loopback; или
- Используйте аутентифицированный SSH-туннель или прокси, управляемый провайдером; или
- Разместите обратный прокси со средствами контроля идентификации и TLS перед намеренно опубликованным сервисом ComfyUI.
Привязывайтесь к 0.0.0.0 только тогда, когда сетевой путь намеренно защищён брандмауэром, уровнем идентификации и, где необходимо, TLS. Не включайте разрешающий CORS лишь для того, чтобы заработало подключение из браузера. Если пользовательский узел, расширение или прокси меняет границу доверия, зафиксируйте это в run-notes/ и проведите тест с отдельной учётной записи или устройства.
Это особенно важно, если вы загружаете приватные референсные изображения, используете API-ключи внутри узлов или разрешаете коллегам устанавливать пользовательские узлы. Рассматривайте установку пользовательских узлов как изменение зависимостей: проверяйте исходный код, фиксируйте версию и тестируйте в одноразовой среде, прежде чем добавлять их в общий рабочий том.
5. Сделайте первую генерацию ComfyUI в облаке на GPU воспроизводимой
Первый сеанс должен подтвердить схему развёртывания, а не быть попыткой получить идеальное изображение. Используйте небольшой известный workflow и выполните следующий цикл:
- Загрузите одно нечувствительное тестовое изображение или промпт.
- Загрузите одну модель из постоянного каталога моделей.
- Выполните одну генерацию с целевыми разрешением и размером пакета.
- Сохраните JSON workflow в
workflows/с описательным названием и датой. - Храните финальное изображение и любые результаты сравнения в
output/. - Укажите редакцию модели, релевантные пользовательские узлы, время выполнения и любые обходные решения для памяти в
run-notes/.
Так разовая генерация ComfyUI в облаке на GPU превращается в эксперимент, который сможет повторить другой человек. Это также позволит определить, правильно ли выбран размер машины, прежде чем вы загрузите несколько крупных моделей и обнаружите, что workflow не запускается с нужными настройками.
6. Используйте правило выбора GPU, ориентированное прежде всего на рабочую нагрузку
Лучший облачный GPU для ComfyUI — это наименьший доступный вариант, который надёжно запускает ваш реальный граф при нужных разрешении, размере пакета и задержке. Понятие «лучший» меняется в зависимости от графа.
| Признак рабочей нагрузки | Что следует приоритизировать | Что протестировать перед окончательным выбором |
|---|---|---|
| Workflow с одним изображением | Достаточный объём VRAM для каждого активного компонента с запасом | Один репрезентативный промпт в вашем обычном разрешении |
| Несколько моделей управления, крупные пакеты или этапы апскейла | Больший объём VRAM, прежде чем стремиться к максимальной вычислительной производительности | Пиковое потребление памяти и сквозное время выполнения |
| Видео, многоэтапные графы или графы с множеством моделей | Постоянное хранилище, быстрая загрузка и план перезапуска | Время загрузки модели, использование временного диска и обработка результатов |
| Повторяющиеся сеансы команды | Многоразовый образ/шаблон и чёткие средства контроля доступа | Время пересборки из чистого экземпляра с использованием того же тома |
Не полагайтесь на указанное другим автором количество VRAM как на гарантию. Его checkpoint, квантизация, версии узлов, разрешение и настройки пакета могут отличаться от ваших. Репрезентативный 10-минутный тест полезнее чрезмерно упрощённой рекомендации по оборудованию.
7. Рассчитывайте стоимость по выполненной работе, а не по почасовой ставке GPU
Расценки на облачный GPU — лишь одна часть общей стоимости. Используйте этот шаблон для каждого рабочего процесса или проекта:
Session cost
  = (GPU runtime × current provider compute rate)
  + retained storage for the billing period
  + applicable transfer, snapshot, or platform charges

Cost per accepted output
  = session cost / number of outputs you actually keep
Второй показатель часто полезнее, чем стоимость одного сгенерированного изображения. Если вы запускаете 200 быстрых тестов и сохраняете пять результатов, стоимость принятого результата расскажет о рабочем процессе больше, чем номинальная цена за изображение.
Используйте эти практические меры контроля для облачного GPU с ComfyUI:
- Выработайте привычку выключать ресурсы. Определите, кто и когда останавливает GPU. Не оставляйте его работающим только потому, что открыта вкладка браузера.
- Отделяйте постоянные данные от временных. Храните модели, рабочие процессы, входные данные и результаты в долговременном хранилище; не платите за случайное сохранение временных файлов.
- Начинайте с малого перед масштабированием. Проверьте граф при умеренном разрешении и размере пакета, прежде чем запускать длительную генерацию изображений или видео.
- Ведите манифест моделей. Записывайте, что установлено и зачем. Это предотвращает повторные загрузки и делает очистку безопаснее.
- Проверяйте счет в остановленном состоянии. Правила оплаты хранилища, снимков, публичных IP-адресов и передачи данных зависят от провайдера; уточняйте их в актуальном интерфейсе биллинга и документации.
- Фиксируйте данные о времени выполнения. Для повторяющегося рабочего процесса записывайте время выполнения, повторные попытки, принятые результаты и размеры входных/выходных данных. Это создаст реалистичную основу для бюджета.
Более общую схему принятия решений смотрите в статье Объяснение цен на аренду GPU. В ней рассматривается разница между привлекательной почасовой ставкой и стоимостью выполненной работы.
8. Когда облачный GPU — неподходящая абстракция
ComfyUI ценен, когда вам нужны контроль на уровне узлов, локальные файлы моделей, пользовательская обработка, визуальная итерация или конкретный граф. Однако это не всегда самый простой способ внедрить функцию ИИ.
Если продукту требуется вызов размещенной модели, а не контроль на уровне рабочего процесса, отдельно сравните вариант с управляемой моделью/API. Flatkey предоставляет унифицированный интерфейс для API-вызовов моделей и инструментов; это может сократить фрагментацию интеграций и биллинга, но не заменяет ComfyUI, если вам требуется постоянный граф узлов с пользовательскими локальными ресурсами. Четко определите эту границу, прежде чем оптимизировать неподходящий стек.
Контрольный список перед запуском
Перед началом сеанса ComfyUI на облачном GPU подтвердите следующее:
- [ ] Постоянное хранилище подключено и смонтировано там, где вы ожидаете.
- [ ] Пути к моделям, рабочим процессам, входным данным и результатам указывают на это хранилище.
- [ ] Текущая комбинация GPU/PyTorch проверена на одном реальном графе.
- [ ] Удаленный доступ аутентифицирован; неаутентифицированный публичный порт не открыт.
- [ ] Будут зафиксированы JSON рабочего процесса, версия модели и изменения пользовательских узлов.
- [ ] Вы знаете, за какие ресурсы продолжает взиматься плата после остановки GPU.
- [ ] Назначенный ответственный остановит вычислительные ресурсы после сеанса.
Часто задаваемые вопросы
Как запустить ComfyUI на облачном GPU?
Разверните интерактивную GPU-машину с постоянным томом, установите ComfyUI согласно актуальным инструкциям основного проекта, направьте пути моделей/входных/выходных данных ComfyUI на смонтированное хранилище, обеспечьте приватный доступ через браузер и протестируйте один репрезентативный рабочий процесс перед масштабированием.
Что следует постоянно хранить для ComfyUI?
Храните многократно используемые модели, рабочие процессы, входные ресурсы, которые понадобятся снова, финальные результаты, заметки о пользовательских узлах и небольшой журнал запусков. Временные кеши и среды, которые можно пересоздать, обрабатывайте отдельно, если их хранение не оправдано стоимостью.
Нужен ли защищенный облачный GPU-рабочий стол для ComfyUI?
Это практичный выбор, если вам нужны интерактивные браузер и терминал без прямой публикации ComfyUI в интернете. Используйте аутентифицированный удаленный рабочий стол, туннель или прокси и по умолчанию держите приложение приватным.
Какой облачный GPU лучше всего подходит для ComfyUI?
Выбирайте исходя из фактической потребности вашего рабочего процесса в VRAM, целевого времени выполнения и требований к хранению и доступу. Сначала протестируйте предполагаемый граф; GPU, который подходит для чужого чекпойнта и разрешения, может не подойти для ваших.
Что должен включать сервис облачного GPU для ComfyUI?
Как минимум: совместимую GPU-среду, постоянное хранилище, контролируемый сетевой доступ, возможность просматривать журналы и понятную информацию о тарификации как работающих, так и остановленных ресурсов.
Официальные источники, использованные в этом руководстве
- Ручная установка ComfyUI и рекомендации по каталогам моделей
- Флаги запуска ComfyUI
- Определения аргументов CLI ComfyUI
- Руководство RunPod по сохранению данных контейнера — используется как конкретный пример хранения, а не как сравнение платформ
Надёжная конфигурация несложна: GPU должен быть заменяемым, работа — сохраняться постоянно, доступ — оставаться приватным, а остановка вычислений должна быть частью рабочего процесса.