Ejecutar ComfyUI en la nube es sencillo. Mantenerlo reproducible, privado y económico es el verdadero trabajo.
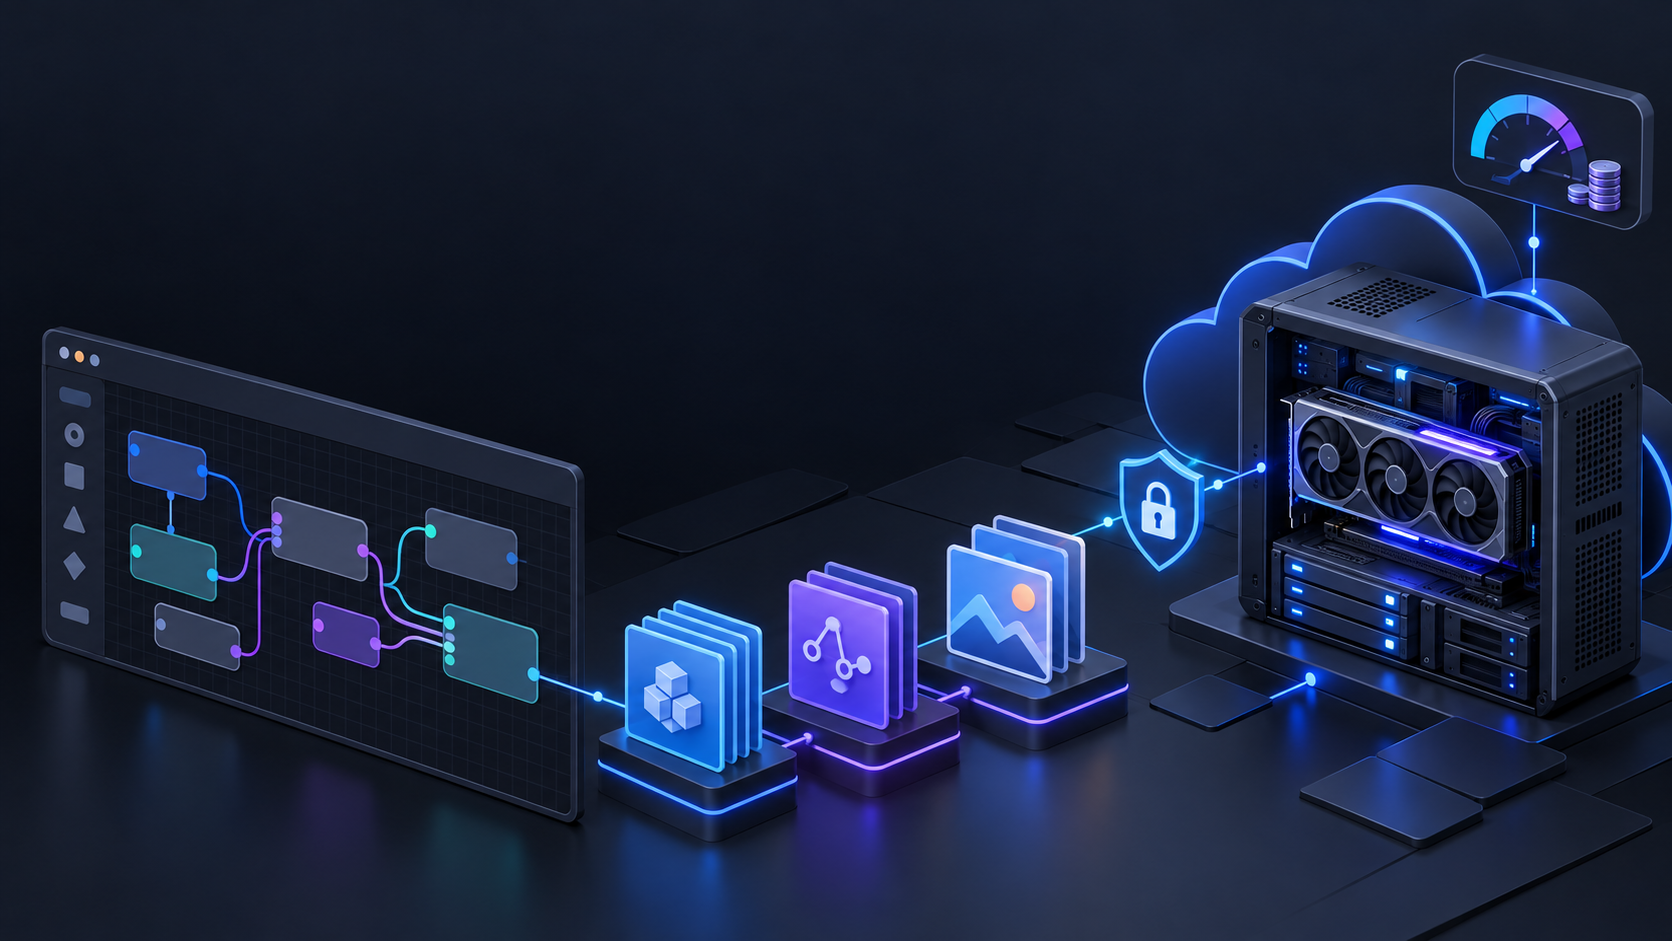
Una configuración útil de GPU en la nube para ComfyUI separa cuatro aspectos: cómputo desechable, archivos persistentes, acceso privado y una regla de detención. Considere la instancia de GPU como reemplazable; coloque los modelos, flujos de trabajo, entradas y salidas en un almacenamiento que sobreviva a la instancia. Así obtiene una configuración que puede reiniciar sin volver a descargar una pila de flujos de trabajo ni preguntarse adónde fueron las imágenes de ayer.
Esta guía es independiente del proveedor. Muestra cómo configurar una GPU en la nube para ComfyUI para trabajo interactivo, cómo planificar el almacenamiento y cómo calcular costos sin fingir que una única tarifa horaria de GPU cuenta toda la historia.
La versión corta
Para la mayoría de los desarrolladores independientes y pequeños equipos de IA, comience con este patrón de implementación:
- Elija una VM o pod de GPU interactivo con suficiente VRAM para un flujo de trabajo real, no para un benchmark teórico.
- Conecte almacenamiento persistente antes de descargar modelos o instalar nodos personalizados.
- Mantenga el proceso web de ComfyUI privado de forma predeterminada; utilice un escritorio autenticado, un túnel o un proxy del proveedor en lugar de un puerto público abierto.
- Guarde cada grafo de trabajo, revisión de modelo y salida en el punto de montaje persistente.
- Mida una generación representativa y, después, detenga la GPU en cuanto termine la sesión de trabajo.
El principio clave es simple: una GPU en la nube para ComfyUI debe ser fácil de reemplazar, mientras que su estado de trabajo no debería serlo.
1. Elija el tipo de recurso en la nube adecuado antes de instalar nada
Para una sesión práctica de ComfyUI, elija una VM de GPU, un pod o un entorno de escritorio remoto que le proporcione un navegador, una terminal y un punto de montaje persistente. Por lo general, esto es más fácil de depurar que un endpoint que solo acepta solicitudes, porque puede inspeccionar registros, probar un grafo, añadir un modelo e iterar en la misma sesión.
Use una implementación orientada a solicitudes solo después de que un flujo de trabajo sea estable y sepa cómo recibirá entradas, devolverá salidas, autenticará a quienes lo llamen y se recuperará de fallos. Un servicio de GPU en la nube para ComfyUI interactivo es el punto de partida adecuado cuando el objetivo es desarrollar flujos de trabajo en lugar de una API de producto terminada.
Antes de implementar, responda estas preguntas específicas del proveedor:
| Pregunta | Por qué importa |
|---|---|
| ¿Puedo conectar almacenamiento que sobreviva a un reinicio o reemplazo? | Los modelos y las salidas son costosos de recrear o descargar. |
| ¿Puedo restringir el acceso de red entrante? | ComfyUI no debería convertirse en un panel de control público sin autenticación. |
| ¿Puedo usar una terminal y ver registros? | La mayoría de los problemas de instalación y de nodos personalizados se diagnostican más rápido desde la shell. |
| ¿Qué sigue siendo facturable después de detener la GPU? | El cómputo, el disco, las instantáneas, las IP y la salida de datos suelen ser partidas independientes. |
| ¿El volumen está vinculado a una región o zona de disponibilidad? | Eso puede limitar dónde puede iniciarse la siguiente GPU. |
No elija la mejor GPU en la nube para ComfyUI basándose únicamente en el nombre de un modelo. Parta de la demanda máxima de memoria del flujo de trabajo: el checkpoint, los codificadores de texto, el VAE, los modelos de control, los LoRA, el tamaño de lote, la resolución y cualquier etapa de video o escalado compiten por la VRAM. Ejecute un grafo representativo y registre su comportamiento máximo antes de comprometerse con una máquina más grande o de ejecución más prolongada.
Para conocer comparativas más amplias entre plataformas, consulte las guías de Flatkey sobre plataformas de alquiler de GPU en la nube, selección de GPU y capacidad de GPU sin servidor frente a dedicada.
2. Conecte primero el almacenamiento persistente
El error más común en la nube es descargar todo en el sistema de archivos temporal de la instancia. Cuando esa máquina se detiene, se reconstruye o se reemplaza, la caché de modelos, las salidas, los flujos de trabajo y los cambios locales pueden desaparecer con ella.
Cree y conecte el volumen persistente antes de la primera instalación. En ese volumen, mantenga una estructura de directorios pequeña y sencilla:
/workspace/comfy-data/
├── models/
│   ├── checkpoints/
│   ├── vae/
│   ├── loras/
│   ├── controlnet/
│   └── upscale_models/
├── input/
├── output/
├── workflows/
├── custom-node-notes/
└── run-notes/
No necesita todas las carpetas el primer día. La idea es colocar los activos reutilizables y el trabajo final en el punto de montaje duradero, mientras deja los archivos temporales y los entornos que pueden reconstruirse en el disco de la instancia cuando resulte más conveniente.
ComfyUI expone controles útiles de directorios mediante sus indicadores de inicio. --base-directory cambia la ubicación base para modelos, nodos personalizados, entrada, salida, archivos temporales y datos de usuario; --input-directory, --output-directory y --extra-model-paths-config permiten ser más específico. Consulte la referencia actual de indicadores de inicio de ComfyUI antes de incorporar rutas en una plantilla.
Como ejemplo concreto de almacenamiento en la nube, RunPod documenta que su sistema de archivos de contenedor es temporal, mientras que los volúmenes persisten fuera del ciclo de vida del contenedor. Otros proveedores usan términos diferentes, así que verifique el comportamiento exacto de detención, reinicio y terminación en la documentación de almacenamiento del propio proveedor antes de depender de ello. La guía de persistencia de RunPod ofrece una explicación útil de la distinción.
3. Instale ComfyUI con una base reproducible
Use el proyecto upstream como autoridad de instalación. La guía actual de instalación manual de ComfyUI cubre las plataformas compatibles, las opciones de PyTorch específicas para cada GPU, la instalación de dependencias, los directorios de modelos y la opción comfy-cli. Comience con el README de ComfyUI oficial y, después, fije en sus propias notas cualquier añadido específico de su equipo.
Para una máquina Linux en la nube, la secuencia general es la siguiente:
git clone https://github.com/Comfy-Org/ComfyUI.git
cd ComfyUI

python -m venv .venv
source .venv/bin/activate

# Instale la compilación de PyTorch que coincida con este entorno de GPU/controlador.
# Siga las instrucciones actuales upstream de ComfyUI y PyTorch en lugar de
# copiar un comando de wheel de CUDA de una imagen antigua.
pip install -r requirements.txt

python main.py \
  --base-directory /workspace/comfy-data \
  --input-directory /workspace/comfy-data/input \
  --output-directory /workspace/comfy-data/output \
  --disable-auto-launch
Esto es intencionadamente una base, no un instalador universal para copiar y pegar. Las imágenes en la nube difieren en controladores, versiones de Python, compatibilidad con CUDA, puntos de montaje y permisos. Confirme python main.py --help en la máquina en ejecución y escriba el comando de inicio que funciona correctamente en run-notes/ una vez que funcione.
Si comparte una biblioteca de modelos con otra interfaz de usuario o coloca modelos fuera de los directorios predeterminados de ComfyUI, use el mecanismo upstream extra_model_paths.yaml en lugar de crear enlaces simbólicos a carpetas al azar. Así se mantiene explícita la relación y una reconstrucción posterior resulta mucho menos sorprendente.
4. Configure acceso remoto seguro antes de usar --listen
De forma predeterminada, ComfyUI escucha en 127.0.0.1 y utiliza el puerto 8188. Sus opciones de inicio también admiten una dirección de enlace diferente, un puerto, archivos de certificado/clave TLS y una cabecera CORS configurable. Consulte los argumentos de CLI actuales para conocer el comportamiento exacto.
Esa flexibilidad no es una invitación a poner una consola de generación de imágenes sin autenticación en la internet pública. Un patrón de escritorio seguro de GPU en la nube para ComfyUI suele ser más seguro para el trabajo interactivo:
- Abra un navegador dentro de una sesión de escritorio remoto autenticada, manteniendo ComfyUI en loopback; o
- Use un túnel SSH autenticado o un proxy administrado por el proveedor; o
- Coloque un proxy inverso con controles de identidad y TLS delante de un servicio de ComfyUI expuesto deliberadamente.
Vincule a 0.0.0.0 solo cuando la ruta de red esté protegida intencionadamente por un firewall, una capa de identidad y TLS cuando corresponda. No habilite CORS permisivo simplemente para que funcione una conexión del navegador. Si un nodo personalizado, una extensión o un proxy cambia el límite de confianza, regístrelo en run-notes/ y pruébelo desde una cuenta o dispositivo independiente.
Esto es especialmente importante si carga imágenes de referencia privadas, usa claves de API dentro de nodos o permite que miembros del equipo instalen nodos personalizados. Trate la instalación de nodos personalizados como un cambio de dependencia: revise la fuente, registre la versión y pruébela en un entorno desechable antes de añadirla a un volumen de producción compartido.
5. Haga reproducible la primera generación de ComfyUI en una GPU en la nube
Su primera sesión debe demostrar el patrón de implementación, no perseguir una imagen perfecta. Use un flujo de trabajo pequeño y conocido, y complete este ciclo:
- Cargue una imagen de prueba no sensible o un prompt.
- Cargue un modelo desde el directorio persistente de modelos.
- Ejecute una sola generación con la resolución y el tamaño de lote objetivo.
- Guarde el JSON del flujo de trabajo en
workflows/con un nombre descriptivo y la fecha. - Conserve la imagen final y cualquier resultado de comparación en
output/. - Anote la revisión del modelo, los nodos personalizados relevantes, el tiempo de ejecución y cualquier solución alternativa de memoria en
run-notes/.
Eso convierte una generación de ComfyUI en una GPU en la nube puntual en un experimento que otra persona puede repetir. También le indica si la máquina tiene el tamaño adecuado antes de descargar varios modelos grandes y descubrir que el flujo de trabajo no puede ejecutarse con la configuración prevista.
6. Use una regla basada primero en la carga de trabajo para seleccionar la GPU
La mejor GPU en la nube para ComfyUI es la opción disponible más pequeña que ejecuta de forma fiable su grafo real con la resolución, el tamaño de lote y la latencia que necesita. La opción «mejor» cambia según el grafo.
| Señal de carga de trabajo | Qué priorizar | Qué probar antes de decidirse |
|---|---|---|
| Un flujo de trabajo de una sola imagen | Suficiente VRAM para cada componente activo, más margen | Un prompt representativo a su resolución habitual |
| Varios modelos de control, lotes grandes o etapas de escalado | Más VRAM antes de perseguir rendimiento de cómputo bruto | Comportamiento de memoria máxima y tiempo de ejecución de extremo a extremo |
| Grafos de vídeo, de varias etapas o con muchos modelos | Almacenamiento persistente, carga rápida y un plan de reinicio | Tiempo de carga de modelos, uso de disco temporal y manejo de salidas |
| Sesiones repetidas de equipo | Una imagen/plantilla reutilizable y controles de acceso claros | Tiempo de reconstrucción desde una instancia limpia usando el mismo volumen |
No se base en la cifra de VRAM de otro creador como garantía. Es posible que su checkpoint, cuantización, versiones de nodos, resolución y configuración de lote no coincidan con las suyas. Una prueba representativa de 10 minutos es más útil que una recomendación de hardware excesivamente simplificada.
7. Calcule el costo a partir del trabajo completado, no de la tarifa horaria de la GPU
La cotización de una GPU en la nube es solo una parte del total. Use esta hoja de cálculo para cada flujo de trabajo o proyecto:
Session cost
  = (GPU runtime × current provider compute rate)
  + retained storage for the billing period
  + applicable transfer, snapshot, or platform charges

Cost per accepted output
  = session cost / number of outputs you actually keep
El segundo número suele ser más útil que el costo por imagen generada. Si ejecuta 200 pruebas rápidas y conserva cinco resultados, el costo por resultado aceptado le dice más sobre el flujo de trabajo que la cifra nominal por imagen.
Use estos controles prácticos para una GPU en la nube con ComfyUI:
- Establezca el hábito de apagarla. Decida quién detiene la GPU y cuándo. No la deje funcionando porque haya una pestaña del navegador abierta.
- Separe los datos persistentes de los desechables. Mantenga los modelos, flujos de trabajo, entradas y resultados en almacenamiento duradero; evite pagar por conservar archivos temporales por accidente.
- Pruebe en pequeño antes de escalar. Valide un grafo con una resolución y tamaño de lote moderados antes de comprometerse con una ejecución larga de imágenes o video.
- Mantenga un manifiesto de modelos. Registre qué está instalado y por qué. Evita descargas duplicadas y hace que la limpieza sea más segura.
- Revise la factura en estado detenido. El almacenamiento, las instantáneas, las IP públicas y las reglas de transferencia de datos dependen del proveedor; confírmelos en la interfaz de facturación y la documentación actuales.
- Capture datos de tiempo de ejecución. Para un flujo de trabajo repetido, anote el tiempo de ejecución, los reintentos, los resultados aceptados y los tamaños de entrada/salida. Esto crea una base real para el presupuesto.
Para un marco de decisión más general, lea Precios de alquiler de GPU explicados. Explica la diferencia entre una tarifa horaria atractiva y el costo del trabajo completado.
8. Cuándo una GPU en la nube es la abstracción equivocada
ComfyUI es valioso cuando necesita control a nivel de nodos, archivos de modelos locales, procesamiento personalizado, iteración visual o un grafo específico. No es automáticamente la forma más sencilla de implementar una función de IA.
Si la necesidad del producto es una llamada a un modelo alojado en lugar de control a nivel de flujo de trabajo, compare por separado una ruta de modelo administrado/API. Flatkey proporciona una interfaz unificada para llamadas a API de modelos y herramientas; esto puede reducir la fragmentación de integración y facturación, pero no sustituye a ComfyUI cuando su requisito es un grafo de nodos persistente con activos locales personalizados. Establezca explícitamente ese límite antes de optimizar la pila equivocada.
Lista de verificación previa
Antes de iniciar una sesión de ComfyUI con una GPU en la nube, confirme todo lo siguiente:
- [ ] El almacenamiento persistente está conectado y montado donde espera.
- [ ] Las rutas de modelos, flujos de trabajo, entradas y resultados apuntan a ese almacenamiento.
- [ ] La combinación actual de GPU/PyTorch se ha validado con un grafo real.
- [ ] El acceso remoto está autenticado; no hay un puerto público sin autenticación expuesto.
- [ ] Se registrarán el JSON del flujo de trabajo, la revisión del modelo y los cambios de nodos personalizados.
- [ ] Sabe qué sigue facturándose después de que la GPU se detiene.
- [ ] Un responsable designado detendrá el cómputo después de la sesión.
Preguntas frecuentes
¿Cómo ejecuto ComfyUI en una GPU en la nube?
Implemente una máquina GPU interactiva con un volumen persistente, instale ComfyUI conforme a las instrucciones actuales del proyecto original, dirija las rutas de modelos/entrada/salida de ComfyUI al almacenamiento montado, mantenga privado el acceso desde el navegador y pruebe un flujo de trabajo representativo antes de escalar.
¿Qué debo almacenar de forma persistente para ComfyUI?
Almacene modelos reutilizables, flujos de trabajo, recursos de entrada que volverá a necesitar, resultados finales, notas sobre nodos personalizados y un pequeño registro de ejecuciones. Trate por separado las cachés temporales y los entornos que pueden reconstruirse, a menos que conservarlos justifique el costo de almacenamiento.
¿Es necesario un escritorio seguro de GPU en la nube para ComfyUI?
Es una opción práctica cuando desea un navegador y una terminal interactivos sin publicar ComfyUI directamente en internet. Use un escritorio remoto, túnel o proxy autenticado, y mantenga la aplicación privada de forma predeterminada.
¿Qué GPU en la nube es mejor para ComfyUI?
Elija según la demanda de VRAM, el objetivo de tiempo de ejecución y las necesidades de almacenamiento/acceso de su flujo de trabajo real. Pruebe primero el grafo previsto; una GPU que funciona para el checkpoint y la resolución de otra persona podría no ser adecuada para los suyos.
¿Qué debe incluir un servicio de GPU en la nube para ComfyUI?
Como mínimo: un entorno de GPU compatible, almacenamiento persistente, acceso de red controlado, una forma de inspeccionar registros y una información de facturación clara tanto para los recursos en ejecución como para los detenidos.
Referencias oficiales utilizadas en esta guía
- Instalación manual de ComfyUI y guía sobre directorios de modelos
- Indicadores de inicio de ComfyUI
- Definiciones de argumentos de CLI de ComfyUI
- Guía de RunPod para conservar datos de contenedores — utilizada como ejemplo concreto de almacenamiento, no como comparación de plataformas
La configuración duradera no es complicada: mantén la GPU reemplazable, conserva el trabajo persistente, mantén el acceso privado e incorpora la detención del cómputo como parte del flujo de trabajo.