
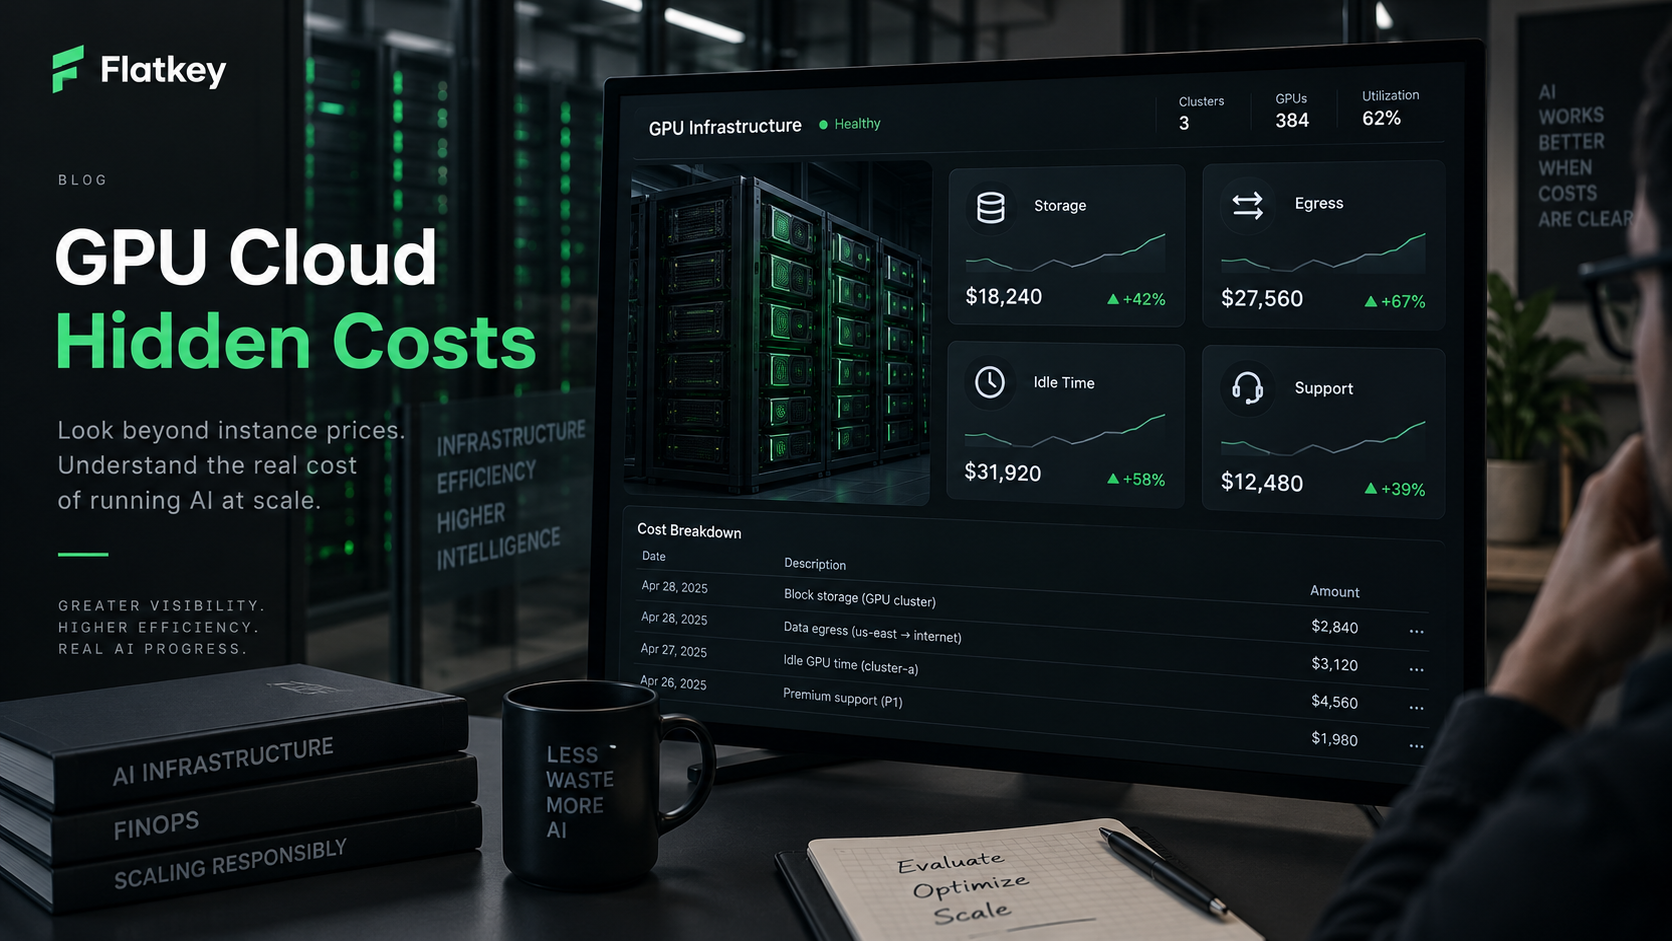
Quais são os custos ocultos dos serviços de GPU na nuvem? A resposta curta é que a tarifa horária da GPU é apenas a linha de partida. A conta real também inclui armazenamento, snapshots, largura de banda de saída, notebooks ou pods ociosos, cold starts, jobs com falha, planos de suporte, redes privadas, monitoramento e o trabalho de engenharia necessário para manter a capacidade de GPU útil.
Para equipes empresariais de IA, os custos ocultos de GPU na nuvem geralmente aparecem após o primeiro benchmark bem-sucedido. A equipe vê um preço horário razoável de H100, H200, A100, L40S ou RTX, começa a mover modelos e dados e então descobre que a fatura é moldada por tudo ao redor do acelerador. Uma GPU mais barata pode perder se ficar ociosa, recarregar os pesos do modelo repetidamente, mover terabytes entre regiões ou precisar de um nível de suporte que não estava no orçamento original.
Este guia oferece às equipes de engenharia de plataforma, FinOps, compras e produto de IA uma forma prática de auditar o custo de GPU na nuvem antes de assinar um contrato de aluguel, capacidade reservada ou cluster dedicado.
A regra útil é simples:
custo real de GPU na nuvem =
  computação da GPU
  + armazenamento
  + egress e rede
  + tempo ocioso
  + desperdício por reinicialização e falhas
  + suporte
  + sobrecarga operacional
Se você comparar provedores apenas pelo item da GPU, não estará comparando o custo de um sistema de IA funcional.
Custos ocultos de GPU na nuvem: a resposta rápida
Comece toda análise de custos ocultos de GPU na nuvem com esta tabela.
| Custo oculto | Como aparece | Controle a exigir |
|---|---|---|
| Armazenamento | Volumes persistentes, discos em bloco, armazenamento de objetos, snapshots, caches de modelo, conjuntos de dados, checkpoints | Separe dados temporários e duráveis; rotule volumes; expire snapshots não usados; mantenha os pesos do modelo perto das GPUs. |
| Egress | Transferência para a internet, movimentação entre regiões, tráfego de IP público, dados saindo do armazenamento de objetos, downloads de resultados | Mantenha dados, GPUs e armazenamento na mesma região; reserve orçamento para transferência de saída; evite downloads repetidos de artefatos. |
| Tempo ocioso | Pods, notebooks, endpoints ou nós reservados em execução sem trabalho útil de GPU | Desligamento automático de recursos ociosos; agende jobs por filas; alerte sobre baixa utilização da GPU e experimentos de longa duração. |
| Cold starts | Download de contêineres, carregamento de pesos de modelo, aquecimento de kernels, montagem de volumes antes de começar o trabalho útil | Pré-construa imagens; armazene pesos em cache; meça o tempo de inicialização como tempo faturável. |
| Jobs com falha | Falhas por falta de memória, incompatibilidades de driver, preempções, hosts defeituosos, implantações quebradas | Execute canários; faça checkpoint; use IDs de job idempotentes; acompanhe o custo de falhas como uma linha do orçamento. |
| Suporte | Planos de suporte pagos, taxas de serviço gerenciado, suporte a cluster privado, cobertura de SLA, ajuda na migração | Pergunte quais termos de suporte estão incluídos no orçamento e quais são custos mensais separados. |
| Rede | Balanceadores de carga, NAT, links privados, IPs públicos, tráfego entre zonas, prêmios de InfiniBand ou RoCE | Adapte a malha de rede à carga de trabalho em vez de aceitar uma cotação genérica por hora de GPU. |
| Operações | Monitoramento, logs, trabalho do scheduler, patches de segurança, incidentes de cluster, conciliação financeira | Conte as horas de engenharia de plataforma no mesmo modelo de TCO da fatura do provedor. |
Para uma revisão inicial de compra, faça uma pergunta: quais são os custos ocultos dos serviços de GPU na nuvem depois que a GPU já está em execução? A resposta raramente é uma única taxa surpresa. Normalmente é um conjunto de componentes comuns da nuvem que se tornam caros porque as cargas de trabalho de IA movem grandes artefatos e desperdiçam tempo caro de acelerador quando a orquestração é fraca.
Por que a hora de GPU listada é incompleta
Uma hora de GPU na nuvem é uma unidade de capacidade. Não é um treinamento concluído, uma resposta de inferência aceita, um vídeo gerado ou um lote de avaliação bem-sucedido.
Essa distinção importa porque as cargas de trabalho de GPU geralmente têm alto custo ao redor:
- Os pesos do modelo podem ter dezenas ou centenas de gigabytes.
- Conjuntos de dados de fine-tuning e checkpoints podem persistir muito tempo depois do fim do job.
- Endpoints de inferência podem precisar de capacidade quente para latência, mesmo quando o volume de requisições é irregular.
- Treinamento multinó pode falhar se um worker, link de rede ou montagem de armazenamento se comportar mal.
- Capacidade de marketplace ou spot pode ser mais barata, mas precisa de controles de reinicialização e de trabalho duplicado.
O denominador melhor é:
custo por carga de trabalho concluída =
  custo total da GPU na nuvem
  / execuções concluídas, saídas aceitas, tokens aceitos, imagens, clipes ou registros aceitos
Essa é a mesma lógica por trás do guia mais amplo da Flatkey sobre GPU cloud vs model API. Se o negócio precisa de resultados do modelo, compare o custo por saída aceita. Se o negócio realmente precisa de controle de hardware, compare todas as opções de GPU pelo custo da carga de trabalho concluída.
Custo oculto 1: armazenamento, snapshots e artefatos de modelo
Armazenamento é o primeiro custo oculto dos serviços de GPU na nuvem porque as equipes de IA precisam de dados próximos ao processamento. O item pode incluir:
- Discos em bloco persistentes ou volumes anexados a instâncias de GPU.
- Armazenamento de objetos para conjuntos de dados, prompts, saídas e artefatos de modelo.
- Snapshots e backups.
- Sistemas de arquivos de rede ou volumes compartilhados para clusters.
- NVMe local incluído em algumas máquinas, mas perdido quando a instância é destruída.
- Caches de modelo de longa duração que ninguém assume após um experimento.
Para um pequeno benchmark, o armazenamento pode parecer insignificante. Para um LLM de produção, um modelo de visão ou um pipeline de mídia, ele pode se tornar um gasto mensal recorrente. O erro é manter tudo para sempre porque apagar o cache errado do modelo deixaria a próxima execução mais lenta.
Use uma política de três compartimentos:
| Classe de armazenamento | Exemplos | Regra de retenção |
|---|---|---|
| Dados-fonte duráveis | Corpus de treinamento, conjunto de avaliação aprovado, ativos aprovados pelo cliente | Gerenciados pela plataforma de dados; versionados e com backup. |
| Artefatos reutilizáveis de runtime | Pesos de modelo, variantes quantizadas, camadas de contêiner, arquivos de tokenizer | Cache próximo ao processamento; atualizados deliberadamente; não duplicados por experimento. |
| Saídas temporárias | Checkpoints com falha, logs de depuração, volumes temporários, mídia intermediária | Expiram automaticamente, salvo se promovidos explicitamente. |
As páginas do provedor a verificar incluem os preços de AWS EC2 e EBS, os preços de persistent disk e snapshot do Google Cloud, os preços de managed disk da Azure, a documentação de armazenamento e network volume do RunPod, os detalhes de listagem de armazenamento do Vast.ai e as premissas de armazenamento de instância do Lambda Cloud. Trate isso como listas de verificação de fonte, não como tabelas de tarifas a copiar.
Custo oculto 2: egress e transferência de rede
Egress é o custo oculto com maior probabilidade de surpreender equipes que movem dados entre nuvens, regiões ou categorias de provedor. Jobs de GPU geralmente são construídos em torno de entradas grandes e artefatos grandes:
- Conjuntos de dados de treinamento.
- Checkpoints de fine-tuning.
- Saídas de embeddings.
- Imagens e vídeos gerados.
- Traços de avaliação e logs.
- Imagens de contêiner e pesos de modelo.
A cobrança não é apenas "download para a internet". Dependendo do provedor e da arquitetura, você também pode pagar por transferência entre regiões, transferência entre zonas, NAT, balanceadores de carga, IPs públicos, links privados ou serviços de rede gerenciados. Para clusters com vários nós, a malha de rede também é um requisito de desempenho, não apenas uma linha na fatura.
Antes de aprovar o gasto, mapeie o caminho dos dados:
source dataset
  -> object storage
  -> GPU region
  -> scratch or shared storage
  -> inference/training output
  -> evaluation or application region
  -> customer, warehouse, or archive
Depois pergunte:
- O conjunto de dados já está na mesma região da GPU?
- O job fará download repetido dos pesos do modelo para cada worker?
- As saídas geradas estão saindo do provedor ou apenas circulando internamente?
- Um link privado reduz o risco de segurança, mas adiciona custo fixo de rede?
- Logs e traces são exportados entre regiões?
Se o caminho dos dados cruza regiões ou provedores todos os dias, uma taxa horária baixa de GPU pode ser o alvo errado de otimização.
Custo oculto 3: tempo ocioso e baixa utilização
O tempo ocioso é o custo oculto mais direto da nuvem de GPU porque o acelerador é caro esteja ele fazendo trabalho útil ou esperando por uma pessoa, fila, download de imagem, implantação com falha ou carregamento de dados.
Meça dois números separadamente:
billable running time =
  minutes the provider charges for the GPU resource

useful GPU-active time =
  minutes spent doing accepted training, inference, eval, or generation work
Depois calcule:
idle waste share =
  1 - useful GPU-active time / billable running time
Se um notebook roda por 100 horas cobradas e o trabalho útil de GPU acontece por 32 horas, o desperdício oculto por ociosidade é de 68%. Negociar uma taxa de GPU 10% menor não vai resolver isso. Política de auto-stop, empacotamento de filas, agendamento de jobs e tagging de proprietário vão resolver.
Controles úteis:
- Desligar automaticamente notebooks interativos após inatividade.
- Encerrar pods desconectados, endpoints órfãos e experimentos abandonados.
- Exigir tags de proprietário, projeto, ambiente e expiração.
- Rastrear utilização de GPU, utilização de memória, tempo de espera na fila e tempo de execução cobrado em conjunto.
- Mover jobs recorrentes de notebooks para um agendador.
- Gerar alerta quando uma GPU ficar abaixo de um limite de utilização por uma janela definida.
O tempo ocioso também é o principal motivo pelo qual uma API de modelo gerenciado pode superar o aluguel direto de GPU para cargas de inferência incertas. Se a utilização for baixa ou irregular, compare a planilha de GPU com comparação de preços de modelos de IA antes de reservar capacidade.
Custo oculto 4: interrupção, novas tentativas e workloads com falha
Capacidade Spot, interruptível e de marketplace de GPU pode ser útil. Mas também pode transferir o custo da tabela de preços para a lógica de retry.
O modelo de custo deve incluir:
- Expulsões e preempções.
- Downloads repetidos do modelo.
- Trabalho perdido desde o último checkpoint.
- Registros em lote duplicados.
- Fine-tunes com falha.
- Execuções por falta de memória.
- Combinações ruins de driver ou CUDA.
- Atraso na fila quando a capacidade de substituição não está disponível.
Para jobs com possibilidade de retry, use:
effective cost with failures =
  listed compute cost
  * retry amplification factor
Se 1.000 saídas aceitas exigirem 1.180 saídas tentadas após erros, expulsões e verificações de qualidade com falha, o fator de amplificação de retries é 1.18x. Esse multiplicador deve ficar na mesma planilha que o preço por hora.
Para uma escolha mais aprofundada entre modelos de precificação, use o guia da Flatkey sobre GPU sob demanda vs. spot. Para este artigo, o ponto principal é mais específico: os custos ocultos não são apenas armazenamento e egress. Trabalho que falha também é trabalho faturável, a menos que o seu fornecedor credite isso explicitamente.
Custo oculto 5: suporte, SLA e escopo de serviço gerenciado
Suporte é fácil de omitir porque muitas vezes aparece fora da cotação da GPU. Equipes corporativas de IA podem precisar de:
- Planos de suporte pagos.
- Compromissos de tempo de resposta.
- Suporte privado por Slack ou suporte de conta.
- Onboarding dedicado de cluster.
- Ajuda de migração.
- Revisão de segurança.
- Documentação de conformidade.
- Suporte gerenciado para Kubernetes, Slurm ou serving de inferência.
- Créditos ou compensações por indisponibilidades do lado do fornecedor.
Suporte não é automaticamente ruim. Ele pode ser mais barato do que perder tempo de lançamento com problemas não resolvidos de capacidade de GPU, driver ou rede. O erro de закупка é comparar a taxa horária de GPU self-service de um fornecedor com a taxa gerenciada ou com suporte de outro como se fossem equivalentes.
Pergunte a cada fornecedor:
| Pergunta | Por que isso importa |
|---|---|
| Qual nível de suporte está incluído nesta cotação? | Evita comparar capacidade com suporte e sem suporte como se fossem o mesmo produto. |
| Qual é a meta de resposta para incidentes em produção? | O valor do suporte depende do timing do incidente, não apenas do acesso a tickets. |
| Falhas do lado do fornecedor são creditadas? | Créditos podem reduzir o desperdício, mas somente se o contrato definir os eventos cobertos. |
| Quem é responsável por problemas de driver, CUDA, imagem e kernel? | O escopo do suporte determina quanto do trabalho de plataforma permanece interno. |
| Há inclusão de migração ou aceitação de benchmark? | Uma cotação horária baixa ainda pode sair cara se o onboarding falhar. |
Para clusters privados e capacidade multinó, o escopo do suporte pode ser tão importante quanto o modelo de GPU.
Custo oculto 6: monitoramento, logs e observabilidade
Cargas de trabalho de GPU precisam de observabilidade além de uma fatura mensal. O custo aparece em dois lugares: nas próprias ferramentas de observabilidade e no tempo de engenharia necessário para transformar métricas em ação.
Acompanhe:
- Utilização da GPU e utilização de memória.
- Latência p50, p95 e p99.
- Tempo de espera na fila e tempo de cold start.
- Tempo de pull do contêiner.
- Tempo de carregamento do modelo.
- Falhas por falta de memória.
- Quantidade de retries e custo de retries.
- Volume de egress.
- Crescimento de armazenamento por projeto.
- Custo por saída aceita.
Logs e traces também podem virar uma linha na conta se forem verbosos, retidos por tempo demais ou exportados para outra região. Mantenha detalhes suficientes para depurar custo e confiabilidade, mas defina a retenção por ambiente. Traces de produção, logs de avaliação e logs de depuração não precisam do mesmo ciclo de vida.
Custo oculto 7: desalinhamento de reserva e lock-in de capacidade
Capacidade reservada de GPU pode reduzir o custo efetivo de computação quando a demanda é real. Ela também pode se tornar uma assinatura de capacidade ociosa.
Use esta fórmula antes de se comprometer:
utilização de ponto de equilíbrio da reserva =
  compromisso mensal reservado
  / custo mensal equivalente sob demanda em uso total
Em seguida, teste a estresse:
- O que acontece se a demanda for 40% menor que a prevista?
- O que acontece se o produto mudar de uma família de modelos para outra?
- O compromisso pode ser convertido de H100 para H200, B200, L40S ou para uma região diferente?
- Armazenamento, egress, suporte e rede estão dentro do compromisso?
- Outras cargas de trabalho internas podem preencher a capacidade base ociosa?
Se a resposta depender de esperança, reserve menos e mantenha a capacidade de burst flexível. Para implantações maiores, combine isso com a planilha de TCO de cluster de GPU.
Planilha de custos ocultos de GPU na nuvem
Use esta planilha nas análises de procurement. Preencha-a para cada fornecedor, cada região e cada modo de produto.
| Campo | O que inserir |
|---|---|
| Fornecedor e modo do produto | Instância sob demanda, pod, VM spot, GPU sem servidor, cluster reservado, host de marketplace, bare metal dedicado. |
| Modelo e quantidade de GPUs | H100, H200, B200, A100, L40S, classe RTX, tamanho da memória, número de GPUs. |
| Região e localização dos dados | Onde os dados começam, onde a GPU executa, para onde os resultados se movem. |
| Unidade de faturamento | Segundo, minuto, hora, mês, prazo contratado, bloco de capacidade, worker de endpoint. |
| Custo de computação de GPU listado | Fonte ou cotação com carimbo de data e hora, com a data verificada. |
| Estimativa de utilização útil | Minutos de GPU ativos esperados divididos pelos minutos cobrados. |
| Estimativa de desperdício ocioso | Tempo faturável esperado não útil. |
| Armazenamento persistente | Volumes, discos, armazenamento de objetos, sistemas de arquivos compartilhados, cache do modelo. |
| Snapshots e backups | Política de retenção, responsável pelo custo, processo de limpeza. |
| Egress e rede | Egress para a internet, movimentação entre regiões, links privados, NAT, balanceadores de carga, IPs públicos. |
| Custo de cold start | Tempo de pull do contêiner, tempo de carregamento do modelo, inicialização do worker. |
| Amplificação de retries | Tentativas falhas divididas pelos resultados aceitos. |
| Suporte e SLA | Suporte incluído, nível de suporte pago, escopo do serviço gerenciado, créditos. |
| Monitoramento e logs | Métricas, traces, exportação de logs, retenção. |
| Overhead de engenharia | Horas da plataforma, resposta a incidentes, manutenção, reconciliação financeira. |
| Denominador da unidade | Saída aceita, execução concluída, token treinado, imagem, clip, registro, GPU-mês. |
| Custo final por unidade | Custo total dividido pelo trabalho útil concluído. |
A planilha deve ser revisada mensalmente para cargas de trabalho de produção e antes de cada renovação de compromisso.
Lista de verificação das fontes do fornecedor
As páginas de preços de GPU e armazenamento mudam com frequência. Não copie números antigos para um caso de negócio. Use as páginas oficiais como uma lista de verificação das fontes e registre a data da verificação ao lado de cada cotação.
| Fornecedor ou fonte | O que verificar |
|---|---|
| preços do AWS EC2, preços do Amazon EBS, preços de transferência de dados da AWS, planos de suporte da AWS | Família da instância de GPU, On-Demand ou Spot, EBS, snapshots, transferência de dados, plano de suporte. |
| preços de GPU do Google Cloud Compute Engine, preços do Persistent Disk, preços de rede da VPC, Cloud Customer Care | Tipo de GPU, família de máquina, região, disco, snapshot, egress, serviço de suporte. |
| preços de Virtual Machines do Azure, preços de discos gerenciados do Azure, preços de largura de banda do Azure, planos de suporte do Azure | SKU de VM de GPU, disco gerenciado, snapshot, largura de banda, plano de suporte, termos de reserva. |
| preços do RunPod e documentação de armazenamento do RunPod | Secure Cloud vs Community Cloud, modo pod ou sem servidor, volumes persistentes, volumes de rede, comportamento ocioso. |
| preços do Vast.ai, FAQ do Vast.ai, e detalhes do anúncio do provedor | Confiabilidade do host de marketplace, disco, largura de banda, IP público, status interruptible, datacenter ou host comunitário. |
| preços de GPU da Lambda Cloud | Tipo de instância, quantidade de GPU, premissas de armazenamento incluído, disponibilidade regional, termos do cluster reservado. |
| FinOps FOCUS | Dimensões comuns de faturamento e linguagem de alocação de custos para equipes de finanças e plataforma. |
| preços do Flatkey, modelos do Flatkey, e Flatkey Compute | Alternativa de API de modelo, um saldo, livro-razão de uso e verificações de fonte atuais do mercado de computação. |
Para este artigo, a lista de verificação das fontes foi revisada em 13 de outubro de 2026. Verifique-a novamente antes de usar qualquer cotação de fornecedor em um memorando de aprovação.
Perguntas de compras antes de aprovar gastos com GPU na nuvem
Use estas perguntas antes de aceitar uma cotação ou iniciar uma migração.
- Quais são os custos ocultos dos serviços de GPU na nuvem nesta cotação, e quais estão fora da cotação?
- Armazenamento, snapshots, object storage e backups estão incluídos ou são separados?
- Quais transferências de dados geram cobranças de egress ou entre regiões?
- Qual é a taxa de ociosidade esperada após lacunas do agendador, tempo de inicialização e depuração humana?
- Como interrupções de spot, falhas de host e incidentes do lado do provedor são creditados?
- Qual plano de suporte é necessário para tempos de resposta em produção?
- Quem é responsável por problemas de CUDA, driver, imagem, kernel e serving stack?
- Quais métricas comprovarão uso eficiente após o lançamento?
- Qual é o caminho de saída se a escolha do modelo mudar?
- Uma API de modelo gerenciada ou um caminho híbrido pode produzir a mesma saída aceita com menos capacidade ociosa?
A última pergunta não é um atalho de vendas. É um controle de TCO. Se a carga de trabalho não exigir controle de hardware, o aluguel de GPU é apenas uma forma possível de comprar saídas de modelo.
Quando a Flatkey entra na comparação
A Flatkey não substitui todos os clusters de GPU. As equipes ainda precisam de capacidade de GPU na nuvem para treinamento personalizado, modelos open-weight auto-hospedados, kernels especializados, clusters privados e infraestrutura rigidamente controlada.
A Flatkey entra na comparação quando a carga de trabalho é realmente sobre consumir resultados de modelo:
- O produto precisa de muitos modelos oficiais em vez de um único modelo auto-hospedado.
- A demanda é incerta, em picos ou sazonal.
- O financeiro quer um único saldo, uma única fatura e um livro-razão de uso.
- A engenharia quer acesso a modelos sem chaves de provedores espalhadas.
- A equipe quer comparar o custo da API do modelo antes de alugar ou reservar GPUs.
Nesse caminho, a Flatkey oferece às equipes uma única chave de API, um único saldo e uma única fatura em rotas e ferramentas oficiais de modelos. Se a planilha de custos ocultos mostrar que armazenamento, egress, tempo ocioso e suporte eliminam a vantagem do custo por hora de GPU, compare o caminho da API gerenciada antes de se comprometer com hardware.
Comece com os guias preços de aluguel de GPU, GPU na nuvem vs API de modelo, TCO de cluster de GPU e gestão de gastos com API de IA para a decisão mais ampla.
Recomendação final
Quando alguém perguntar quais são os custos ocultos dos serviços de GPU na nuvem, não responda com uma única taxa. Responda com uma planilha.
- Comece com o preço por hora da GPU.
- Some armazenamento, snapshots, egress, rede, suporte, observabilidade e operações.
- Não subtraia nada até que um crédito do provedor esteja escrito no contrato.
- Divida pelo trabalho concluído, não pelas horas faturáveis.
- Rerodele o modelo sob menor utilização, maior taxa de retry e mudança de escolha de modelo.
Os serviços de GPU na nuvem podem ser a resposta certa quando a equipe precisa de controle de hardware e consegue manter a capacidade útil. Eles se tornam caros quando o armazenamento cresce silenciosamente, os dados se movem repetidamente, as GPUs ficam ociosas, o suporte está ausente e o trabalho falho é tratado como problema de outra pessoa.
A função do comprador é tornar esses custos visíveis antes que a fatura chegue.


