
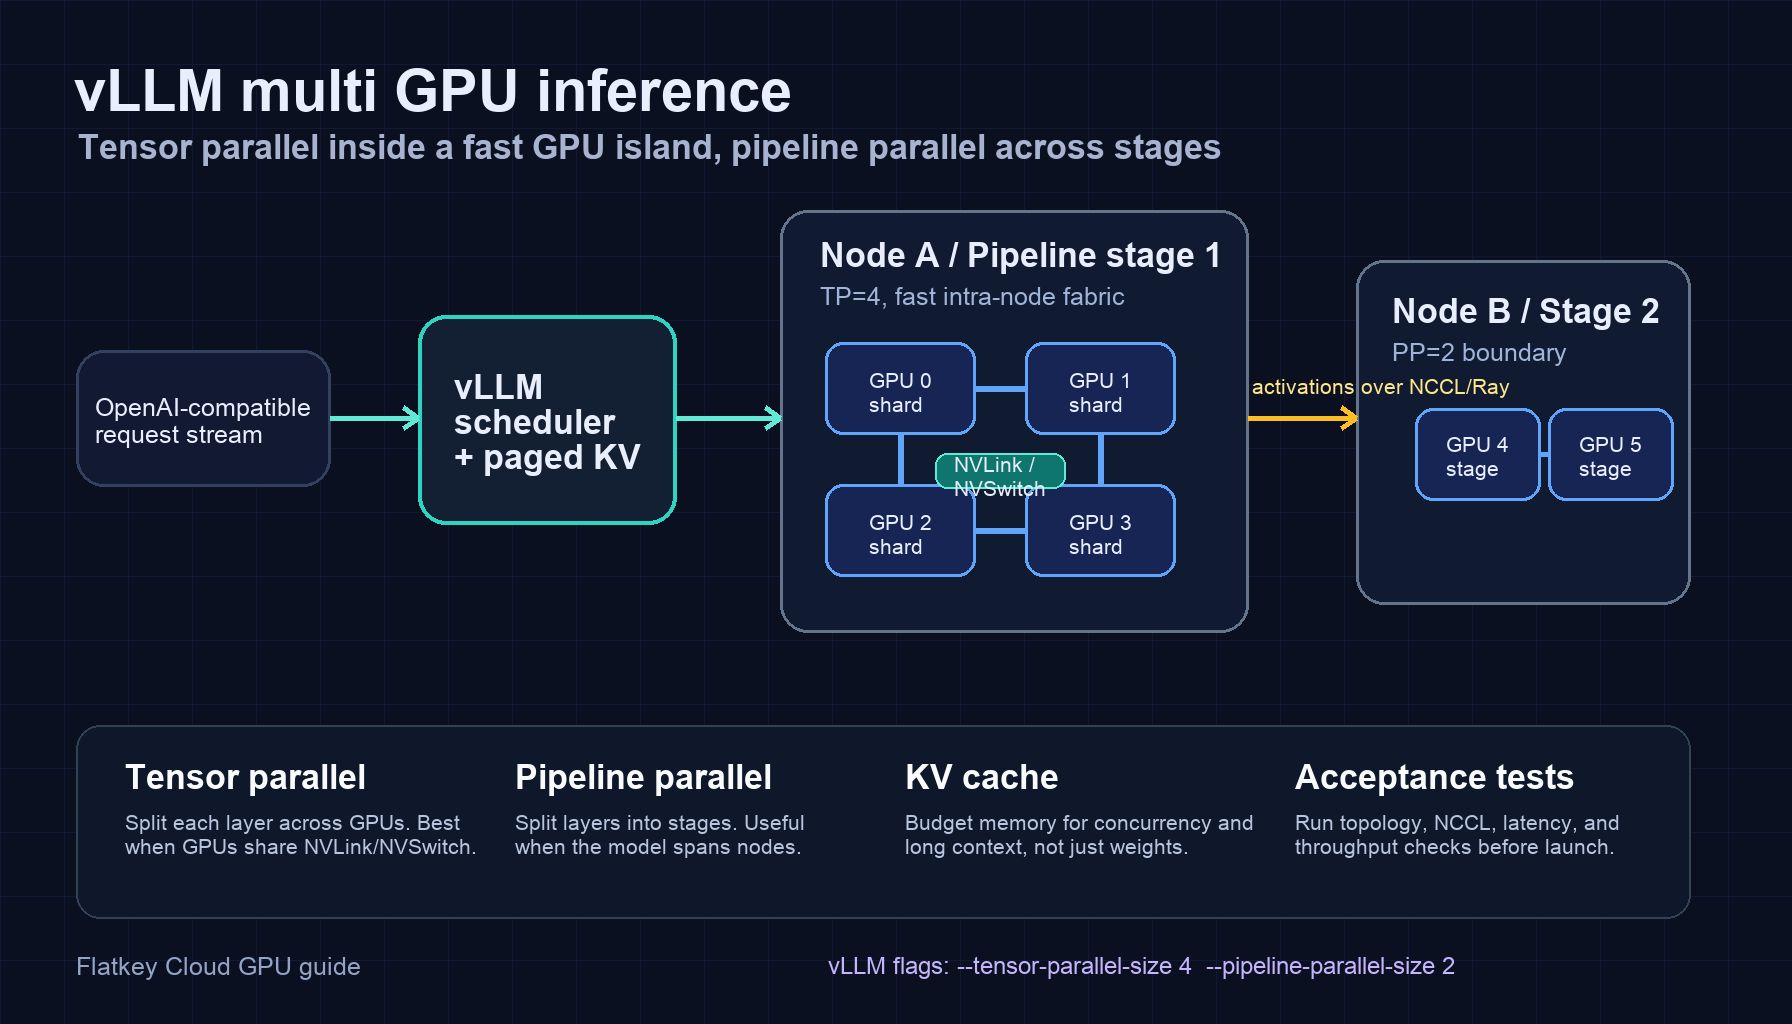
A inferência multi GPU com vLLM geralmente começa por um de três motivos: os pesos do modelo não cabem em uma GPU, o cache KV para o contexto e a concorrência necessários não cabe em uma GPU, ou uma GPU não consegue entregar a meta de tokens por segundo e de tempo até o primeiro token de que você precisa. A configuração não é apenas uma decisão de --tensor-parallel-size. Você também precisa alinhar o paralelismo tensorial, o paralelismo de pipeline, o backend do executor e a topologia física das GPUs.
A versão curta:
- Use paralelismo tensorial primeiro quando o modelo couber em GPUs dentro da mesma ilha rápida de GPUs, especialmente um nó H100/H200/B200 de 8 GPUs com NVLink ou NVSwitch.
- Adicione paralelismo de pipeline quando o modelo precisar abranger vários nós ou quando o paralelismo tensorial sozinho criar comunicação entre nós em excesso.
- Considere
tp * ppcomo o número de workers de GPU usados por uma réplica do vLLM. - Faça benchmarking com o comprimento real do prompt, o comprimento da saída, a forma do batch e a quantização do modelo antes de considerar a configuração pronta para produção.
- Se sua equipe só precisa de um endpoint compatível com a OpenAI e não de controle direto do hardware, compare o caminho com GPU com uma linha de base de modelo/API gerenciada, como Flatkey, antes de alugar e operar um cluster.
Este guia traz um exemplo prático de inferência multi GPU com vLLM, um diagrama de arquitetura, comandos de inicialização e as verificações que normalmente identificam configurações multi-GPU ruins antes dos usuários.
Arquitetura de inferência multi-GPU com vLLM
No vLLM, o paralelismo tensorial divide o trabalho de cada camada do transformer entre vários workers de GPU. O paralelismo de pipeline divide as camadas do modelo em estágios, para que diferentes grupos de GPU executem partes diferentes do modelo. Para serving em produção, essas escolhas afetam mais do que a memória: elas mudam a comunicação coletiva, o agendamento de requisições, o raio de impacto de falhas e se a rede de escala horizontal se torna o gargalo.
Uma arquitetura inicial comum é:
| Camada | Escolha prática | Por que isso importa |
|---|---|---|
| Superfície da API | vllm serve com o servidor compatível com a OpenAI |
Permite que as equipes de aplicação mantenham clientes no estilo OpenAI enquanto trocam o backend de serving. |
| Grupo de paralelismo tensorial | Um nó ou uma ilha NVLink/NVSwitch | Camadas com paralelismo tensorial se comunicam com frequência, então links lentos entre nós prejudicam rapidamente. |
| Estágios de pipeline | Divisão no nível do nó ou do rack quando o modelo não cabe em um único nó | O paralelismo de pipeline pode reduzir a quantidade de comunicação entre nós em comparação com colocar um grupo tensor-parallel em todas as GPUs. |
| Backend distribuído | Multiprocessamento para um nó, Ray quando você precisa de orquestração multi-nó | Mantenha o serving em nó único simples; use Ray quando os workers precisarem abranger máquinas. |
| Plano de cache KV | Dimensione para comprimento do prompt, comprimento da saída e concorrência | Os pesos são apenas o ponto de partida; o serving de contexto longo pode ser limitado pelo cache KV. |
| Teste de aceitação | Topologia, NCCL, carregamento a frio, TTFT, throughput e reinício após falha | A maioria das implantações ruins parece funcionar bem até que tráfego realista chegue. |
Para uma visão adjacente da infraestrutura, veja o guia de arquitetura de cluster de GPU. Para dimensionamento de memória, use a planilha de requisitos de memória de GPU para LLM assim que ela estiver disponível.
Paralelismo tensorial vs paralelismo de pipeline no vLLM
A regra de decisão mais útil é simples:
Use paralelismo tensorial dentro de uma ilha rápida de GPUs. Use paralelismo de pipeline para atravessar limites mais lentos.
O paralelismo tensorial é uma boa primeira medida quando:
- o modelo é grande demais para uma GPU, mas cabe em 2, 4 ou 8 GPUs em um único nó;
- seu nó de GPU tem links GPU-para-GPU de alta largura de banda;
- a latência importa e você quer que cada requisição percorra uma única réplica lógica do modelo sem uma longa bolha de pipeline;
- a família do modelo é bem suportada pela execução de paralelismo tensorial do vLLM.
O paralelismo de pipeline se torna útil quando:
- o modelo não cabe em um único nó mesmo após quantização ou precisão menor;
- um grupo tensor-parallel, de outra forma, cruzaria Ethernet ou InfiniBand com muita frequência;
- você quer que cada nó seja dono de um estágio do modelo, em vez de cada camada participar de coletivos entre nós;
- você consegue tolerar o overhead de agendamento e de bolha que acompanha os estágios de pipeline.
Não presuma que tp=8 é sempre melhor que tp=4, ou que pp=2 melhora automaticamente o throughput. Para inferência multi GPU com vLLM, a forma correta depende do tamanho do modelo, da pressão de memória, da interconexão, dos comprimentos de sequência e de quanta concorrência de batch sua carga de trabalho consegue sustentar.
Exemplo de inferência multi-GPU com vLLM em nó único
Comece com um único nó quando puder. É mais fácil de depurar, mais barato de testar e evita rede multi-nó como o primeiro domínio de falha.
Exemplo: um servidor com 4 GPUs, uma réplica do vLLM, tamanho de paralelismo tensorial 4.
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
Use esta configuração quando um modelo couber de forma limpa em quatro GPUs e o nó tiver comunicação GPU-para-GPU rápida. Para um nó com 8 GPUs, teste tanto --tensor-parallel-size 4 quanto --tensor-parallel-size 8; o grupo maior pode melhorar a margem de memória, mas pode adicionar overhead de comunicação.
Teste básico de smoke:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "Give me a one-sentence GPU health check."}],
    "max_tokens": 64
  }'
Se isso falhar, não avance para multi-node ainda. Corrija primeiro o download do modelo, a visibilidade da CUDA, a visibilidade do NCCL, a compatibilidade entre driver e runtime e a pressão de memória da GPU.
Exemplo multi-node com paralelismo tensorial e de pipeline
Quando você precisar de mais GPUs do que um único nó pode fornecer, mantenha o grupo de paralelismo tensorial dentro de cada nó, se possível, e então use paralelismo de pipeline entre os nós.
Formato-alvo de exemplo:
- dois nós;
- quatro GPUs por nó;
- tamanho do paralelismo tensorial 4;
- tamanho do paralelismo de pipeline 2;
- trabalhadores totais:
4 * 2 = 8.
Inicialização conceitual:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
Em um cluster real, inicie o Ray no nó head, junte os nós workers a esse cluster Ray, torne o armazenamento do modelo acessível por todos os nós e confirme que todos os workers veem a contagem de GPUs pretendida antes de iniciar o servidor vLLM. Fixe sua versão exata do vLLM, a imagem CUDA, a branch do driver e a revisão do modelo no runbook para que uma reconstrução posterior não altere o comportamento silenciosamente.
Este é o ponto em que a qualidade da infraestrutura se torna qualidade do produto. Se o segundo nó estiver conectado por uma rede fraca, se o NCCL escolher a interface errada ou se o caminho do cache do modelo for lento, os usuários perceberão isso como variância de latência, cold starts longos ou falhas de requisição.
Escolha do backend: multiprocessing ou Ray
Para suporte de inferência multi-gpu do vLLM, use o backend de executor mais simples que se ajuste à implantação:
| Implantação | Backend sugerido | Observações |
|---|---|---|
| Uma máquina, múltiplas GPUs | Multiprocessing ou o padrão do vLLM para a sua versão | Mais fácil de operar; menos peças móveis. |
| Múltiplas máquinas | Ray | Necessário quando os workers se distribuem entre nós e precisam de coordenação em nível de cluster. |
| Serviço multi-node em Kubernetes | Ray mais planejamento explícito de pod/rede/armazenamento | Torne o agendamento, o posicionamento e as verificações de saúde visíveis em vez de esperar que o processo de serving encontre as GPUs corretas. |
A escolha do backend não deve ser isolada da topologia. Se você precisa do Ray apenas porque o modelo é grande demais para um único servidor, a próxima pergunta é se o paralelismo de pipeline pode manter a maior parte da comunicação de alta frequência dentro de cada nó.
Dimensionamento de memória antes de escolher TP e PP
Um plano de inferência multi gpu do vLLM deve orçar a memória nesta ordem:
- Pesos: parâmetros do modelo após dtype ou quantização.
- KV cache: comprimento do prompt, comprimento da saída, concorrência de batch e dtype do cache.
- Overhead de runtime: CUDA graphs, comportamento do alocador, buffers de comunicação, overhead do tokenizer/servidor e margem de segurança.
- Margem operacional: reinicializações em rolling, recarga do modelo, telemetria e picos ocasionais de prompt.
O paralelismo tensorial distribui os pesos do modelo e parte do trabalho de computação entre as GPUs, mas não torna o tráfego gratuito. O paralelismo de pipeline pode reduzir a pressão de memória por estágio, mas introduz questões de equilíbrio entre estágios. Um estágio de pipeline com mais pressão de memória ou kernels mais lentos se torna o limitador de throughput para toda a réplica.
Escolhas práticas para a primeira tentativa:
| Situação do modelo/runtime | Primeiro formato de TP/PP para testar |
|---|---|
| Modelo 7B ou 8B, contexto comum | tp=1, uma GPU, escale réplicas horizontalmente |
| Modelo 32B, alta concorrência | tp=2 ou tp=4 em um nó |
| Modelo da classe 70B, BF16/FP16 | tp=4 ou tp=8 em um nó de alta memória |
| Modelo denso muito grande distribuído entre nós | tp=4, pp=2 ou tp=8, pp=2, dependendo do tamanho do nó |
| Modelo MoE | Verifique separadamente a orientação de paralelismo de especialistas do vLLM; não trate MoE como um modelo denso por padrão |
A tabela é um ponto de partida, não um resultado de benchmark. O seu custo de saída aceito depende de prompts reais, saídas reais, taxa de retry, comportamento de enfileiramento e aceitação de qualidade.
Verificações de topologia que importam
Antes de publicar um endpoint multi-GPU, colete estes fatos do provedor ou da máquina:
- saída de
nvidia-smi topo -mpara cada nó; - se as GPUs compartilham NVLink ou NVSwitch dentro do nó;
- malha de rede entre nós, incluindo InfiniBand, RoCE, EFA ou Ethernet;
- interfaces visíveis para o NCCL e se o tráfego está usando o caminho pretendido;
- caminho de armazenamento para os pesos do modelo e se múltiplos nós carregam de um disco compartilhado lento;
- memória da GPU, status do MIG, limites de energia e versões de driver/CUDA.
Os sistemas NVIDIA DGX H100/H200, por exemplo, são documentados como sistemas de oito GPUs com conectividade GPU-to-GPU NVSwitch/NVLink e opções de rede de 400 Gb/s. Nós PCIe de commodity ainda podem servir bem ao vLLM, mas você deve esperar um perfil de comunicação diferente e fazer benchmarks de acordo.
Para o contexto de interconexão, veja NVLink vs NVSwitch. Para linguagem de compra de clusters e topologia, o guia de aluguel de cluster GPU é um companheiro útil.
Teste de aceitação em produção
Execute um teste em etapas em vez de um único prompt de caminho feliz.
- Teste de topologia: salve
nvidia-smi topo -m, o inventário de NICs e o ambiente NCCL. - Teste de carregamento a frio: meça o tempo desde a inicialização do contêiner até o primeiro token bem-sucedido.
- Teste de prompt curto: baixo comprimento de prompt, comprimento de saída moderado, carga de trabalho de chat esperada.
- Teste de prompt longo: comprimento de contexto realista próximo ao requisito do seu produto.
- Varredura de concorrência: aumente as requisições concorrentes até que o p95 do tempo até o primeiro token ou a latência p95 entre tokens ultrapasse seu limite.
- Teste com saída intensa: use cargas de trabalho que gerem completions longas, não apenas prompts de classificação.
- Teste de falha: encerre um processo worker ou um nó e verifique se o balanceador de carga remove a réplica.
- Teste de reinício: reinicie o processo do vLLM e confirme que o cache do modelo, o estado do Ray e as verificações de integridade se recuperam corretamente.
Acompanhe pelo menos estas métricas:
| Métrica | Por que isso importa |
|---|---|
| Tempo até o primeiro token | Os usuários percebem isso imediatamente em fluxos de chat e de agentes. |
| Latência entre tokens | Mostra a estabilidade da decodificação depois que a geração começa. |
| Tokens por segundo por réplica | Ajuda a comparar as configurações de TP/PP. |
| Margem de memória da GPU | Prevê se picos de contexto longo causarão OOM. |
| Tempo na fila | Separa a capacidade de serving da latência da aplicação. |
| Taxa de erro e de retry | Converte instabilidade de infraestrutura em custo real. |
| Taxa de saída aceita | Evita otimizar tokens baratos que os usuários rejeitam. |
Padrões de troubleshooting
O modelo carrega, mas a vazão é pior com mais GPUs.
O grupo de TP pode ser grande demais para a topologia, ou o workload pode não ter concorrência suficiente para amortizar a comunicação. Teste um TP menor, mais réplicas ou uma forma diferente de lote/concorrência.
A inicialização multi-nó fica travada.
Verifique a membresia do Ray, as regras de firewall, a seleção da interface NCCL, a rede do contêiner e se cada nó consegue acessar o mesmo caminho do modelo. Não depure isso primeiro pela camada de API.
Uma GPU entra em OOM enquanto as outras ainda têm folga.
Procure por estágios de pipeline desiguais, diferentes SKUs de GPU, fragmentação de memória ou um problema de atribuição de rank. Confirme que cada worker está usando a GPU visível pretendida.
Os picos de latência aumentam com prompts longos.
Pressão no cache KV, custo de prefill e enfileiramento do scheduler são os suspeitos mais prováveis. Teste buckets separados de comprimento de prompt antes de alterar o hardware.
O endpoint funciona em um terminal, mas falha atrás de um balanceador de carga.
Verifique o timeout de streaming, o timeout de inatividade, o path de health-check, os limites do corpo da requisição e se o balanceador de carga envia tráfego para uma réplica antes de o modelo estar aquecido.
Quando não executar inferência multi-GPU do vLLM por conta própria
Executar vLLM é a escolha certa quando você precisa de controle no nível do modelo, pesos privados, kernels personalizados, quantização personalizada ou experimentos no nível de hardware. Não é automaticamente a escolha certa quando a necessidade do negócio é simplesmente "dar ao nosso app uma API confiável compatível com OpenAI".
Antes de alugar um cluster GPU multi-nó, compare o caminho self-hosted com uma abordagem gerenciada de modelo/API:
| Requisito | Self-host do vLLM em GPUs | Base gerenciada de modelo/API |
|---|---|---|
| Pesos personalizados/privados | Excelente aderência | Geralmente não é suficiente |
| Experimentos de hardware | Excelente aderência | Não é o objetivo |
| Integração rápida de produto | Mais trabalho operacional | Excelente aderência |
| Alternância entre múltiplos modelos | Você opera cada stack | Um gateway pode simplificar o acesso |
| Faturamento e visibilidade de uso | Construa ou integre isso | Frequentemente incluído |
| Tratamento de falhas | Você é o responsável | O provedor/gateway trata mais disso |
Flatkey é o ponto de comparação quando você quer uma única chave compatível com OpenAI, um único saldo e acesso a endpoints oficiais de modelos sem operar você mesmo a camada de serving das GPUs. Se o controle direto do hardware não for o requisito do produto, faça benchmark em relação a uma base de modelo/API antes de se comprometer com operações de cluster.
Perguntas frequentes
O vLLM suporta inferência multi-GPU?
Sim. O vLLM suporta inferência multi-GPU por meio de paralelismo tensorial e paralelismo de pipeline, com opções de executor que abrangem serving em um único nó e em múltiplos nós. O caminho exato de suporte depende da sua versão do vLLM, da arquitetura do modelo, da topologia de GPU e do backend de implantação.
Qual é o melhor tamanho de paralelismo tensorial para o vLLM?
O melhor tamanho de paralelismo tensorial é o menor valor de TP que oferece folga de memória e throughput suficientes para o seu workload. Comece com as GPUs de um nó rápido e então compare tp=2, tp=4 ou tp=8 usando comprimentos reais de prompt e de saída.
Quando devo usar paralelismo de pipeline no vLLM?
Use paralelismo de pipeline quando o modelo ou a exigência de KV-cache o obrigarem a ir além de um nó, ou quando manter a comunicação de tensor-parallel dentro de cada nó for melhor do que criar um único grupo de TP entre nós.
Ray é obrigatório para serving multi-GPU do vLLM?
Ray normalmente é a escolha prática para serving multi-nó do vLLM. Para um único nó, um backend de multiprocessamento ou o backend padrão da sua versão do vLLM pode ser mais simples.
Como sei se uma configuração de inferência multi-GPU do vLLM está pronta para produção?
Ela só está pronta para produção depois que verificações de topologia, testes de carga a frio, benchmarks realistas de prompt/concorrência, health checks, testes de reinicialização e o comportamento em caso de falha estiverem documentados. Uma única requisição curl bem-sucedida não é suficiente.


