
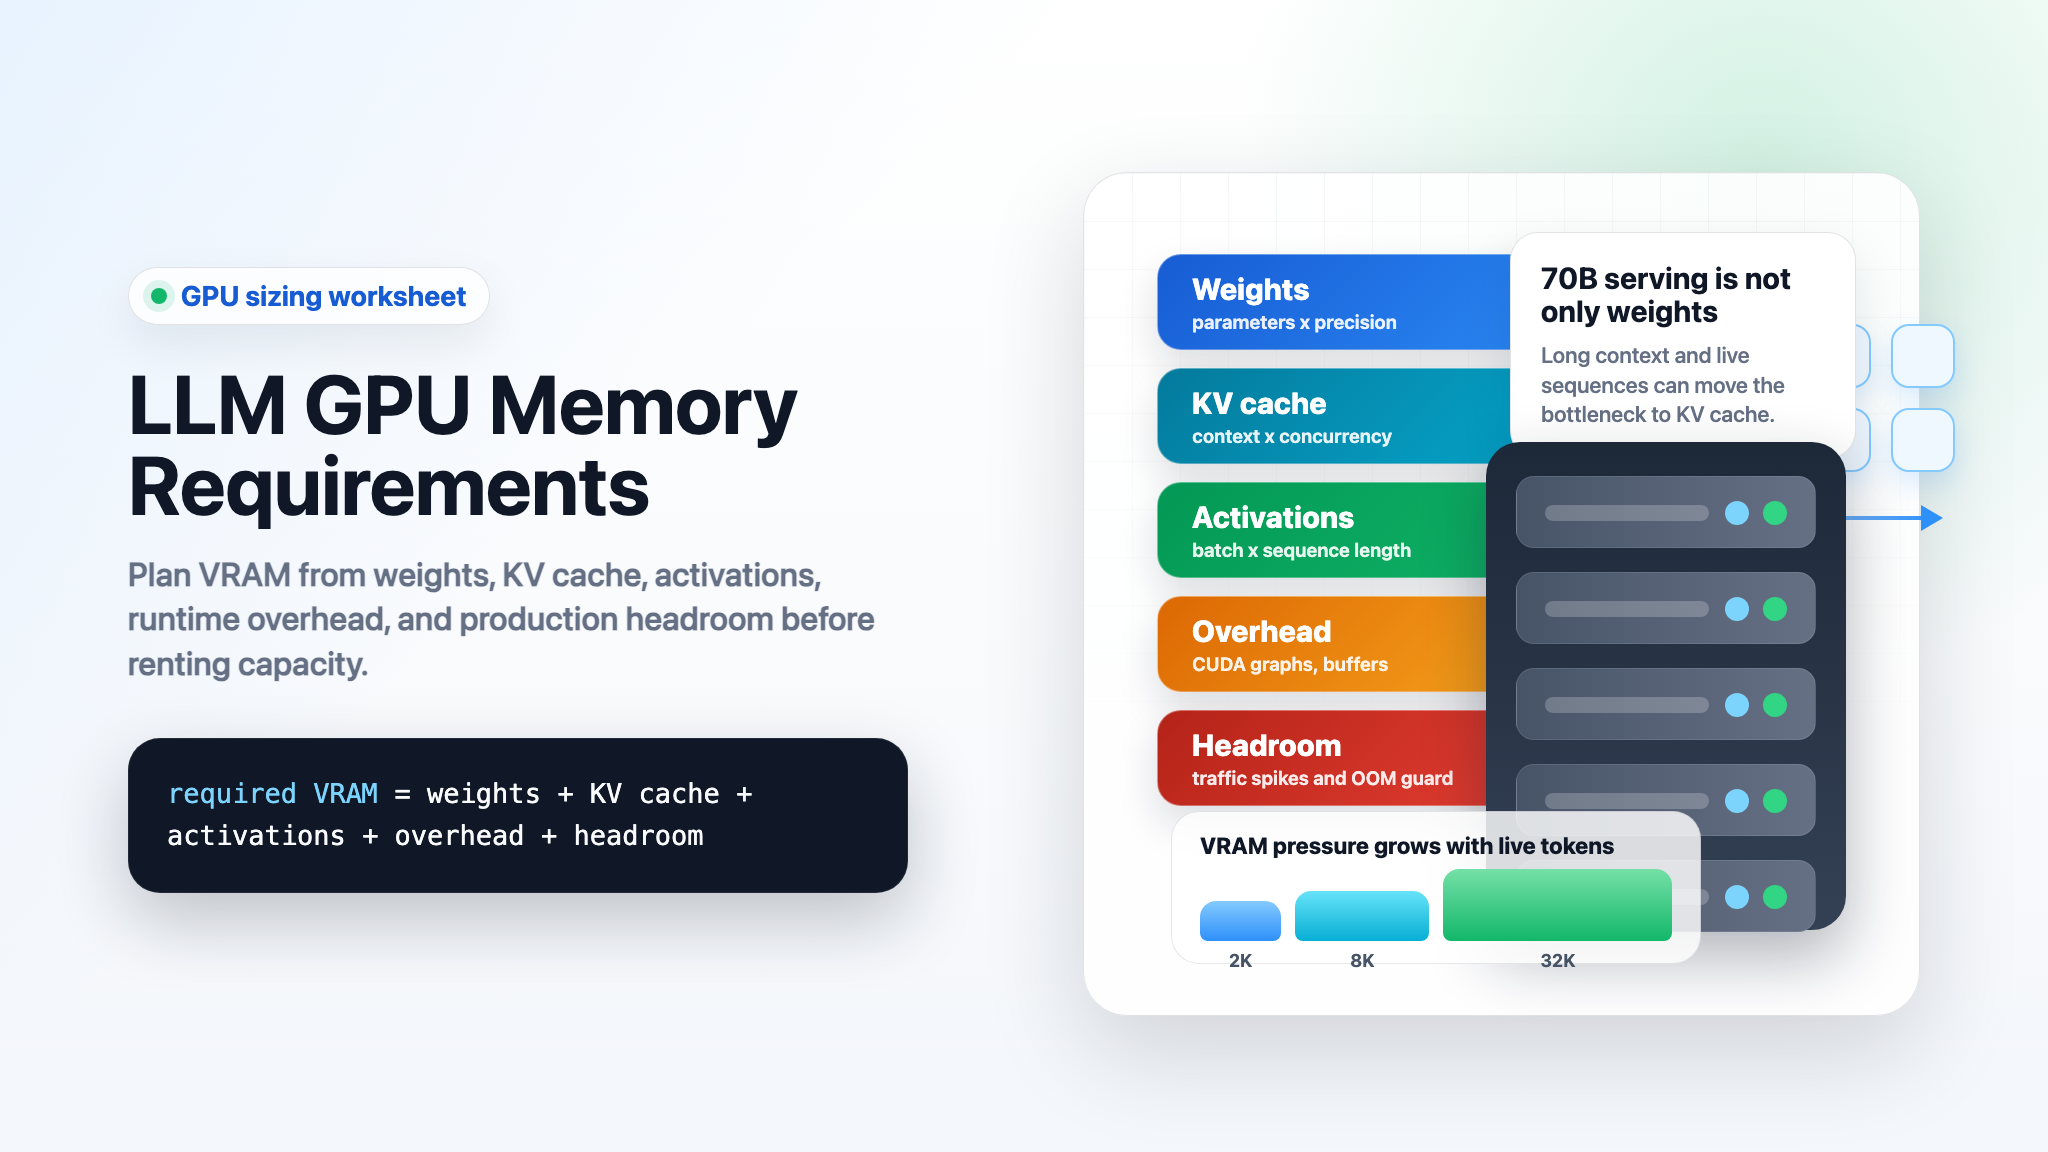
Os requisitos de memória GPU para LLM não são apenas "tamanho do modelo mais um pouco de espaço". Um trabalho de serving ou treinamento tem vários compartimentos de memória separados: pesos do modelo, KV cache, ativações, workspaces do framework, gráficos CUDA, buffers temporários e margem operacional.
A regra rápida de planejamento é esta:
required VRAM =
  model weights
+ KV cache for live tokens
+ activation and workspace memory
+ training state, if training or full fine-tuning
+ allocator and safety headroom
É por isso que duas equipes podem executar o mesmo modelo 70B na mesma classe de GPU e ver resultados diferentes. Uma usa prompts curtos, um stream, KV cache em FP8 e batching conservador. A outra usa contexto longo, muitas requisições concorrentes, captura de gráfico CUDA e uma configuração alta de gpu_memory_utilization. O primeiro trabalho cabe. O segundo falha com erros de out-of-memory ou sacrifica latência ao deslocar trabalho para outros lugares.
Este guia fornece uma planilha prática para llm gpu memory requirements em inferência, serving com vLLM, fine-tuning e treinamento. Use-o antes de alugar uma GPU, escolher capacidade H100 versus H200 versus B200, ou decidir se uma API de modelo é mais simples do que operar seu próprio endpoint de GPU.
Resposta rapida sobre requisitos de memoria GPU para LLM
Para inferência, comece pelos pesos e depois dimensione o KV cache com base no comprimento do contexto e na concorrência. Para treinamento, os pesos são apenas o começo; estados do otimizador, gradientes e ativações salvas dominam o plano de memória.
| Workload | O que geralmente domina a VRAM | Regra rápida de planejamento |
|---|---|---|
| Inferência com uma única requisição | Pesos | parameters x bytes_per_weight, depois adicione KV cache para o prompt e os tokens gerados. |
| Inferência de alto throughput | KV cache e margem do scheduler | Dimensione por concurrent sequences x tokens per sequence, e não apenas pela contagem de parâmetros do modelo. |
| Serving de contexto longo | KV cache | Dobrar o comprimento do contexto aproximadamente dobra a memória do KV cache para o mesmo modelo e batch. |
| Fine-tuning completo | Estados do otimizador, gradientes, ativações | AdamW em precisão mista pode exigir muitas vezes a memória dos pesos do modelo antes das ativações. |
| Tuning LoRA ou adapter | Pesos base mais ativações e estado do adapter | Muito menor do que o fine-tuning completo, mas contexto longo e tamanho do batch ainda importam. |
| Pré-treinamento | Estado de treinamento mais ativações mais overhead distribuído | Planeje com base em uma execução mensurada do framework; fórmulas são apenas a primeira passada. |
Se você só precisa de saídas do modelo, compare primeiro o serving direto em GPU com uma linha de base de API de modelo. GPUs diretas fazem sentido quando você precisa de pesos personalizados, controle de posicionamento, política de runtime privada ou uma carga de trabalho que fica mais barata após medir a utilização. Se você precisa principalmente de respostas de API confiáveis, uma rota de modelo gerenciada pode evitar semanas de dimensionamento de GPU, fila e trabalho operacional.
Planilha de requisitos de memoria GPU para LLM
Use esta planilha antes de escolher uma instância.
| Bucket | Fórmula ou verificação | Observações |
|---|---|---|
| Pesos | parameter_count x weight_bytes |
BF16/FP16 usam cerca de 2 bytes por parâmetro. INT8 usa cerca de 1 byte. 4-bit usa cerca de 0,5 byte antes dos metadados de quantização. |
| KV cache | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
O 2 é para keys e values. A atenção grouped-query reduz kv_heads em relação à atenção multi-head completa. |
| Ativações | Inferência: geralmente modestas. Treinamento: escala com batch, comprimento de sequência, tamanho oculto, camadas e escolhas de checkpointing. | A anatomia de memória do modelo da Hugging Face destaca pesos, estados do otimizador, gradientes, ativações salvas, buffers temporários e memória específica da funcionalidade para treinamento. |
| Reserva do framework de serving | vLLM, TensorRT-LLM, SGLang, PyTorch, gráficos CUDA, kernels de attention, filas de agendamento | O vLLM expõe controles de memória como gpu_memory_utilization, kv_cache_memory_bytes, kv_cache_dtype, max_model_len e max_num_seqs. |
| Margem de segurança | 10-20% para produção, mais durante os primeiros benchmarks | Deixe espaço para fragmentação do alocador, picos de tráfego, prompts mais longos, recargas de modelo e agentes de observabilidade. |
O erro mais comum é acomodar os pesos e esquecer os tokens ativos. Para uma estimativa de requisitos de memória GPU para inferência de LLM, o KV cache pode ser a diferença entre um endpoint estável e um loop de OOM.
Passo 1: calcule a memoria dos pesos do modelo
Os pesos são a parte mais simples dos requisitos de memória GPU para cargas de trabalho de LLM.
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Tamanho do modelo | Pesos BF16 / FP16 | Pesos INT8 | Pesos 4-bit antes dos metadados |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
Esta tabela é um limite inferior. Implementações reais adicionam escalas de quantização, buffers não relacionados a parâmetros, estado do tokenizer/runtime, workspaces temporários e overhead de serving.
Para uma estimativa de vLLM GPU memory requirements 70B model VRAM, apenas os pesos BF16/FP16 já excedem uma única H100 de 80 GB. Uma única H200 tem 141 GB de HBM3e de acordo com a página da H200 da NVIDIA, então os pesos podem caber em princípio, mas o KV cache restante e a margem do runtime ainda podem exigir contexto menor, menor concorrência, quantização de KV cache ou paralelismo tensorial. A NVIDIA lista a H100 SXM com 80 GB, a H200 com 141 GB e a DGX B200 como oito GPUs Blackwell com 1.440 GB totais de HBM3e, o que equivale efetivamente a 180 GB por GPU B200 nesse sistema.
Passo 2: calcule a memória do KV cache para LLM GPU memory requirements
KV cache é a memória usada para armazenar as chaves e valores de atenção dos tokens já processados. Ele permite que o modelo gere sem recomputar todo o prefixo a cada vez.
Para inferência de transformadores apenas decoder:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
Onde:
| Variable | Meaning |
|---|---|
active_tokens |
Soma dos tokens do prompt e gerados atualmente residentes no cache em todas as requisições ativas. |
num_layers |
Contagem de camadas do Transformer. |
num_kv_heads |
Cabeças de KV, nem sempre cabeças de atenção. A atenção grouped-query pode tornar isso muito menor. |
head_dim |
Dimensão por cabeça. |
2 |
Tensor de chave mais tensor de valor. |
bytes_per_kv_element |
2 para BF16/FP16, 1 para FP8, menor para modos de cache de menor bit suportados. |
Como exemplo, uma forma de 70B no estilo Llama com 80 camadas, 8 cabeças de KV e dimensão de cabeça 128 usa:
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes por token
Isso equivale a cerca de 0,3125 MiB por token ativo no KV cache BF16/FP16.
| Contexto ativo por sequência | KV cache aproximado para uma sequência | KV cache aproximado para 16 sequências ativas |
|---|---|---|
| 2.048 tokens | ~0,6 GiB | ~10,0 GiB |
| 4.096 tokens | ~1,3 GiB | ~20,0 GiB |
| 8.192 tokens | ~2,5 GiB | ~40,0 GiB |
| 16.384 tokens | ~5,0 GiB | ~80,0 GiB |
| 32.768 tokens | ~10,0 GiB | ~160,0 GiB |
O número exato muda conforme a arquitetura do modelo. Um modelo com mais cabeças KV usa mais memória KV. Um modelo com atenção multi-query ou grouped-query pode usar muito menos memória KV do que um design de atenção multi-head completo.
O vLLM documenta vários controles importantes aqui: --gpu-memory-utilization controla a fração da memória GPU usada pelo executor do modelo, --kv-cache-memory-bytes pode dimensionar explicitamente o KV cache, --kv-cache-dtype pode selecionar a precisão do cache, e o guia de economia de memória recomenda reduzir max_model_len e max_num_seqs quando a memória está apertada. O vLLM também documenta o KV cache FP8 como uma forma de reduzir a ocupação do KV cache e suportar contexto mais longo ou maior throughput, com validação de precisão ainda necessária.
Passo 3: adicione ativações e overhead de runtime
Na inferência, a memória de ativações geralmente é menor do que pesos e KV cache, mas não é zero. Prefill, gráficos CUDA, kernels de atenção, buffers temporários, processadores multimodais, speculative decoding e agendamento de batches podem reservar memória extra.
No treinamento, a memória de ativações se torna um termo de primeira ordem. A anatomia de memória de modelos da Hugging Face lista os componentes de memória de treinamento como pesos do modelo, estados do otimizador, gradientes, ativações de forward salvas para o cálculo do gradiente, buffers temporários e memória específica da funcionalidade. Ela também observa que a memória de ativações depende do comprimento da sequência, do tamanho oculto e do tamanho do batch.
Uma divisão útil para planejamento é:
| Scenario | Activation and overhead posture |
|---|---|
| Inferência simples, batch 1 | Deixe pelo menos 10% de margem após pesos e KV cache. |
| Serving com vLLM usando gráficos CUDA e batching | Comece com 15-20% de margem e depois ajuste gpu_memory_utilization, max_model_len e max_num_seqs. |
| Serving de contexto longo | Trate o KV cache como a principal variável e reserve mais margem para picos de prefill. |
| Fine-tuning | Meça uma execução pequena no comprimento de sequência alvo antes de escalar; as ativações podem dominar quando batch e contexto aumentam. |
| Modelos multimodais | Adicione cache do processador e memória de entrada de mídia; o guia de economia de memória do vLLM observa controles de cache multimodal e de limite de entrada. |
Não execute produção com 99% de memória só porque uma requisição de teste cabe. Isso não deixa espaço para prompts mais longos, hot reloads, captura de gráficos CUDA, comportamento do alocador ou um mix de tráfego diferente do benchmark.
Passo 4: estime a memória de treinamento e fine-tuning
A memória de treinamento é maior porque a GPU precisa manter mais do que os pesos da passagem forward.
Para o fine-tuning completo com precisão mista e AdamW, a anatomia de memória da Hugging Face oferece uma divisão prática: o treinamento com precisão mista pode manter cópias dos pesos em FP32 e FP16/BF16, estados do otimizador AdamW, gradientes, ativações salvas, buffers temporários e memória específica da funcionalidade. A mesma página resume uma configuração típica de AdamW com precisão mista como 18 bytes por parâmetro do modelo, além da memória de ativação.
Isso significa:
| Tamanho do modelo | 18 bytes por parâmetro antes das ativações |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1,173 GiB |
É por isso que consultas sobre gpu memory requirements LLM training precisam de uma resposta diferente das consultas de inferência. Um modelo 70B que pode ser servido com paralelismo de tensores e cache KV quantizado não é automaticamente viável para fine-tuning completo em um pequeno número de GPUs.
Formas de reduzir a memória de treinamento incluem:
| Técnica | O que ela reduz | Compromisso |
|---|---|---|
| LoRA / QLoRA | Memória de parâmetros treináveis e do otimizador | Não é o mesmo que fine-tuning completo; ainda precisa da memória do modelo base e das ativações. |
| Checkpointing de ativações | Memória de ativações salvas | Mais recomputação e menor throughput de treinamento. |
| ZeRO / FSDP / paralelismo de tensores | Memória por GPU de otimizador, gradiente, parâmetros ou computação | Maior complexidade distribuída e sensibilidade à comunicação. |
| Comprimento de sequência menor | Memória de ativação e de atenção | Pode reduzir a qualidade da tarefa se a carga de trabalho precisar de contexto longo. |
| Micro-batch menor | Memória de ativação | Pode exigir acumulação de gradientes para preservar o tamanho efetivo do batch. |
Para treinamento completo, as fórmulas levam você a uma primeira forma do cluster. Elas não substituem uma execução medida do framework.
Passo 5: mapear os requisitos de memória GPU para LLM aos tamanhos comuns de memória GPU
Use a capacidade de memória da GPU como uma restrição, não como o único critério de compra. Largura de banda de memória, topologia NVLink, rede, armazenamento, agendamento e utilização podem importar tanto quanto a VRAM bruta.
| Classe de GPU | Referência pública de memória | O que isso geralmente significa para os requisitos de memória GPU para LLM |
|---|---|---|
| H100 SXM | 80 GB HBM3 | Base sólida para serving de 7B-34B e muitas tarefas de fine-tuning. BF16 de 70B normalmente precisa de paralelismo de tensores ou quantização. |
| H100 NVL | 94 GB por GPU, 188 GB por par na página da H100 da NVIDIA | Projetada para inferência de LLMs maiores em racks corporativos com restrição de energia; ainda assim, valide a topologia e o SKU do provedor. |
| H200 | 141 GB HBM3e | Mais confortável para pesos de modelos grandes e contextos mais longos do que a H100, mas o serving de 70B com alta concorrência ainda pode ficar limitado pelo cache KV. |
| B200 em DGX B200 | 1,440 GB no total em 8 GPUs | Grande pool de memória para sistemas corporativos de treinamento e inferência, com requisitos operacionais que vão além da especificação de uma única GPU. |
Se sua planilha diz que uma única H200 "just fits" um modelo 70B, isso não é um plano de implantação. É um sinal para fazer benchmark destas configurações:
| Configuração | Por que isso importa |
|---|---|
max_model_len |
Define o limite superior do contexto e, portanto, do cache KV. |
max_num_seqs |
Define o limite superior de sequências concorrentes e da pressão do scheduler. |
kv_cache_dtype |
Pode reduzir a memória do cache KV, mas exige verificações de qualidade. |
| Tamanho do paralelismo de tensores | Divide o trabalho do modelo entre GPUs; também altera as necessidades de comunicação. |
| Formato de quantização | Reduz os pesos e, às vezes, o cache KV; pode afetar a qualidade e o suporte do kernel. |
| Latência alvo de p95 | Configurações com maior throughput podem prejudicar a latência mesmo quando a memória cabe. |
Para detalhes de seleção de hardware, use esta planilha junto com os guias da Flatkey melhor GPU para inferência de LLM, H200 vs H100 e B200 vs H200.
Exemplo: dimensionamento de inferência 70B no vLLM
Aqui está uma forma conservadora de raciocinar sobre vllm gpu memory requirements 70b model vram antes de alugar capacidade.
Assuma:
| Entrada | Valor |
|---|---|
| Pesos do modelo | 70B parâmetros |
| Precisão dos pesos | BF16 / FP16 |
| Memória dos pesos | ~130.4 GiB |
| Forma do cache KV | 80 camadas, 8 cabeças KV, dimensão de cabeça 128 |
| Precisão do KV | BF16 / FP16 |
| KV por token ativo | ~0.3125 MiB |
Em seguida, compare algumas formas de serving:
| Alvo de serving | KV cache aproximado | Por que isso importa |
|---|---|---|
| 1 sequência ativa, 4K tokens | ~1.3 GiB | Os pesos dominam. Uma única GPU de grande memória pode caber apenas com pouca folga. |
| 8 sequências ativas, 4K tokens | ~10.0 GiB | Requer folga real além dos pesos. |
| 16 sequências ativas, 8K tokens | ~40.0 GiB | Um plano de GPU única geralmente é frágil, a menos que os pesos ou o KV cache sejam quantizados. |
| 16 sequências ativas, 16K tokens | ~80.0 GiB | O KV cache sozinho corresponde aproximadamente à memória de uma H100 SXM. |
Na prática, um plano vLLM para 70B geralmente cai em um destes caminhos:
| Caminho | Adequação |
|---|---|
| Pesos BF16, baixa concorrência, contexto mais curto | Memória de classe H200 pode funcionar após verificações de overhead. |
| Pesos BF16, concorrência de produção | Use paralelismo tensorial e verifique a rede/topologia. |
| Pesos quantizados, KV cache BF16/FP16 | Bom primeiro benchmark quando a qualidade permite quantização dos pesos. |
| Pesos quantizados mais KV cache FP8 | Pode liberar contexto mais longo ou mais concorrência, mas precisa de validação de precisão e latência. |
| Sem requisito de controle de hardware | Compare um caminho de API de modelo antes de se comprometer com operações em GPU. |
Esta é a პასუხa prática para requisitos de memória GPU para serving de LLM: a contagem de parâmetros diz se o modelo pode carregar; o KV cache e a reserva de runtime dizem se ele pode atender tráfego útil.
Por que o comprimento do contexto muda a resposta
Contexto longo é caro porque o cache cresce com tokens ativos. Se você dobrar o contexto de 8K para 16K, o KV cache praticamente dobra para o mesmo modelo, precisão e concorrência. Se você dobrar a concorrência no mesmo contexto, o KV cache praticamente dobra de novo.
Para equipes que comparam planos de requisitos de hardware para LLM memória GPU, isso cria um padrão simples de dimensionamento:
mais usuários x prompts mais longos x mais tokens de saída = mais KV cache
Antes de alugar uma GPU maior, pergunte se o produto realmente precisa do contexto máximo para cada requisição. Muitos sistemas podem rotear:
| Tipo de requisição | Política de economia de memória |
|---|---|
| Chat curto ou extração | Limite de contexto menor, maior concorrência. |
| Análise de documentos longos | Limite de contexto maior, pool com menor concorrência. |
| Jobs em lote | Fila por orçamento de tokens, não apenas por contagem de requisições. |
| Cargas de trabalho premium | Pool dedicado com contexto máximo explícito e meta de p95. |
Isso costuma ser mais barato e mais estável do que operar um único endpoint gigante com uma configuração global de memória.
O que medir no primeiro benchmark
Execute um benchmark que se pareça com tráfego de produção, e não com um único prompt de caminho feliz.
| Métrica | Por que ela deve estar no primeiro benchmark |
|---|---|
| VRAM alocada e reservada no pico | Detecta folga do alocador e do framework, e não apenas a matemática dos tensores. |
| Latência de prefill | Prompts longos pressionam a largura de banda de memória e os kernels de atenção. |
| Tokens por segundo no decode | Mostra a taxa de geração em regime permanente. |
| Latência p95 e p99 | Evita que uma configuração otimizada apenas para throughput prejudique os usuários. |
| Taxa de OOM | Acompanha falhas de memória sob mistura real de tráfego. |
| Uso de KV cache | Explica se o gargalo é contexto/concorrência ou os pesos. |
| Custo por saída aceita | Conecta o custo de aluguel da GPU a conclusões utilizáveis, e não a tokens brutos. |
Para implantações multi-node, combine isso com as listas de verificação de arquitetura de cluster GPU e TCO de cluster GPU. Um modelo que cabe na memória ainda pode ser caro se rede, armazenamento, filas ou utilização forem ruins.
Erros comuns
| Erro | Abordagem melhor |
|---|---|
| Dimensionar apenas pela contagem de parâmetros | Adicione KV cache, ativações, reserva do framework e folga. |
| Tratar "cabe uma vez" como pronto para produção | Teste o contexto alvo, a concorrência, o comprimento da saída e o comportamento de retry. |
| Ignorar a precisão do KV cache | Valide FP8 ou outros formatos de cache quando a memória for o gargalo. |
| Usar o nome da GPU do provedor sem o SKU exato | Confirme capacidade de memória, interconexão, política de MIG, stack de driver e se as GPUs são compartilhadas. |
| Assumir que memória de treino é igual à memória de inferência | O treino adiciona estados do otimizador, gradientes, ativações salvas e overhead distribuído. |
Executar gpu_memory_utilization de forma muito agressiva |
Deixe reserva suficiente para CUDA graphs, buffers, picos de tráfego e comportamento do alocador. |
Guia de decisão: alugar GPUs ou usar uma API de modelo?
Capacidade direta de GPU é a direção certa quando você precisa de um ou mais destes:
| Escolha GPUs diretas quando... | Escolha uma API de modelo base quando... |
|---|---|
| Você atende pesos personalizados ou fine-tunes privados. | Você usa modelos hospedados comuns e precisa principalmente de saídas confiáveis. |
| Você precisa de controle de posicionamento, isolamento ou runtime. | Você não quer operar filas, autoscaling, imagens, drivers e falhas de GPU. |
| Sua utilização medida é alta o suficiente para superar a economia da API. | O tráfego é em picos, inicial ou difícil de prever. |
| Você pode assumir benchmarking e resposta a incidentes. | Sua equipe prefere gastar tempo de engenharia na lógica do produto. |
Flatkey é útil como o caminho base quando o controle de hardware não é o requisito do produto. Ele oferece às equipes um equilíbrio entre modelos e ferramentas oficiais, para que você possa comparar o aluguel de GPU com o custo de saída da API do modelo antes de se comprometer com um cluster de longa duração. Se o benchmark provar que GPUs diretas vencem, use a planilha de memória acima para alugar a configuração confiável menor em vez da maior e mais impressionante.
Perguntas frequentes
Quanta memória de GPU um LLM de 70B precisa?
Os pesos BF16 ou FP16 para um modelo de 70B exigem cerca de 130 GiB antes do KV cache e do overhead de runtime. Os pesos INT8 são cerca de 65 GiB antes dos metadados. Os pesos de 4 bits são cerca de 33 GiB antes dos metadados de quantização. Para inferência em produção, adicione KV cache para contexto e concorrência, reserva do framework de serving e margem de segurança.
Por que um modelo carrega, mas falha sob tráfego?
O teste de carga pode caber apenas nos pesos. O tráfego real adiciona KV cache para prompts ativos e tokens gerados, overhead de batching, buffers temporários e reservas do framework. Prompts mais longos e mais sequências concorrentes podem levar o mesmo modelo a OOM.
O que mais afeta os requisitos de memória GPU para inferência de LLM?
As maiores variáveis são tamanho do modelo, precisão dos pesos, comprimento do contexto, sequências concorrentes, precisão do KV cache e configurações do framework de serving. Para serving de contexto longo, o KV cache frequentemente se torna o gargalo.
O que afeta mais os requisitos de hardware de LLM para memória GPU no treinamento?
O treinamento adiciona estados do otimizador, gradientes, ativações salvas, buffers temporários e overhead do framework distribuído. Tamanho do batch, comprimento da sequência, checkpointing de ativações, escolha do otimizador e estratégia de sharding podem alterar drasticamente a contagem de GPUs.
O vLLM reduz os requisitos de memória GPU?
O vLLM oferece controles de memória úteis e gerenciamento eficiente de KV cache, mas não elimina o orçamento de memória subjacente. Você ainda precisa de VRAM suficiente para pesos, KV cache, ativações, reserva de runtime e margem. Seus controles de memória ajudam a escolher o trade-off entre comprimento do contexto, concorrência, precisão e throughput.
O KV cache FP8 pode resolver a pressão de memória de contexto longo?
Ele pode reduzir o tamanho do KV cache, e o vLLM documenta suporte a KV cache FP8. Trate isso como uma configuração de benchmark, não como um botão grátis: valide qualidade de saída, latência, caminhos suportados de hardware/software e comportamento de falha antes de usá-lo em produção.
Checklist final
Antes de alugar capacidade, responda a estas perguntas:
- Qual tamanho de modelo e precisão de pesos você está servindo?
- Qual é o comprimento máximo de contexto que os usuários realmente podem enviar?
- Quantas sequências concorrentes precisam caber na carga p95?
- Que comprimento de saída você reserva para geração?
- O KV cache é BF16/FP16, FP8 ou outro formato suportado?
- Quanto de margem sobra após os pesos e o KV cache?
- Você está usando paralelismo de tensor, quantização, LoRA, FSDP ou ZeRO?
- Qual SKU exato de GPU, capacidade de memória e topologia o provedor alocará?
- Quais limites de OOM, latência e custo por saída aceita definem sucesso?
- Se você não precisa de controle de hardware, qual é o custo base da API do modelo?
A melhor estimativa de requisitos de memória gpu para llm é aquela que sobrevive a um benchmark com formato de produção. Use a planilha para rejeitar rapidamente formas de GPU impossíveis e, em seguida, valide a lista curta com comprimentos de contexto reais, concorrência real e margem suficiente para permanecer online.
Fontes
- Argumentos do mecanismo vLLM:
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtypee controles de cache relacionados: https://docs.vllm.ai/en/latest/configuration/engine_args.html - Guia de economia de memória do vLLM: paralelismo de tensor, quantização, comprimento de contexto, tamanho de batch, memória de CUDA graph e controles de memória multimodal: https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- Guia de KV cache quantizado do vLLM: opções de KV cache FP8 e trade-offs: https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Anatomia de memória de modelos do Hugging Face Transformers: buckets de memória de treinamento, estados do otimizador, gradientes, ativações e notas de memória de precisão mista: https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- Página de produto NVIDIA H100: memória H100, largura de banda, H100 NVL e posicionamento para LLM: https://www.nvidia.com/en-us/data-center/h100/
- Página de produto NVIDIA H200: 141 GB de HBM3e e largura de banda de memória: https://www.nvidia.com/en-us/data-center/h200/
- Página de produto NVIDIA DGX B200: oito GPUs B200 e 1.440 GB de HBM3e total: https://www.nvidia.com/en-us/data-center/dgx-b200/


