
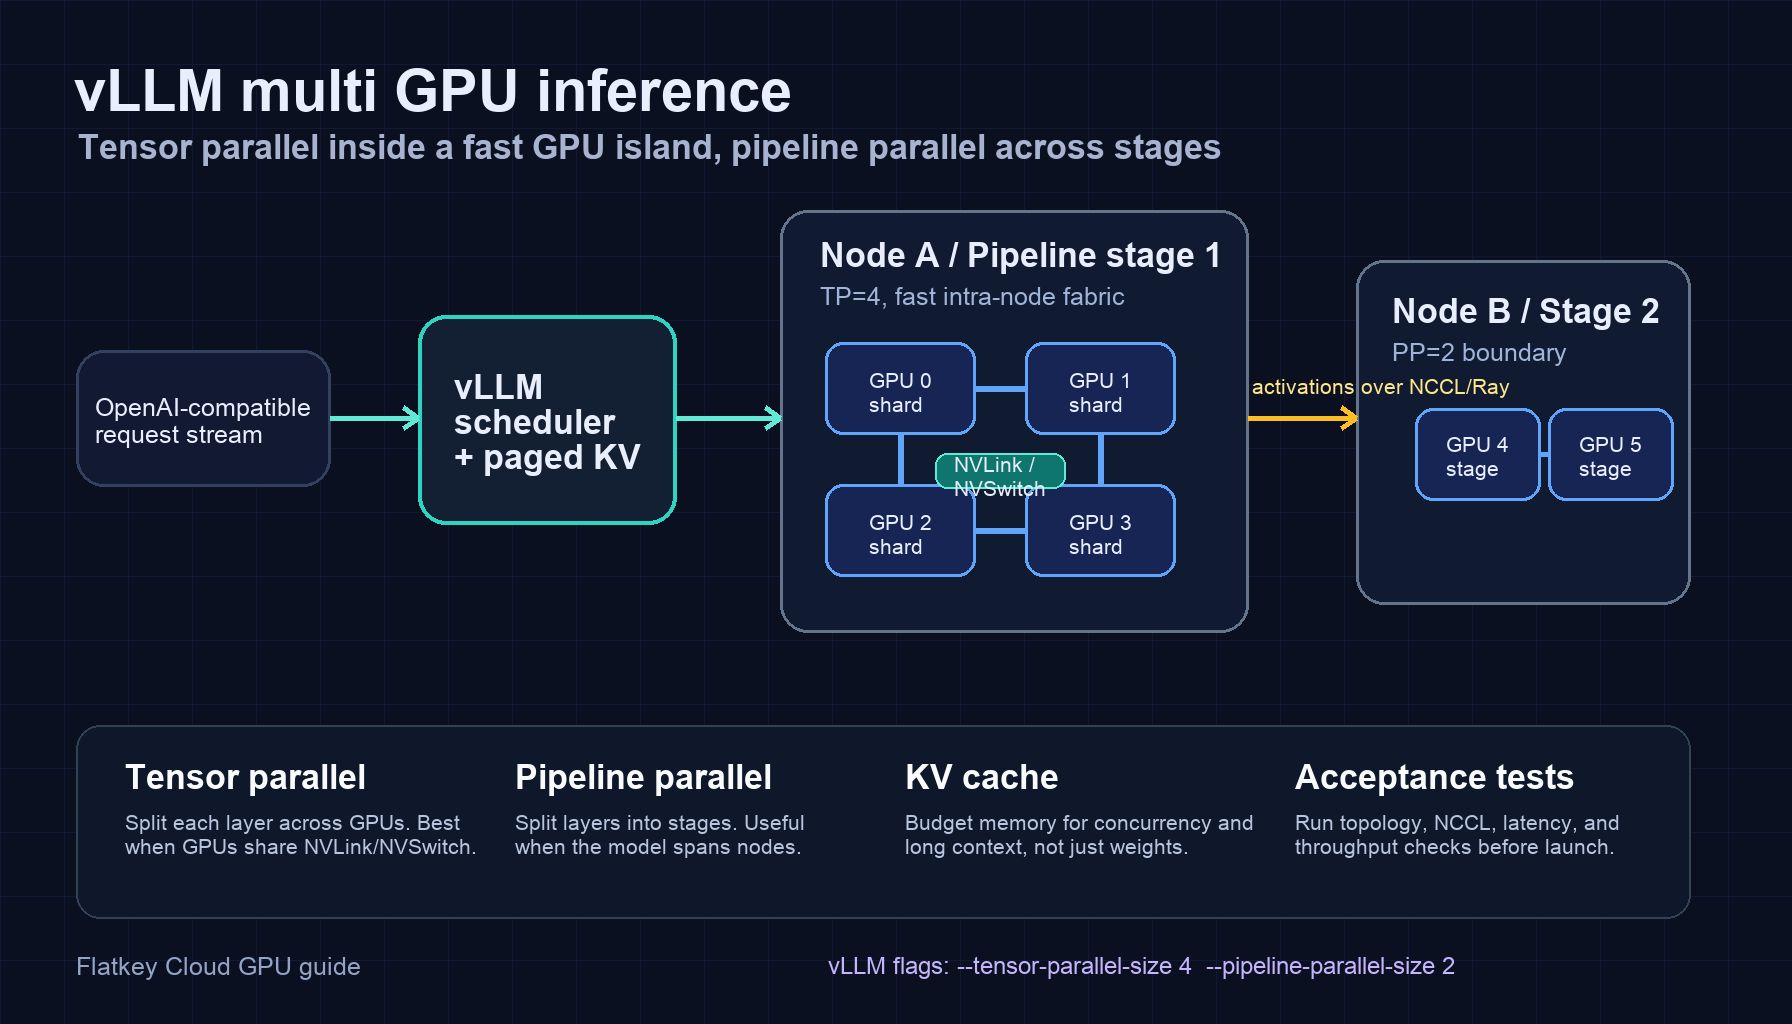
Suy luận đa GPU với vLLM thường bắt đầu vì một trong ba lý do: trọng số mô hình không vừa trên một GPU, KV cache cho ngữ cảnh và mức độ đồng thời yêu cầu không vừa trên một GPU, hoặc một GPU không thể đáp ứng mục tiêu tokens-per-second và time-to-first-token mà bạn cần. Việc thiết lập không chỉ là quyết định --tensor-parallel-size. Bạn cũng cần khớp tensor parallelism, pipeline parallelism, executor backend và topology GPU vật lý.
Bản tóm tắt ngắn:
- Ưu tiên dùng tensor parallelism trước khi mô hình có thể trải trên các GPU trong cùng một GPU island tốc độ cao, đặc biệt là node 8 GPU H100/H200/B200 với NVLink hoặc NVSwitch.
- Thêm pipeline parallelism khi mô hình phải trải qua nhiều node hoặc khi tensor parallel đơn lẻ tạo ra quá nhiều giao tiếp liên node.
- Coi
tp * pplà số GPU worker được dùng bởi một vLLM replica. - Benchmark với độ dài prompt thực tế, độ dài output, hình dạng batch và quantization của mô hình trước khi gọi thiết lập là sẵn sàng cho production.
- Nếu team của bạn chỉ cần một endpoint tương thích OpenAI và không cần điều khiển phần cứng trực tiếp, hãy so sánh đường đi GPU với baseline mô hình/API được quản lý như Flatkey trước khi thuê và vận hành một cluster.
Hướng dẫn này cung cấp một ví dụ thực tế về vLLM multi gpu inference, sơ đồ kiến trúc, lệnh khởi chạy và các kiểm tra thường phát hiện những thiết lập đa GPU sai trước khi người dùng gặp phải.
Kiến trúc vLLM multi GPU inference
Trong vLLM, tensor parallelism chia công việc của mỗi transformer layer trên nhiều GPU worker. Pipeline parallelism chia các layer của mô hình thành các stage, để các nhóm GPU khác nhau chạy các phần khác nhau của mô hình. Với serving production, những lựa chọn đó ảnh hưởng nhiều hơn bộ nhớ: chúng thay đổi collective communication, lập lịch request, phạm vi ảnh hưởng khi lỗi xảy ra và việc mạng mở rộng theo cụm có trở thành nút thắt cổ chai hay không.
Một kiến trúc khởi đầu phổ biến là:
| Layer | Lựa chọn thực tế | Vì sao quan trọng |
|---|---|---|
| Bề mặt API | vllm serve với OpenAI-compatible server |
Cho phép các team ứng dụng giữ client kiểu OpenAI trong khi thay đổi backend serving. |
| Nhóm tensor parallel | Một node hoặc một NVLink/NVSwitch island | Các layer tensor parallel giao tiếp thường xuyên, nên liên kết chậm giữa các node sẽ ảnh hưởng rất nhanh. |
| Pipeline stages | Phân tách ở cấp node hoặc rack khi mô hình không thể vừa trong một node | Pipeline parallelism có thể giảm lượng giao tiếp liên node so với việc đặt một nhóm tensor-parallel trên mọi GPU. |
| Distributed backend | Multiprocessing cho một node, Ray khi bạn cần điều phối đa node | Giữ serving một node đơn giản; dùng Ray khi worker phải trải trên nhiều máy. |
| Kế hoạch KV cache | Dành ngân sách cho độ dài prompt, độ dài output và concurrency | Trọng số chỉ là điểm khởi đầu; serving ngữ cảnh dài có thể bị giới hạn bởi KV cache. |
| Bài kiểm thử chấp nhận | Topology, NCCL, tải lạnh, TTFT, throughput và khởi động lại khi lỗi | Phần lớn các triển khai tệ trông vẫn ổn cho đến khi traffic thực tế xuất hiện. |
Với góc nhìn hạ tầng liên quan, xem GPU cluster architecture guide. Với sizing bộ nhớ, hãy dùng LLM GPU memory requirements worksheet khi nó hoạt động.
Tensor parallel vs pipeline parallel trong vLLM
Quy tắc quyết định hữu ích nhất rất đơn giản:
Dùng tensor parallelism bên trong một GPU island tốc độ cao. Dùng pipeline parallelism để băng qua các ranh giới chậm hơn.
Tensor parallelism là lựa chọn khởi đầu tốt khi:
- mô hình quá lớn cho một GPU, nhưng vừa trên 2, 4 hoặc 8 GPU trong cùng một node;
- node GPU của bạn có liên kết GPU-to-GPU băng thông cao;
- độ trễ quan trọng và bạn muốn mỗi request đi qua một bản sao mô hình logic duy nhất mà không có pipeline bubble dài;
- họ mô hình được vLLM hỗ trợ tốt cho thực thi tensor parallel.
Pipeline parallelism trở nên hữu ích khi:
- mô hình không thể vừa trong một node ngay cả sau quantization hoặc giảm precision;
- một tensor-parallel group nếu không sẽ phải băng qua Ethernet hoặc InfiniBand quá thường xuyên;
- bạn muốn mỗi node sở hữu một stage của mô hình thay vì mọi layer đều tham gia các collective liên node;
- bạn có thể chấp nhận chi phí lập lịch và bubble đi kèm với các pipeline stage.
Đừng cho rằng tp=8 luôn tốt hơn tp=4, hoặc rằng pp=2 tự động cải thiện throughput. Với vLLM multi gpu inference, hình dạng phù hợp phụ thuộc vào kích thước mô hình, áp lực bộ nhớ, interconnect, độ dài chuỗi và mức độ đồng thời batch mà workload của bạn có thể duy trì.
Ví dụ vLLM multi GPU inference trên một node
Bắt đầu với một node khi có thể. Cách này dễ debug hơn, rẻ hơn để benchmark, và tránh mạng đa node như miền lỗi đầu tiên.
Ví dụ: một server 4 GPU, một vLLM replica, tensor parallel size 4.
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
Dùng cấu hình này khi một mô hình vừa gọn trên bốn GPU và node có giao tiếp GPU-to-GPU nhanh. Với node 8 GPU, hãy thử cả --tensor-parallel-size 4 và --tensor-parallel-size 8; nhóm lớn hơn có thể cải thiện headroom bộ nhớ nhưng cũng có thể làm tăng overhead giao tiếp.
Kiểm tra smoke cơ bản:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "Cho tôi một kiểm tra sức khỏe GPU trong một câu."}],
    "max_tokens": 64
  }'
Nếu bước này thất bại, đừng chuyển sang multi-node vội. Hãy sửa trước việc tải model, khả năng hiển thị CUDA, khả năng hiển thị NCCL, tính tương thích giữa driver/runtime và áp lực bộ nhớ GPU.
Ví dụ multi-node với tensor và pipeline parallelism
Khi bạn cần nhiều GPU hơn một node có thể cung cấp, hãy giữ nhóm tensor-parallel trong từng node nếu có thể, rồi dùng pipeline parallelism trải rộng qua nhiều node.
Hình dạng mục tiêu ví dụ:
- hai node;
- bốn GPU mỗi node;
- tensor parallel size 4;
- pipeline parallel size 2;
- tổng workers:
4 * 2 = 8.
Khởi chạy ở mức khái niệm:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
Trong một cụm thực tế, hãy khởi động Ray trên node head, cho các node worker tham gia vào cụm Ray đó, đảm bảo bộ nhớ lưu trữ model có thể được tất cả các node truy cập, và xác nhận rằng tất cả workers nhìn thấy số lượng GPU như mong muốn trước khi khởi chạy server vLLM. Ghim chính xác phiên bản vLLM, image CUDA, nhánh driver và model revision trong runbook để việc rebuild sau này không làm thay đổi hành vi một cách âm thầm.
Đây là lúc chất lượng hạ tầng trở thành chất lượng sản phẩm. Nếu node thứ hai kết nối qua mạng yếu, nếu NCCL chọn sai giao diện, hoặc nếu đường dẫn cache model chậm, người dùng sẽ thấy điều đó dưới dạng độ trễ dao động, cold start dài hoặc lỗi request.
Lựa chọn backend: multiprocessing hay Ray
Đối với hỗ trợ vLLM multi-gpu inference, hãy dùng backend executor đơn giản nhất phù hợp với triển khai:
| Triển khai | Backend được đề xuất | Ghi chú |
|---|---|---|
| Một máy, nhiều GPU | Multiprocessing hoặc mặc định của vLLM cho phiên bản của bạn | Dễ vận hành hơn; ít thành phần chuyển động hơn. |
| Nhiều máy | Ray | Cần thiết khi workers trải rộng qua nhiều node và cần phối hợp ở cấp cụm. |
| Phục vụ multi-node trên Kubernetes | Ray cộng với kế hoạch rõ ràng về pod/network/storage | Làm cho việc lập lịch, placement và health checks trở nên hiển thị thay vì hy vọng tiến trình phục vụ tự tìm đúng GPU. |
Việc chọn backend không nên tách rời khỏi topology. Nếu bạn cần Ray chỉ vì model quá lớn cho một server, câu hỏi tiếp theo là liệu pipeline parallelism có thể giữ hầu hết giao tiếp tần suất cao bên trong từng node hay không.
Định cỡ bộ nhớ trước khi chọn TP và PP
Kế hoạch vLLM multi gpu inference nên phân bổ bộ nhớ theo thứ tự này:
- Weights: tham số model sau dtype hoặc quantization.
- KV cache: độ dài prompt, độ dài output, mức đồng thời của batch, và cache dtype.
- Runtime overhead: CUDA graphs, hành vi của allocator, buffers giao tiếp, overhead của tokenizer/server, và phần dự phòng an toàn.
- Operational headroom: rolling restarts, nạp lại model, telemetry, và các đợt tăng đột biến prompt thỉnh thoảng.
Tensor parallelism phân tán weights của model và một phần tính toán qua các GPU, nhưng nó không làm traffic trở nên miễn phí. Pipeline parallelism có thể giảm áp lực bộ nhớ trên mỗi stage, nhưng nó đặt ra các câu hỏi về cân bằng stage. Một pipeline stage có áp lực bộ nhớ lớn hơn hoặc kernel chậm hơn sẽ trở thành nút thắt throughput cho toàn bộ replica.
Các lựa chọn thực dụng ban đầu:
| Tình huống model/runtime | Dạng TP/PP đầu tiên để thử |
|---|---|
| Model 7B hoặc 8B, context thông thường | tp=1, một GPU, scale replicas theo chiều ngang |
| Model 32B, mức đồng thời cao | tp=2 hoặc tp=4 trên một node |
| Model cỡ 70B, BF16/FP16 | tp=4 hoặc tp=8 trên một node có bộ nhớ lớn |
| Model dense rất lớn trải qua nhiều node | tp=4, pp=2 hoặc tp=8, pp=2, tùy theo kích thước node |
| Model MoE | Kiểm tra riêng hướng dẫn expert-parallel của vLLM; đừng mặc định coi MoE như một model dense |
Bảng này là điểm khởi đầu, không phải kết quả benchmark. Chi phí output được chấp nhận của bạn phụ thuộc vào prompt thực, output thực, tỷ lệ retry, hành vi xếp hàng, và mức chấp nhận về chất lượng.
Các kiểm tra topology quan trọng
Trước khi công bố một endpoint multi-GPU, hãy thu thập các thông tin sau từ nhà cung cấp hoặc từ máy:
- kết quả
nvidia-smi topo -mcho từng node; - liệu các GPU có chia sẻ NVLink hoặc NVSwitch bên trong node hay không;
- fabric mạng giữa các node, bao gồm InfiniBand, RoCE, EFA hoặc Ethernet;
- các interface mà NCCL nhìn thấy và liệu traffic có đang đi theo đường dự kiến hay không;
- đường dẫn lưu trữ cho weights của model và liệu nhiều node có tải từ một đĩa chia sẻ chậm hay không;
- bộ nhớ GPU, trạng thái MIG, giới hạn công suất và các phiên bản driver/CUDA.
Ví dụ, các hệ thống NVIDIA DGX H100/H200 được tài liệu hóa là hệ thống tám GPU với kết nối GPU-to-GPU NVSwitch/NVLink và các tùy chọn mạng 400 Gb/s. Các node PCIe phổ thông vẫn có thể phục vụ vLLM tốt, nhưng bạn nên kỳ vọng một profile giao tiếp khác và benchmark tương ứng.
Để biết thêm về interconnect, xem NVLink vs NVSwitch. Để có thêm ngữ cảnh về mua cụm và thuật ngữ topology, GPU cluster rental guide là một tài liệu bổ trợ hữu ích.
Kiểm thử nghiệm thu sản xuất
Chạy một bài kiểm thử theo từng giai đoạn thay vì một prompt theo đường đi thuận lợi duy nhất.
- Kiểm thử topology: lưu
nvidia-smi topo -m, danh mục NIC và môi trường NCCL. - Kiểm thử tải lạnh: đo thời gian từ lúc container khởi động đến token thành công đầu tiên.
- Kiểm thử prompt ngắn: độ dài prompt thấp, độ dài đầu ra vừa phải, khối lượng công việc chat dự kiến.
- Kiểm thử prompt dài: độ dài ngữ cảnh thực tế gần với yêu cầu sản phẩm của bạn.
- Quét đồng thời: tăng số yêu cầu đồng thời cho đến khi thời gian đến token đầu tiên p95 hoặc độ trễ giữa các token p95 vượt ngưỡng của bạn.
- Kiểm thử thiên về đầu ra: dùng các workload tạo ra phần hoàn thành dài, không chỉ các prompt phân loại.
- Kiểm thử lỗi: tắt một tiến trình worker hoặc một node và xác minh bộ cân bằng tải loại bỏ bản sao.
- Kiểm thử khởi động lại: triển khai lại tiến trình vLLM và xác nhận cache mô hình, trạng thái Ray, và các kiểm tra sức khỏe khôi phục sạch sẽ.
Theo dõi ít nhất các chỉ số sau:
| Chỉ số | Vì sao quan trọng |
|---|---|
| Thời gian đến token đầu tiên | Người dùng cảm nhận ngay điều này trong các luồng chat và agent. |
| Độ trễ giữa các token | Cho thấy độ ổn định của giai đoạn giải mã sau khi quá trình tạo sinh bắt đầu. |
| Số token mỗi giây trên mỗi bản sao | Giúp so sánh các cấu hình TP/PP. |
| Dư địa bộ nhớ GPU | Dự đoán liệu các đợt tăng đột biến ngữ cảnh dài có gây OOM hay không. |
| Thời gian chờ hàng đợi | Tách biệt năng lực phục vụ khỏi độ trễ ứng dụng. |
| Tỷ lệ lỗi và tỷ lệ thử lại | Chuyển sự bất ổn của hạ tầng thành chi phí thực tế. |
| Tỷ lệ đầu ra được chấp nhận | Tránh tối ưu cho các token rẻ mà người dùng từ chối. |
Các mẫu khắc phục sự cố
Mô hình tải được, nhưng thông lượng lại tệ hơn khi có nhiều GPU hơn.
Nhóm TP có thể quá lớn so với topology, hoặc workload có thể không đủ mức đồng thời để bù cho chi phí giao tiếp. Hãy thử TP nhỏ hơn, nhiều bản sao hơn, hoặc một cấu hình batch/đồng thời khác.
Khởi chạy đa node bị treo.
Kiểm tra membership của Ray, quy tắc firewall, lựa chọn interface của NCCL, mạng container, và việc mọi node có thể truy cập cùng một đường dẫn model hay không. Đừng debug từ lớp API trước.
Một GPU bị OOM trong khi các GPU khác vẫn còn dư bộ nhớ.
Tìm các stage pipeline không đều, các SKU GPU khác nhau, phân mảnh bộ nhớ, hoặc vấn đề gán rank. Xác nhận rằng mỗi worker đang sử dụng đúng GPU hiển thị được dự định.
Độ trễ tăng đột biến với prompt dài.
Áp lực lên KV cache, chi phí prefill và hàng đợi của scheduler là những nghi phạm có khả năng cao. Hãy kiểm tra các bucket độ dài prompt riêng trước khi thay đổi phần cứng.
Endpoint hoạt động trong terminal nhưng thất bại phía sau load balancer.
Kiểm tra timeout cho streaming, idle timeout, đường dẫn health-check, giới hạn kích thước body request, và việc load balancer có gửi traffic tới một replica trước khi model sẵn sàng hay không.
Khi nào không nên tự chạy vLLM multi GPU inference
Chạy vLLM là lựa chọn đúng khi bạn cần kiểm soát ở cấp độ model, weight riêng tư, kernel tùy chỉnh, quantization tùy chỉnh, hoặc các thử nghiệm ở cấp phần cứng. Nó không tự động là lựa chọn đúng khi yêu cầu kinh doanh chỉ đơn giản là "cung cấp cho ứng dụng của chúng tôi một API tương thích OpenAI đáng tin cậy."
Trước khi thuê một cụm GPU đa node, hãy so sánh hướng tự host với một phương án model/API được quản lý:
| Yêu cầu | Tự host vLLM trên GPU | Mốc baseline model/API được quản lý |
|---|---|---|
| Weight tùy chỉnh/riêng tư | Phù hợp mạnh | Thường chưa đủ |
| Thử nghiệm phần cứng | Phù hợp mạnh | Không phải mục đích |
| Tích hợp sản phẩm nhanh | Nhiều công việc vận hành hơn | Phù hợp mạnh |
| Chuyển đổi giữa nhiều model | Bạn vận hành từng stack | Một gateway có thể đơn giản hóa truy cập |
| Khả năng nhìn thấy billing và usage | Tự xây dựng hoặc tích hợp | Thường đã bao gồm |
| Xử lý lỗi | Bạn tự chịu trách nhiệm | Nhà cung cấp/gateway xử lý nhiều phần hơn |
Flatkey là điểm so sánh khi bạn muốn một key tương thích OpenAI, một số dư duy nhất, và quyền truy cập vào các endpoint model chính thức mà không phải tự vận hành tầng phục vụ GPU. Nếu kiểm soát phần cứng trực tiếp không phải là yêu cầu của sản phẩm, hãy benchmark với một baseline model/API trước khi cam kết vận hành cụm.
Câu hỏi thường gặp
vLLM có hỗ trợ inference đa GPU không?
Có. vLLM hỗ trợ inference đa GPU thông qua tensor parallelism và pipeline parallelism, với các lựa chọn executor bao phủ phục vụ trên một node và nhiều node. Đường hỗ trợ cụ thể phụ thuộc vào phiên bản vLLM, kiến trúc model, topology GPU, và backend triển khai của bạn.
Kích thước tensor parallel tốt nhất cho vLLM là gì?
Kích thước tensor parallel tốt nhất là giá trị TP nhỏ nhất cho đủ khoảng trống bộ nhớ và thông lượng cho workload của bạn. Bắt đầu với các GPU trong một node nhanh, sau đó benchmark tp=2, tp=4, hoặc tp=8 với độ dài prompt và output thực tế.
Khi nào tôi nên dùng pipeline parallelism trong vLLM?
Hãy dùng pipeline parallelism khi yêu cầu của model hoặc KV-cache buộc bạn vượt ra ngoài một node, hoặc khi giữ giao tiếp tensor-parallel bên trong từng node tốt hơn việc xây dựng một nhóm TP xuyên nhiều node.
Ray có bắt buộc cho vLLM multi-GPU serving không?
Ray thường là lựa chọn thực tế cho vLLM serving đa node. Với một node, backend multiprocessing hoặc backend mặc định cho phiên bản vLLM của bạn có thể đơn giản hơn.
Làm sao biết một thiết lập vLLM multi GPU inference đã sẵn sàng cho production?
Nó chỉ sẵn sàng cho production sau khi kiểm tra topology, kiểm thử cold-load, benchmark prompt/đồng thời thực tế, health check, kiểm thử khởi động lại, và hành vi khi lỗi đã được tài liệu hóa. Một lệnh curl thành công duy nhất là chưa đủ.


