
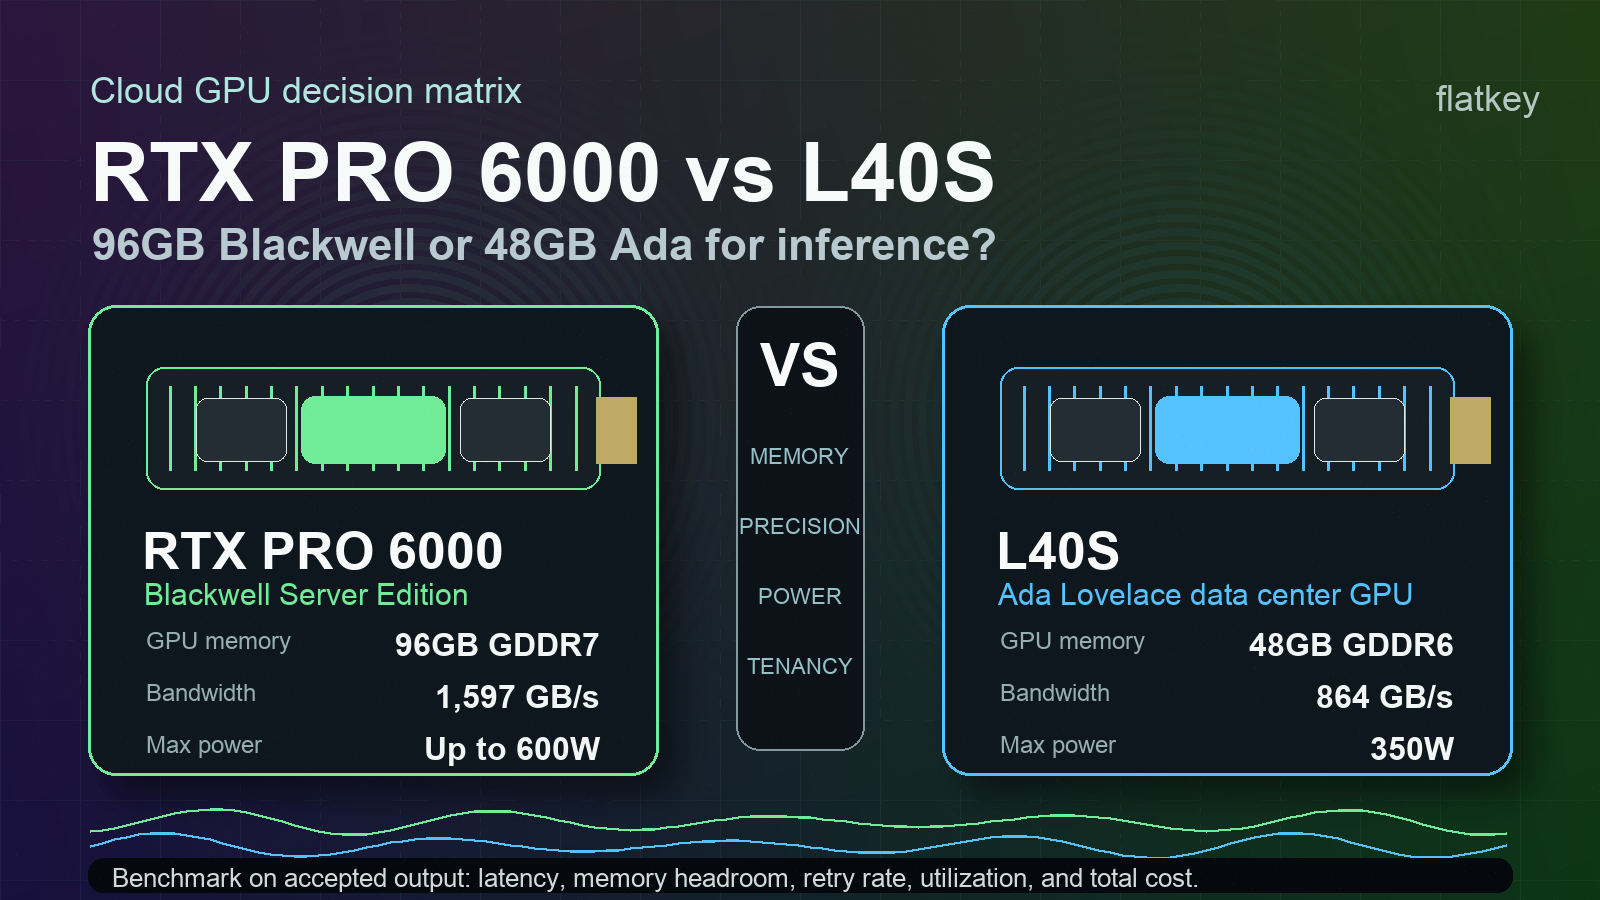
RTX PRO 6000 对比 L40S:96GB Blackwell 还是 Ada 推理 GPU?
关于 l40s vs rtx pro 6000 的简短答案:当 96GB GPU 内存、Blackwell FP4 支持、PCIe Gen 5、MIG 分区,以及更先进的媒体引擎会改变你的服务设计时,选择 NVIDIA RTX PRO 6000 Blackwell Server Edition。当你的工作负载已经能装进 48GB、你的技术栈在 Ada GPU 上已经很成熟,而且价格或供货差距大到足以压过新卡时,选择 NVIDIA L40S。
这并不是一个“新 GPU 一定更好”的简单决定。rtx pro 6000 vs l40s 的比较,本质上是关于显存匹配、精度支持、软件成熟度、功耗预算以及可接受输出成本。如果 RTX PRO 6000 让你可以使用更少的分片、更大的上下文窗口、更大的批次,或减少 OOM 重试次数,那么它就可能是更强的推理 GPU。如果 L40S 的容量更便宜、更容易预留,并且已经满足你的延迟目标,那么这款更老的 Ada 卡仍然可能是务实之选。
检查时间:2026 年 10 月 13 日。
L40S 对比 RTX PRO 6000:实际差异
在向供应商索要基准测试之前,先用这张表作为第一道采购筛选。
| 决策点 | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| GPU 代际 | Blackwell | Ada Lovelace |
| 主要购买原因 | 更大显存、更先进的 Tensor Core、FP4 路径、PCIe Gen 5、工作负载分区 | 成熟的 48GB 数据中心 GPU,适用于推理、渲染、图形和视频 |
| GPU 内存 | 96GB GDDR7,带 ECC | 48GB GDDR6,带 ECC |
| 内存带宽 | 1,597 GB/s | 864 GB/s |
| FP32 | 120 TFLOPS | 91.6 TFLOPS |
| Tensor 精度亮点 | FP4 4 PFLOPS、FP8 2 PFLOPS、FP16/BF16 1 PFLOP | FP8 733 / 1,466 TFLOPS(带稀疏性),FP16/BF16 362.05 / 733 TFLOPS(带稀疏性) |
| 最大功耗 | 最高可配置 600W | 350W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | RTX PRO 6000 最多支持四个隔离实例 | L40S 未列出 MIG 支持 |
| 最佳首测场景 | 长上下文 LLM 推理、更大的多模态模型、多租户 GPU 共享、FP4/Blackwell 优化服务 | 48GB 友好的 LLM、Stable Diffusion 风格图像生成、渲染、视频、成熟的 Ada 集群 |
来源:NVIDIA 的 RTX PRO 6000 Blackwell Server Edition 产品页、NVIDIA 的 L40S 产品页,以及 NVIDIA 的 Blackwell 架构页面。
快速建议
开始 l40s vs rtx pro 6000 基准测试时,先看显存,而不是峰值 TFLOPS。
- 当你的模型在 L40S 上受显存限制、当上下文长度或 KV cache 压力决定 GPU 数量、当你想测试 FP4/Blackwell 推理路径,或者当隔离式 GPU 切片对共享企业集群很重要时,选择 RTX PRO 6000 Blackwell Server Edition。
- 当你的模型、批大小和上下文窗口能轻松放进 48GB、当你的生产栈已经针对 Ada 做了优化,或者当供应商价格差异大到让更老的 GPU 在可接受输出成本上胜出时,选择 L40S。
- 当你不需要自定义权重、CUDA 控制、私有 GPU 调度或直接的媒体/渲染加速时,请使用 模型 API 基线。在考虑排队、重试、空闲时间和工程开销之后,硬件必须在成本和运维简易性上胜过托管模型调用。
正因如此,nvidia rtx pro 6000 vs l40s 的决策不应止步于规格表。如果利用率很低,或者团队并不需要自行管理 GPU 运维,那么即使卡更快,它也可能不是正确采购。
为什么 RTX PRO 6000 会改变推理讨论
RTX PRO 6000 Blackwell Server Edition 的标称显存容量是 L40S 的两倍:96GB GDDR7,而不是 48GB GDDR6。它的标称内存带宽也从 L40S 的 864 GB/s 提升到了 1,597 GB/s。
对于推理团队来说,显存不只是“模型大小”。它还包括 KV cache、批处理余量、运行时缓冲区、适配器、多模态输入、长提示词的安全余量,以及多租户开销。在真实服务中,能避免 OOM 错误或减少 tensor-parallel 分片的卡,可能会胜过标称按小时价格更低的卡。
在以下场景中,RTX PRO 6000 尤其值得测试:
- 你提供长上下文 LLM 流量,而 KV cache 主导了显存规划。
- 你想测试 70B 级或更大的量化模型,并且希望用更少的分片。
- 你运行混合多模态工作负载,图像、视频、embedding、reranking 和 LLM 组件都在争夺显存。
- 你需要把一块物理 GPU 分给多个用户或多个工作负载;NVIDIA 为 RTX PRO 6000 标称最多支持四个隔离的 MIG 实例。
- 你正在评估 Blackwell 特有的服务路径,例如 FP4/NVFP4、TensorRT-LLM、vLLM 或 SGLang 的改进。
功耗取舍是真实存在的。NVIDIA 将 RTX PRO 6000 标为最高可配置 600W,而 L40S 为 350W。如果你的供应商按已承诺服务器、功耗上限、机架密度或预留容量定价,那么更高的上限就应计入 rtx 6000 pro vs l40s 的成本模型中。不要只比较 GPU 小时价格,而不询问其中是否包含电力、散热、主机配置、支持和多租户。
为什么 L40S 仍然有用
L40S 依然是一款强劲且实用的 GPU,因为它是一张成熟的 Ada 数据中心卡,配备 48GB ECC 内存、864 GB/s 内存带宽、350W 最高功耗,以及广泛的量产熟悉度。NVIDIA 将 L40S 定位用于生成式 AI、LLM 训练与推理、图形、渲染、Omniverse 和视频工作负载。
这种成熟度在云采购中很重要。当以下情况出现时,稍旧的卡片也可能胜出:
- 你需要的具体区域里,容量现在就可用。
- 提供商的镜像、驱动、容器和监控已经稳定。
- 工作负载可在 48GB 内运行,而无需激进分片。
- 你的瓶颈是排队时间、数据加载、CPU 预处理或软件调度,而不是原始 Tensor Core 峰值。
- 你正在运行图像生成、渲染、视频或视觉计算任务,并且这些任务在 Ada 上已经有良好的基准表现。
nvidia l40s vs rtx pro 6000 这个问题,往往取决于 RTX PRO 6000 上额外的 48GB 是否会改变部署形态。如果不会,L40S 可能是风险更低的租用或预留容量选择,尤其适合已有脚本和基线的团队。
逐项工作负载决策矩阵
在向提供商询价之前,请先使用这个矩阵。
| 工作负载 | 在以下情况下优先选择 RTX PRO 6000... | 在以下情况下优先选择 L40S... | 需要衡量什么 |
|---|---|---|---|
| 长上下文 LLM 推理 | 48GB 限制了上下文长度、批量大小或 KV cache 余量 | 48GB 满足 p95 上下文和并发目标 | 首 token 时间、tokens/秒、p95 延迟、OOM 率、每小时可接受响应数 |
| 量化 70B 级模型服务 | 96GB 减少分片、重试或放置复杂度 | 你的量化模型和 KV cache 在目标并发下可放入 L40S | 每个副本的 GPU 数、排队延迟、质量分数、重试率 |
| 多租户推理 | MIG 隔离和 96GB 内存提升利用率 | 租户管理在节点或调度器层面完成 | 按租户统计的利用率、邻居噪声事件、失败作业 |
| Stable Diffusion 和图像生成 | 更大的模型、批量或混合媒体阶段需要更多内存 | 现有管道已经达到吞吐和质量目标 | 每小时可接受图像数、VRAM 余量、每张可接受图像成本 |
| 渲染和 3D 图形 | Blackwell RT/媒体特性改进了特定渲染器或管线 | Ada L40S 的性能已经在该渲染器上得到验证 | 帧/渲染时间、失败渲染、媒体编解码吞吐量 |
| 企业刷新 | 你希望在未来 24 个月采用 Blackwell 时代平台 | 你需要带着已知运维方式增量扩容 | 利用率下限、迁移工作量、支持 SLA、容量可用性 |
这才是看待 l40s vs rtx 6000 pro 的有用方式:不是哪张产品页上的数字更大,而是哪款 GPU 能让你每美元交付更多可接受的输出。
基准测试应以可接受输出为准,而不是峰值规格
一场严谨的 l40s vs rtx pro 6000 基准测试,应该重放你的真实工作负载,而不是依赖通用峰值。要衡量用户或客户实际接受的输出。
对于 LLM 推理,请收集:
| 指标 | 为什么重要 |
|---|---|
| 首 token 时间 | 反映交互式用户延迟 |
| token 间延迟 | 展示真实并发下的解码行为 |
| 稳定并发数 | 揭示 48GB 或 96GB 是否会改变批处理方式 |
| 上下文长度阶梯测试 | 找出 KV cache 压力何时出现 |
| OOM 和重试率 | 把内存适配转化为真实成本 |
| 每小时可接受响应数 | 对质量过滤、失败和重试进行归一化 |
| 每 100 万个可接受输出 token 的成本 | 让 RTX PRO 6000、L40S 和模型 API 使用同一指标 |
| 每月工程工时 | 反映驱动、内核、排队、故障和基准测试的人力成本 |
对于图像、视频、渲染或多模态工作负载,请把可接受 token 替换为可接受图像、可接受片段、渲染帧或已完成作业。逻辑是一样的。一张在厂商基准测试中看起来更快的卡,如果它增加了队列争用、带来更多失败作业,或者需要你的团队无法维护的软件迁移,就可能落败。
在租用 RTX PRO 6000 或 L40S 之前要问提供商的问题
在决定采用任一 GPU 之前,请先问这些问题:
- RTX PRO 6000 的容量是否明确是 Blackwell Server Edition,并且是风冷双槽还是液冷单槽?
- L40S 容量是专用、按份额、容器化,还是托管作业服务的一部分?
- 支持哪些驱动、CUDA、TensorRT-LLM、vLLM、SGLang、PyTorch 和容器版本?
- 提供商是否在 RTX PRO 6000 上暴露 MIG,实例如何计费?
- 基准测试是按按需费率、预留费率计费,还是包含在评估窗口内?
- 区域、网络 fabric、主机 CPU、存储类型以及本地 NVMe 容量分别是什么?
- 失败作业、空闲时间、排队时间、快照和出站流量是否单独计费?
- 当 GPU 主机不健康时,适用什么支持 SLA 和替换路径?
- 能否导出每个作业的 GPU 利用率、内存使用、排队延迟、重试率和成本?
- 如果 Blackwell 的可用性、驱动或内核落后于你的发布计划,备选路径是什么?
将这些答案与 Flatkey 的 GPU 租赁价格指南、GPU 集群 TCO 工作表以及 GPU 云与模型 API 对比配合使用。如果你仍在决定 GPU 类别,请在进一步缩小到 nvidia l40s vs rtx pro 6000 之前,先阅读更广泛的 LLM 推理最佳 GPU指南。
Flatkey 的适用场景
当你需要直接控制 GPU 时,Flatkey 并不能替代 RTX PRO 6000 或 L40S。如果你运行私有权重、自定义内核、严格的数据本地性、专用渲染管线,或硬件级研究,你仍然需要云 GPU 算力或自有基础设施。
当你的团队主要需要可靠的模型输出时,Flatkey 就是值得超越的基准。通过一个密钥和一个余额即可访问官方模型和 AI 工具,团队可以路由 API 工作负载、跟踪用量、比较模型成本,并避免分散的供应商账号。这能为财务和工程团队提供一个清晰的对照组,再去决定是否投入固定的 GPU 容量。
在实践中,请走三条路径:
| 路径 | 何时胜出 |
|---|---|
| RTX PRO 6000 | 更多显存或 Blackwell 特性能够减少 GPU 数量、故障或延迟,从而足以抵消更高成本 |
| L40S | 48GB 足够,且成熟的 Ada 容量具有最佳的有效输出价格 |
| 通过 Flatkey 托管的模型 API | 不需要直接控制 GPU,且运维简化胜过基础设施自建 |
真正的赢家,是在你的质量和延迟目标下,每个被接受输出的成本最低的路径。
最终建议
对于 l40s vs rtx pro 6000,如果显存余量、FP4/Blackwell 支持、PCIe Gen 5 或 MIG 分区能力会改变服务架构,那么就把 RTX PRO 6000 作为你的首个基准。如果工作负载已经能装进 48GB,并且成熟的 Ada 容量更便宜或更容易预留,那么就把 L40S 作为你的首个基准。
然后把两者都与模型/API 基准进行比较。如果 Flatkey 或其他托管 API 路线能够满足质量、延迟、隐私和成本要求,那么 GPU 租赁就必须证明其额外的运维工作是值得的。如果做不到,那么硬件路径就是合理的,而最终选择就变成了一次工作负载回放:看 rtx pro 6000 vs l40s 的有效输出,而不是营销峰值。
常见问题
RTX PRO 6000 Blackwell 比 L40S 更快吗?
根据 NVIDIA 的公开规格,RTX PRO 6000 Blackwell Server Edition 列出了更高的 FP32 性能、更大的显存、更高的显存带宽、更新的 Tensor Core,以及 FP4 支持。但这并不意味着它对每种工作负载都更便宜。请对你的具体服务栈和有效输出成本进行基准测试。
L40S 还适合 LLM 推理吗?
是的,只要模型、上下文窗口和并发目标能装进 48GB。L40S 对 LLM 推理、图像生成、渲染、视频以及混合视觉计算工作负载仍然可行,尤其是在供应商容量成熟的情况下。
NVIDIA RTX PRO 6000 与 L40S 最大的区别是什么?
最大的实际差异是显存。RTX PRO 6000 Blackwell Server Edition 标称 96GB GDDR7 和 1,597 GB/s 显存带宽;L40S 标称 48GB GDDR6 和 864 GB/s 显存带宽。RTX PRO 6000 还增加了 Blackwell FP4 路径和 MIG 支持。
我应该从 L40S 升级到 RTX PRO 6000 吗?
当 L40S 的显存限制导致需要更多分片、更小批次、更短上下文窗口、作业失败或利用率过低时,就升级。当 L40S 已经以更低的有效输出成本满足你的延迟和质量目标时,就继续使用 L40S。
我应该使用模型 API,而不是租用这两种 GPU 之一吗?
当你不需要自定义权重、直接 CUDA 控制、私有 GPU 调度,或渲染/媒体加速时,就使用模型 API。当工作负载需求波动很大,或者 GPU 利用率会很低时,模型 API 可能是更优的经济路径。
已核查来源
- NVIDIA RTX PRO 6000 Blackwell Server Edition 产品页面
- NVIDIA L40S 产品页面
- NVIDIA Blackwell 架构页面
- Flatkey Cloud GPU 主题地图和 Cloud GPU 关键词来源,日期为 2026-10-10
- Flatkey 产品概览和已批准定位:一个密钥、一个余额、官方模型、按成功调用计费的用量账本


