
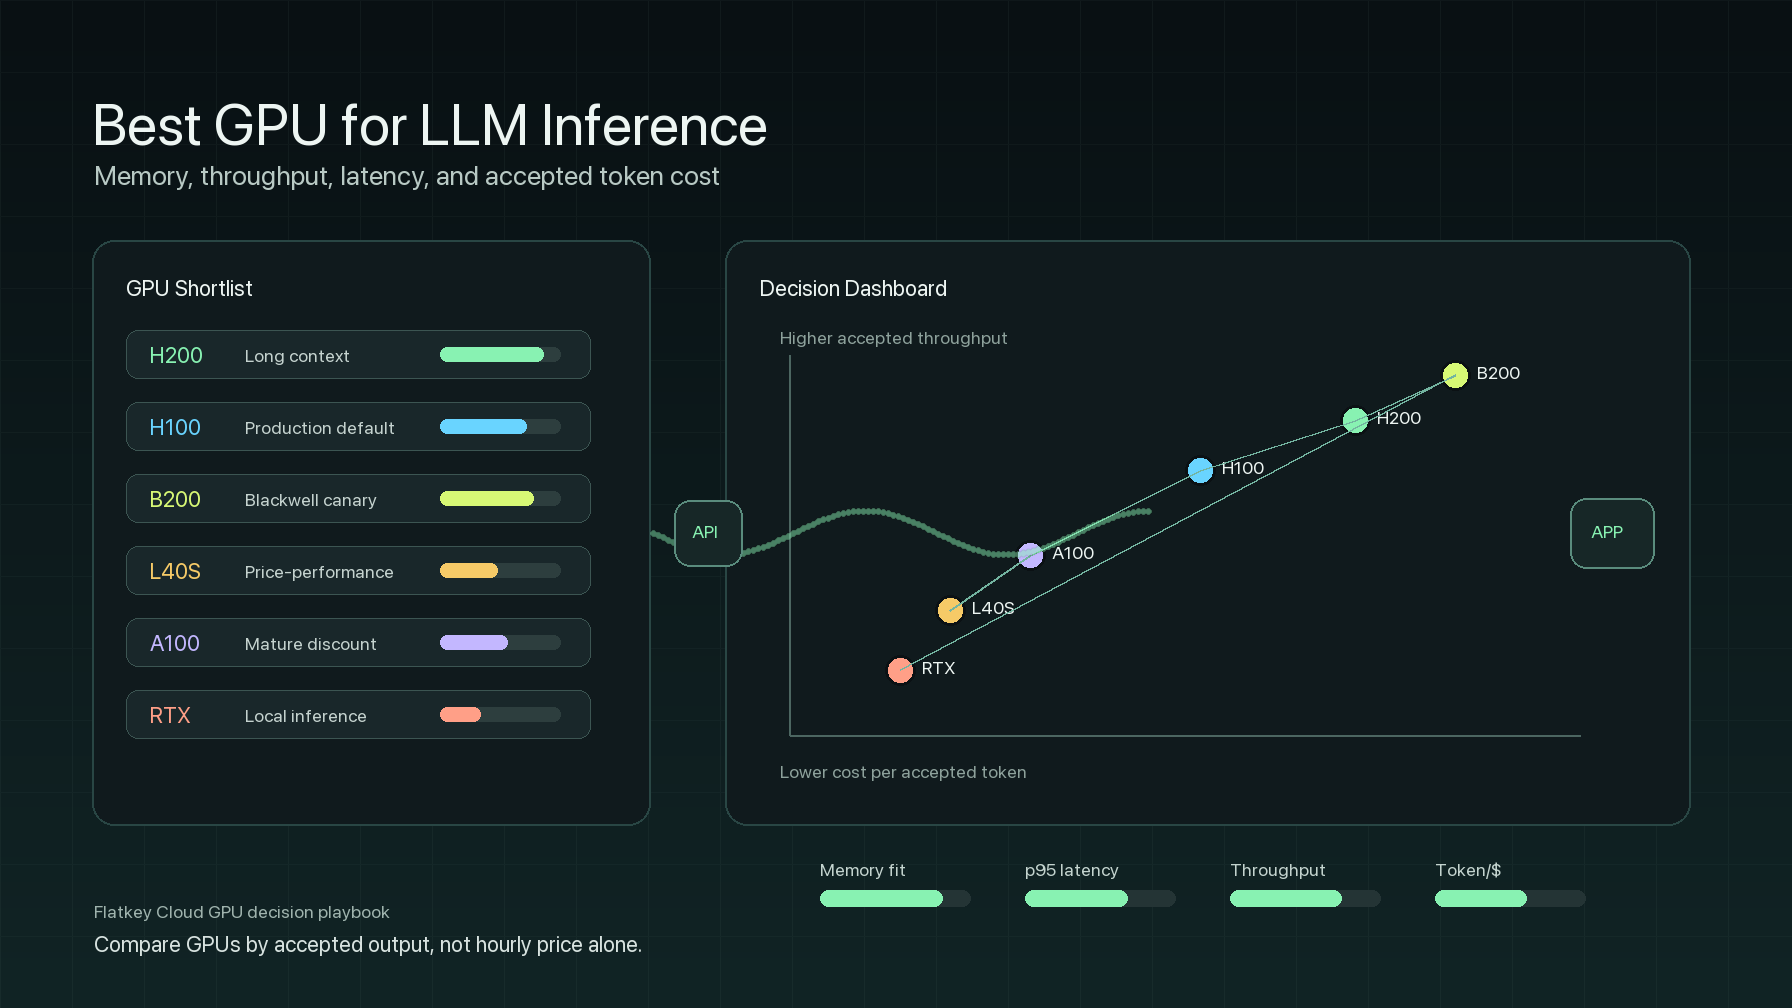
La mejor GPU para inferencia de LLM es la GPU que se ajusta a tu combinación real de prompts al menor costo aceptable, mientras cumple con los objetivos de memoria, latencia y confiabilidad. No siempre es la GPU más reciente, el listado horario más barato ni la tarjeta con la mejor captura de benchmark.
Para la mayoría de los equipos de IA empresarial, la respuesta corta es:
- Elige H200 cuando la memoria sea el cuello de botella: serving de clase 70B, RAG de contexto largo, alta concurrencia o un KV cache que lleve a la H100 demasiado cerca del límite.
- Elige H100 cuando necesites un estándar de producción maduro, con fuerte soporte de software, amplia disponibilidad en la nube y buen rendimiento sin migrar a la nueva capacidad Blackwell.
- Elige B200, GB200 o sistemas Blackwell más nuevos cuando tu stack pueda aprovechar la precisión y la topología de la era Blackwell, y el proveedor pueda demostrar disponibilidad real, precio y soporte operativo.
- Elige L40S o A100 cuando la relación costo-beneficio importe más que la latencia pico, el modelo quepa sin dificultad y tu carga de trabajo sea batch, interna o de contexto moderado.
- Elige RTX 4090, RTX 5090 o GPUs de workstation para inferencia local de LLM, desarrollo, demos y pequeñas cargas privadas, no para serving empresarial multi-tenant.
- Usa una API de modelo o un router en lugar de alquilar GPUs cuando el tráfico sea en ráfagas, la elección del modelo cambie con frecuencia o operar el stack de serving no sea el diferencial.
Esta guía explica cómo elegir la mejor GPU para inferencia de LLM por memoria, rendimiento, latencia y costo por token. También incluye una matriz de decisión, un plan de benchmark y una hoja de cálculo de tokens por dólar que puedes reutilizar antes de alquilar o comprar capacidad.
Mejor GPU para inferencia de LLM: matriz de decisión rápida
| Carga de trabajo | Mejor GPU para empezar | Por qué normalmente encaja | Puntos de atención |
|---|---|---|---|
| chat 7B-13B, herramientas internas, prototipos | L40S, RTX 4090, RTX 5090, A100 40GB o capacidad de nube de clase L4 | Un costo horario menor puede importar más que la velocidad de pico del acelerador cuando el modelo es pequeño y la concurrencia es moderada. | No extrapoles la latencia de una demo local al tráfico de producción p95/p99. |
| inferencia 30B-34B | L40S, A100 80GB, H100 PCIe/SXM | Suficiente memoria para configuraciones prácticas de serving, con un piso de costo menor que H200 o B200. | Contexto largo y alta concurrencia pueden llevar la carga de trabajo al territorio de H100/H200. |
| inferencia de clase 70B | H100, H200 o A100/H100 multi-GPU | La H100 es la base madura; la H200 es atractiva cuando la memoria y la presión del KV cache reducen la cantidad de GPUs necesaria. | La cuantización, el paralelismo de tensor y la política de batch definen el costo real. |
| RAG de contexto largo | H200 primero, luego H100 NVL/SXM o B200, si está disponible | El KV cache y el prefill del prompt pueden hacer que la capacidad y el ancho de banda de memoria sean más importantes que el precio horario bruto. | Haz benchmark con longitudes de contexto reales, no solo prompts cortos. |
| inferencia en batch de alto rendimiento | A100, L40S, H100 o H100 spot/marketplace | El rendimiento por dólar a menudo supera la menor latencia cuando los trabajos pueden ponerse en cola. | Incluye reintentos, interrupciones, cold starts y costo de almacenamiento. |
| chat con clientes sensible a la latencia | H100, H200 o B200, según el tamaño del modelo | Las GPUs de centro de datos más nuevas tienen mejor soporte para la stack de serving, ancho de banda y margen para concurrencia. | La latencia p95 y p99 importan más que el promedio de tokens/seg. |
| inferencia local de LLM | RTX 4090, RTX 5090, tarjetas de workstation RTX PRO / clase RTX 6000 | Las tarjetas locales son útiles para desarrollo privado, pruebas offline y modelos pequeños. | Las tarjetas de consumo no sustituyen la confiabilidad gestionada de multi-tenant. |
| producción regulada o empresarial | H100/H200/B200 en un proveedor con soporte, red, aislamiento y controles de auditoría | La capa operativa puede ser más importante que el nombre de la GPU. | Verifica SLA, política de reemplazo, red, almacenamiento y observabilidad. |
La regla práctica: la mejor GPU para inferencia de LLM cambia cuando cambian el tamaño del modelo, la longitud del contexto, la concurrencia, la precisión, el framework de serving y el precio. Haz que la GPU merezca la carga de trabajo.
Por qué la memoria suele decidir la primera lista corta
La inferencia de LLM usa memoria de la GPU para más que los pesos del modelo. Un servidor de producción también necesita KV cache, overhead de runtime, buffers de batching, adapters, overhead del tokenizer/servidor y, a veces, speculative decoding o buffers de salida estructurada.
Usa este modelo de memoria de primera pasada:
required_vram =
  model_weights
  + KV_cache_for_target_context_and_concurrency
  + runtime_overhead
  + safety_margin
La KV cache es la razón por la que un modelo que cabe en una demo breve puede fallar en producción. Prompts largos, lotes más grandes, más solicitudes concurrentes y límites de salida más altos aumentan la presión de memoria. La mejor relación costo-beneficio de GPU para inferencia de LLM suele ser la GPU que evita un shard extra, evita un intento después de un fallo de memoria o permite mantener un batch mayor sin perjudicar la latencia p95.
La capacidad de memoria también cambia las operaciones:
| Condición de memoria | Qué significa esto para el serving de LLM |
|---|---|
| Holgura suficiente | Puedes ajustar el tamaño del batch, la longitud del contexto y la concurrencia sin riesgo inmediato de OOM. |
| Cerca del límite | La cuantización, los batches más pequeños, un contexto más corto o el paralelismo de tensor se vuelven obligatorios. |
| Por encima del límite | Necesitas más GPUs, una GPU con más memoria, un modelo más pequeño, menor precisión o una ruta vía API. |
NVIDIA lista el H200 con 141GB de memoria HBM3e y 4.8TB/s de ancho de banda de memoria. Las páginas de NVIDIA para el H100 posicionan al H100 como la base madura de Hopper, mientras que las páginas de AWS P5 muestran familias de instancias H100 y H200 con hasta 8 GPUs por nodo y ancho de banda GPU-to-GPU NVSwitch. Para el trabajo de compra, el punto importante no es una sola línea de especificación. Es saber si la memoria extra reduce el número de GPUs, simplifica el sharding o mejora el rendimiento aceptado.
Rendimiento: tokens por segundo no es suficiente
Los tokens/sec brutos son útiles, pero no son la métrica del comprador. Para un servicio en producción, mide el trabajo aceptado:
accepted_output_rendimento =
  accepted output tokens or accepted responses
  / wall-clock benchmark duration
Luego normaliza por el costo:
token_per_dollar =
  accepted output tokens per hour
  / effective hourly cost
Esa es la métrica central detrás de las búsquedas de mejor GPU para inferencia de LLM token/s/usd. Una GPU más barata puede ganar cuando permanece bien utilizada y el objetivo de latencia es más flexible. Una GPU más cara puede ganar cuando aumenta el batch size, reduce réplicas, evita fallos de memoria o mantiene la latencia p95/p99 dentro del objetivo de nivel de servicio.
Divide el rendimiento en dos fases:
| Fase | Qué estresa la GPU | Qué medir |
|---|---|---|
| Prefill | Longitud del prompt, trabajo de atención, movimiento de memoria, reutilización de caché | tiempo hasta el primer token, tokens del prompt/sec, espera en la cola |
| Decode | Longitud de la salida, escalado del batch, ancho de banda de la caché KV | tokens de salida/sec, latencia entre tokens, tiempo de finalización p95/p99 |
Para RAG de contexto largo y tráfico de agentes, el prefill puede dominar. Para chat en streaming con respuestas largas, el decode puede dominar. Para clasificación en batch, las solicitudes aceptadas por minuto pueden importar más que la latencia de streaming.
Latencia: elige para p95 y p99, no para la velocidad media
La mejor GPU para inferencia de LLM bajo un SLA orientado al usuario es la GPU que mantiene la latencia de cola baja bajo carga. La latencia media oculta la cola de espera, vecinos ruidosos, fallos de caché, cold starts y nuevos intentos después de OOM.
Haz seguimiento de estas métricas en cada prueba de GPU:
able>| Métrica | Por qué importa |
|---|---|
| Tiempo hasta el primer token | Capacidad de respuesta percibida por el usuario y eficiencia del prefill. |
| Latencia entre tokens | Calidad del streaming y velocidad del decode. |
| Latencia de extremo a extremo | Tiempo total de finalización de la tarea. |
| Latencia p95 y p99 | Salud real del SLO en producción. |
| Espera en la cola | Si el servidor ya está sobrecargado incluso antes de que comience la generación. |
| Tasa de OOM y de retry | Si el benchmark es lo suficientemente estable como para orientar la compra. |
| Utilización de la GPU y utilización del ancho de banda HBM | Si la GPU es el cuello de botella o si el pipeline está esperando en otro lugar. |
Si la cotización del H200 es 1,4x la cotización de un H100 y ofrece 1,8x de rendimiento de salida aceptada para tu carga de trabajo, el H200 puede ganar. Si cuesta 2,2x y mejora el p95 solo en un 10%, probablemente gane el H100. Si un L40S es mucho más barato y cumple el objetivo de latencia para un modelo de 13B, el L40S puede ser la mejor GPU para costo-beneficio de inferencia de LLM para ese escenario.
Mejor GPU para inferencia local de LLM
La mejor GPU para inferencia local de LLM es una cuestión diferente de la mejor GPU de serving empresarial. La inferencia local generalmente valora el precio de compra, el consumo de energía en el escritorio, la VRAM, la privacidad y la comodidad para desarrolladores. El serving en producción valora la disponibilidad, la observabilidad, la política de reemplazo, la interconexión, el aislamiento multi-tenant y el soporte.
Para uso local:
- RTX 4090 y RTX 5090 son opciones sólidas para el desarrollo local de modelos pequeños y cuantizados, porque ofrecen alto rendimiento de GPU de consumo y VRAM suficiente para muchos experimentos.
- GPUs de workstation de la clase RTX PRO / RTX 6000 son mejores cuando necesitas más VRAM, drivers de workstation o soporte profesional.
- Memoria unificada de Mac o inferencia en CPU puede ser útil para pruebas, pero no debe tratarse como benchmark de serving en GPU.
- Rigs locales con múltiples GPUs pueden funcionar para investigación, pero rara vez igualan las operaciones de un centro de datos en la nube, a menos que tu equipo sea responsable de la energía, la refrigeración, la red, la monitorización y la recuperación ante fallos.
Usa GPUs locales para validar prompts, calidad, cuantización y comportamiento de la aplicación. Usa GPUs en la nube o en centros de datos para validar la concurrencia de producción, la latencia p95/p99, la disponibilidad, el costo por token aceptado y los procesos de despliegue.
GPU recomendada por modelo y patrón de serving
| Patrón de serving | Lista corta de GPUs | Por qué |
|---|---|---|
| Bot de soporte 7B/8B, contexto moderado | L40S, A100 40GB/80GB, H100 PCIe, RTX de clase local para desarrollo | El modelo es lo suficientemente pequeño como para que un costo horario menor pueda importar más que la memoria de punta. |
| Asistente privado 13B-34B | L40S, A100 80GB, H100 | Elige en función de la concurrencia y el objetivo de latencia; el H100 es útil cuando importa la latencia de cola. |
| Chat 70B con contexto moderado | H100, H200, 2x A100/H100 dependiendo de la precisión | Haz benchmark de cuantización, paralelismo tensorial y política de batch. |
| RAG de largo contexto 70B | H200, H100 NVL/SXM, B200 cuando esté disponible | La memoria y la presión sobre el KV cache pueden dominar. |
| API empresarial multi-tenant | H100/H200/B200 en un proveedor con soporte | El soporte, la observabilidad, el aislamiento y la política de reemplazo importan. |
| Inferencia offline en lote | A100, L40S, H100 spot o marketplace | El rendimiento por dólar puede superar a la menor latencia. |
| Laptop o desktop del desarrollador | RTX 4090, RTX 5090, RTX PRO/workstation | Excelente para inferencia local de LLM y desarrollo de prompts; no es una respuesta completa para producción. |
Plan de benchmark antes de alquilar o comprar
No elijas la mejor GPU para inferencia de LLM solo con base en un benchmark genérico. Ejecuta una reproducción que se parezca a tu producto.
- Congela la carga de trabajo. Registra el ID del modelo, la cuantización, la precisión, la distribución de la longitud de los prompts, la distribución de la longitud de las salidas, el contexto objetivo, la concurrencia y las comprobaciones de calidad.
- Congela la stack de serving. Usa la misma versión de vLLM, SGLang, TensorRT-LLM, NIM o servidor personalizado en todas las pruebas de GPU, cuando sea posible.
- Congela la configuración de hardware. Captura el SKU de la GPU, la cantidad de GPUs, PCIe/SXM/NVL, CPU, RAM, almacenamiento, driver, versión de CUDA, red y posicionamiento.
- Ejecuta tres trazas de tráfico. Chat corto, RAG de largo contexto y prompts por lote/offline revelan cuellos de botella diferentes.
- Mide p50, p95, p99. La latencia media no es suficiente para inferencia orientada al cliente.
- Rastrea fallos. Cuenta OOMs, timeouts, evictions, fallos de cold start y amplificación de retries.
- Calcula el costo aceptado. Divide el costo efectivo por tokens de salida aceptados, respuestas aceptadas o tareas completadas.
- Ejecuta al menos un día de canario. Los precios de marketplace, la disponibilidad del proveedor y la cola pueden cambiar durante ventanas reales de tráfico.
Tabla mínima de benchmark:
| Métrica | GPU candidata A | GPU candidata B | GPU candidata C |
|---|---|---|---|
| Precio horario de la GPU | |||
| Costo horario efectivo | |||
| Tokens de salida aceptados/hora | |||
| Costo por 1M de tokens de salida aceptados | |||
| Tiempo hasta el primer token p95 | |||
| Latencia extremo a extremo p95/p99 | |||
| Tasa de OOM o de retry | |||
| Utilización media de la GPU | |||
| Notas sobre operaciones |
Cuando una API de modelo supera alquilar GPUs
La mejor GPU para inferencia de LLM puede ser, en realidad, ninguna locación de GPU. El control directo de la GPU es valioso cuando tienes pesos propietarios, utilización sostenida, kernels personalizados, fuerte localidad de datos o un equipo de serving que puede mantener las GPUs ocupadas.
Usa una API de modelo o un router cuando:
- El tráfico es irregular.
- Necesitas varios proveedores de modelos, en lugar de un único modelo open-weight fijo.
- La elección del modelo cambia con frecuencia.
- Necesitas más fallback que control de bare-metal.
- El tiempo ocioso de la GPU excedería cualquier prima de API por token.
- Tu equipo quiere registros de uso, límites de presupuesto, facturas y gobernanza de proveedores sin operar un clúster de serving.
Flatkey encaja en este lado de la decisión: una clave, un saldo, una factura, más de 300 modelos oficiales, más de 1.000 herramientas pay-per-call y registros de uso a nivel de solicitud. Si una carga de trabajo no requiere pesos autoalojados, compara el costo de la GPU por token aceptado con rutas gestionadas de modelo antes de comprometerte con un clúster de GPU.
Para decisiones de costo relacionadas, consulta las guías de Flatkey sobre precios de alquiler de GPU, H100 vs A100, H200 vs H100, alquiler de clúster de GPU, vLLM vs SGLang y comparación de precios de modelos de IA.
Recomendación final
La mejor GPU para inferencia de LLM depende de la carga de trabajo:
- Usa H200 cuando la memoria, el contexto largo y la presión de la caché KV determinen el costo.
- Usa H100 cuando necesites un estándar de producción probado y la carga de trabajo encaje.
- Usa B200 o GB200 cuando haya capacidad Blackwell disponible, la stack de serving esté lista y tu benchmark pruebe la prima.
- Usa L40S o A100 cuando la relación costo-beneficio supere la latencia máxima.
- Usa GPUs locales de la clase RTX para desarrollo e inferencia local de LLM, no para serving multi-tenant empresarial.
- Usa Flatkey u otra capa de API de modelo cuando operar GPUs directamente no sea la ventaja del producto.
La métrica de compra no es "¿qué GPU es la más rápida?" Es costo por token aceptado al nivel de latencia y confiabilidad que tu producto exige.
Preguntas frecuentes
¿Cuál es la mejor GPU para inferencia de LLM?
La mejor GPU para inferencia de LLM depende de la carga de trabajo. La H200 suele ser el punto de partida más fuerte para serving de 70B y de contexto largo limitado por memoria. La H100 es el estándar de producción maduro. La L40S, la A100, la RTX 4090 o la RTX 5090 pueden ser mejores para modelos más pequeños, trabajos por lotes o inferencia local cuando cumplen la meta de latencia con menor costo.
¿Cuál es la mejor GPU para costo-beneficio en la inferencia de LLM?
La mejor GPU para costo-beneficio en la inferencia de LLM es la GPU con el menor costo por token aceptado o respuesta aceptada, y no el menor precio por hora. Calcula el costo horario efectivo, tokens de salida aceptados por hora, latencia p95/p99 y tasa de fallo antes de elegir.
¿Cómo calculo la mejor GPU para inferencia de LLM en token/s/usd?
Usa los tokens de salida aceptados por hora divididos por el costo horario efectivo. El costo efectivo debe incluir alquiler de la GPU, almacenamiento, ancho de banda, tiempo ocioso, reintentos, soporte y overhead de ingeniería. Luego compara el mismo modelo, precisión, longitud de contexto y stack de serving entre GPUs.
¿H100 o H200 es mejor para inferencia de LLM?
La H200 generalmente es mejor cuando la capacidad de memoria, el ancho de banda, el contexto largo o una caché KV más grande alteran la forma del serving. La H100 generalmente es mejor cuando el modelo encaja bien, la capacidad es más barata o más fácil de obtener, y el benchmark cumple los objetivos de latencia y rendimiento.
¿La B200 es la mejor GPU para inferencia de LLM?
Los sistemas B200 o GB200 pueden ser excelentes para inferencia de LLM a gran escala cuando el proveedor tiene capacidad real, el framework de serving soporta la precisión y la topología que pretendes usar, y el benchmark demuestra un costo aceptado menor. No compres capacidad Blackwell solo con base en promesas de lanzamiento; prueba tu tráfico.
¿Cuál es la mejor GPU para inferencia local de LLM?
Para inferencia local de LLM, la RTX 4090 y la RTX 5090 son opciones comunes de alto rendimiento para desarrolladores, mientras que las tarjetas RTX PRO o de la clase RTX 6000 son mejores cuando necesitas más VRAM o soporte profesional para workstation. Las GPUs locales son mejores para desarrollo, privacidad y pequeños deployments, no para confiabilidad total de serving empresarial.
Fuentes verificadas
- GPU NVIDIA H200: https://www.nvidia.com/en-us/data-center/h200/
- GPU NVIDIA H100 Tensor Core: https://www.nvidia.com/en-us/data-center/h100/
- GPU NVIDIA A100 Tensor Core: https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA DGX B200: https://www.nvidia.com/en-us/data-center/dgx-b200/
- GPU NVIDIA L40S: https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA GeForce RTX 5090: https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- Precios del cloud GPU de RunPod: https://www.runpod.io/pricing
- Precios del cloud GPU de Lambda: https://lambda.ai/pricing
- Instancias AWS EC2 P5: https://aws.amazon.com/ec2/instance-types/p5/
- Tipos de máquina con GPU de Google Cloud: https://docs.cloud.google.com/docs/compute-area/gpus
- Documentación del servidor compatible con OpenAI de vLLM: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html


