
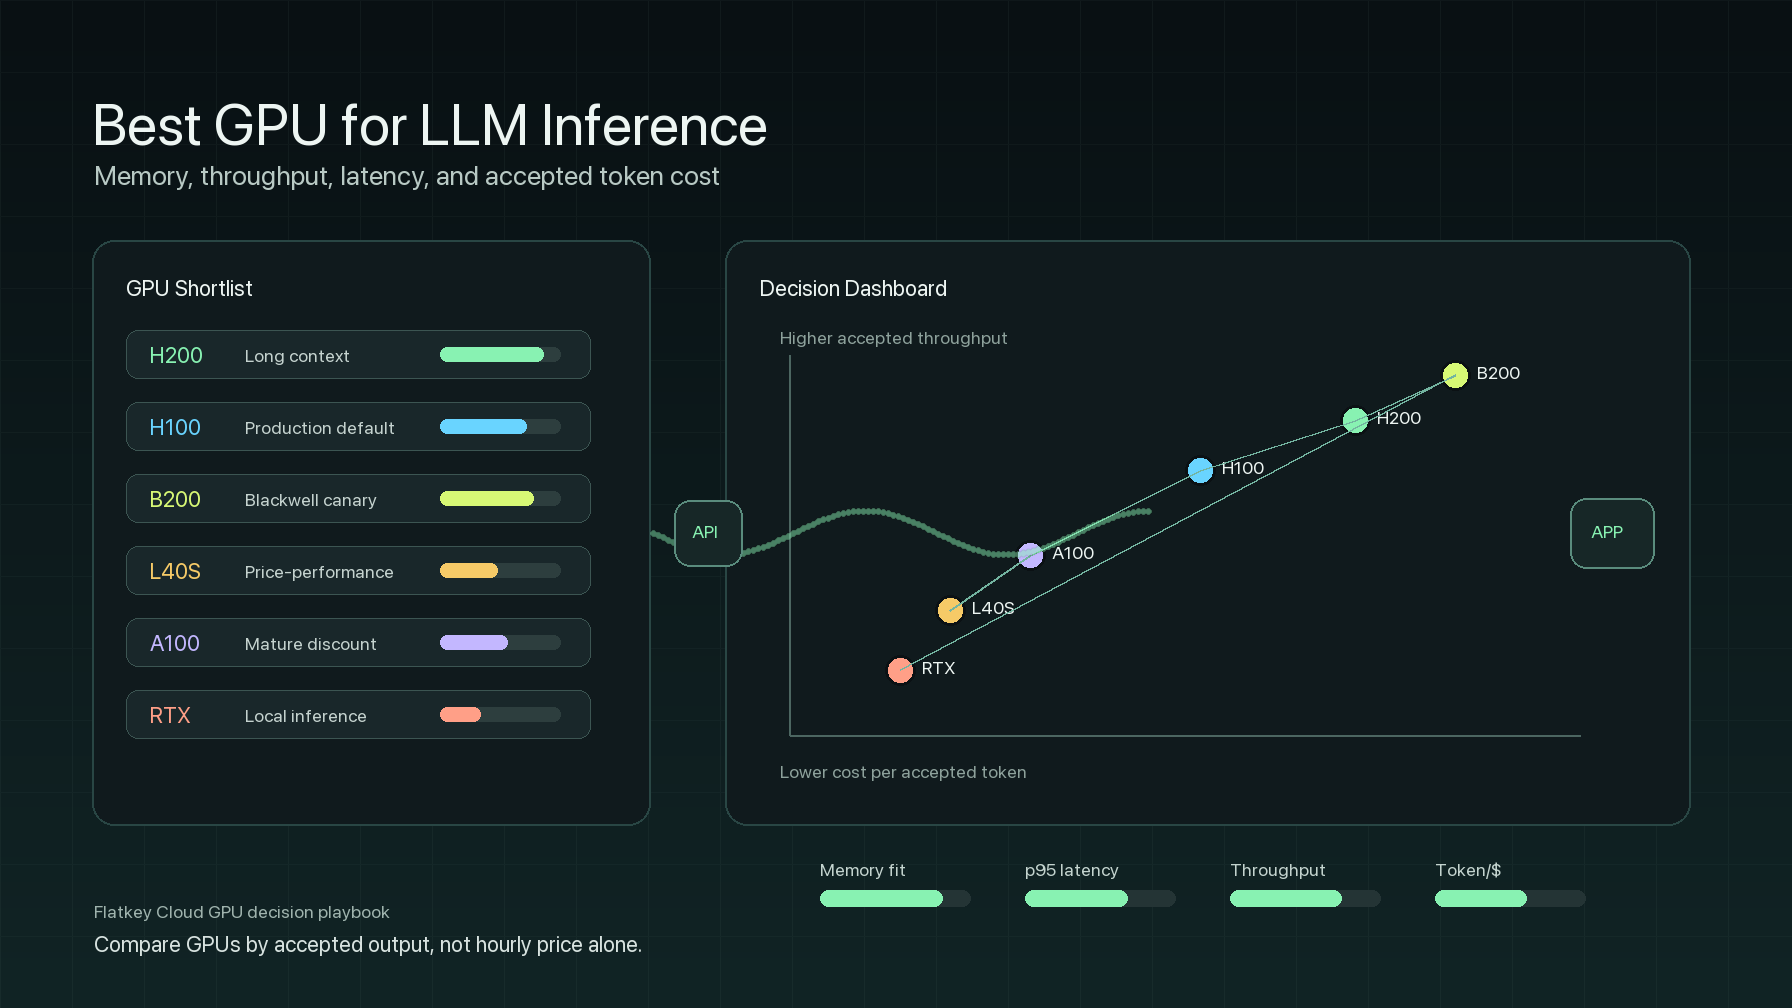
LLM推論に最適なGPUとは、許容可能な最小コストで実際のプロンプト構成に対応しつつ、メモリ、レイテンシ、信頼性の目標を満たすGPUです。必ずしも最新のGPU、最も安い時間単価のリスト、あるいはベンチマーク結果が最も高いカードであるとは限りません。
ほとんどのエンタープライズAIチームにとって、短い答えは次のとおりです。
- メモリがボトルネックならH200を選びます。70B級のサービング、長文コンテキストのRAG、高並列、またはH100を限界近くまで押し込むKVキャッシュがある場合です。
- 成熟した本番標準、強力なソフトウェアサポート、幅広いクラウドでの利用可能性、そしてBlackwellの新しい性能領域へ移行せずに良好なスループットが必要ならH100を選びます。
- スタックがBlackwell世代の精度とトポロジーを活用でき、プロバイダーが実際の在庫、価格、運用サポートを証明できるなら、B200、GB200、またはより新しいBlackwellシステムを選びます。
- コスト効率がピークレイテンシより重要で、モデルが無理なく収まり、ワークロードがバッチ、社内向け、または中程度のコンテキストであるならL40SまたはA100を選びます。
- ローカルLLM推論、開発、デモ、小規模なプライベート負荷にはRTX 4090、RTX 5090、またはワークステーションGPUを使います。マルチテナントのエンタープライズサービング向けではありません。
- トラフィックがバースト型で、モデル選択が頻繁に変わる、またはサービングスタックの運用が差別化要素でない場合は、GPUを借りる代わりにモデルAPIまたはルーターを使います。
このガイドでは、メモリ、スループット、レイテンシ、トークン単価の観点からLLM推論に最適なGPUをどう選ぶかを説明します。また、GPUを借りる前、あるいは購入する前に再利用できる、意思決定マトリクス、ベンチマーク計画、トークン対ドルのスプレッドシートも含みます。
LLM推論に最適なGPU: 迅速な意思決定マトリクス
| ワークロード | 最初に試すのに最適なGPU | 通常フィットする理由 | 注意点 |
|---|---|---|---|
| 7B-13Bチャット、社内ツール、プロトタイプ | L40S、RTX 4090、RTX 5090、A100 40GB、またはL4クラスのクラウド容量 | モデルが小さく並列性が中程度なら、最速アクセラレータよりも低い時間単価のほうが重要になることがあります。 | ローカルデモのレイテンシを本番トラフィックのp95/p99に外挿しないでください。 |
| 30B-34B推論 | L40S、A100 80GB、H100 PCIe/SXM | 実用的なサービング構成に十分なメモリがあり、H200やB200よりも低いコストの下限で運用できます。 | 長いコンテキストと高い並列性により、ワークロードがH100/H200の領域に移ることがあります。 |
| 70B級推論 | H100、H200、またはA100/H100マルチGPU | H100は成熟した標準であり、H200はメモリとKVキャッシュ圧力によって必要GPU数を減らせる場合に魅力的です。 | 量子化、テンソル並列、バッチングポリシーが実コストを左右します。 |
| 長文コンテキストRAG | まずH200、次に利用可能ならH100 NVL/SXMまたはB200 | KVキャッシュとプロンプトのprefillにより、生の時間単価よりもメモリ容量と帯域幅のほうが重要になる場合があります。 | 短いプロンプトだけでなく、実際のコンテキスト長でベンチマークしてください。 |
| 高スループットのバッチ推論 | A100、L40S、H100、またはH100のspot/marketplace | ジョブを待ち行列に入れられるなら、低レイテンシよりもドルあたりのスループットが勝ることがよくあります。 | 再試行、インタラプト、コールドスタート、ストレージ費用を含めてください。 |
| レイテンシに敏感な顧客向けチャット | モデルサイズに応じてH100、H200、またはB200 | より新しいデータセンターGPUは、サービングスタック、帯域幅、並列性の余裕に優れています。 | 平均tokens/秒よりもp95とp99レイテンシが重要です。 |
| ローカルLLM推論 | RTX 4090、RTX 5090、RTX PRO / RTX 6000クラスのワークステーションカード | ローカルカードは、プライベート開発、オフラインテスト、小規模モデルに有用です。 | コンシューマー向けカードは、マネージドなマルチテナント信頼性の代わりにはなりません。 |
| 規制対象またはエンタープライズ本番 | サポート、ネットワーク、分離、監査制御を備えたプロバイダー上のH100/H200/B200 | 運用レイヤーがGPU名より重要になることがあります。 | SLA、交換ポリシー、ネットワーク、ストレージ、可観測性を確認してください。 |
実用上のルール: LLM推論に最適なGPUは、モデルサイズ、コンテキスト長、並列性、精度、サービングフレームワーク、価格が変わると変化します。GPUにワークロードを見合うものにしてください。
なぜメモリが最初の候補リストを左右することが多いのか
LLM推論では、モデルの重み以外にもGPUメモリを使用します。本番サーバーには、KVキャッシュ、ランタイムオーバーヘッド、バッチング用バッファ、アダプター、トークナイザー/サーバーのオーバーヘッド、場合によってはspeculative decodingや構造化出力用バッファも必要です。
初期段階のメモリモデルは次のようにします。
required_vram =
  model_weights
  + KV_cache_for_target_context_and_concurrency
  + runtime_overhead
  + safety_margin
KVキャッシュは、短いデモには収まるモデルが本番で失敗しうる理由です。長いプロンプト、より大きなバッチ、より多い同時リクエスト、より大きい出力上限は、メモリ圧力を高めます。LLM推論におけるGPUの最良のコストパフォーマンスとは、多くの場合、追加のシャードを避け、メモリ不足後の再試行を避け、p95レイテンシを損なうことなくより大きなバッチを維持できるGPUのことです。
メモリ容量は運用も変えます:
| メモリ状況 | LLMサービングにとっての意味 |
|---|---|
| 十分な余裕あり | OOMの即時リスクなしに、バッチサイズ、コンテキスト長、同時実行数を調整できます。 |
| 上限に近い | 量子化、より小さいバッチ、より短いコンテキスト、またはテンソル並列化が必須になります。 |
| 上限超過 | より多くのGPU、より大容量のGPU、より小さいモデル、より低い精度、またはAPI経由のルートが必要です。 |
NVIDIAは、H200を141GBのHBM3eメモリと4.8TB/sのメモリ帯域幅を備えていると公表しています。NVIDIAのH100ページではH100をHopperの成熟した基盤として位置づけており、AWSのP5ページではノードあたり最大8基のGPUとGPU間NVSwitch帯域幅を備えたH100およびH200インスタンスファミリーを示しています。購入検討で重要なのは、単一の仕様値ではありません。追加メモリによってGPU台数が減るのか、シャーディングが単純になるのか、受け入れ可能なスループットが改善するのかを知ることです。
スループット: 1秒あたりのトークン数だけでは不十分
生のTokens/secは有用ですが、購入者向けの指標ではありません。本番サービスでは、受け入れられた作業量を測定してください:
accepted_output_rendimento =
  accepted output tokens or accepted responses
  / wall-clock benchmark duration
次にコストで正規化します:
token_per_dollar =
  accepted output tokens per hour
  / effective hourly cost
これが、LLM推論 token/s/usd に最適なGPUを探す際の中心的な指標です。より安価なGPUは、高い稼働率を維持でき、レイテンシ目標により柔軟性がある場合に勝つことがあります。より高価なGPUは、バッチサイズを増やし、レプリカ数を減らし、メモリエラーを回避し、またはp95/p99レイテンシをサービスレベル目標内に収めることで勝つことがあります。
スループットを2つの段階に分けます:
| 段階 | GPUに負荷をかける要素 | 測定項目 |
|---|---|---|
| Prefill | プロンプト長、アテンション処理、メモリ移動、キャッシュ再利用 | 最初のトークンまでの時間、プロンプトtokens/sec、キュー待ち |
| Decode | 出力長、バッチスケーリング、KVキャッシュ帯域幅 | 出力tokens/sec、トークン間レイテンシ、完了時間p95/p99 |
長文コンテキストのRAGやエージェントトラフィックでは、prefillが支配的になることがあります。長い応答のストリーミングチャットでは、decodeが支配的になることがあります。バッチ分類では、ストリーミングレイテンシよりも、1分あたりの受け入れリクエスト数のほうが重要な場合があります。
レイテンシ: 平均速度ではなくp95とp99で選ぶ
SLAがユーザー向けのLLM推論に最適なGPUは、負荷下でテールレイテンシを抑えられるGPUです。平均レイテンシは、キューイング、うるさい隣人、キャッシュミス、コールドスタート、OOM後の再試行を隠してしまいます。
各GPUテストで次の指標を追跡してください:
| 指標 | 重要な理由 |
|---|---|
| 最初のトークンまでの時間 | ユーザーが感じる応答性とprefill効率。 |
| トークン間レイテンシ | ストリーミング品質とdecode速度。 |
| エンドツーエンドのレイテンシ | タスク完了までの総時間。 |
| p95およびp99レイテンシ | 本番におけるSLOの実態。 |
| キュー待ち時間 | 生成開始前にサーバーがすでに飽和しているかどうか。 |
| OOMと再試行率 | 購入判断に使えるほどベンチマークが安定しているかどうか。 |
| GPU使用率とHBM帯域幅使用率 | GPUがボトルネックなのか、パイプラインが他の場所で待っているのか。 |
H200の見積もりがH100の1.4倍で、そのワークロードに対して許容される出力スループットが1.8倍になるなら、H200が勝つかもしれません。2.2倍の価格でp95がわずか10%しか改善しないなら、おそらくH100が勝ちます。L40Sがはるかに安く、13Bモデルのレイテンシ目標を満たせるなら、そのシナリオではL40SがLLM推論におけるコストパフォーマンス最適なGPUになり得ます。
ローカルLLM推論に最適なGPU
ローカルLLM推論に最適なGPUは、企業向けサービングに最適なGPUとは別の問題です。ローカル推論では通常、購入価格、デスク上での消費電力、VRAM、プライバシー、開発者の利便性が重視されます。本番サービングでは、可用性、可観測性、置き換えポリシー、相互接続、マルチテナント分離、サポートが重視されます。
ローカル用途では:
- RTX 4090とRTX 5090は、消費者向けGPUとして高い性能と、多くの実験に十分なVRAMを提供するため、小規模で量子化されたモデルのローカル開発に有力な選択肢です。
- RTX PRO / RTX 6000クラスのワークステーションGPUは、より多くのVRAM、ワークステーション向けドライバ、またはプロフェッショナルサポートが必要な場合に適しています。
- MacのユニファイドメモリやCPU推論はテストには役立ちますが、GPUサービングのベンチマークとして扱うべきではありません。
- 複数GPUのローカル構成は研究には使えますが、チームが電源、冷却、ネットワーク、監視、障害復旧まで責任を持たない限り、クラウドのデータセンター運用に匹敵することはまれです。
ローカルGPUは、プロンプト、品質、量子化、アプリケーションの挙動を検証するために使います。クラウドまたはデータセンターのGPUは、本番の同時実行、p95/p99レイテンシ、可用性、受理トークンあたりのコスト、ロールアウト手順を検証するために使います。
モデルとサービングパターン別の推奨GPU
| サービングパターン | GPU候補の短いリスト | 理由 |
|---|---|---|
| 7B/8Bサポートボット、適度なコンテキスト | L40S、A100 40GB/80GB、H100 PCIe、ローカル開発向けRTXクラス | モデルが十分小さいため、最先端のメモリ性能よりも低い時間単価のほうが重要になる場合があります。 |
| 13B-34Bのプライベートアシスタント | L40S、A100 80GB、H100 | 同時実行数とレイテンシ目標に基づいて選びます。テールレイテンシが重要な場合はH100が有用です。 |
| 適度なコンテキストの70Bチャット | H100、H200、精度に応じて2x A100/H100 | 量子化、テンソル並列、バッチポリシーをベンチマークしてください。 |
| 長文コンテキストRAG 70B | H200、H100 NVL/SXM、利用可能ならB200 | メモリとKVキャッシュへの圧力が支配的になる可能性があります。 |
| マルチテナント企業API | サポート付きプロバイダーのH100/H200/B200 | サポート、可観測性、分離、置き換えポリシーが重要です。 |
| オフラインのバッチ推論 | A100、L40S、H100 spotまたはマーケットプレイス | ドルあたりのスループットが低レイテンシより重要になることがあります。 |
| 開発者のラップトップまたはデスクトップ | RTX 4090、RTX 5090、RTX PRO/ワークステーション | ローカルLLM推論とプロンプト開発には最適ですが、本番運用の完全な答えではありません。 |
レンタルまたは購入前のベンチマーク計画
一般的なベンチマークだけでLLM推論に最適なGPUを決めないでください。自社プロダクトに近い再現を実行してください。
- ワークロードを固定する。 モデルID、量子化、精度、プロンプト長分布、出力長分布、ターゲットコンテキスト、同時実行数、品質チェックを記録します。
- サービングスタックを固定する。 可能であれば、すべてのGPUテストで同じバージョンのvLLM、SGLang、TensorRT-LLM、NIM、またはカスタムサーバーを使用します。
- ハードウェア構成を固定する。 GPUのSKU、GPU数、PCIe/SXM/NVL、CPU、RAM、ストレージ、ドライバ、CUDAバージョン、ネットワーク、配置を記録します。
- 3つのトラフィックトレースを実行する。 短いチャット、長文RAG、バッチ/オフラインプロンプトは、それぞれ異なるボトルネックを明らかにします。
- p50、p95、p99を測定する。 平均レイテンシだけでは、顧客向け推論には不十分です。
- 障害を追跡する。 OOM、タイムアウト、エビクション、コールドスタート失敗、再試行の増幅を数えます。
- 受理コストを計算する。 実効コストを、受理された出力トークン、受理された応答、または完了したタスクで割ります。
- 少なくとも1日キャナリーを実行する。 マーケットプレイス価格、プロバイダーの可用性、キューイングは、実際のトラフィック時間帯に変化することがあります。
最小限のベンチマーク表:
| メトリクス | 候補GPU A | 候補GPU B | 候補GPU C |
|---|---|---|---|
| GPUの時間単価 | |||
| 実効時間単価 | |||
| 受理された出力トークン/時 | |||
| 受理された出力トークン1Mあたりのコスト | |||
| 最初のトークンまでの時間 p95 | |||
| エンドツーエンドレイテンシ p95/p99 | |||
| OOMまたは再試行率 | |||
| 平均GPU使用率 | |||
| 運用上のメモ |
モデル API が GPU レンタルより優れている場合
LLM 推論に最適な GPUが、実は GPU を借りないこと、という場合もあります。専有重み、持続的な利用率、カスタムカーネル、強いデータ局所性、あるいは GPU を稼働させ続けられる serving チームがあるなら、GPU の直接制御には価値があります。
次のような場合は、モデル API またはルーターを使ってください:
- トラフィックが不規則である。
- 単一の固定された open-weight モデルではなく、複数のモデルプロバイダーが必要である。
- モデル選択が頻繁に変わる。
- bare-metal の制御よりもフォールバックの方が重要である。
- GPU のアイドル時間が、トークンあたりの API プレミアムを上回ってしまう。
- チームが serving クラスタを運用せずに、利用ログ、予算上限、請求書、プロバイダー統制を必要としている。
Flatkey はこの判断のもう一方に当てはまります。1つのキー、1つの残高、1つの請求書、300以上の公式モデル、1,000以上の pay-per-call ツール、そしてリクエスト単位の利用ログです。ワークロードが self-hosted の重みを必要としないなら、GPU クラスタに踏み切る前に、受け入れられたトークンあたりの GPU コストと、管理されたモデルルートを比較してください。
関連するコスト判断については、Flatkey の GPU レンタル価格ガイド、H100 vs A100、H200 vs H100、GPU クラスタレンタルガイド、vLLM vs SGLang、および AI モデル価格比較 を参照してください。
最終的な推奨
LLM 推論に最適な GPUは、ワークロードによって異なります:
- メモリ、長いコンテキスト、KV キャッシュ圧力がコストを左右するなら、H200 を使う。
- 実績ある本番標準が必要で、ワークロードに適合するなら、H100 を使う。
- Blackwell の容量が利用可能で、serving スタックが準備できており、ベンチマークがそのプレミアムを証明するなら、B200 または GB200 を使う。
- コスト効率が最大レイテンシを上回るなら、L40S または A100 を使う。
- 開発とローカル LLM 推論には RTX クラスのローカル GPU を使い、マルチテナントの企業向け serving には使わない。
- GPU を直接運用することが製品の強みでないなら、Flatkey または別のモデル API レイヤー を使う。
購入指標は「どの GPU が最速か?」ではありません。製品が要求するレイテンシと信頼性の水準で、受け入れられたトークンあたりのコストはいくらか、です。
よくある質問
LLM 推論に最適な GPU は何ですか?
LLM 推論に最適な GPU はワークロードによって異なります。H200 は、メモリ制約のある 70B や長コンテキスト serving において、最も有力な出発点であることが多いです。H100 は成熟した本番標準です。L40S、A100、RTX 4090、RTX 5090 は、より小さなモデル、バッチジョブ、またはローカル推論で、より低コストかつ目標レイテンシを満たせる場合により適していることがあります。
LLM 推論で最もコスト効率のよい GPU は何ですか?
LLM 推論で最もコスト効率のよい GPU は、1時間あたりの最安価格ではなく、受け入れられたトークンまたは受け入れられた応答あたりのコストが最も低い GPU です。選ぶ前に、実効時間コスト、1時間あたりの受け入れ済み出力トークン、p95/p99 レイテンシ、失敗率を計算してください。
token/s/usd で LLM 推論に最適な GPU をどう計算しますか?
1時間あたりの受け入れ済み出力トークンを実効時間コストで割ります。実効コストには、GPU レンタル、ストレージ、帯域幅、アイドル時間、再試行、サポート、エンジニアリングのオーバーヘッドを含める必要があります。そのうえで、同じモデル、精度、コンテキスト長、serving スタックを GPU 間で比較してください。
LLM 推論には H100 と H200 のどちらが適していますか?
メモリ容量、帯域幅、長いコンテキスト、または大きな KV キャッシュが serving の形を左右する場合、一般に H200 の方が適しています。モデルがうまく収まり、容量がより安価または入手しやすく、ベンチマークがレイテンシとスループットの目標を満たすなら、一般に H100 の方が適しています。
B200 は LLM 推論に最適な GPU ですか?
B200 または GB200 システムは、プロバイダーに実際の容量があり、serving フレームワークが予定する精度とトポロジーをサポートし、ベンチマークがより低い受け入れコストを証明する場合、大規模な LLM 推論に非常に優れた選択肢となり得ます。リリースの約束だけで Blackwell 容量を購入しないでください。トラフィックでテストしてください。
ローカル LLM 推論に最適な GPU は何ですか?
ローカル LLM 推論では、RTX 4090 と RTX 5090 が開発者向けの高性能な一般的選択肢です。一方で、より多くの VRAM やワークステーション向けのプロフェッショナルサポートが必要な場合は、RTX PRO または RTX 6000 クラスのカードがより適しています。ローカル GPU は、開発、プライバシー、小規模デプロイメントには適していますが、企業向け serving の完全な信頼性には向いていません。
検証済みのソース
- NVIDIA H200 GPU: https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA H100 Tensor Core GPU: https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA A100 Tensor Core GPU: https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA DGX B200: https://www.nvidia.com/en-us/data-center/dgx-b200/
- NVIDIA L40S GPU: https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA GeForce RTX 5090: https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- RunPodのGPUクラウド料金: https://www.runpod.io/pricing
- LambdaのGPUクラウド料金: https://lambda.ai/pricing
- AWS EC2 P5インスタンス: https://aws.amazon.com/ec2/instance-types/p5/
- Google CloudのGPU搭載マシンタイプ: https://docs.cloud.google.com/docs/compute-area/gpus
- vLLMのOpenAI互換サーバーのドキュメント: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html


