
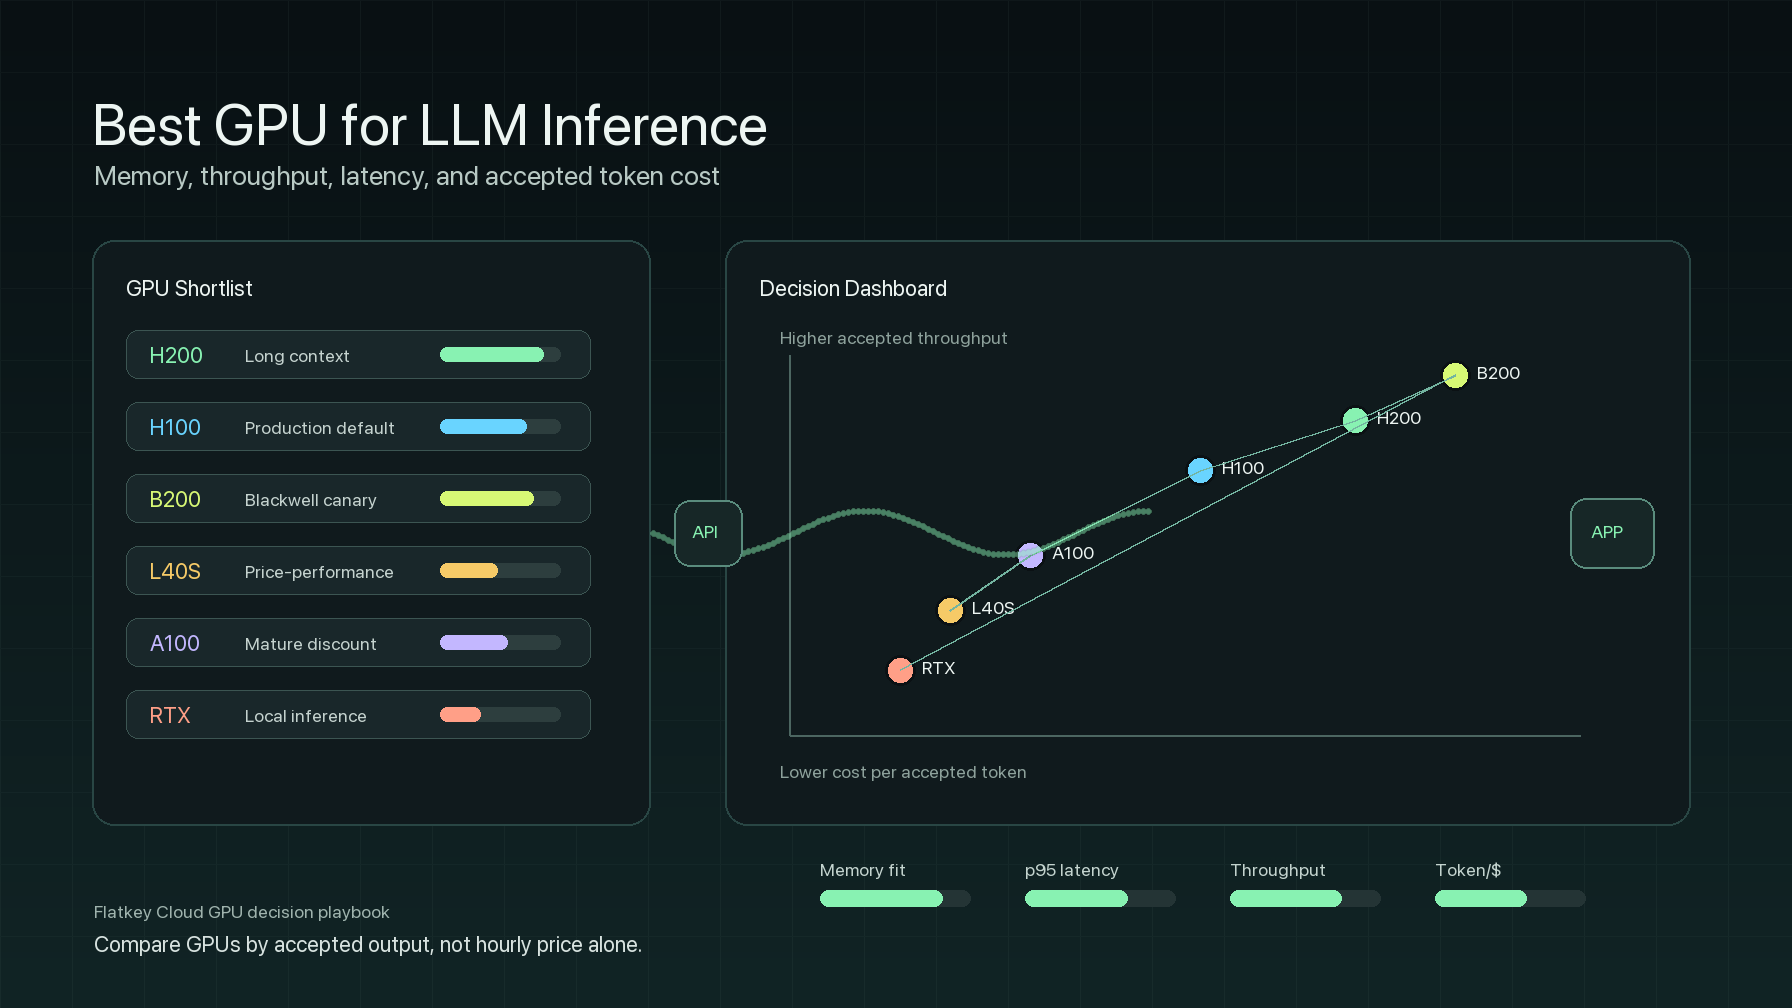
La meilleure GPU pour l’inférence de LLM est la GPU qui répond à votre mix réel de prompts au coût acceptable le plus bas, tout en respectant les objectifs de mémoire, de latence et de fiabilité. Ce n’est pas toujours la GPU la plus récente, l’offre horaire la moins chère ou la carte affichant le score de benchmark le plus élevé.
Pour la plupart des équipes d’IA en entreprise, la réponse courte est :
- Choisissez H200 lorsque la mémoire est le goulot d’étranglement : serving de classe 70B, RAG à long contexte, forte concurrence ou un KV cache qui pousse la H100 trop près de la limite.
- Choisissez H100 lorsque vous avez besoin d’un standard de production éprouvé, avec un fort support logiciel, une large disponibilité dans le cloud et un bon rendement sans passer à la nouvelle capacité Blackwell.
- Choisissez B200, GB200 ou des systèmes Blackwell plus récents lorsque votre stack peut exploiter la précision et la topologie de l’ère Blackwell, et que le fournisseur peut démontrer une disponibilité réelle, un prix et un support opérationnel.
- Choisissez L40S ou A100 lorsque le rapport coût-performance compte plus que la latence de pointe, que le modèle tient sans difficulté et que votre charge de travail est batch, interne ou de complexité modérée.
- Choisissez RTX 4090, RTX 5090 ou des GPU de workstation pour l’inférence locale de LLM, le développement, les démos et les petites charges privées, pas pour un serving d’entreprise multi-tenant.
- Utilisez une API de modèle ou un routeur plutôt que de louer des GPU lorsque le trafic est en rafales, que le choix du modèle change fréquemment ou que l’exploitation de la stack de serving n’est pas votre avantage différenciant.
Ce guide explique comment choisir la meilleure GPU pour l’inférence de LLM selon la mémoire, le rendement, la latence et le coût par token. Il inclut aussi une matrice de décision, un plan de benchmark et un tableur de tokens par dollar que vous pouvez réutiliser avant de louer ou d’acheter de la capacité.
Meilleure GPU pour l’inférence de LLM : matrice de décision rapide
| Charge de travail | Meilleure GPU pour commencer | Pourquoi cela convient généralement | Points d’attention |
|---|---|---|---|
| chat 7B-13B, outils internes, prototypes | L40S, RTX 4090, RTX 5090, A100 40GB ou capacité cloud de classe L4 | Un coût horaire plus bas peut compter davantage que la vitesse de pointe de l’accélérateur lorsque le modèle est petit et que la concurrence est modérée. | Ne projetez pas la latence d’une démo locale sur le trafic de production p95/p99. |
| inférence 30B-34B | L40S, A100 80GB, H100 PCIe/SXM | Assez de mémoire pour des configurations de serving pratiques, avec un plancher de coût plus bas que H200 ou B200. | Un contexte long et une forte concurrence peuvent faire basculer la charge de travail vers le territoire de la H100/H200. |
| inférence de classe 70B | H100, H200 ou A100/H100 multi-GPU | La H100 est la base mature ; la H200 est attrayante lorsque la mémoire et la pression du KV cache réduisent le nombre de GPU nécessaire. | La quantification, le parallélisme tensoriel et la politique de batch définissent le coût réel. |
| RAG à long contexte | H200 d’abord, puis H100 NVL/SXM ou B200, si disponible | Le KV cache et le prefill du prompt peuvent rendre la capacité et la bande passante mémoire plus importantes que le prix horaire brut. | Faites le benchmark avec des longueurs de contexte réelles, pas seulement des prompts courts. |
| inférence batch à haut rendement | A100, L40S, H100 ou H100 spot/marketplace | Le rendement par dollar l’emporte souvent sur la latence plus faible lorsque les jobs peuvent attendre en file. | Incluez les retries, les interruptions, les cold starts et le coût du stockage. |
| chat client sensible à la latence | H100, H200 ou B200, selon la taille du modèle | Les GPU de data center plus récents offrent un meilleur support de la stack de serving, une meilleure bande passante et davantage de marge pour la concurrence. | La latence p95 et p99 compte plus que la moyenne des tokens/s. |
| inférence locale de LLM | RTX 4090, RTX 5090, cartes de workstation RTX PRO / classe RTX 6000 | Les cartes locales sont utiles pour le développement privé, les tests hors ligne et les petits modèles. | Les cartes grand public ne remplacent pas la fiabilité gérée d’un environnement multi-tenant. |
| production réglementée ou d’entreprise | H100/H200/B200 chez un fournisseur avec support, réseau, isolation et contrôles d’audit | La couche opérationnelle peut être plus importante que le nom de la GPU. | Vérifiez le SLA, la politique de remplacement, le réseau, le stockage et l’observabilité. |
La règle pratique : la meilleure GPU pour l’inférence de LLM change lorsque changent la taille du modèle, la longueur du contexte, la concurrence, la précision, le framework de serving et le prix. Faites en sorte que la GPU mérite la charge de travail.
Pourquoi la mémoire décide souvent de la première liste restreinte
L’inférence de LLM utilise la mémoire GPU pour bien plus que les poids du modèle. Un serveur de production a aussi besoin de KV cache, d’un overhead d’exécution, de buffers de batching, d’adapters, d’un overhead du tokenizer/serveur et, parfois, de speculative decoding ou de buffers de sortie structurée.
Utilisez ce modèle de mémoire de premier passage :
required_vram =
  model_weights
  + KV_cache_for_target_context_and_concurrency
  + runtime_overhead
  + safety_margin
Le KV cache est la raison pour laquelle un modèle qui tient dans une courte démo peut échouer en production. Les invites longues, les lots plus importants, davantage de requêtes concurrentes et des limites de sortie plus élevées augmentent la pression sur la mémoire. Le meilleur rapport coût-efficacité du GPU pour l’inférence de LLM est souvent le GPU qui évite un shard supplémentaire, évite une nouvelle tentative après une erreur de manque de mémoire ou permet de conserver un batch plus grand sans nuire à la latence p95.
La capacité mémoire change aussi les opérations :
| Condition mémoire | Ce que cela signifie pour le serving de LLM |
|---|---|
| De la marge en réserve | Vous pouvez ajuster la taille du batch, la longueur du contexte et la concurrence sans risque immédiat d’OOM. |
| Au plus juste | La quantification, des batches plus petits, un contexte plus court ou le parallélisme de tenseurs deviennent obligatoires. |
| Au-dessus de la limite | Vous avez besoin de plus de GPU, d’un GPU avec plus de mémoire, d’un modèle plus petit, d’une précision moindre ou d’un passage via API. |
NVIDIA indique que le H200 dispose de 141 Go de mémoire HBM3e et d’une bande passante mémoire de 4,8 To/s. Les pages NVIDIA du H100 positionnent le H100 comme la base mature de Hopper, tandis que les pages AWS P5 montrent des familles d’instances H100 et H200 avec jusqu’à 8 GPU par nœud et une bande passante GPU-à-GPU NVSwitch. Pour l’achat, le point important n’est pas une seule ligne de spécification. C’est de savoir si la mémoire supplémentaire réduit le nombre de GPU, simplifie le sharding ou améliore le rendement accepté.
Rendement : les tokens par seconde ne suffisent pas
Le débit brut en tokens/sec est utile, mais ce n’est pas la métrique de l’acheteur. Pour un service en production, mesurez le travail accepté :
accepted_output_rendimento =
  accepted output tokens or accepted responses
  / wall-clock benchmark duration
Normalisez ensuite par le coût :
token_per_dollar =
  accepted output tokens per hour
  / effective hourly cost
C’est la métrique centrale derrière les recherches de meilleur GPU pour l’inférence de LLM token/s/usd. Un GPU moins cher peut l’emporter lorsqu’il reste bien utilisé et que l’objectif de latence est plus flexible. Un GPU plus coûteux peut l’emporter lorsqu’il augmente la taille du batch, réduit le nombre de réplicas, évite les erreurs de mémoire ou maintient la latence p95/p99 dans l’objectif de niveau de service.
Divisez le rendement en deux phases :
| Phase | Ce qui sollicite le GPU | Ce qu’il faut mesurer |
|---|---|---|
| Prefill | Longueur de l’invite, travail d’attention, déplacement de mémoire, réutilisation du cache | temps jusqu’au premier token, tokens d’invite/sec, attente dans la file |
| Decode | Longueur de sortie, orchestration du batch, bande passante du cache KV | tokens de sortie/sec, latence entre tokens, temps de fin p95/p99 |
Pour le RAG à contexte long et le trafic d’agents, le prefill peut dominer. Pour le chat en streaming avec des réponses longues, le decode peut dominer. Pour la classification en batch, les requêtes acceptées par minute peuvent compter davantage que la latence de streaming.
Latence : choisissez pour p95 et p99, pas pour la vitesse moyenne
Le meilleur GPU pour l’inférence de LLM dans le cadre d’un SLA orienté utilisateur est le GPU qui maintient la latence de queue sous charge. La latence moyenne masque l’attente en file, les voisins bruyants, les échecs de cache, les cold starts et les nouvelles tentatives après OOM.
Suivez ces métriques lors de chaque test de GPU :
\table>| Métrique | Pourquoi c’est important |
|---|---|
| Temps jusqu’au premier token | Réactivité perçue par l’utilisateur et efficacité du prefill. |
| Latence entre les tokens | Qualité du streaming et vitesse du decode. |
| Latence de bout en bout | Temps total de finalisation de la tâche. |
| Latence p95 et p99 | Véritable santé du SLO en production. |
| Attente dans la file | Si le serveur est déjà saturé avant même le début de la génération. |
| Taux d’OOM et de retry | Si le benchmark est suffisamment stable pour guider l’achat. |
| Utilisation du GPU et utilisation de la bande passante HBM | Si le GPU est le goulot d’étranglement ou si le pipeline attend ailleurs. |
Si le prix du H200 est 1,4x celui d’un H100 et qu’il offre 1,8x le débit de sortie accepté pour votre charge de travail, le H200 peut l’emporter. S’il coûte 2,2x et n’améliore le p95 que de 10 %, le H100 l’emporte probablement. Si un L40S est nettement moins cher et atteint l’objectif de latence pour un modèle de 13B, le L40S peut être la meilleure GPU pour le rapport coût-efficacité de l’inférence de LLM pour ce scénario.
Meilleure GPU pour l’inférence locale de LLM
La meilleure GPU pour l’inférence locale de LLM est une question différente de celle de la meilleure GPU de serving d’entreprise. L’inférence locale valorise généralement davantage le prix d’achat, la consommation d’énergie sur le bureau, la VRAM, la confidentialité et la commodité pour les développeurs. Le serving en production valorise la disponibilité, l’observabilité, la politique de remplacement, l’interconnexion, l’isolation multi-tenant et le support.
Pour un usage local :
- RTX 4090 et RTX 5090 sont de fortes options pour le développement local de petits modèles quantifiés, car elles offrent de hautes performances GPU grand public et suffisamment de VRAM pour de nombreuses expériences.
- Les GPU de workstation de classe RTX PRO / RTX 6000 sont meilleurs lorsque vous avez besoin de plus de VRAM, de pilotes de workstation ou d’un support professionnel.
- La mémoire unifiée Mac ou l’inférence sur CPU peut être utile pour les tests, mais ne doit pas être considérée comme un benchmark de serving sur GPU.
- Les configurations locales multi-GPU peuvent fonctionner pour la recherche, mais égalent rarement les opérations d’un centre de données cloud, à moins que votre équipe ne soit responsable de l’alimentation, du refroidissement, du réseau, de la surveillance et de la reprise après incident.
Utilisez des GPU locaux pour valider les prompts, la qualité, la quantisation et le comportement de l’application. Utilisez des GPU cloud ou de centre de données pour valider la concurrence de production, la latence p95/p99, la disponibilité, le coût par token accepté et les processus de déploiement progressif.
GPU recommandée par modèle et schéma de serving
| Schéma de serving | Courte liste de GPU | Pourquoi |
|---|---|---|
| Bot de support 7B/8B, contexte modéré | L40S, A100 40GB/80GB, H100 PCIe, RTX de classe locale pour le développement | Le modèle est assez petit pour qu’un coût horaire plus faible puisse compter davantage que la mémoire haut de gamme. |
| Assistant privé 13B-34B | L40S, A100 80GB, H100 | Choisissez en fonction de la concurrence et de l’objectif de latence ; le H100 est utile lorsque la latence de queue compte. |
| Chat 70B avec contexte modéré | H100, H200, 2x A100/H100 selon la précision | Benchmarkez la quantisation, le parallélisme tensoriel et la politique de batch. |
| RAG à long contexte 70B | H200, H100 NVL/SXM, B200 lorsque disponible | La mémoire et la pression sur le KV cache peuvent dominer. |
| API d’entreprise multi-tenant | H100/H200/B200 chez un fournisseur avec support | Le support, l’observabilité, l’isolation et la politique de remplacement comptent. |
| Inférence hors ligne en batch | A100, L40S, H100 spot ou marketplace | Le débit par dollar peut l’emporter sur la faible latence. |
| Portable ou station de travail du développeur | RTX 4090, RTX 5090, RTX PRO/workstation | Idéal pour l’inférence locale de LLM et le développement de prompts ; ce n’est pas une solution complète pour la production. |
Plan de benchmark avant de louer ou d’acheter
Ne choisissez pas la meilleure GPU pour l’inférence de LLM sur la base d’un simple benchmark générique. Lancez une reproduction qui ressemble à votre produit.
- Figez la charge de travail. Enregistrez l’ID du modèle, la quantisation, la précision, la distribution de la longueur des prompts, la distribution de la longueur des sorties, le contexte cible, la concurrence et les contrôles de qualité.
- Figez la stack de serving. Utilisez si possible la même version de vLLM, SGLang, TensorRT-LLM, NIM ou du serveur personnalisé sur tous les tests GPU.
- Figez la configuration matérielle. Capturez le SKU du GPU, le nombre de GPU, PCIe/SXM/NVL, le CPU, la RAM, le stockage, le pilote, la version de CUDA, le réseau et le placement.
- Exécutez trois profils de trafic. Le chat court, le RAG à long contexte et les prompts batch/hors ligne révèlent différents goulots d’étranglement.
- Mesurez p50, p95, p99. La latence moyenne ne suffit pas pour l’inférence orientée client.
- Suivez les échecs. Comptez les OOM, les timeouts, les évictions, les échecs de cold start et l’amplification des retries.
- Calculez le coût accepté. Divisez le coût effectif par les tokens de sortie acceptés, les réponses acceptées ou les tâches terminées.
- Exécutez au moins une journée de canary. Les prix du marketplace, la disponibilité du fournisseur et la mise en file d’attente peuvent changer pendant les véritables fenêtres de trafic.
Tableau de benchmark minimal :
| Métrique | GPU candidate A | GPU candidate B | GPU candidate C |
|---|---|---|---|
| Prix horaire du GPU | |||
| Coût horaire effectif | |||
| Tokens de sortie acceptés/horaire | |||
| Coût par 1M de tokens de sortie acceptés | |||
| Temps jusqu’au premier token p95 | |||
| Latence de bout en bout p95/p99 | |||
| Taux d’OOM ou de retry | |||
| Utilisation moyenne du GPU | |||
| Notes sur les opérations |
Quand une API de modèle surpasse la location de GPU
La meilleure GPU pour l’inférence de LLM peut en réalité être l’absence totale de location de GPU. Le contrôle direct du GPU est précieux lorsque vous disposez de poids propriétaires, d’une utilisation soutenue, de kernels personnalisés, d’une forte localité des données ou d’une équipe de serving capable de maintenir les GPU occupés.
Utilisez une API de modèle ou un routeur lorsque :
- Le trafic est irrégulier.
- Vous avez besoin de plusieurs fournisseurs de modèles, plutôt que d’un seul modèle open-weight fixe.
- Le choix du modèle change fréquemment.
- Vous avez davantage besoin de fallback que de contrôle bare-metal.
- Le temps d’inactivité du GPU dépasserait toute prime d’API par token.
- Votre équipe veut des journaux d’utilisation, des limites budgétaires, des factures et une gouvernance des fournisseurs sans exploiter un cluster de serving.
Flatkey s’inscrit de ce côté de la décision : une clé, un solde, une facture, plus de 300 modèles officiels, plus de 1 000 outils pay-per-call et des journaux d’utilisation au niveau de la requête. Si une charge de travail ne nécessite pas de poids auto-hébergés, comparez le coût du GPU par token accepté avec des routes de modèle gérées avant de vous engager dans un cluster de GPU.
Pour des décisions de coût connexes, consultez les guides Flatkey sur les prix de location de GPU, H100 vs A100, H200 vs H100, location de cluster GPU, vLLM vs SGLang et comparaison des prix des modèles d’IA.
Recommandation finale
La meilleure GPU pour l’inférence de LLM dépend de la charge de travail :
- Utilisez H200 lorsque la mémoire, le long contexte et la pression sur le cache KV déterminent le coût.
- Utilisez H100 lorsque vous avez besoin d’un standard de production éprouvé et que la charge de travail s’y prête.
- Utilisez B200 ou GB200 lorsqu’une capacité Blackwell est disponible, que la stack de serving est prête et que votre benchmark justifie la prime.
- Utilisez L40S ou A100 lorsque le rapport coût-efficacité l’emporte sur la latence maximale.
- Utilisez des GPU locaux de classe RTX pour le développement et l’inférence locale de LLM, pas pour du serving multi-tenant d’entreprise.
- Utilisez Flatkey ou une autre couche d’API de modèle lorsque l’exploitation directe des GPU n’est pas l’avantage du produit.
La métrique d’achat n’est pas « quel GPU est le plus rapide ? » C’est le coût par token accepté au niveau de latence et de fiabilité qu’exige votre produit.
Foire aux questions
Quelle est la meilleure GPU pour l’inférence de LLM ?
La meilleure GPU pour l’inférence de LLM dépend de la charge de travail. La H200 est souvent le point de départ le plus solide pour le serving de 70B et les longs contextes limités par la mémoire. La H100 est le standard de production mature. La L40S, la A100, la RTX 4090 ou la RTX 5090 peuvent être meilleures pour des modèles plus petits, des traitements par lots ou de l’inférence locale lorsqu’elles atteignent l’objectif de latence à moindre coût.
Quelle est la meilleure GPU pour le rapport coût-efficacité dans l’inférence de LLM ?
La meilleure GPU pour le rapport coût-efficacité dans l’inférence de LLM est celle qui offre le coût le plus bas par token accepté ou par réponse acceptée, et non le prix horaire le plus bas. Calculez le coût horaire effectif, les tokens de sortie acceptés par heure, la latence p95/p99 et le taux d’échec avant de choisir.
Comment calculer la meilleure GPU pour l’inférence de LLM en token/s/USD ?
Utilisez les tokens de sortie acceptés par heure divisés par le coût horaire effectif. Le coût effectif doit inclure la location du GPU, le stockage, la bande passante, le temps d’inactivité, les retries, le support et les frais d’ingénierie. Comparez ensuite le même modèle, la même précision, la même longueur de contexte et la même stack de serving entre GPU.
H100 ou H200 est-elle meilleure pour l’inférence de LLM ?
La H200 est généralement meilleure lorsque la capacité mémoire, la bande passante, le long contexte ou un cache KV plus grand modifient la forme du serving. La H100 est généralement meilleure lorsque le modèle s’y adapte bien, que la capacité est moins chère ou plus facile à obtenir, et que le benchmark atteint les objectifs de latence et de rendement.
La B200 est-elle la meilleure GPU pour l’inférence de LLM ?
Les systèmes B200 ou GB200 peuvent être excellents pour l’inférence de LLM à grande échelle lorsque le fournisseur dispose d’une capacité réelle, que le framework de serving prend en charge la précision et la topologie que vous prévoyez d’utiliser, et que le benchmark prouve un coût accepté plus faible. N’achetez pas de capacité Blackwell sur la seule base de promesses de lancement ; testez votre trafic.
Quelle est la meilleure GPU pour l’inférence locale de LLM ?
Pour l’inférence locale de LLM, la RTX 4090 et la RTX 5090 sont des choix courants à haute performance pour les développeurs, tandis que les cartes RTX PRO ou de classe RTX 6000 sont meilleures lorsque vous avez besoin de plus de VRAM ou d’un support professionnel pour workstation. Les GPU locaux sont meilleurs pour le développement, la confidentialité et les petits déploiements, pas pour la fiabilité complète du serving d’entreprise.
Sources vérifiées
- GPU NVIDIA H200 : https://www.nvidia.com/en-us/data-center/h200/
- GPU NVIDIA H100 Tensor Core : https://www.nvidia.com/en-us/data-center/h100/
- GPU NVIDIA A100 Tensor Core : https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA DGX B200 : https://www.nvidia.com/en-us/data-center/dgx-b200/
- GPU NVIDIA L40S : https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA GeForce RTX 5090 : https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- Tarifs du cloud GPU de RunPod : https://www.runpod.io/pricing
- Tarifs du cloud GPU de Lambda : https://lambda.ai/pricing
- Instances AWS EC2 P5 : https://aws.amazon.com/ec2/instance-types/p5/
- Types de machines avec GPU de Google Cloud : https://docs.cloud.google.com/docs/compute-area/gpus
- Documentation du serveur compatible OpenAI de vLLM : https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html


