
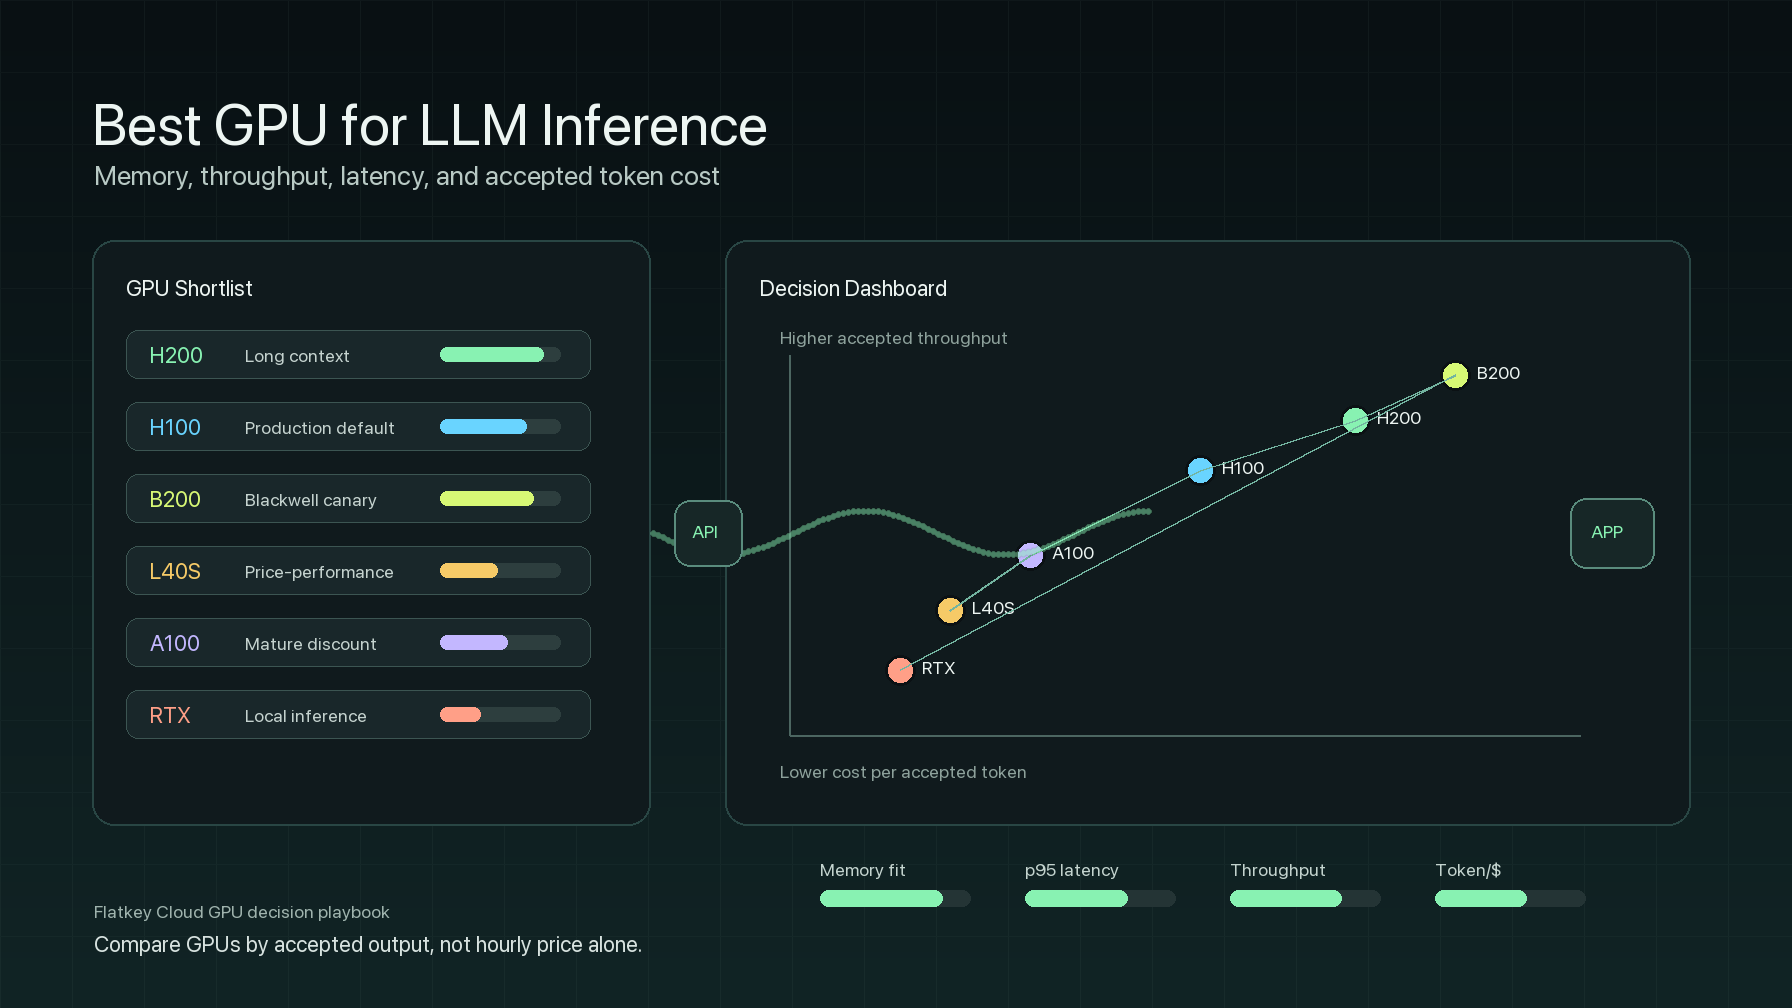
GPU terbaik untuk inferensi LLM adalah GPU yang memenuhi campuran prompt nyata Anda dengan biaya terendah yang dapat diterima, sambil memenuhi target memori, latensi, dan keandalan. Itu tidak selalu GPU terbaru, daftar harga per jam termurah, atau kartu dengan hasil benchmark tertinggi.
Untuk sebagian besar tim AI enterprise, jawaban singkatnya adalah:
- Pilih H200 ketika memori menjadi bottleneck: serving kelas 70B, RAG konteks panjang, konkurensi tinggi, atau KV cache yang membuat H100 terlalu dekat dengan batas.
- Pilih H100 ketika Anda membutuhkan standar produksi yang matang, dengan dukungan software yang kuat, ketersediaan cloud yang luas, dan throughput yang baik tanpa bermigrasi ke kapasitas Blackwell yang baru.
- Pilih B200, GB200, atau sistem Blackwell yang lebih baru ketika stack Anda dapat memanfaatkan presisi dan topologi era Blackwell, dan penyedia dapat membuktikan ketersediaan, harga, dan dukungan operasional yang nyata.
- Pilih L40S atau A100 ketika nilai biaya-manfaat lebih penting daripada latensi puncak, model muat tanpa masalah, dan beban kerja Anda bersifat batch, internal, atau konteks sedang.
- Pilih RTX 4090, RTX 5090, atau GPU workstation untuk inferensi LLM lokal, pengembangan, demo, dan beban kerja privat kecil, bukan untuk serving enterprise multi-tenant.
- Gunakan API model atau router alih-alih menyewa GPU ketika trafik bersifat bursty, pilihan model sering berubah, atau mengoperasikan stack serving bukan merupakan keunggulan Anda.
Panduan ini menjelaskan cara memilih GPU terbaik untuk inferensi LLM berdasarkan memori, throughput, latensi, dan biaya per token. Ini juga mencakup matriks keputusan, rencana benchmark, dan lembar kerja token per dolar yang dapat Anda gunakan kembali sebelum menyewa atau membeli kapasitas.
GPU terbaik untuk inferensi LLM: matriks keputusan cepat
| Beban kerja | GPU terbaik untuk memulai | Mengapa biasanya cocok | Hal yang perlu diperhatikan |
|---|---|---|---|
| chat 7B-13B, alat internal, prototipe | L40S, RTX 4090, RTX 5090, A100 40GB atau kapasitas cloud kelas L4 | Biaya per jam yang lebih rendah bisa lebih penting daripada kecepatan puncak akselerator ketika model kecil dan konkurensi sedang. | Jangan mengekstrapolasi latensi demo lokal ke trafik produksi p95/p99. |
| inferensi 30B-34B | L40S, A100 80GB, H100 PCIe/SXM | Memori yang cukup untuk konfigurasi serving praktis, dengan lantai biaya lebih rendah daripada H200 atau B200. | Konkurensi tinggi dan konteks panjang dapat mendorong beban kerja ke wilayah H100/H200. |
| inferensi kelas 70B | H100, H200 atau A100/H100 multi-GPU | H100 adalah basis yang matang; H200 menarik ketika memori dan tekanan KV cache mengurangi jumlah GPU yang diperlukan. | Quantization, paralelisme tensor, dan kebijakan batch menentukan biaya sebenarnya. |
| RAG konteks panjang | H200 terlebih dahulu, lalu H100 NVL/SXM atau B200, jika tersedia | KV cache dan prefill prompt dapat membuat kapasitas dan bandwidth memori lebih penting daripada harga per jam bruto. | Benchmark dengan panjang konteks yang nyata, bukan hanya prompt singkat. |
| inferensi batch throughput tinggi | A100, L40S, H100 atau H100 spot/marketplace | Throughput per dolar sering kali mengungguli latensi terendah ketika job dapat mengantre. | Masukkan retries, gangguan, cold start, dan biaya penyimpanan. |
| chat pelanggan sensitif latensi | H100, H200 atau B200, tergantung ukuran model | GPU data center yang lebih baru memiliki dukungan stack serving, bandwidth, dan ruang lebih baik untuk konkurensi. | Latensi p95 dan p99 lebih penting daripada rata-rata token/detik. |
| inferensi LLM lokal | RTX 4090, RTX 5090, kartu workstation RTX PRO / kelas RTX 6000 | Kartu lokal berguna untuk pengembangan privat, pengujian offline, dan model kecil. | Kartu konsumen tidak menggantikan keandalan multi-tenant yang dikelola. |
| produksi yang diatur atau enterprise | H100/H200/B200 di penyedia dengan dukungan, jaringan, isolasi, dan kontrol audit | Lapisan operasional bisa lebih penting daripada nama GPU. | Verifikasi SLA, kebijakan penggantian, jaringan, penyimpanan, dan observabilitas. |
Aturan praktisnya: GPU terbaik untuk inferensi LLM berubah ketika ukuran model, panjang konteks, konkurensi, presisi, framework serving, dan harga berubah. Buat GPU layak untuk beban kerjanya.
Mengapa memori biasanya menentukan shortlist pertama
Inferensi LLM menggunakan memori GPU untuk lebih dari sekadar bobot model. Server produksi juga memerlukan KV cache, overhead runtime, buffer batching, adapter, overhead tokenizer/server, dan kadang speculative decoding atau buffer output terstruktur.
Gunakan model memori tahap pertama ini:
required_vram =
  model_weights
  + KV_cache_for_target_context_and_concurrency
  + runtime_overhead
  + safety_margin
KV cache adalah alasan mengapa model yang muat untuk demo singkat bisa gagal dalam produksi. Prompt yang panjang, batch yang lebih besar, lebih banyak permintaan konkuren, dan batas output yang lebih besar meningkatkan tekanan memori. GPU dengan rasio biaya-manfaat terbaik untuk inferensi LLM sering kali adalah GPU yang mencegah shard tambahan, mencegah percobaan ulang setelah kehabisan memori, atau memungkinkan Anda mempertahankan batch yang lebih besar tanpa mengorbankan latensi p95.
Kapasitas memori juga mengubah operasi:
| Kondisi memori | Apa artinya bagi serving LLM |
|---|---|
| Ruang cadangan berlebih | Anda dapat menyesuaikan ukuran batch, panjang konteks, dan konkurensi tanpa risiko OOM segera. |
| Mendekati batas | Quantization, batch yang lebih kecil, konteks yang lebih pendek, atau paralelisme tensor menjadi wajib. |
| Melampaui batas | Anda memerlukan GPU tambahan, GPU dengan memori lebih besar, model yang lebih kecil, presisi lebih rendah, atau jalur via API. |
NVIDIA mencantumkan H200 dengan memori HBM3e 141GB dan bandwidth memori 4.8TB/s. Halaman NVIDIA untuk H100 menempatkan H100 sebagai basis matang Hopper, sementara halaman AWS P5 menunjukkan keluarga instance H100 dan H200 dengan hingga 8 GPU per node dan bandwidth GPU-to-GPU NVSwitch. Untuk pekerjaan pembelian, poin pentingnya bukan satu baris spesifikasi. Yang penting adalah apakah memori tambahan mengurangi jumlah GPU, menyederhanakan sharding, atau meningkatkan throughput yang diterima.
Throughput: token per detik saja tidak cukup
Token/detik mentah berguna, tetapi itu bukan metrik pembeli. Untuk layanan produksi, ukur pekerjaan yang diterima:
accepted_output_rendimento =
  accepted output tokens or accepted responses
  / wall-clock benchmark duration
Lalu normalkan berdasarkan biaya:
token_per_dollar =
  accepted output tokens per hour
  / effective hourly cost
Inilah metrik inti di balik pencarian GPU terbaik untuk inferensi LLM token/s/usd. GPU yang lebih murah dapat menang ketika tetap terpakai dengan baik dan target latensinya lebih fleksibel. GPU yang lebih mahal dapat menang ketika meningkatkan ukuran batch, mengurangi replika, menghindari kegagalan memori, atau menjaga latensi p95/p99 tetap dalam target service level.
Bagilah throughput menjadi dua fase:
| Fase | Apa yang membebani GPU | Apa yang diukur |
|---|---|---|
| Prefill | Panjang prompt, kerja attention, perpindahan memori, reuse cache | waktu hingga token pertama, token prompt/detik, waktu tunggu antrean |
| Decode | Panjang output, penjadwalan batch, bandwidth cache KV | token output/detik, latensi antar token, waktu selesai p95/p99 |
Untuk RAG dengan konteks panjang dan traffic agen, prefill bisa mendominasi. Untuk chat streaming dengan jawaban panjang, decode bisa mendominasi. Untuk klasifikasi dalam batch, permintaan yang diterima per menit bisa lebih penting daripada latensi streaming.
Latensi: pilih untuk p95 dan p99, bukan untuk kecepatan rata-rata
GPU terbaik untuk inferensi LLM dalam SLA yang berorientasi ke pengguna adalah GPU yang menjaga latensi ekor tetap rendah di bawah beban. Latensi rata-rata menutupi antrean, tetangga yang berisik, cache miss, cold start, dan percobaan ulang setelah OOM.
Pantau metrik berikut pada setiap pengujian GPU:
able>| Metrik | Mengapa penting |
|---|---|
| Waktu hingga token pertama | Responsivitas yang dirasakan pengguna dan efisiensi prefill. |
| Latensi antar token | Kualitas streaming dan kecepatan decode. |
| Latensi end-to-end | Waktu total penyelesaian tugas. |
| Latensi p95 dan p99 | Kesehatan SLO yang sesungguhnya dalam produksi. |
| Waktu tunggu antrean | Apakah server sudah kewalahan bahkan sebelum generasi dimulai. |
| Tingkat OOM dan retry | Apakah benchmark cukup stabil untuk memandu pembelian. |
| Utilisasi GPU dan utilisasi bandwidth HBM | Apakah GPU menjadi bottleneck atau pipeline menunggu di tempat lain. |
Jika kutipan H200 adalah 1,4x kutipan H100 dan ia memberikan 1,8x throughput output yang diterima untuk beban kerja Anda, H200 bisa menang. Jika biayanya 2,2x dan hanya meningkatkan p95 sebesar 10%, H100 kemungkinan menang. Jika L40S jauh lebih murah dan memenuhi target latensi untuk model 13B, L40S bisa menjadi GPU terbaik untuk cost-benefit inferensi LLM untuk skenario tersebut.
GPU terbaik untuk inferensi LLM lokal
GPU terbaik untuk inferensi LLM lokal adalah pertanyaan yang berbeda dari GPU terbaik untuk serving enterprise. Inferensi lokal biasanya menekankan harga pembelian, konsumsi daya di meja, VRAM, privasi, dan kemudahan bagi developer. Serving produksi menekankan ketersediaan, observabilitas, kebijakan failover, interkoneksi, isolasi multi-tenant, dan dukungan.
Untuk penggunaan lokal:
- RTX 4090 dan RTX 5090 adalah opsi kuat untuk pengembangan lokal model kecil dan terkuantisasi, karena menawarkan performa GPU konsumen yang tinggi dan VRAM yang cukup untuk banyak eksperimen.
- GPU workstation kelas RTX PRO / RTX 6000 lebih baik ketika Anda membutuhkan lebih banyak VRAM, driver workstation, atau dukungan profesional.
- Memori terpadu Mac atau inferensi di CPU dapat berguna untuk pengujian, tetapi tidak boleh dianggap sebagai benchmark serving di GPU.
- Rig lokal dengan banyak GPU dapat bekerja untuk riset, tetapi jarang menyamai operasi data center cloud, kecuali tim Anda bertanggung jawab atas daya, pendinginan, jaringan, pemantauan, dan pemulihan kegagalan.
Gunakan GPU lokal untuk memvalidasi prompt, kualitas, kuantisasi, dan perilaku aplikasi. Gunakan GPU cloud atau data center untuk memvalidasi konkurensi produksi, latensi p95/p99, ketersediaan, biaya per token yang diterima, dan proses rollout.
GPU yang direkomendasikan berdasarkan model dan pola serving
| Pola serving | Daftar singkat GPU | Mengapa |
|---|---|---|
| Bot dukungan 7B/8B, konteks sedang | L40S, A100 40GB/80GB, H100 PCIe, RTX kelas lokal untuk pengembangan | Modelnya cukup kecil sehingga biaya per jam yang lebih rendah bisa lebih penting daripada memori kelas atas. |
| Asisten privat 13B-34B | L40S, A100 80GB, H100 | Pilih berdasarkan konkurensi dan target latensi; H100 berguna ketika latensi ekor penting. |
| Chat 70B dengan konteks sedang | H100, H200, 2x A100/H100 tergantung presisi | Lakukan benchmark pada kuantisasi, paralelisme tensor, dan kebijakan batch. |
| RAG konteks panjang 70B | H200, H100 NVL/SXM, B200 jika tersedia | Memori dan tekanan pada KV cache dapat menjadi faktor dominan. |
| API enterprise multi-tenant | H100/H200/B200 pada penyedia dengan dukungan | Dukungan, observabilitas, isolasi, dan kebijakan failover sangat penting. |
| Inferensi batch offline | A100, L40S, H100 spot atau marketplace | Throughput per dolar dapat mengungguli latensi yang lebih rendah. |
| Laptop atau desktop developer | RTX 4090, RTX 5090, RTX PRO/workstation | Sangat baik untuk inferensi LLM lokal dan pengembangan prompt; bukan jawaban lengkap untuk produksi. |
Rencana benchmark sebelum menyewa atau membeli
Jangan memilih GPU terbaik untuk inferensi LLM hanya berdasarkan benchmark generik. Jalankan reproduksi yang menyerupai produk Anda.
- Kunci beban kerja. Catat ID model, kuantisasi, presisi, distribusi panjang prompt, distribusi panjang output, konteks target, konkurensi, dan pemeriksaan kualitas.
- Kunci stack serving. Gunakan versi vLLM, SGLang, TensorRT-LLM, NIM, atau server kustom yang sama di semua tes GPU, jika memungkinkan.
- Kunci konfigurasi hardware. Catat SKU GPU, jumlah GPU, PCIe/SXM/NVL, CPU, RAM, penyimpanan, driver, versi CUDA, jaringan, dan penempatan.
- Jalankan tiga jejak trafik. Chat singkat, RAG konteks panjang, dan prompt batch/offline mengungkap bottleneck yang berbeda.
- Ukur p50, p95, p99. Latensi rata-rata tidak cukup untuk inferensi yang ditujukan ke pelanggan.
- Lacak kegagalan. Hitung OOM, timeout, eviction, kegagalan cold start, dan amplifikasi retry.
- Hitung biaya yang diterima. Bagi biaya efektif dengan token output yang diterima, respons yang diterima, atau tugas yang selesai.
- Jalankan setidaknya satu hari canary. Harga marketplace, ketersediaan penyedia, dan antrean dapat berubah selama jendela trafik nyata.
Tabel benchmark minimum:
| Metrik | GPU kandidat A | GPU kandidat B | GPU kandidat C |
|---|---|---|---|
| Harga GPU per jam | |||
| Biaya efektif per jam | |||
| Token output yang diterima/jam | |||
| Biaya per 1M token output yang diterima | |||
| Waktu ke token pertama p95 | |||
| Latensi end-to-end p95/p99 | |||
| Tingkat OOM atau retry | |||
| Utilisasi rata-rata GPU | |||
| Catatan operasional |
Kapan API model mengalahkan penyewaan GPU
GPU terbaik untuk inferensi LLM sebenarnya bisa jadi bukan menyewa GPU sama sekali. Kontrol langsung atas GPU bernilai ketika Anda memiliki bobot proprietary, pemakaian yang berkelanjutan, kernel khusus, lokalitas data yang kuat, atau tim serving yang mampu menjaga GPU tetap sibuk.
Gunakan API model atau router ketika:
- Lalu lintas tidak teratur.
- Anda membutuhkan beberapa penyedia model, bukan satu model open-weight yang tetap.
- Pilihan model sering berubah.
- Anda lebih membutuhkan fallback daripada kontrol bare-metal.
- Waktu menganggur GPU akan melebihi premi API per token apa pun.
- Tim Anda menginginkan log penggunaan, batas anggaran, faktur, dan tata kelola penyedia tanpa mengoperasikan cluster serving.
Flatkey cocok pada sisi keputusan ini: satu kunci, satu saldo, satu faktur, lebih dari 300 model resmi, lebih dari 1.000 alat pay-per-call, dan log penggunaan di tingkat permintaan. Jika suatu beban kerja tidak memerlukan bobot yang di-host sendiri, bandingkan biaya GPU per token yang diterima dengan rute model terkelola sebelum berkomitmen ke cluster GPU.
Untuk keputusan biaya terkait, lihat panduan Flatkey tentang harga sewa GPU, H100 vs A100, H200 vs H100, sewa cluster GPU, vLLM vs SGLang, dan perbandingan harga model AI.
Rekomendasi akhir
GPU terbaik untuk inferensi LLM bergantung pada beban kerja:
- Gunakan H200 ketika memori, konteks panjang, dan tekanan pada KV cache menentukan biaya.
- Gunakan H100 ketika Anda membutuhkan standar produksi yang terbukti dan beban kerja sesuai.
- Gunakan B200 atau GB200 ketika kapasitas Blackwell tersedia, stack serving sudah siap, dan benchmark Anda membuktikan premi tersebut.
- Gunakan L40S atau A100 ketika efisiensi biaya mengungguli latensi maksimum.
- Gunakan GPU lokal kelas RTX untuk pengembangan dan inferensi LLM lokal, bukan untuk serving multi-tenant tingkat enterprise.
- Gunakan Flatkey atau lapisan API model lainnya ketika mengoperasikan GPU secara langsung bukan keunggulan produk.
Metrik pembelian bukanlah "GPU mana yang paling cepat?" Melainkan biaya per token yang diterima pada tingkat latensi dan keandalan yang dibutuhkan produk Anda.
Pertanyaan umum
Apa GPU terbaik untuk inferensi LLM?
GPU terbaik untuk inferensi LLM bergantung pada beban kerja. H200 sering menjadi titik awal terkuat untuk serving 70B dan konteks panjang yang dibatasi oleh memori. H100 adalah standar produksi yang matang. L40S, A100, RTX 4090, atau RTX 5090 bisa lebih baik untuk model yang lebih kecil, job batch, atau inferensi lokal ketika mereka memenuhi target latensi dengan biaya lebih rendah.
Apa GPU terbaik untuk efisiensi biaya pada inferensi LLM?
GPU terbaik untuk efisiensi biaya pada inferensi LLM adalah GPU dengan biaya per token yang diterima atau respons yang diterima paling rendah, bukan harga per jam terendah. Hitung biaya efektif per jam, token keluaran yang diterima per jam, latensi p95/p99, dan tingkat kegagalan sebelum memilih.
Bagaimana cara menghitung GPU terbaik untuk inferensi LLM dalam token/s/usd?
Gunakan token keluaran yang diterima per jam dibagi biaya efektif per jam. Biaya efektif harus mencakup sewa GPU, penyimpanan, bandwidth, waktu menganggur, retry, dukungan, dan overhead engineering. Lalu bandingkan model yang sama, presisi, panjang konteks, dan stack serving di antara GPU.
H100 atau H200 yang lebih baik untuk inferensi LLM?
H200 umumnya lebih baik ketika kapasitas memori, bandwidth, konteks panjang, atau KV cache yang lebih besar mengubah bentuk serving. H100 umumnya lebih baik ketika model cocok dengan baik, kapasitasnya lebih murah atau lebih mudah diperoleh, dan benchmark memenuhi target latensi serta throughput.
Apakah B200 adalah GPU terbaik untuk inferensi LLM?
Sistem B200 atau GB200 bisa sangat baik untuk inferensi LLM skala besar ketika penyedia memiliki kapasitas nyata, framework serving mendukung presisi dan topologi yang ingin Anda gunakan, dan benchmark membuktikan biaya yang diterima lebih rendah. Jangan membeli kapasitas Blackwell hanya berdasarkan janji peluncuran; uji trafik Anda.
Apa GPU terbaik untuk inferensi LLM lokal?
Untuk inferensi LLM lokal, RTX 4090 dan RTX 5090 adalah pilihan berperforma tinggi yang umum untuk developer, sementara kartu RTX PRO atau kelas RTX 6000 lebih baik ketika Anda membutuhkan VRAM lebih besar atau dukungan profesional untuk workstation. GPU lokal lebih baik untuk pengembangan, privasi, dan deployment kecil, bukan untuk keandalan penuh serving enterprise.
Sumber terverifikasi
- GPU NVIDIA H200: https://www.nvidia.com/en-us/data-center/h200/
- GPU NVIDIA H100 Tensor Core: https://www.nvidia.com/en-us/data-center/h100/
- GPU NVIDIA A100 Tensor Core: https://www.nvidia.com/en-us/data-center/a100/
- NVIDIA DGX B200: https://www.nvidia.com/en-us/data-center/dgx-b200/
- GPU NVIDIA L40S: https://www.nvidia.com/en-us/data-center/l40s/
- NVIDIA GeForce RTX 5090: https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
- Harga cloud GPU RunPod: https://www.runpod.io/pricing
- Harga cloud GPU Lambda: https://lambda.ai/pricing
- Instans AWS EC2 P5: https://aws.amazon.com/ec2/instance-types/p5/
- Jenis mesin dengan GPU Google Cloud: https://docs.cloud.google.com/docs/compute-area/gpus
- Dokumentasi server OpenAI-compatible vLLM: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html


