
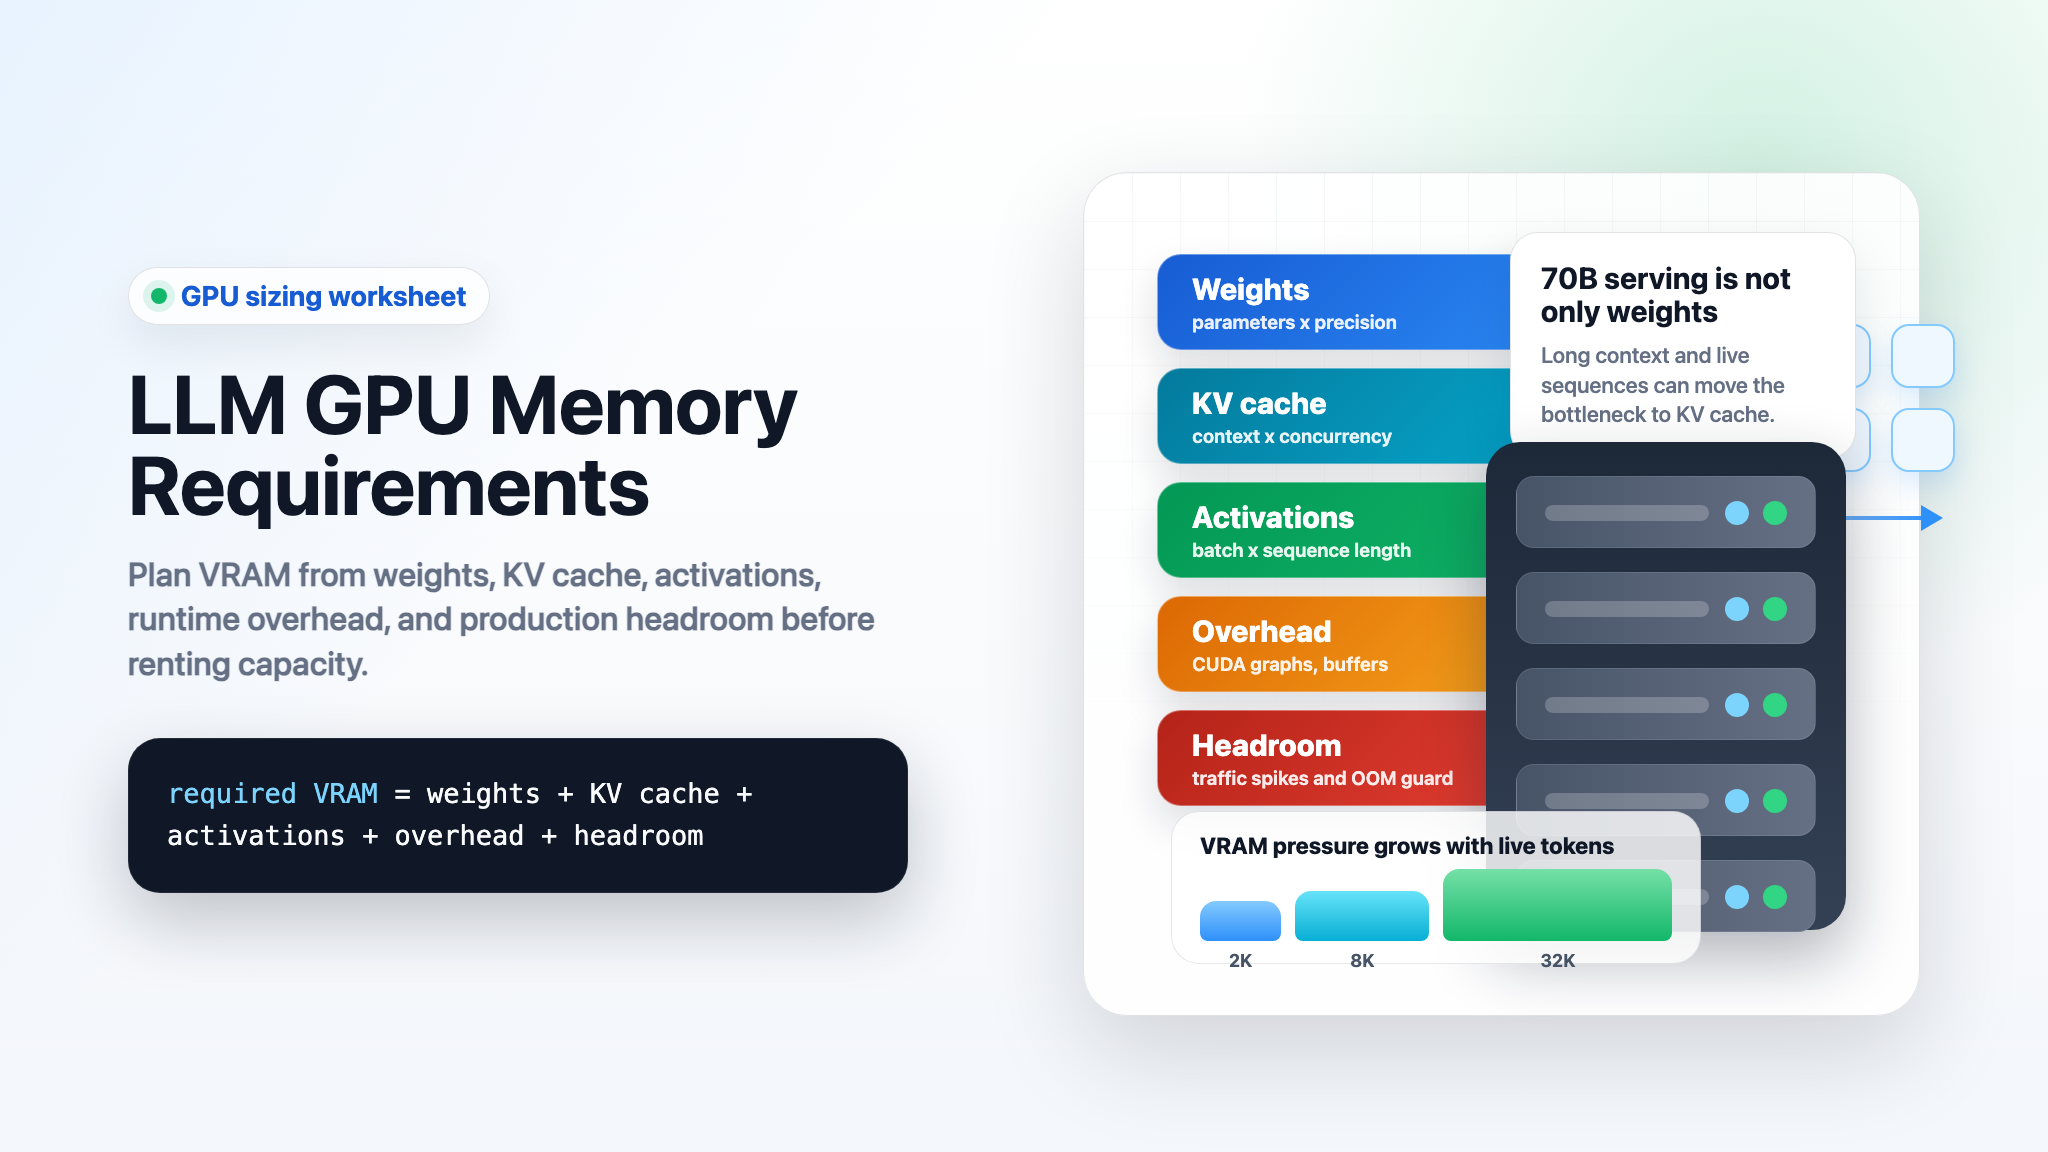
LLM の GPU メモリ要件は、単なる「モデルサイズに少し余裕を足したもの」ではありません。サービングやトレーニングのジョブには、モデル重み、KV キャッシュ、アクティベーション、フレームワークのワークスペース、CUDA グラフ、一時バッファ、運用上のヘッドルームなど、複数の独立したメモリ領域があります。
簡単な計画ルールは次のとおりです:
required VRAM =
  model weights
+ KV cache for live tokens
+ activation and workspace memory
+ training state, if training or full fine-tuning
+ allocator and safety headroom
そのため、同じ 70B モデルを同じ GPU クラスで実行しても、2 つのチームで結果が異なることがあります。片方は短いプロンプト、1 ストリーム、FP8 KV キャッシュ、保守的なバッチ処理を使います。もう片方は長いコンテキスト、多数の同時リクエスト、CUDA graph capture、高い gpu_memory_utilization 設定を使います。前者は収まります。後者は out-of-memory エラーで失敗するか、他所へ処理を逃がしてレイテンシを悪化させます。
このガイドでは、推論、vLLM サービング、ファインチューニング、トレーニングにわたる llm gpu memory requirements の実用的なワークシートを示します。GPU を借りる前、H100 と H200 と B200 の容量を選ぶ前、あるいは自前の GPU エンドポイントを運用するよりモデル API のほうが簡単かどうかを判断する前に使ってください。
LLMのGPUメモリ要件の要点
推論では、まず重みを基準にし、次にコンテキスト長と同時実行数から KV キャッシュを見積もります。トレーニングでは、重みは出発点にすぎません。オプティマイザ状態、勾配、保存されたアクティベーションがメモリ計画の大部分を占めます。
| Workload | What usually dominates VRAM | Fast planning rule |
|---|---|---|
| Single-request inference | Weights | parameters x bytes_per_weight の後、プロンプトと生成トークンの KV キャッシュを追加します。 |
| High-throughput inference | KV cache and scheduler headroom | モデルのパラメータ数だけでなく、concurrent sequences x tokens per sequence で容量を見積もります。 |
| Long-context serving | KV cache | コンテキスト長を 2 倍にすると、同じモデルとバッチで KV キャッシュのメモリもほぼ 2 倍になります。 |
| Full fine-tuning | Optimizer states, gradients, activations | mixed-precision AdamW では、アクティベーションの前にモデル重みメモリの何倍も必要になることがあります。 |
| LoRA or adapter tuning | Base weights plus activations and adapter state | フルファインチューニングより大幅に小さいですが、長いコンテキストとバッチサイズは依然として重要です。 |
| Pretraining | Training state plus activations plus distributed overhead | 測定済みのフレームワーク実行から計画してください。式は最初の見積もりにすぎません。 |
モデル出力だけが必要なら、まずは直接 GPU サービングとモデル API のベースラインを比較してください。カスタム重み、配置制御、プライベートなランタイムポリシー、あるいは利用率を測定した後のほうが安価なワークロードが必要なら、直接 GPU が有効です。主に信頼性の高い API 応答が必要なだけなら、マネージドなモデル経由で GPU のサイズ決定、キューイング、運用にかかる数週間を避けられます。
LLMのGPUメモリ要件ワークシート
インスタンスを選ぶ前に、このワークシートを使ってください。
| Bucket | Formula or check | Notes |
|---|---|---|
| Weights | parameter_count x weight_bytes |
BF16/FP16 はパラメータ 1 個あたり約 2 バイトを使用します。INT8 は約 1 バイトです。4-bit は量子化メタデータの前で約 0.5 バイトです。 |
| KV cache | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
2 は key と value を表します。Grouped-query attention は full multi-head attention と比べて kv_heads を削減します。 |
| Activations | Inference: usually modest. Training: scales with batch, sequence length, hidden size, layers, and checkpointing choices. | Hugging Face の model memory anatomy では、トレーニング時の weights、optimizer states、gradients、saved activations、temporary buffers、そして機能固有のメモリを挙げています。 |
| Serving framework reserve | vLLM, TensorRT-LLM, SGLang, PyTorch, CUDA graphs, attention kernels, scheduling queues | vLLM は gpu_memory_utilization、kv_cache_memory_bytes、kv_cache_dtype、max_model_len、max_num_seqs などのメモリ制御を公開しています。 |
| Safety headroom | 10-20% for production, more during first benchmarks | allocator の断片化、トラフィック急増、より長いプロンプト、モデルの再ロード、可観測性エージェントのための余裕を残してください。 |
最も一般的なミスは、重みは収まるのにライブトークンを忘れることです。LLM inference GPU memory requirements の見積もりでは、KV キャッシュが安定したエンドポイントと OOM ループの分かれ目になります。
ステップ1: モデル重みメモリを計算する
重みは、LLM ワークロードにおける GPU メモリ要件の中で最も単純な部分です。
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| Model size | BF16 / FP16 weights | INT8 weights | 4-bit weights before metadata |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
この表は下限値です。実運用では、量子化スケール、非パラメータバッファ、トークナイザー/ランタイム状態、一時ワークスペース、そしてサービングのオーバーヘッドが追加されます。
vLLM GPU memory requirements 70B model VRAM の見積もりでは、BF16/FP16 の重みだけで単一の 80 GB H100 をすでに超えます。NVIDIA の H200 ページによると、単一の H200 は 141 GB の HBM3e を備えているため、理論上は重みを収められますが、残りの KV cache とランタイムの余裕を考えると、より小さいコンテキスト、低い同時実行数、KV-cache の量子化、またはテンソル並列が必要になる場合があります。NVIDIA は H100 SXM を 80 GB、H200 を 141 GB、DGX B200 を合計 1,440 GB の HBM3e を持つ 8 枚の Blackwell GPU として掲載しており、これはそのシステムでは実質的に B200 GPU 1 枚あたり 180 GB に相当します。
ステップ 2: LLM GPU memory requirements の KV cache メモリを計算する
KV cache は、すでに処理済みのトークンの attention の key と value を保存するために使われるメモリです。これにより、モデルは毎回プレフィックス全体を再計算せずに生成できます。
decoder-only transformer の推論では、次のようになります:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
ここで:
| 変数 | 意味 |
|---|---|
active_tokens |
現在キャッシュに常駐している、実行中リクエスト全体のプロンプトと生成済みトークンの合計。 |
num_layers |
Transformer の層数。 |
num_kv_heads |
KV heads。attention heads とは限りません。grouped-query attention により、これがかなり小さくなることがあります。 |
head_dim |
各 head の次元。 |
2 |
key と value のテンソル。 |
bytes_per_kv_element |
BF16/FP16 では 2、FP8 では 1、対応する低ビットの cache モードではさらに低くなります。 |
例として、80 層、8 KV heads、128 head dimension を持つ Llama 風の 70B 形状では次のようになります:
80 x 8 x 128 x 2 x 2 bytes = 327,680 bytes per token
これは、BF16/FP16 KV cache における active token 1 個あたり約 0.3125 MiB に相当します。
| シーケンスあたりのアクティブコンテキスト | 1 シーケンス分のおおよその KV cache | 16 個の同時実行シーケンス分のおおよその KV cache |
|---|---|---|
| 2,048 tokens | ~0.6 GiB | ~10.0 GiB |
| 4,096 tokens | ~1.3 GiB | ~20.0 GiB |
| 8,192 tokens | ~2.5 GiB | ~40.0 GiB |
| 16,384 tokens | ~5.0 GiB | ~80.0 GiB |
| 32,768 tokens | ~10.0 GiB | ~160.0 GiB |
正確な数値はモデルアーキテクチャによって変わります。より多くの KV heads を持つモデルは、より多くの KV メモリを使用します。multi-query または grouped-query attention を持つモデルは、完全な multi-head attention 設計よりもはるかに少ない KV メモリで済む場合があります。
vLLM は、ここで重要になるいくつかの設定項目を文書化しています。--gpu-memory-utilization はモデル実行器が使用する GPU メモリの割合を制御し、--kv-cache-memory-bytes は KV cache のサイズを明示的に指定でき、--kv-cache-dtype は cache の精度を選択でき、さらに conserving-memory ガイドではメモリが逼迫しているときに max_model_len と max_num_seqs を減らすことを推奨しています。vLLM はまた、KV cache のフットプリントを削減してより長いコンテキストやより高いスループットを可能にする方法として FP8 KV cache も文書化しており、精度検証は引き続き必要です。
ステップ 3: activations とランタイムのオーバーヘッドを追加する
推論では、activation メモリは通常、重みや KV cache より小さいですが、ゼロではありません。prefill、CUDA graphs、attention kernel、一時バッファ、マルチモーダル処理、speculative decoding、バッチスケジューリングなどが追加のメモリを確保することがあります。
学習では、activation メモリは主要な要素になります。Hugging Face の model memory anatomy では、学習時のメモリ構成要素としてモデルの重み、optimizer states、gradients、勾配計算のために保存される forward activations、一時バッファ、機能固有のメモリを挙げています。また、activation メモリはシーケンス長、hidden size、batch size に依存すると述べています。
実用的な計画の切り分けは次のとおりです:
| シナリオ | Activation とオーバーヘッドの方針 |
|---|---|
| 単純な推論、batch 1 | 重みと KV cache の後に少なくとも 10% の余裕を残します。 |
| CUDA graphs と batching を使う vLLM サービング | まず 15-20% の余裕から始め、その後 gpu_memory_utilization、max_model_len、max_num_seqs を調整します。 |
| 長文コンテキストのサービング | KV cache を主要変数として扱い、prefill のスパイク用により多くの余裕を確保します。 |
| ファインチューニング | スケールアップする前に、対象シーケンス長で小規模な実行を測定します。batch と context が増えると activation が支配的になることがあります。 |
| マルチモーダルモデル | processor cache とメディア入力メモリを追加します。vLLM の conserving-memory ガイドでは、マルチモーダル cache と入力制限の制御が記載されています。 |
テスト要求が収まるからといって、本番を 99% のメモリ使用率で動かしてはいけません。それでは、より長いプロンプト、ホットリロード、CUDA graph capture、allocator の挙動、またはベンチマークとは異なるトラフィックの混在に対応する余地がなくなります。
ステップ 4: 学習とファインチューニングのメモリを見積もる
学習メモリは、GPU が forward-pass の重み以上を保持する必要があるため、より大きくなります。
混合精度とAdamWを用いたフルファインチューニングについては、Hugging Faceのメモリアナトミーが実用的な内訳を示しています。混合精度トレーニングでは、FP32とFP16/BF16の重みコピー、AdamWオプティマイザ状態、勾配、保存されたアクティベーション、一時バッファ、および機能固有のメモリが保持される場合があります。同ページでは、典型的な混合精度のAdamW構成を、アクティベーションメモリに加えてモデルパラメータ1つあたり18バイトと要約しています。
つまり、次のようになります:
| Model size | 18 bytes per parameter before activations |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1,173 GiB |
これが、gpu memory requirements LLM training の検索に、推論向けの検索とは別の答えが必要な理由です。テンソル並列化と量子化KVキャッシュで提供できる70Bモデルでも、少数のGPUでフルファインチューニングするのが自動的に現実的とは限りません。
トレーニングメモリを削減する方法には、次のものがあります:
| Technique | What it reduces | Tradeoff |
|---|---|---|
| LoRA / QLoRA | Trainable parameter and optimizer memory | Not the same as full fine-tuning; still needs base model memory and activations. |
| Activation checkpointing | Saved activation memory | More recomputation and lower training throughput. |
| ZeRO / FSDP / tensor parallelism | Per-GPU optimizer, gradient, parameter, or compute memory | More distributed complexity and communication sensitivity. |
| Shorter sequence length | Activation and attention memory | May reduce task quality if the workload needs long context. |
| Smaller micro-batch | Activation memory | May require gradient accumulation to preserve effective batch size. |
フルトレーニングでは、式によって最初のクラスター構成の目安までは分かります。しかし、実測に基づくフレームワーク実行の代わりにはなりません。
ステップ5: LLMのGPUメモリ要件を一般的なGPUメモリ容量に対応させる
GPUメモリ容量は、唯一の購入基準ではなく制約条件として扱ってください。メモリ帯域、NVLinkトポロジ、ネットワーク、ストレージ、スケジューリング、そして稼働率は、単純なVRAM容量と同じくらい重要になることがあります。
| GPU class | Public memory anchor | What it usually means for LLM GPU memory requirements |
|---|---|---|
| H100 SXM | 80 GB HBM3 | 7B-34Bの提供や多くのファインチューニングジョブに対する強力な標準選択肢。70B BF16では通常、テンソル並列化または量子化が必要です。 |
| H100 NVL | 94 GB per GPU, 188 GB pair in NVIDIA's H100 page | 電力制約のあるエンタープライズラックでより大きなLLM推論を行うために設計されています。とはいえ、トポロジとプロバイダーのSKUは必ず検証してください。 |
| H200 | 141 GB HBM3e | H100よりも大規模モデルの重みや長いコンテキストに余裕がありますが、高同時実行の70B提供ではKVキャッシュが依然として制約になることがあります。 |
| B200 in DGX B200 | 1,440 GB total across 8 GPUs | エンタープライズのトレーニングおよび推論システム向けの大容量メモリプールであり、1つのGPU仕様を超える運用要件があります。 |
ワークシートで単一のH200が70Bモデルに「ちょうど収まる」と示されたとしても、それはデプロイ計画ではありません。次の設定をベンチマークする必要があるという संकेतです:
| Setting | Why it matters |
|---|---|
max_model_len |
Upper-bounds context and therefore KV cache. |
max_num_seqs |
Upper-bounds concurrent sequences and scheduler pressure. |
kv_cache_dtype |
Can cut KV cache memory, but requires quality checks. |
| Tensor parallel size | Splits model work across GPUs; also changes communication needs. |
| Quantization format | Shrinks weights and sometimes KV cache; may affect quality and kernel support. |
| Target p95 latency | Higher throughput settings can hurt latency even when memory fits. |
ハードウェア選定の詳細については、このワークシートをFlatkeyのLLM推論に最適なGPU、H200 vs H100、およびB200 vs H200ガイドと併せてご利用ください。
例: vLLMでの70B推論サイズ見積もり
レンタル容量を確保する前に、vllm gpu memory requirements 70b model vram を考える保守的な方法を示します。
前提:
| Input | Value |
|---|---|
| Model weights | 70B parameters |
| Weight precision | BF16 / FP16 |
| Weight memory | ~130.4 GiB |
| KV cache shape | 80 layers, 8 KV heads, 128 head dimension |
| KV precision | BF16 / FP16 |
| KV per active token | ~0.3125 MiB |
次に、いくつかの提供構成を比較します:
| 提供対象 | 概算KVキャッシュ | 重要な理由 |
|---|---|---|
| 1ライブシーケンス、4Kトークン | ~1.3 GiB | 重みが支配的です。大容量メモリの単一GPUでも、余裕が少ない場合しか収まらないことがあります。 |
| 8ライブシーケンス、4Kトークン | ~10.0 GiB | 重み以外にも十分な余裕が必要です。 |
| 16ライブシーケンス、8Kトークン | ~40.0 GiB | 重みまたはKVキャッシュを量子化しない限り、単一GPUでの計画は通常かなり不安定です。 |
| 16ライブシーケンス、16Kトークン | ~80.0 GiB | KVキャッシュだけで、おおよそH100 SXM 1枚分のメモリに相当します。 |
運用面では、70BのvLLMプランは通常、次のいずれかの経路に分類されます:
| 経路 | 適合性 |
|---|---|
| BF16重み、低い同時実行数、短いコンテキスト | オーバーヘッド確認後にH200クラスのメモリで動作する可能性があります。 |
| BF16重み、本番同時実行 | テンソル並列を使用し、ネットワーク/トポロジーを検証します。 |
| 量子化重み、BF16/FP16 KVキャッシュ | 品質上重みの量子化が許容される場合の、最初のベンチマークとして有効です。 |
| 量子化重み + FP8 KVキャッシュ | より長いコンテキストやより多い同時実行を可能にしますが、精度とレイテンシの検証が必要です。 |
| ハードウェア制御要件なし | GPU運用に踏み切る前に、モデルAPI経路を比較してください。 |
これは、LLMのGPUメモリ要件に対する実践的な答えです。パラメータ数はモデルを読み込めるかどうかを示し、KVキャッシュとランタイム予約領域は、有用なトラフィックを処理できるかどうかを示します。
コンテキスト長によって答えが変わる理由
ロングコンテキストが高コストなのは、キャッシュがライブトークンに応じて増えるためです。コンテキストを8Kから16Kに倍増すると、同じモデル、精度、同時実行数でKVキャッシュはおおよそ2倍になります。同じコンテキストで同時実行数を倍にすると、KVキャッシュは再びおおよそ2倍になります。
LLMのGPUメモリ要件を比較するチームにとって、これは単純なサイズ決定のパターンになります:
より多いユーザー x より長いプロンプト x より多い出力トークン = より多いKVキャッシュ
より大きなGPUを借りる前に、製品が各リクエストで最大コンテキストを本当に必要としているかを確認してください。多くのシステムは次のようにルーティングできます:
| リクエスト種別 | メモリ節約ポリシー |
|---|---|
| 短いチャットまたは抽出 | 小さめのコンテキスト上限、高めの同時実行数。 |
| 長文書解析 | 大きめのコンテキスト上限、低めの同時実行プール。 |
| バッチジョブ | リクエスト数ではなく、トークン予算でキューイングします。 |
| プレミアムワークロード | 明示的な最大コンテキストとp95目標を持つ専用プール。 |
これは、単一のグローバルなメモリ設定で巨大なエンドポイントを1つ動かすより、しばしば安価で安定しています。
最初のベンチマークで測定すべきもの
単一の順調なパスのプロンプトではなく、本番トラフィックに近いベンチマークを実行してください。
| メトリック | 最初のベンチマークに含めるべき理由 |
|---|---|
| ピーク時の割り当て済みおよび予約済みVRAM | テンソル計算だけでなく、アロケータとフレームワークの余裕も把握できます。 |
| プレフィルレイテンシ | 長いプロンプトはメモリ帯域幅とアテンションカーネルに負荷をかけます。 |
| デコードのトークン/秒 | 定常状態での生成スループットを示します。 |
| p95およびp99レイテンシ | スループットだけを重視した設定がユーザー体験を損なうのを防ぎます。 |
| OOM率 | 実際のトラフィック混合下でのメモリ失敗を追跡します。 |
| KVキャッシュ使用量 | ボトルネックがコンテキスト/同時実行なのか、重みなのかを説明します。 |
| 受理済み出力コスト | GPUレンタルコストを、生のトークン数ではなく、利用可能な完了結果に結びつけます。 |
複数ノードのデプロイでは、これにGPUクラスターアーキテクチャとGPUクラスターTCOのチェックリストを組み合わせてください。ネットワーク、ストレージ、キューイング、または稼働率が悪ければ、メモリに収まるモデルでも高コストになり得ます。
よくあるミス
| ミス | より良い方法 |
|---|---|
| パラメータ数だけでサイズを決める | KVキャッシュ、アクティベーション、フレームワークの予備領域、余裕を追加します。 |
| "一度収まる"を本番対応とみなす | 対象のコンテキスト、同時実行数、出力長、リトライ動作をテストします。 |
| KVキャッシュの精度を無視する | メモリがボトルネックなら、FP8やその他のキャッシュ形式を検証します。 |
| プロバイダーのGPU名だけで正確なSKUを確認しない | メモリ容量、インターコネクト、MIGポリシー、ドライバスタック、GPUが共有かどうかを確認します。 |
| 学習時のメモリが推論時のメモリと同じだと考える | 学習では、オプティマイザ状態、勾配、保存されたアクティベーション、分散オーバーヘッドが追加されます。 |
gpu_memory_utilizationを攻めすぎる |
CUDAグラフ、バッファ、トラフィック急増、アロケータ挙動のために十分な予備を残します。 |
判断ガイド: GPUを借りるか、モデルAPIを使うか?
次のいずれかが必要な場合は、直接GPU容量を使うのが適切です:
| 次のような場合は直接GPUを選ぶ | 次のような場合はモデルAPIのベースラインを選ぶ |
|---|---|
| カスタム重みやプライベートなファインチューニングを提供する。 | 一般的なホスト済みモデルを使い、主に信頼性の高い出力が必要。 |
| 配置、分離、またはランタイム制御が必要。 | キュー、オートスケーリング、イメージ、ドライバ、GPU障害を運用したくない。 |
| 測定した利用率が、APIの経済性を上回るのに十分高い。 | トラフィックが突発的、初期段階、または予測しにくい。 |
| ベンチマークやインシデント対応を自分たちで担える。 | チームはエンジニアリングの時間をプロダクトロジックに使いたい。 |
ハードウェア制御が製品要件ではない場合、Flatkey はベースラインの選択肢として有用です。公式モデルとツール全体で1つの基準を提供するため、長期間稼働するクラスターにコミットする前に、GPUレンタルとモデルAPIの出力コストを比較できます。ベンチマークで直接GPUが有利だと証明できたら、上のメモリワークシートを使って、最も大きく見栄えのする形ではなく、最小で信頼できる構成を借りてください。
よくある質問
70B LLMにはどれくらいのGPUメモリが必要ですか?
70BモデルのBF16またはFP16の重みには、KV cacheとランタイムオーバーヘッドの前で約130 GiBが必要です。INT8の重みは、メタデータの前で約65 GiBです。4-bitの重みは、量子化メタデータの前で約33 GiBです。本番推論では、コンテキストと同時実行数のためのKV cache、サービングフレームワークの予約領域、安全マージンを追加してください。
モデルは読み込めるのに、トラフィックがあると失敗するのはなぜですか?
負荷テストでは重みだけが収まっている場合があります。実際のトラフィックでは、アクティブなプロンプトと生成トークンのためのKV cache、バッチ処理のオーバーヘッド、一時バッファ、フレームワークの予約領域が追加されます。長いプロンプトや同時シーケンス数の増加によって、同じモデルでもOOMになることがあります。
LLM推論のGPUメモリ要件に最も影響するものは何ですか?
最大の変数は、モデルサイズ、重み精度、コンテキスト長、同時シーケンス数、KV cache精度、そしてサービングフレームワーク設定です。長文コンテキストのサービングでは、KV cacheがしばしばボトルネックになります。
学習時のLLMハードウェア要件のGPUメモリに最も影響するものは何ですか?
学習では、オプティマイザ状態、勾配、保存されたアクティベーション、一時バッファ、分散フレームワークのオーバーヘッドが追加されます。バッチサイズ、シーケンス長、アクティベーションチェックポイント、オプティマイザの選択、シャーディング戦略によって、必要なGPU数は大きく変わります。
vLLMはGPUメモリ要件を下げますか?
vLLMは有用なメモリ制御と効率的なKV cache管理を提供しますが、根本的なメモリ予算をなくすわけではありません。重み、KV cache、アクティベーション、ランタイム予約領域、ヘッドルームのための十分なVRAMは依然として必要です。メモリ制御は、コンテキスト長、同時実行数、精度、スループットのトレードオフを選ぶのに役立ちます。
FP8 KV cacheで長文コンテキストのメモリ圧迫は解決できますか?
KV cacheのフットプリントは削減できますし、vLLMはFP8 KV cacheのサポートを文書化しています。これはベンチマーク設定として扱い、無料の切り替えではないと考えてください。本番利用の前に、出力品質、レイテンシ、対応ハードウェア/ソフトウェア経路、障害時の挙動を検証してください。
最終チェックリスト
容量を借りる前に、次の質問に答えてください。
- どのモデルサイズと重み精度を提供しますか?
- ユーザーが実際に送れる最大コンテキスト長はどれくらいですか?
- p95負荷で、いくつの同時シーケンスを収める必要がありますか?
- 生成用にどの出力長を見積もっていますか?
- KV cacheはBF16/FP16、FP8、または別のサポート済み形式ですか?
- 重みとKV cacheの後に、どれだけのヘッドルームが残りますか?
- tensor parallelism、量子化、LoRA、FSDP、またはZeROを使っていますか?
- プロバイダが割り当てる正確なGPU SKU、メモリ容量、トポロジーは何ですか?
- どのOOM、レイテンシ、成功とみなす1件あたり受理出力コストのしきい値を定義しますか?
- ハードウェア制御が不要なら、モデルAPIのベースラインコストはいくらですか?
最良のllm gpu memory requirements推定は、本番に近いベンチマークを生き残るものです。ワークシートを使って不可能なGPU構成を素早く除外し、その後、実際のコンテキスト長、実際の同時実行数、そしてオンラインを維持するのに十分なヘッドルームで候補を検証してください。
ソース
- vLLMエンジン引数:
gpu_memory_utilization,kv_cache_memory_bytes,kv_cache_dtype, および関連するキャッシュ制御: https://docs.vllm.ai/en/latest/configuration/engine_args.html - vLLMのメモリ節約ガイド: tensor parallelism、quantization、context length、batch size、CUDA graph memory、multimodal memory controls: https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- vLLMの量子化KV cacheガイド: FP8 KV cacheのオプションとトレードオフ: https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Hugging Face Transformersのモデルメモリアーキテクチャ: 学習時のメモリバケット、オプティマイザ状態、勾配、アクティベーション、mixed-precisionメモリの注記: https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- NVIDIA H100製品ページ: H100メモリ、帯域幅、H100 NVL、LLMでの位置づけ: https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA H200製品ページ: 141 GB HBM3eとメモリ帯域幅: https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA DGX B200製品ページ: 8基のB200 GPUと合計1,440 GBのHBM3e: https://www.nvidia.com/en-us/data-center/dgx-b200/


