
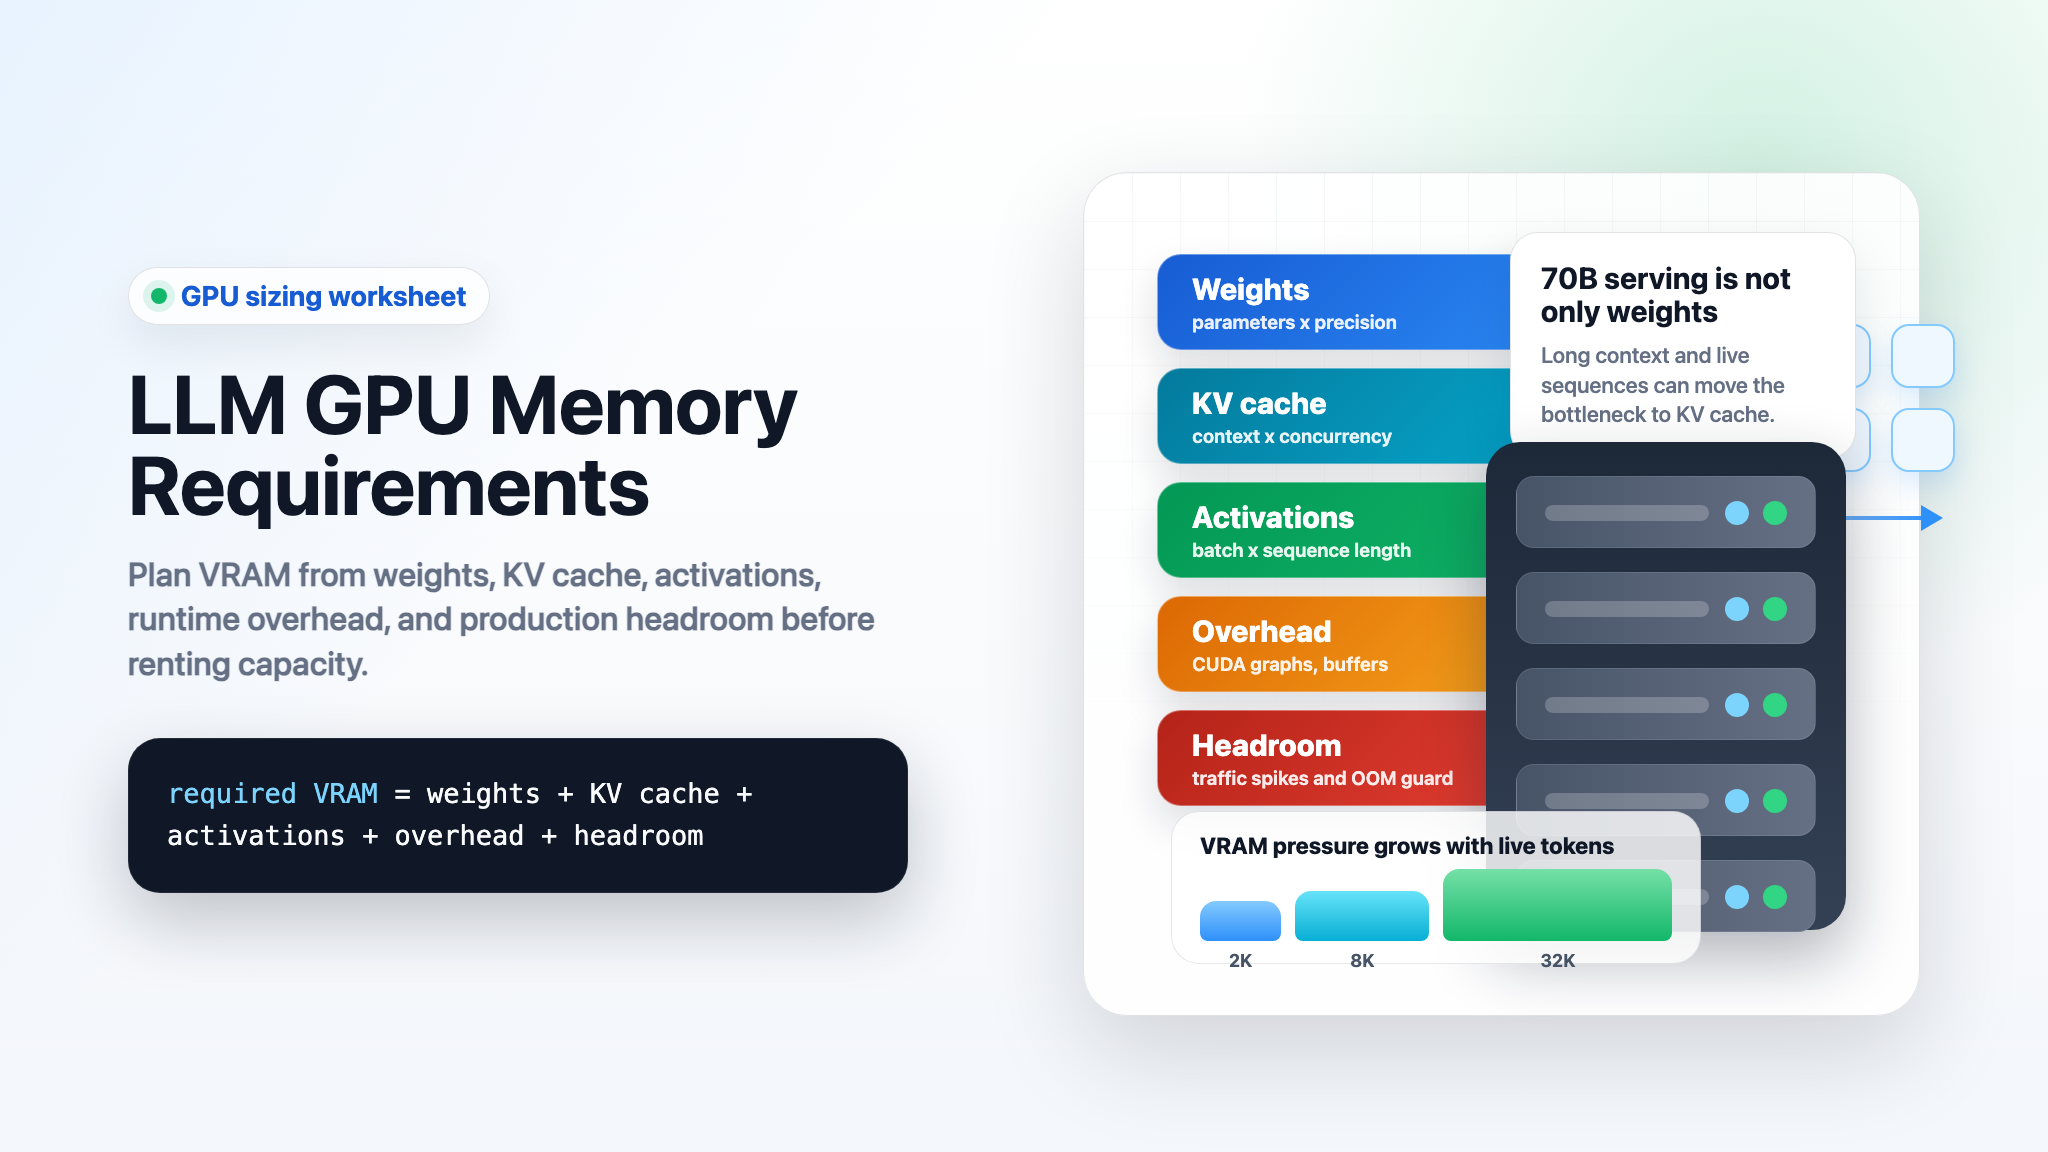
LLM GPU 内存需求不只是“模型大小再加一点余量”。一个推理或训练任务包含多个独立的内存桶:模型权重、KV cache、激活值、框架工作空间、CUDA graphs、临时缓冲区以及运行安全余量。
快速规划规则如下:
所需 VRAM =
  模型权重
+ 运行中 token 的 KV cache
+ 激活值和工作空间内存
+ 训练状态(如果是训练或完整微调)
+ 分配器和安全余量
这就是为什么两个团队可以在同一类 GPU 上运行相同的 70B 模型,却得到不同结果的原因。一个使用短提示词、单流、FP8 KV cache 和保守批处理;另一个使用长上下文、许多并发请求、CUDA graph 捕获以及较高的 gpu_memory_utilization 设置。第一个任务可以正常运行。第二个任务则会因内存不足而失败,或者因为把工作溢出到其他地方而增加延迟。
本指南提供了一份实用的 llm gpu memory requirements 工作表,适用于推理、vLLM 部署、微调和训练。在租用 GPU、选择 H100、H200 还是 B200 容量,或决定使用模型 API 是否比自建 GPU 端点更简单之前,都可以先用它。
LLM GPU 内存需求快速答案
对于推理,先从权重开始,再根据上下文长度和并发数确定 KV cache。对于训练,权重只是开始;优化器状态、梯度和保存的激活值才是内存规划中的主要部分。
| 工作负载 | 通常占用 VRAM 的主要部分 | 快速规划规则 |
|---|---|---|
| 单请求推理 | 权重 | parameters x bytes_per_weight,然后为提示词和生成的 token 额外加上 KV cache。 |
| 高吞吐推理 | KV cache 和调度器余量 | 按 concurrent sequences x tokens per sequence 进行容量规划,而不只是按模型参数数量。 |
| 长上下文服务 | KV cache | 对于同一模型和批次,将上下文长度加倍,大致会使 KV cache 内存加倍。 |
| 完整微调 | 优化器状态、梯度、激活值 | 混合精度 AdamW 在激活值之前,可能就需要达到模型权重内存的数倍。 |
| LoRA 或适配器调优 | 基础权重加激活值和适配器状态 | 比完整微调小得多,但长上下文和批大小仍然很重要。 |
| 预训练 | 训练状态加激活值加分布式开销 | 应基于实测的框架运行结果来规划;公式只是第一步。 |
如果你只需要模型输出,先比较直接 GPU 服务和模型 API 基线。若你需要自定义权重、放置控制、私有运行时策略,或者在利用率经过测量后更便宜的工作负载,直接使用 GPU 才有意义。如果你主要需要可靠的 API 响应,托管模型方案可以避免数周的 GPU 选型、排队和运维工作。
LLM GPU 内存需求工作表
在选择实例之前使用这份工作表。
| 桶 | 公式或检查项 | 说明 |
|---|---|---|
| 权重 | parameter_count x weight_bytes |
BF16/FP16 每个参数大约使用 2 字节。INT8 大约使用 1 字节。4-bit 在量化元数据之前大约使用 0.5 字节。 |
| KV cache | active_tokens x layers x kv_heads x head_dim x 2 x kv_bytes |
2 代表 key 和 value。分组查询注意力相较于完整多头注意力会减少 kv_heads。 |
| 激活值 | 推理:通常较小。训练:随 batch、序列长度、隐藏层大小、层数和检查点策略而变化。 | Hugging Face 的模型内存构成指出,训练时内存包括权重、优化器状态、梯度、保存的激活值、临时缓冲区以及特定功能所需的内存。 |
| 服务框架预留 | vLLM、TensorRT-LLM、SGLang、PyTorch、CUDA graphs、attention kernels、调度队列 | vLLM 提供诸如 gpu_memory_utilization、kv_cache_memory_bytes、kv_cache_dtype、max_model_len 和 max_num_seqs 之类的内存控制项。 |
| 安全余量 | 生产环境预留 10-20%,首次基准测试期间预留更多 | 为分配器碎片、流量峰值、更长的提示词、模型重载和可观测性代理留出空间。 |
最常见的错误是只装得下权重,却忽略了运行中的 token。对于 LLM 推理 GPU 内存需求估算,KV cache 可能就是稳定端点和 OOM 循环之间的区别。
步骤 1:计算模型权重内存
权重是 LLM 工作负载 GPU 内存需求中最简单的部分。
weight_memory_gib = parameters x bytes_per_parameter / 1024^3
| 模型规模 | BF16 / FP16 权重 | INT8 权重 | 不含元数据的 4-bit 权重 |
|---|---|---|---|
| 7B | ~13.0 GiB | ~6.5 GiB | ~3.3 GiB |
| 13B | ~24.2 GiB | ~12.1 GiB | ~6.1 GiB |
| 34B | ~63.3 GiB | ~31.7 GiB | ~15.8 GiB |
| 70B | ~130.4 GiB | ~65.2 GiB | ~32.6 GiB |
| 405B | ~754.4 GiB | ~377.2 GiB | ~188.6 GiB |
此表格是一个下限。实际部署还会增加量化缩放因子、非参数缓冲区、分词器/运行时状态、临时工作区以及服务开销。
对于 vLLM GPU memory requirements 70B model VRAM 的估算,仅 BF16/FP16 权重就已经超过单张 80 GB H100。根据 NVIDIA 的 H200 页面,单张 H200 具有 141 GB HBM3e,因此从原理上说权重可以装下,但剩余的 KV cache 和运行时余量仍可能迫使使用更短的上下文、更低的并发、KV cache 量化或张量并行。NVIDIA 列出的 H100 SXM 为 80 GB,H200 为 141 GB,DGX B200 则是 8 张 Blackwell GPU,共 1,440 GB HBM3e,总体上相当于该系统中每张 B200 GPU 约 180 GB。
第 2 步:计算 LLM GPU 内存需求的 KV cache 内存
KV cache 是用于存储已经处理过的 token 的注意力 key 和 value 的内存。它使模型无需每次都重新计算完整前缀即可生成输出。
对于仅解码器的 transformer 推理:
kv_cache_bytes =
  active_tokens
x num_layers
x num_kv_heads
x head_dim
x 2
x bytes_per_kv_element
其中:
| 变量 | 含义 |
|---|---|
active_tokens |
当前驻留在缓存中的、来自所有在线请求的 prompt 与已生成 token 之和。 |
num_layers |
Transformer 层数。 |
num_kv_heads |
KV heads,不一定等于 attention heads。分组查询注意力可以使其小得多。 |
head_dim |
每个 head 的维度。 |
2 |
Key 和 value 张量。 |
bytes_per_kv_element |
BF16/FP16 为 2,FP8 为 1,支持更低位缓存模式时更低。 |
例如,一个 Llama 风格的 70B 结构,具有 80 层、8 个 KV heads 和 128 的 head 维度,使用:
80 x 8 x 128 x 2 x 2 bytes = 每个 token 327,680 bytes
这大约相当于 BF16/FP16 KV cache 中每个活跃 token 0.3125 MiB。
| 每个序列的活跃上下文 | 单个序列的近似 KV cache | 16 个在线序列的近似 KV cache |
|---|---|---|
| 2,048 tokens | ~0.6 GiB | ~10.0 GiB |
| 4,096 tokens | ~1.3 GiB | ~20.0 GiB |
| 8,192 tokens | ~2.5 GiB | ~40.0 GiB |
| 16,384 tokens | ~5.0 GiB | ~80.0 GiB |
| 32,768 tokens | ~10.0 GiB | ~160.0 GiB |
精确数值会因模型架构而变化。KV heads 更多的模型会占用更多 KV 内存。采用 multi-query 或 grouped-query attention 的模型所需 KV 内存可以远少于完整 multi-head attention 设计。
vLLM 在这里记录了几个重要参数:--gpu-memory-utilization 控制模型执行器使用的 GPU 内存比例,--kv-cache-memory-bytes 可显式指定 KV cache 大小,--kv-cache-dtype 可选择缓存精度,而节省内存指南建议在内存紧张时降低 max_model_len 和 max_num_seqs。vLLM 还将 FP8 KV cache 记录为一种减少 KV cache 占用并支持更长上下文或更高吞吐量的方法,但仍需要进行准确性验证。
第 3 步:加入激活值和运行时开销
对于推理,激活值内存通常比权重和 KV cache 小,但并不是零。prefill、CUDA graphs、attention kernels、临时缓冲区、多模态处理器、speculative decoding 以及批调度都可能预留额外内存。
对于训练,激活值内存会成为首要项。Hugging Face 的 model memory anatomy 将训练内存组件列为模型权重、优化器状态、梯度、用于梯度计算而保存的前向激活值、临时缓冲区以及特定功能的内存。它还指出,激活值内存取决于序列长度、隐藏层大小和 batch size。
一个有用的规划拆分如下:
| 场景 | 激活值与开销策略 |
|---|---|
| 简单推理,batch 1 | 在权重和 KV cache 之后至少保留 10% 的余量。 |
| 带 CUDA graphs 和 batching 的 vLLM serving | 先预留 15-20% 余量,然后调优 gpu_memory_utilization、max_model_len 和 max_num_seqs。 |
| 长上下文 serving | 将 KV cache 视为主要变量,并为 prefill 峰值保留更多余量。 |
| 微调 | 在扩展前,先在目标序列长度下测量一次小规模运行;当 batch 和上下文变大时,激活值可能占主导。 |
| 多模态模型 | 增加处理器缓存和媒体输入内存;vLLM 的节省内存指南指出了多模态缓存和输入限制控制。 |
不要因为测试请求能跑通,就把生产环境运行在 99% 内存占用上。那样就没有空间应对更长的 prompt、热重载、CUDA graph capture、分配器行为,或者与基准测试不同的流量组合。
第 4 步:估算训练和微调内存
训练内存更大,因为 GPU 必须容纳的不只是前向传播权重。
对于使用混合精度和 AdamW 的完整微调,Hugging Face 的内存结构分析给出了一个实用的拆分:混合精度训练可能会保留 FP32 和 FP16/BF16 权重副本、AdamW 优化器状态、梯度、保存的激活值、临时缓冲区,以及与功能相关的内存。同一页面将典型的混合精度 AdamW 配置概括为每个模型参数 18 字节,再加上激活值内存。
这意味着:
| 模型大小 | 每个参数 18 字节(不含激活值) |
|---|---|
| 7B | ~117 GiB |
| 13B | ~218 GiB |
| 34B | ~570 GiB |
| 70B | ~1,173 GiB |
这就是为什么 gpu memory requirements LLM training 这类查询需要与推理查询不同的答案。一个可以通过张量并行和量化 KV cache 提供服务的 70B 模型,并不自动意味着它适合在少量 GPU 上进行完整微调。
降低训练内存的方法包括:
| 技术 | 减少的内容 | 权衡 |
|---|---|---|
| LoRA / QLoRA | 可训练参数和优化器内存 | 与完整微调不同;仍然需要基础模型内存和激活值。 |
| 激活值检查点 | 保存的激活值内存 | 需要更多重计算,训练吞吐量更低。 |
| ZeRO / FSDP / 张量并行 | 每个 GPU 的优化器、梯度、参数或计算内存 | 分布式复杂度更高,对通信更敏感。 |
| 更短的序列长度 | 激活值和注意力内存 | 如果工作负载需要长上下文,可能降低任务质量。 |
| 更小的 micro-batch | 激活值内存 | 可能需要梯度累积来保持有效批大小。 |
对于完整训练,公式只能帮助你确定一个初始集群形态。它们不能替代实际测量的框架运行结果。
步骤 5:将 LLM GPU 内存需求映射到常见 GPU 显存规格
把 GPU 显存容量当作一个约束条件,而不是唯一的采购标准。内存带宽、NVLink 拓扑、网络、存储、调度以及利用率的重要性,可能与原始 VRAM 一样高。
| GPU 类别 | 公开内存基准 | 这通常对 LLM GPU 内存需求意味着什么 |
|---|---|---|
| H100 SXM | 80 GB HBM3 | 适合作为 7B-34B 推理和许多微调任务的强默认选择。70B BF16 通常需要张量并行或量化。 |
| H100 NVL | NVIDIA 的 H100 页面中为每个 GPU 94 GB、两张卡合计 188 GB | 面向功耗受限的企业机架中的更大 LLM 推理;但仍需验证拓扑和供应商 SKU。 |
| H200 | 141 GB HBM3e | 相比 H100,对大模型权重和更长上下文更从容,但高并发 70B 服务仍可能受到 KV cache 限制。 |
| DGX B200 中的 B200 | 8 张 GPU 总计 1,440 GB | 用于企业训练和推理系统的大内存池,但其运营需求远不止单卡规格。 |
如果你的表格计算显示单张 H200“刚好适合”一个 70B 模型,这并不等于已经有了部署方案。这只是一个信号,表明你需要对以下设置进行基准测试:
| 设置 | 重要原因 |
|---|---|
max_model_len |
对上下文长度设上限,因此也限制了 KV cache。 |
max_num_seqs |
对并发序列数量和调度压力设上限。 |
kv_cache_dtype |
可以减少 KV cache 内存,但需要进行质量检查。 |
| 张量并行规模 | 将模型计算分摊到多张 GPU;同时也会改变通信需求。 |
| 量化格式 | 压缩权重,有时也会压缩 KV cache;可能影响质量和内核支持。 |
| 目标 p95 延迟 | 更高吞吐量的配置即使内存够用,也可能损害延迟表现。 |
关于硬件选择的细节,请结合这份工作表以及 Flatkey 的 LLM 推理最佳 GPU、H200 vs H100 和 B200 vs H200 指南一起使用。
示例:vLLM 中 70B 推理的容量规划
在租用算力之前,这里有一种更保守的方式来推算 vllm gpu memory requirements 70b model vram。
假设:
| 输入 | 值 |
|---|---|
| 模型权重 | 70B 参数 |
| 权重精度 | BF16 / FP16 |
| 权重内存 | ~130.4 GiB |
| KV cache 形状 | 80 层、8 个 KV 头、128 头维度 |
| KV 精度 | BF16 / FP16 |
| 每个活跃 token 的 KV | ~0.3125 MiB |
然后将几个服务形态进行对比:
| 服务目标 | 大约 KV cache | 重要原因 |
|---|---|---|
| 1 个在线序列,4K tokens | ~1.3 GiB | 权重占主导。单块大显存 GPU 可能只能在较低余量下勉强容纳。 |
| 8 个在线序列,4K tokens | ~10.0 GiB | 除了权重之外,还需要真正的余量。 |
| 16 个在线序列,8K tokens | ~40.0 GiB | 如果不对权重或 KV cache 做量化,单 GPU 方案通常比较脆弱。 |
| 16 个在线序列,16K tokens | ~80.0 GiB | 仅 KV cache 的规模就大约相当于一块 H100 SXM 的内存容量。 |
从运维角度看,70B vLLM 方案通常会落入以下路径之一:
| 路径 | 适配情况 |
|---|---|
| BF16 权重、低并发、较短上下文 | 在检查开销后,H200 级别内存可能可行。 |
| BF16 权重、生产级并发 | 使用张量并行,并验证网络/拓扑。 |
| 量化权重、BF16/FP16 KV cache | 当质量允许权重量化时,这是一个很好的首轮基准测试方案。 |
| 量化权重加 FP8 KV cache | 可以释放更长上下文或更高并发,但需要验证准确性和延迟。 |
| 没有硬件控制要求 | 在投入 GPU 运维之前,先对比模型 API 路线。 |
这就是关于 LLM 的 gpu 内存需求 在推理服务中的实际答案:参数数量告诉你模型能否加载;KV cache 和运行时预留则告诉你它能否服务有价值的流量。
为什么上下文长度会改变答案
长上下文的代价很高,因为缓存会随着在线 token 数增长。如果你把上下文从 8K 翻倍到 16K,在相同模型、精度和并发条件下,KV cache 大约也会翻倍。如果你在相同上下文下把并发翻倍,KV cache 也会再次大约翻倍。
对于比较 llm 硬件需求 gpu 内存 方案的团队来说,这会形成一个简单的容量规划模式:
更多用户 x 更长提示词 x 更多输出 token = 更多 KV cache
在租用更大的 GPU 之前,先问问产品是否真的需要每个请求都使用最大上下文。许多系统可以这样分流:
| 请求类型 | 节省内存策略 |
|---|---|
| 短对话或抽取 | 更小的上下文上限,更高的并发。 |
| 长文档分析 | 更大的上下文上限,更低的并发池。 |
| 批处理任务 | 按 token 预算排队,而不只是按请求数量。 |
| 高优先级工作负载 | 使用带明确最大上下文和 p95 目标的专用池。 |
这通常比运行一个带单一全局内存设置的超大端点更便宜,也更稳定。
在第一次基准测试中应测量什么
运行一个类似生产流量的基准测试,而不是只测一个理想路径提示词。
| 指标 | 为什么它应纳入第一次基准测试 |
|---|---|
| 峰值已分配和已预留 VRAM | 能发现分配器和框架预留空间的问题,而不只是张量计算本身。 |
| Prefill 延迟 | 长提示词会对内存带宽和 attention 内核造成压力。 |
| Decode 每秒 token 数 | 显示稳定状态下的生成吞吐量。 |
| p95 和 p99 延迟 | 防止只追求吞吐量的配置伤害用户体验。 |
| OOM 率 | 跟踪真实流量组合下的内存失败情况。 |
| KV cache 使用量 | 说明瓶颈究竟在上下文/并发还是在权重。 |
| 已接受输出成本 | 将 GPU 租用成本与可用完成结果联系起来,而不是只看原始 token 数。 |
对于多节点部署,请配合 GPU 集群架构 和 GPU 集群 TCO 清单一起使用。即使模型在内存上可放得下,如果网络、存储、排队或利用率表现不佳,整体成本仍然可能很高。
常见错误
| 错误 | 更好的做法 |
|---|---|
| 只根据参数数量做容量规划 | 加入 KV cache、激活值、框架预留和余量。 |
| 把“能装下”当成可直接用于生产 | 测试目标上下文、并发、输出长度和重试行为。 |
| 忽视 KV cache 精度 | 当内存是瓶颈时,验证 FP8 或其他缓存格式。 |
| 只使用提供商的 GPU 名称而不看精确 SKU | 确认显存容量、互连、MIG 策略、驱动栈,以及 GPU 是否共享。 |
| 假设训练内存等于推理内存 | 训练会增加优化器状态、梯度、保存的激活值以及分布式开销。 |
过于激进地设置 gpu_memory_utilization |
为 CUDA graph、缓冲区、流量峰值和分配器行为保留足够余量。 |
决策指南:租用 GPU 还是使用模型 API?
当你需要以下一种或多种能力时,直接使用 GPU 容量是正确方向:
| 在以下情况下选择直接使用 GPU…… | 在以下情况下选择模型 API 基线…… |
|---|---|
| 您提供自定义权重或私有微调模型。 | 您使用常见的托管模型,主要需要可靠输出。 |
| 您需要部署位置、隔离或运行时控制。 | 您不想运维队列、自动扩缩容、镜像、驱动程序以及 GPU 故障。 |
| 您的实测利用率足够高,能胜过 API 经济性。 | 流量是突发性的、早期的,或难以预测的。 |
| 您可以自行负责基准测试和事故响应。 | 您的团队更愿意把工程时间投入到产品逻辑上。 |
当硬件控制不是产品需求时,Flatkey 是很有用的基线路径。它为官方模型和工具提供一个统一的平衡点,因此在承诺使用长期运行的集群之前,您可以先比较 GPU 租用与模型 API 输出成本。如果基准测试证明直接使用 GPU 更划算,就使用上面的内存工作表租用最小且可靠的规格,而不是最大、最“惊艳”的规格。
常见问题
70B LLM 需要多少 GPU 内存?
70B 模型的 BF16 或 FP16 权重大约需要 130 GiB,这还不包括 KV cache 和运行时开销。INT8 权重大约是 65 GiB,不包括元数据。4-bit 权重大约是 33 GiB,不包括量化元数据。对于生产推理,还要加上上下文和并发所需的 KV cache、服务框架预留,以及安全余量。
为什么模型能加载,但在流量下却失败?
负载测试可能只容得下权重。真实流量还会增加活动提示和生成 token 的 KV cache、批处理开销、临时缓冲区以及框架预留。更长的提示和更多并发序列会把同一个模型推入 OOM。
哪些因素对 LLM 推理 GPU 内存需求影响最大?
最大的变量是模型大小、权重精度、上下文长度、并发序列数、KV cache 精度以及服务框架设置。对于长上下文服务,KV cache 往往会成为瓶颈。
哪些因素对训练时的 LLM 硬件需求 GPU 内存影响最大?
训练会增加优化器状态、梯度、保存的激活值、临时缓冲区以及分布式框架开销。批大小、序列长度、激活检查点、优化器选择和切分策略都会显著改变 GPU 数量。
vLLM 会降低 GPU 内存需求吗?
vLLM 提供了有用的内存控制和高效的 KV cache 管理,但它并不会消除底层的内存预算。您仍然需要足够的 VRAM 来容纳权重、KV cache、激活值、运行时预留以及安全余量。它的内存控制可以帮助您在上下文长度、并发、精度和吞吐量之间做取舍。
FP8 KV cache 可以解决长上下文内存压力吗?
它可以减少 KV cache 占用,而且 vLLM 文档说明支持 FP8 KV cache。请把它当作一个基准测试设置,而不是一个免费的开关:在生产中使用之前,要验证输出质量、延迟、受支持的硬件/软件路径以及故障行为。
最终检查清单
在您租用容量之前,请回答以下问题:
- 您正在提供的模型大小和权重精度是什么?
- 用户实际可以发送的最大上下文长度是多少?
- 在 p95 负载下,必须容纳多少并发序列?
- 您为生成预留的输出长度是多少?
- KV cache 是 BF16/FP16、FP8,还是其他受支持格式?
- 在权重和 KV cache 之后,还剩多少余量?
- 您是否在使用张量并行、量化、LoRA、FSDP 或 ZeRO?
- 提供商将分配什么具体的 GPU SKU、显存容量和拓扑?
- 什么样的 OOM、延迟和每个被接受输出的成本阈值才算成功?
- 如果您不需要硬件控制,模型 API 基线成本是多少?
最佳的 llm gpu memory requirements 估算,是那种能够经受生产形态基准测试检验的估算。使用这份工作表快速排除不可能的 GPU 规格,然后用真实的上下文长度、真实的并发量以及足够的余量来验证最终候选方案,以确保系统持续在线。
来源
- vLLM 引擎参数:
gpu_memory_utilization、kv_cache_memory_bytes、kv_cache_dtype以及相关缓存控制:https://docs.vllm.ai/en/latest/configuration/engine_args.html - vLLM 节省内存指南:张量并行、量化、上下文长度、批大小、CUDA graph 内存和多模态内存控制:https://docs.vllm.ai/en/latest/configuration/conserving_memory/
- vLLM 量化 KV cache 指南:FP8 KV cache 选项与权衡:https://docs.vllm.ai/en/latest/features/quantization/quantized_kvcache.html
- Hugging Face Transformers 模型内存剖析:训练内存分类、优化器状态、梯度、激活值和混合精度内存说明:https://huggingface.co/docs/transformers/v4.57.1/en/model_memory_anatomy
- NVIDIA H100 产品页:H100 内存、带宽、H100 NVL 和 LLM 定位:https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA H200 产品页:141 GB HBM3e 和内存带宽:https://www.nvidia.com/en-us/data-center/h200/
- NVIDIA DGX B200 产品页:八块 B200 GPU 和总计 1,440 GB HBM3e:https://www.nvidia.com/en-us/data-center/dgx-b200/


