
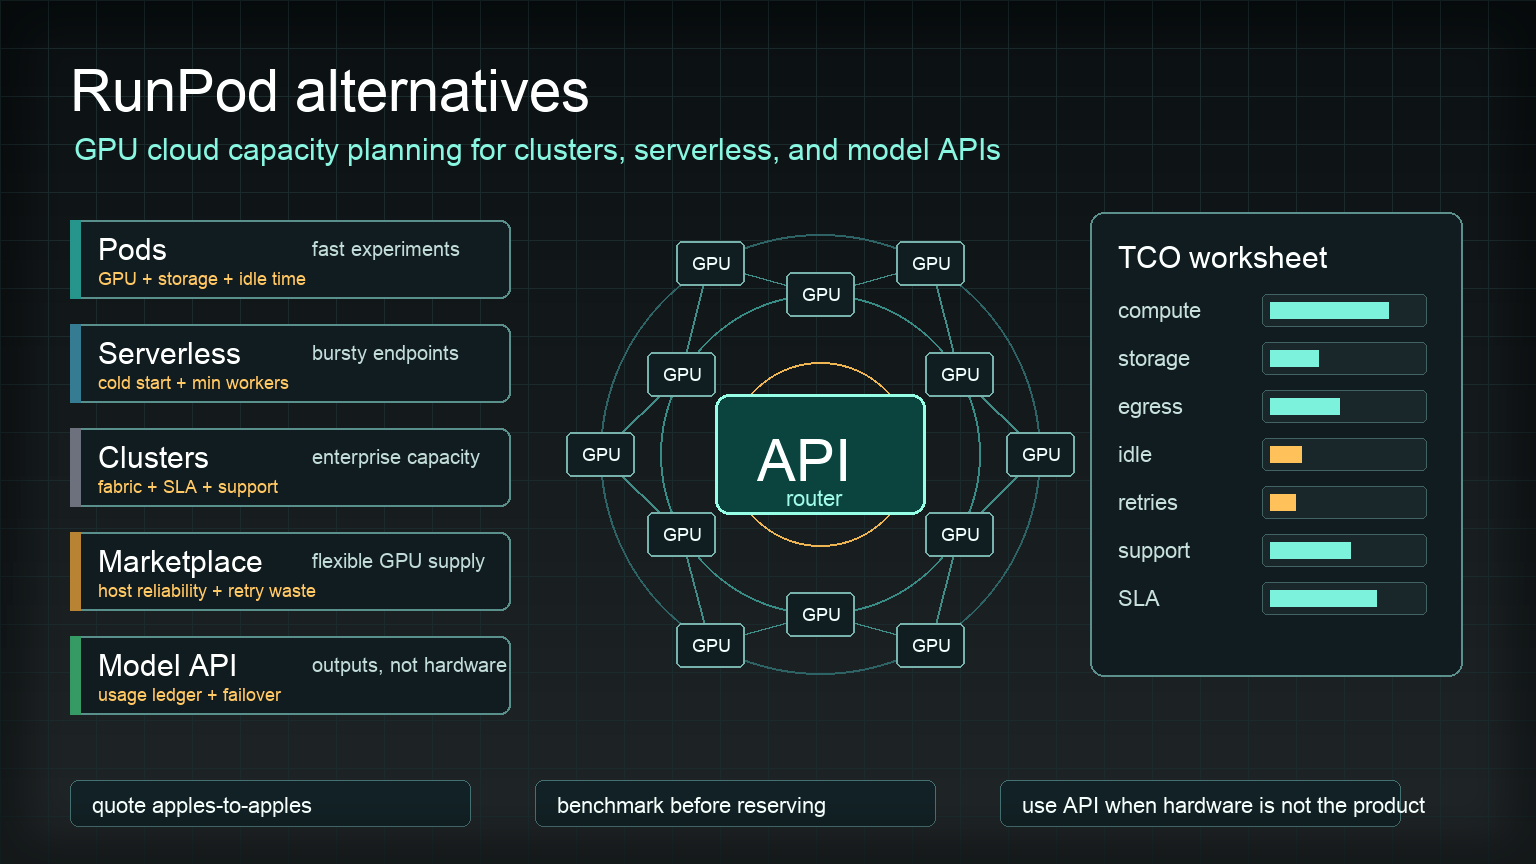
Les alternatives à RunPod entrent généralement dans la conversation après le premier prototype réussi. Un développeur fait fonctionner sur RunPod un workflow ComfyUI, un fine-tune, un script d’inférence par lots ou un endpoint vLLM ; puis l’équipe pose une question plus difficile : cela peut-il devenir une capacité de production avec un coût, un support, un stockage, un réseau, une sécurité et des conditions d’approvisionnement prévisibles ?
La réponse dépend de ce que vous remplacez. Un pod RunPod, un endpoint RunPod Serverless, une instance GPU sécurisée, un GPU communautaire et une discussion sur des capacités d’entreprise sont des modes d’achat différents. Les bonnes alternatives à RunPod pour un traitement ComfyUI le week-end ne sont pas les mêmes que les bonnes alternatives pour un cluster H100 privé, une tâche d’entraînement multi-nœuds ou un service d’inférence orienté client.
Ce guide compare des alternatives à RunPod pour les développeurs et les petites à moyennes équipes IA qui ont besoin de plus qu’une simple heure de GPU bon marché. Il couvre les fournisseurs de cloud GPU, les places de marché, les hyperscalers, les plateformes d’inférence managée et les routes via API de modèles, puis vous donne une grille pour comparer le coût total de possession plutôt que les tarifs horaires affichés. Si vous avez d’abord besoin du modèle de tarification plus large, commencez par le guide Flatkey sur les tarifs de location de GPU.
La réponse rapide : les meilleures alternatives à RunPod par charge de travail
Utilisez ce tableau pour établir une première liste restreinte. Considérez-le comme une carte de décision, pas comme un classement universel.
| Charge de travail | Alternatives solides à RunPod à évaluer | Pourquoi elles conviennent | Ce qu’il faut vérifier avant de changer |
|---|---|---|---|
| Expérimentations ComfyUI et lots d’images | Vast.ai, TensorDock, Hyperstack, Paperspace/DigitalOcean, RunPod Community Cloud si vous restez | Accès rapide aux GPU, économie de place de marché ou en libre-service, bon choix pour les traitements par lots flexibles | Stockage persistant, temps de démarrage, fiabilité de l’hôte, bande passante, flux de redémarrage, adéquation du GPU aux données de production |
| Inférence stable sur un seul nœud | Lambda Cloud, Hyperstack, Massed Compute, Nebius, Vultr, VMs GPU AWS/GCP/Azure | Modèle d’instance plus clair, voies d’approvisionnement plus larges, contrôles d’infrastructure plus prévisibles | Disponibilité du GPU, région, support, coût du disque/réseau, quota, observabilité, autoscaling |
| Clusters GPU dédiés | Clusters réservés Lambda, CoreWeave, Crusoe Cloud, Massed Compute, Nebius, AWS Capacity Blocks, réservations Google Cloud, Azure ND-series | Mieux adapté aux capacités engagées, au support, au réseau privé et à la planification de clusters multi-nœuds | Fabric réseau, garantie de placement, SLA de support, durée d’engagement, chemin de montée en gamme, seuil de rentabilité de l’utilisation |
| Endpoints d’inférence serverless | Replicate, endpoints dédiés Together AI, plateformes de type Modal, fonctions cloud avec support GPU, RunPod Serverless si vous restez | Utile lorsque vous avez davantage besoin d’un comportement d’inférence déployé que d’un contrôle brut des VM | Démarrages à froid, workers minimum, tarification à la requête, limites de packaging des modèles, logs, politique de données |
| Utilisation de modèles frontier ou d’API multi-modèles | Flatkey, routeurs de type OpenRouter, API de modèles propriétaires | Évite les opérations GPU lorsque la valeur réside dans le résultat, et non dans le contrôle du matériel | Disponibilité des modèles, endpoints officiels, comportement de repli, journal d’utilisation, contrôles budgétaires, politique de données |
Pour la plupart des équipes, les meilleures alternatives à RunPod ne sont pas un seul fournisseur. Il s’agit d’une architecture répartie :
- Utilisez des GPU de place de marché pour les expériences et les traitements média par pics.
- Utilisez un cloud GPU spécialisé ou un hyperscaler pour une capacité de production stable.
- Utilisez une API/un routeur de modèles lorsque le produit n’a pas besoin d’un contrôle direct sur les poids, les kernels ou le placement GPU.
Cette répartition évite qu’une charge de travail impose à toutes les autres le mauvais modèle d’infrastructure.
Quand RunPod reste un bon choix
Cet article n’est pas un « RunPod est mauvais ». RunPod est populaire parce qu’il réduit le temps de mise en place. Les développeurs peuvent lancer des pods GPU, exécuter des notebooks et des conteneurs, expérimenter avec des capacités communautaires ou sécurisées, et utiliser des endpoints serverless sans passer par un processus d’approvisionnement d’hyperscaler.
RunPod reste souvent un bon choix lorsque :
- Vous avez besoin d’un accès rapide au GPU pour expérimenter.
- Vous testez ComfyUI, Stable Diffusion, des workflows LoRA ou la génération de médias par lots.
- Vous voulez un développement simple basé sur des pods avant de concevoir un cluster de production.
- Vous pouvez tolérer une certaine variabilité d’infrastructure pendant la phase d’exploration.
- Votre charge de travail peut être redémarrée ou reconstruite sans incident client grave.
Le changement mérite généralement d’être évalué lorsque la charge de travail devient coûteuse, constante, sensible à la sécurité, sensible à la latence ou visible pour les achats. À ce stade, vous devez comparer les alternatives à RunPod selon l’adéquation à la charge de travail, et non selon la familiarité de la marque.
Cadre de comparaison des alternatives à RunPod
Commencez avec cette formule normalisée :
coût effectif par charge de travail acceptée =
  calcul
  + stockage
  + instantanés
  + bande passante et sortie de données
  + temps d'inactivité
  + démarrages à froid
  + tâches échouées et nouvelles tentatives
  + support
  + surcharge d'ingénierie
  / jetons, tâches, images, vidéos, fine-tunes ou demandes clients acceptés
Puis posez six questions avant de comparer les fournisseurs.
| Question | Pourquoi cela change la réponse |
|---|---|
| Avez-vous besoin du contrôle du GPU ou simplement de résultats d’IA ? | Si vous avez seulement besoin de texte généré, d’images, d’embeddings ou de transcriptions, une approche par API peut être moins coûteuse sur le plan opérationnel que la location de GPU. |
| La charge de travail est-elle interactive ou par lots ? | L’inférence interactive nécessite une latence p95/p99 et de la disponibilité. Les jobs par lots peuvent échanger le temps en file d’attente contre un coût plus faible. |
| Le job est-il interrompable ? | Les capacités de type marketplace et spot peuvent convenir à des jobs avec points de contrôle ; elles peuvent être dangereuses pour des jobs longs et avec état. |
| Le modèle tient-il sur un seul GPU ? | Les charges de travail multi-GPU et multi-nœuds ajoutent des risques liés à la topologie, au réseau, au planificateur et au placement. |
| L’utilisation est-elle prévisible ? | Une capacité réservée ou dédiée nécessite une utilisation de base suffisante pour être plus avantageuse que l’on-demand. |
| Qui prend en charge les opérations ? | Les pilotes GPU, les images CUDA, vLLM/SGLang, le nettoyage du stockage, l’observabilité et la réponse aux incidents font partie du coût réel. |
C’est là que de nombreuses comparaisons d’alternatives à RunPod deviennent superficielles. Une liste de fournisseurs ne suffit pas. Vous avez besoin d’un modèle d’approvisionnement. Pour une capacité multi-nœuds, associez cet article à la checklist de location de cluster GPU.
Alternatives cloud GPU à RunPod
Lambda Cloud
Lambda Cloud est l’une des alternatives à RunPod les plus claires lorsque vous voulez un cloud GPU spécialisé avec des options d’instances GPU publiées et un processus d’achat d’infrastructure plus traditionnel. Cela vaut la peine de l’évaluer pour les capacités H100, H200, B200, A100 et autres capacités NVIDIA lorsque votre charge de travail passe des expérimentations à un entraînement ou une inférence reproductibles.
Utilisez Lambda lorsque vous voulez :
- Des instances cloud GPU simples.
- Un fournisseur d’infrastructure IA spécialisé plutôt qu’un hyperscaler généraliste.
- Un chemin allant des expérimentations à la demande vers une capacité réservée ou engagée.
- Une ligne source que les achats peuvent comprendre rapidement.
Vérifiez la disponibilité actuelle des instances, la variante exacte de GPU, le stockage local, la région, le support, et si le devis est à la demande, réservé ou orienté cluster. Utilisez la page officielle Lambda GPU Cloud comme point de vérification source, puis demandez un devis si vous avez besoin d’une capacité dédiée. Pour les arbitrages entre familles de GPU, consultez le guide Flatkey sur le meilleur GPU pour l’inférence LLM.
CoreWeave
CoreWeave est une alternative solide à RunPod pour les équipes qui sont allées au-delà d’un simple pod et ont besoin d’une capacité cloud GPU à grande échelle. Il est plus pertinent pour les charges de travail IA en production, les environnements dédiés et l’approvisionnement GPU d’entreprise que pour des expérimentations ponctuelles de loisir.
Évaluez CoreWeave lorsque :
- Vous avez besoin d’une infrastructure GPU de production plutôt que d’un simple pod de développement.
- Vous accordez de l’importance aux opérations natives Kubernetes, au stockage, au réseau et au support.
- Vous planifiez une inférence, un entraînement ou une capacité média IA soutenus.
- Vous avez besoin d’un échange avec le fournisseur autour d’une capacité engagée et de conditions d’entreprise.
Le compromis est que CoreWeave n’est généralement pas l’option la plus légère pour une petite expérimentation. Il doit figurer sur la liste restreinte lorsque la planification de capacité, le support et la fiabilité en production comptent plus que le premier pod le plus rapide possible.
Crusoe Cloud
Crusoe Cloud mérite d’être comparé pour les équipes IA qui veulent une infrastructure GPU dédiée ou évolutive avec un approvisionnement d’entreprise et un positionnement axé sur la durabilité. Il figure souvent dans la même liste restreinte que Lambda, CoreWeave, Nebius et Massed Compute pour les discussions sur la capacité.
Utilisez Crusoe comme alternative à RunPod lorsque :
- Vous demandez une capacité de cluster plutôt qu’une location ponctuelle de GPU.
- Vous avez besoin d’un devis fournisseur avec support, région et conditions de capacité.
- Vous souhaitez une conversation avec un cloud spécialisé plutôt qu’un processus de quota chez un hyperscaler.
Vérifiez le modèle exact de GPU, l’interconnexion, le stockage, la portée du support et si votre charge de travail nécessite Kubernetes autogéré, Slurm ou un environnement managé.
Massed Compute
Massed Compute est un point de comparaison utile pour les acheteurs qui veulent des prix GPU publiés ainsi qu’un chemin vers une capacité réservée ou dédiée. C’est une alternative pratique à RunPod pour les équipes qui ont besoin d’une économie cloud GPU simple mais qui commencent à poser des questions d’entreprise.
Évaluez Massed Compute lorsque :
- Vous avez besoin d’une capacité de type H100/A100/L40S avec un point de départ public clair.
- Vous voulez comparer les tarifs GPU à la demande avec des engagements à plus long terme.
- Vous construisez une feuille de calcul d’approvisionnement pour un cluster dédié ou un pool de base pour l’inférence.
Utilisez la page officielle des tarifs Massed Compute comme ligne source active, puis demandez ce qui est inclus dans le support, le réseau, le stockage et les conditions réservées.
Nebius AI Cloud
Nebius est une alternative crédible à RunPod lorsque l’acheteur veut un cloud natif IA avec des services d’infrastructure managés autour des GPU, et pas seulement des serveurs bruts. C’est particulièrement pertinent lorsque votre équipe veut une plateforme cloud pour l’entraînement de modèles, l’inférence, les données et l’orchestration plutôt que des instances isolées.
Évaluez Nebius lorsque :
- Vous avez besoin d’un environnement cloud IA plus large.
- Vous accordez de l’importance à Kubernetes, aux services managés, au stockage et au réseau autour des charges de travail GPU.
- Vous voulez des alternatives en dehors de la liste restreinte par défaut des hyperscalers américains.
Pour le TCO, confirmez la disponibilité régionale, le support, le stockage, l’egress réseau, les quotas, les mécanismes de réservation et la disponibilité de la génération de GPU.
Hyperstack
Hyperstack est une alternative directe à RunPod pour les équipes qui comparent des fournisseurs de cloud GPU selon le type d’instance, le coût horaire et le déploiement en libre-service. Il est utile pour un accès rapide à des instances GPU NVIDIA sans devoir adopter une grande plateforme cloud.
Utilisez Hyperstack lorsque :
- Vous voulez un fournisseur de cloud GPU simple pour des expérimentations, de l’inférence ou des jobs par lots.
- Vous comparez la disponibilité des GPU H100, H200, A100, L40S, de classe RTX ou plus récents.
- Vous avez besoin d’un repère de tarification publique avant d’engager les équipes commerciales.
Utilisez la page officielle Hyperstack GPU pricing comme point de référence. Vérifiez tout de même le stockage, la bande passante, les attentes en matière de disponibilité, le support, et si votre GPU/région exact est disponible au démarrage du job.
Vultr Cloud GPU
Vultr a sa place dans la liste des alternatives à RunPod lorsque votre équipe veut un fournisseur cloud familier avec des options GPU, des régions mondiales et un packaging d’infrastructure plus simple qu’une place de marché GPU pure. Cela peut être intéressant pour les équipes qui utilisent déjà des VM cloud et veulent des capacités GPU sans adopter un nouveau modèle opérationnel.
Évaluez Vultr lorsque :
- Votre charge de travail se rapproche d’une VM classique plutôt que d’un cluster complexe.
- Vous avez besoin d’une infrastructure cloud mondiale avec accélération GPU.
- Vous voulez un fournisseur qui s’intègre aux pratiques d’exploitation cloud existantes.
Vérifiez le quota, la famille GPU, la région, le stockage persistant, l’egress, le support, et si la charge de travail nécessite une interconnexion haut de gamme qu’une simple VM GPU ne peut pas fournir.
Alternatives de place de marché à RunPod
Vast.ai
Vast.ai est l’une des alternatives à RunPod les plus courantes pour les développeurs à la recherche d’une offre GPU flexible et d’un faible coût d’entrée. C’est une place de marché, donc la comparaison fournisseur ne se limite pas à Vast.ai contre RunPod. Il faut comparer chaque hôte, GPU, emplacement, score de fiabilité, disque, réseau et profil d’interruption avec votre charge de travail.
Vast.ai convient souvent bien pour :
- Des expérimentations ComfyUI.
- La génération d’images par lots.
- Des jobs de recherche courts.
- Des tests d’inférence flexibles.
- Des charges de travail capables de faire des checkpoints et de réessayer.
Il est moins adapté aux charges de travail qui nécessitent un support prévisible, la conformité, un réseau privé ou une disponibilité stricte orientée client. Utilisez la page officielle Vast.ai pricing comme repère de place de marché en temps réel, mais ne comparez jamais uniquement le tarif horaire du GPU.
TensorDock
TensorDock est une autre alternative à RunPod de type place de marché. Sa page officielle sur le cloud GPU décrit une place de marché d’hôtes indépendants qui se font concurrence et fixent les prix, ce qui signifie que les acheteurs doivent évaluer chaque option de déploiement plutôt que de considérer TensorDock comme un cloud unique à tarif fixe.
TensorDock peut être utile lorsque :
- Vous voulez des choix flexibles de VM GPU.
- Vous avez besoin d’options GPU de classe RTX ou de type datacenter pour des projets courts.
- Vous pouvez évaluer les détails de l’hôte, le stockage, la bande passante et la fiabilité avant le lancement.
Utilisez la page officielle TensorDock GPU cloud comme point de référence. Pour la production, demandez si la capacité sélectionnée offre le support, l’isolation et les garanties opérationnelles dont votre charge client a besoin.
Alternatives hyperscaler à RunPod
AWS, Google Cloud et Azure ne sont pas toujours des alternatives à RunPod moins chères. Ce sont souvent des alternatives plus complètes sur le plan opérationnel.
AWS
AWS est pertinent lorsque la charge de travail nécessite une identité d’entreprise, la mise en réseau, la conformité, les achats et l’intégration avec les systèmes AWS existants. Pour les charges de travail de classe H100, les instances AWS P5 constituent le principal point de référence, et EC2 Capacity Blocks est pertinent lorsque vous avez besoin d’une capacité ML réservée pour une fenêtre définie.
AWS peut convenir lorsque :
- Vous exécutez déjà des systèmes de données, de sécurité et de déploiement sur AWS.
- Vous avez besoin d’achats et d’un support de niveau entreprise.
- Vous avez besoin d’un modèle de réservation défini pour une période d’entraînement ou de lancement.
- Vous pouvez gérer la complexité du cloud et la gestion des quotas.
Consultez AWS P5 instances et EC2 Capacity Blocks for ML, puis intégrez EBS, le transfert de données, le support, NAT, l’observabilité et le temps d’ingénierie dans le TCO. Si la décision porte spécifiquement sur les capacités NVIDIA plus anciennes ou plus récentes, utilisez les comparaisons H100 vs A100 et H200 vs H100 comme lectures complémentaires.
Google Cloud
Google Cloud est une alternative à RunPod lorsque votre équipe veut des familles de machines optimisées pour accélérateurs, des contrôles d’entreprise et un environnement cloud-native autour des données, du réseau et de Kubernetes. Il est particulièrement pertinent pour les organisations qui utilisent déjà l’infrastructure de données Google Cloud.
Utilisez Google Cloud lorsque :
- Votre charge de travail nécessite une proximité des données cloud avec BigQuery, GCS, GKE ou Vertex AI.
- Vous avez besoin de contrôles d’identité, d’audit et d’achats de niveau entreprise.
- Vous pouvez planifier en tenant compte des quotas, des régions, du disque et des tarifs réseau.
Utilisez la documentation Google Cloud sur les machines optimisées pour accélérateurs et les tarifs GPU de Compute Engine comme points de référence. Normalisez les hypothèses sur le GPU, la machine, le disque, le réseau et l’utilisation engagée avant de le comparer à des clouds GPU spécialisés.
Azure
Azure est une alternative pratique à RunPod pour les entreprises déjà standardisées sur le cloud, l’identité, la sécurité, les achats ou les systèmes de données Microsoft. La série ND H100 v5 d’Azure est un point de référence clé pour les charges de travail de type cluster H100.
Utilisez Azure lorsque :
- Votre entreprise achète déjà via des accords Microsoft.
- Vous avez besoin de sécurité, de conformité et de contrôles réseau de niveau entreprise.
- Vous avez besoin de VMs GPU liées à une infrastructure de données ou d’applications Azure plus large.
Consultez la série Azure ND H100 v5, puis vérifiez la disponibilité régionale, les quotas, les exigences InfiniBand, le stockage, le support et la complexité du déploiement.
Alternatives serverless et d’inférence managée
Toute alternative à RunPod ne doit pas forcément être un GPU loué. Si votre équipe veut un endpoint, pas une machine, l’inférence managée peut supprimer une grande partie du travail opérationnel.
Replicate
Replicate est un excellent choix lorsque l’équipe veut exécuter des modèles via une API, déployer des versions de modèle et éviter de gérer directement des hôtes GPU. C’est particulièrement utile pour les équipes produit qui cherchent à livrer rapidement des fonctionnalités fondées sur des modèles.
Replicate peut convenir à :
- L’inférence de modèles open source, d’images, de vidéos et d’audio.
- Des prototypes de produit qui nécessitent rapidement une API.
- Des équipes qui privilégient l’ergonomie du déploiement plutôt qu’un contrôle GPU de bas niveau.
Utilisez les tarifs Replicate comme point de référence source, puis vérifiez les options matérielles, le comportement de déploiement, les cold starts, les journaux, le traitement des données et si la charge de travail nécessite des kernels personnalisés ou un réseau privé.
Together AI
Together AI est une alternative à RunPod lorsque la charge de travail se rapproche davantage de l’inférence LLM et du fine-tuning que de la location générale de VM GPU. Elle figure sur la liste restreinte des équipes qui veulent de l’inférence managée, des endpoints dédiés et une infrastructure de service de modèles sans exploiter toute la pile.
Together AI peut convenir à :
- Des endpoints d’inférence LLM.
- Des workflows de fine-tuning et d’évaluation.
- Des équipes qui veulent une infrastructure de service de modèles plutôt qu’une gestion brute de pods.
Utilisez les tarifs de Together AI comme point de référence des prix en temps réel et vérifiez si la charge de travail relève de l’inférence serverless, des endpoints dédiés, des API batch ou d’un accord d’entreprise personnalisé. Si vous auto-hébergez, comparez séparément les piles de service avec vLLM vs SGLang.
Alternatives d’API de modèles et de routeurs
Les alternatives RunPod les plus négligées sont les API de modèles et les routeurs. Si votre produit ne nécessite pas de poids personnalisés, de kernels CUDA personnalisés, de placement privé des GPU ou de contrôle de bas niveau du service, louer des GPU peut être la mauvaise abstraction.
Le positionnement de Flatkey est utile pour cette décision : une clé, un solde, une facture, un routage compatible OpenAI, des endpoints de modèles officiels, des registres d’utilisation, des contrôles budgétaires et des chemins de secours sur de nombreux modèles et outils. Cela ne remplace pas un cluster GPU dédié lorsque vous devez posséder la pile de service. En revanche, cela remplace le cluster lorsque vous avez besoin d’une sortie IA fiable avec des dépenses traçables. Pour la budgétisation côté modèle, comparez la feuille de calcul GPU avec la comparaison des tarifs des modèles d’IA et la gestion des dépenses des API d’IA.
Utilisez une API de modèle ou un routeur lorsque :
- Vous avez besoin d’accéder à de nombreux modèles de texte, d’image ou de vidéo.
- Le trafic est par à-coups et ne justifie pas des GPU réservés.
- Le choix du modèle change souvent.
- Vous n’avez pas besoin de gérer les poids, les pilotes, CUDA ou les kernels de service.
- La visibilité sur les coûts, les solutions de secours et la consolidation de la facturation comptent plus que le contrôle brut des GPU.
Utilisez des GPU dédiés lorsque :
- Vous servez des poids privés ou personnalisés.
- Vous avez besoin de kernels personnalisés, de quantification, d’adaptateurs ou de logique de service.
- La résidence des données ou l’isolation exige votre propre environnement.
- Le volume d’inférence est suffisamment stable pour justifier une capacité engagée.
- Vous pouvez pourvoir des ressources pour les opérations GPU.
C’est la question d’approvisionnement centrale : achetez-vous un accès au matériel ou des résultats acceptables ?
Alternatives à RunPod pour ComfyUI
Les recherches pour runpod alternatives comfyui proviennent généralement d’une difficulté pratique : le flux de travail fonctionne, mais le stockage, le temps de démarrage, les versions d’image et la reproductibilité deviennent agaçants.
Pour ComfyUI, comparez ces options :
| Option | Meilleur cas d’usage | Points de vigilance |
|---|---|---|
| Pods RunPod | Parcours familier si vous avez déjà des modèles et des volumes | Nettoyage des volumes persistants, coût à l’inactivité, dérive de l’image |
| Vast.ai ou TensorDock | Approvisionnement GPU flexible pour les tâches d’images par lots | Fiabilité de l’hôte, stockage, bande passante, redémarrages |
| Hyperstack ou Lambda | Modèle de cloud GPU plus conventionnel | Disponibilité, coût horaire, responsabilité de configuration |
| API de type Replicate | Fonctionnalités produit qui ont besoin de sorties image via une API | Moins de contrôle sur le flux de travail de bas niveau |
| Route Flatkey/API de modèle | Expérimentation multi-fournisseurs de modèles d’image/vidéo | Ne remplace pas les graphes ComfyUI personnalisés qui nécessitent un contrôle direct des nœuds |
Pour ComfyUI, ne comparez pas seulement le modèle de GPU et le tarif horaire. Mesurez aussi :
- Temps nécessaire pour récupérer les images et les poids du modèle.
- Coût du stockage persistant.
- Si les nœuds personnalisés survivent aux reconstructions.
- Temps d’inactivité après la fin d’un lot.
- Coût du transfert des sorties.
- Taux d’échec dû à des modèles manquants, à de mauvaises images ou à des redémarrages de l’hôte.
- Si le workflow a besoin d’une interface utilisateur, d’un point de terminaison API ou d’une file d’attente automatisée.
Les meilleures alternatives à RunPod pour ComfyUI sont généralement celles qui réduisent le temps de reconstruction et le stockage abandonné, et non celles qui affichent le coût horaire GPU le plus bas.
Liste de contrôle pour un cluster GPU dédié
Si la raison du changement est la capacité d’entreprise, utilisez cette liste de contrôle avant de signer une term sheet.
| Exigence | Ce qu’il faut demander à chaque fournisseur |
|---|---|
| Configuration GPU | Modèle exact du GPU, mémoire, PCIe/SXM/NVL, GPU par nœud, CPU, RAM, NVMe local |
| Réseau | InfiniBand, RoCE, EFA, NVLink/NVSwitch, garantie de placement, sursouscription, preuve de test NCCL |
| Stockage | Scratch local, système de fichiers partagé, région de stockage objet, débit des checkpoints, tarification des instantanés |
| Planificateur | Kubernetes, Slurm, Ray, service managé, accès utilisateur, quota, arrêt en cas d’inactivité |
| Fiabilité | Politique de remplacement des nœuds, fenêtres de maintenance, escalade des incidents, SLA, politique de relance |
| Sécurité | Isolation multi-tenant, journaux d’audit, gestion des secrets, réseau privé, suppression des données |
| Contrôles des coûts | Balises par équipe, exports d’utilisation, alertes budgétaires, détection d’inactivité, refacturation |
| Contrat | Durée minimale, dépense minimale, options d’absorption de pics, parcours de mise à niveau, annulation, périmètre du support |
Exécutez au moins un test d’acceptation avant que le contrat ne devienne difficile à résilier :
test d'acceptation du cluster =
  déployer le conteneur de production
  récupérer les poids du modèle et l'ensemble de données
  exécuter un benchmark représentatif
  exécuter un all-reduce NCCL si multi-nœud
  écrire et restaurer un checkpoint
  simuler un job en échec
  exporter les journaux de coût et d'utilisation
Si un fournisseur ne peut pas prendre en charge un benchmark représentatif, considérez cela comme un risque d’achat.
Replicate vs Together AI vs alternatives à RunPod
La requête replicate vs together ai vs runpod alternatives mélange trois catégories, donc comparez-les par niveau d’abstraction.
| Type de plateforme | Vous gérez | Le fournisseur gère | Cas d’usage idéal |
|---|---|---|---|
| Cloud GPU de type RunPod | Conteneurs, images, stockage, cycle de vie du GPU, pile de service | Infrastructure GPU et primitives de plateforme | Développeurs qui ont besoin d’un contrôle direct du GPU |
| Déploiement de modèles de type Replicate | Empaquetage du modèle et utilisation de l’API | Une grande partie de l’infrastructure de service et de l’ergonomie de déploiement côté utilisateur | Équipes produit qui publient rapidement des endpoints de modèle |
| Plateforme d’inférence de type Together AI | Sélection du modèle, choix de l’endpoint, conception de la charge de travail | Infrastructure de service LLM et opérations des endpoints | Équipes axées sur l’inférence/le fine-tuning LLM |
| Routeur de modèles de type Flatkey | Appels API, budgets, politique de routage des modèles | Couche d’accès multi-modèles, facturation unifiée, registre d’utilisation | Équipes qui ont besoin de sorties de modèles officielles, pas de la propriété du GPU |
Ne choisissez pas la ligne de coût la moins chère. Choisissez le risque opérationnel le plus faible pour le travail à réaliser.
Feuille de comparaison des alternatives à RunPod
Utilisez cette feuille lorsque vous comparez des fournisseurs de cloud GPU.
| Champ | Fournisseur A | Fournisseur B | Fournisseur C |
|---|---|---|---|
| Mode produit | Pod / VM / serverless / cluster réservé / API | ||
| Modèle GPU et mémoire | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| Région ou hôte | |||
| Unité de facturation | seconde, minute, heure, mensuel, bloc de capacité | ||
| Engagement minimum | aucun, mensuel, annuel, bloc réservé | ||
| Coût du stockage | volumes, instantanés, stockage objet, NVMe local | ||
| Coût réseau | sortant, liaison privée, interrégion, IP publique | ||
| Frais de démarrage | chargement d’image, téléchargement des poids, cold start | ||
| Taux d’inactivité | minutes facturables sans travail utile | ||
| Multiplicateur d’échec/de relance | expulsions, OOM, mauvais hôtes, échecs au démarrage à froid | ||
| Support | autoservice, ticket, support dédié, SLA | ||
| Sécurité | isolation multi-tenant, journaux d’audit, secrets, suppression | ||
| Unité de sortie acceptée | 1M tokens, image, vidéo, fine-tune, exécution d’entraînement | ||
| Coût effectif par sortie acceptée | calculé, pas estimé |
Ensuite, calculez :
coût horaire effectif =
  coût horaire du GPU
  + stockage par heure
  + réseau par heure
  + support par heure
  + gaspillage dû à l’inactivité
  + gaspillage dû aux relances
  + surcharge d’ingénierie

coût par sortie acceptée =
  coût horaire effectif / sorties acceptées par heure
C’est aussi ainsi que vous décidez si une capacité dédiée est meilleure que des API. Si le coût API par sortie acceptée est inférieur après prise en compte des opérations GPU, ne louez pas le cluster simplement parce que le tarif horaire GPU semble attractif.
Checklist des sources pour les tarifs actuels
Les tarifs et la disponibilité des GPU changent fréquemment. Avant de prendre une décision d’achat, vérifiez à nouveau les lignes sources et notez la date. Pour cette version, la checklist des sources a été vérifiée pour la disponibilité des pages le 12 octobre 2026.
| Fournisseur/catégorie | Point de contrôle source | Éléments à relever |
|---|---|---|
| RunPod | Tarifs RunPod, Documentation de stockage des pods RunPod | Mode pod, mode serverless, capacité sécurisée/communautaire, stockage, volume réseau, hypothèses d’inactivité |
| Lambda | Lambda GPU Cloud | Modèle de GPU, format d’instance, disponibilité, conditions de réservation ou de cluster |
| Vast.ai | Tarifs Vast.ai | Hôte, fiabilité, GPU, stockage, bande passante, conditions de la place de marché |
| Massed Compute | Tarifs Massed Compute | Tarifs à la demande, voie de réservation, support et conditions de cluster |
| Hyperstack | Tarifs GPU Hyperstack | Référence GPU, région, stockage, mise en réseau, support |
| TensorDock | Cloud GPU TensorDock | Hôte de la place de marché, GPU, RAM/vCPU, stockage, tarification au moment du déploiement |
| Replicate | Tarifs Replicate | Tarification du déploiement, matériel, démarrages à froid, journaux, politique de données |
| Together AI | Tarifs Together AI | Serverless, points de terminaison dédiés, fine-tuning, économie du traitement par lots |
| AWS | Instances EC2 P5, EC2 Capacity Blocks | Région, quota, famille d’instances, fenêtre de réservation, EBS, transfert de données, support |
| Google Cloud | Machines optimisées pour accélérateurs, Tarifs GPU | Famille de machines, prix du GPU, disque, réseau, remises pour engagement d’utilisation |
| Azure | Série ND H100 v5 | Taille de VM, région, quota, InfiniBand, support, stockage |
Recommandation finale
Sélectionnez les alternatives à RunPod selon le modèle opérationnel :
- Utilisez des places de marché comme Vast.ai ou TensorDock pour les expériences flexibles, les lots ComfyUI et les charges de travail tolérantes aux réessais.
- Utilisez des clouds GPU spécialisés comme Lambda, CoreWeave, Crusoe, Massed Compute, Nebius, Hyperstack ou Vultr lorsque vous avez besoin d’une capacité GPU et d’un support plus prévisibles.
- Utilisez des hyperscalers lorsque l’identité d’entreprise, les achats, la conformité et la gravité des données dans le cloud existant priment sur la simplicité.
- Utilisez des plateformes d’inférence gérées comme Replicate ou Together AI lorsque le comportement du point de terminaison compte plus que le contrôle de la VM.
- Utilisez Flatkey ou un autre routeur d’API de modèles lorsque vous avez besoin de sorties officielles de modèles IA, de visibilité sur l’utilisation, de bascule et d’une facturation unifiée plutôt que de la possession directe du GPU.
Les meilleures alternatives à RunPod sont celles qui réduisent le coût du travail accepté. Si un fournisseur vous donne une heure de GPU moins chère mais augmente le temps d’inactivité, la surcharge de démarrage, les échecs de tâches, le gaspillage de stockage ou la charge d’ingénierie, ce n’est pas réellement moins cher.
Foire aux questions
Quelles sont certaines alternatives à RunPod ?
Les alternatives courantes à RunPod incluent Lambda Cloud, CoreWeave, Crusoe Cloud, Massed Compute, Nebius AI Cloud, Hyperstack, Vultr Cloud GPU, Vast.ai, TensorDock, Replicate, Together AI, AWS, Google Cloud, Azure, ainsi que des routeurs d’API de modèles comme Flatkey. Le bon choix dépend de vos besoins en pods, points de terminaison serverless, clusters dédiés, places de marché ou accès aux modèles via API.
Quelle est la meilleure alternative à RunPod pour ComfyUI ?
Pour les expérimentations ComfyUI, Vast.ai, TensorDock, Hyperstack, Lambda et les clouds GPU de type Paperspace figurent souvent parmi les premières options. Comparez le stockage persistant, la mise en cache des poids de modèle, le temps de démarrage, la gestion des nœuds personnalisés, l’arrêt en cas d’inactivité, le transfert des sorties et la fiabilité de l’hôte avant de comparer les tarifs GPU horaires.
Les alternatives à RunPod sont-elles moins chères ?
Parfois, mais seulement après avoir calculé le coût effectif par sortie acceptée. Un tarif horaire GPU plus bas peut être désavantageux si la charge de travail passe plus de temps à télécharger les modèles, à rester inactive, à relancer des tâches échouées ou à déplacer des données. Comparez les images, jetons, vidéos ou tâches terminés, pas seulement les heures GPU.
Dois-je utiliser Replicate ou Together AI à la place de RunPod ?
Utilisez Replicate ou Together AI lorsque vous voulez des points de terminaison de modèles gérés et que vous n’avez pas besoin d’un contrôle bas niveau du GPU. Utilisez des clouds GPU de type RunPod lorsque vous avez besoin de conteneurs personnalisés, de workflows personnalisés, d’un accès direct au GPU ou d’un contrôle sur la pile de service.
Quand devrais-je utiliser Flatkey au lieu de louer des GPU ?
Utilisez Flatkey lorsque votre équipe a besoin d’API de modèles officielles, de routage multi-modèles, d’une seule clé, d’un seul solde, de registres d’utilisation, de bascule et de contrôles budgétaires. Louez des GPU lorsque des poids personnalisés, des noyaux personnalisés, un placement privé ou un taux d’utilisation élevé et stable rendent le contrôle direct de l’infrastructure rentable malgré le coût opérationnel.


