
Las alternativas a RunPod suelen entrar en la conversación después del primer prototipo exitoso. Un desarrollador consigue que funcione en RunPod un flujo de trabajo de ComfyUI, un fine-tune, un script de inferencia por lotes o un endpoint de vLLM; luego el equipo plantea una pregunta más difícil: ¿puede esto convertirse en capacidad de producción con coste predecible, soporte, almacenamiento, red, seguridad y condiciones de compra?
La respuesta depende de lo que estés sustituyendo. Un pod de RunPod, un endpoint de RunPod Serverless, una instancia segura de GPU, una GPU comunitaria y una conversación sobre capacidad empresarial son movimientos de compra distintos. Las alternativas a RunPod adecuadas para un lote de ComfyUI de fin de semana no son las mismas que las adecuadas para un clúster privado de H100, un trabajo de entrenamiento multinodo o un servicio de inferencia orientado al cliente.
Esta guía compara alternativas a RunPod para desarrolladores y equipos de IA pequeños y medianos que necesitan más que una hora barata de GPU. Cubre proveedores de nube GPU, marketplaces, hiperescaladores, plataformas de inferencia gestionada y rutas de API de modelos, y luego te ofrece una hoja de trabajo para comparar el coste total de propiedad en lugar de las tarifas horarias destacadas. Si necesitas primero el modelo de precios más amplio, empieza con la guía de Flatkey sobre precios de alquiler de GPU.
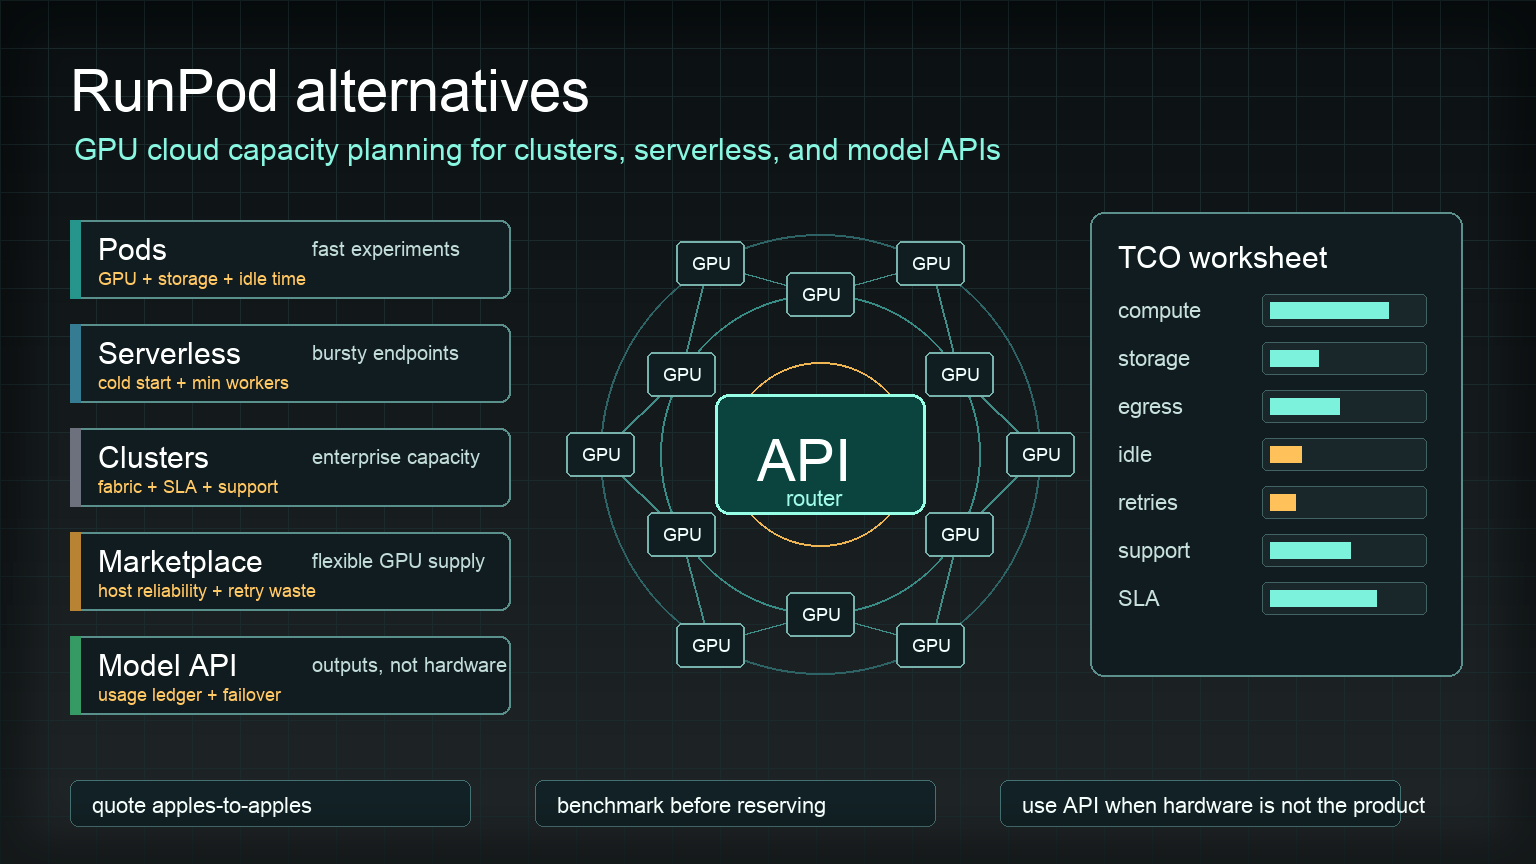
La respuesta rápida: las mejores alternativas a RunPod por carga de trabajo
Usa esta tabla para construir la primera lista corta. Trátala como un mapa de decisión, no como una clasificación universal.
| Carga de trabajo | Fuertes alternativas a RunPod a evaluar | Por qué encajan | Qué verificar antes de cambiar |
|---|---|---|---|
| Experimentos de ComfyUI y lotes de imágenes | Vast.ai, TensorDock, Hyperstack, Paperspace/DigitalOcean, RunPod Community Cloud si se mantiene | Acceso rápido a GPU, economía de marketplace o autoservicio, buen ajuste para trabajo por lotes flexible | Almacenamiento persistente, tiempo de arranque, fiabilidad del host, ancho de banda, flujo de trabajo de reinicio, si la GPU es adecuada para datos de producción |
| Inferencia estable en un solo nodo | Lambda Cloud, Hyperstack, Massed Compute, Nebius, Vultr, VMs GPU de AWS/GCP/Azure | Modelo de instancia más limpio, rutas de compra más amplias, controles de infraestructura más predecibles | Disponibilidad de GPU, región, soporte, coste de disco/red, cuota, observabilidad, escalado automático |
| Clústeres de GPU dedicados | Clústeres reservados de Lambda, CoreWeave, Crusoe Cloud, Massed Compute, Nebius, AWS Capacity Blocks, reservas de Google Cloud, Azure serie ND | Mejor ajuste para capacidad comprometida, soporte, red privada y planificación de clúster multinodo | Fabric de red, garantía de colocación, SLA de soporte, duración del término, ruta de actualización, punto de equilibrio de utilización |
| Endpoints de inferencia serverless | Replicate, endpoints dedicados de Together AI, plataformas estilo Modal, funciones en la nube con soporte GPU, RunPod Serverless si se mantiene | Buena opción cuando necesitas el comportamiento de inferencia desplegada más que control bruto de la VM | Arranques en frío, workers mínimos, precios por solicitud, límites de empaquetado del modelo, registros, política de datos |
| Uso de API de modelo de vanguardia o multimodelo | Flatkey, routers estilo OpenRouter, API de modelo de primera parte | Evita operar GPUs cuando el valor está en la salida, no en el control del hardware | Disponibilidad del modelo, endpoints oficiales, comportamiento de respaldo, registro de uso, controles de presupuesto, política de datos |
Para la mayoría de los equipos, las mejores alternativas a RunPod no son un único proveedor. Son una arquitectura dividida:
- Usa GPUs de marketplace para experimentos y lotes de medios con picos.
- Usa una nube GPU especializada o un hiperescalador para capacidad de producción estable.
- Usa una API/router de modelo cuando el producto no necesita control directo sobre pesos, kernels o ubicación de la GPU.
Esa división evita que una carga de trabajo fuerce el modelo de infraestructura equivocado sobre todas las demás.
Cuándo RunPod sigue siendo una buena opción
Este no es un artículo de "RunPod es malo". RunPod es popular porque comprime el tiempo de configuración. Los desarrolladores pueden lanzar pods de GPU, ejecutar notebooks y contenedores, experimentar con capacidad comunitaria o segura, y usar endpoints serverless sin empezar con un proceso de adquisición de hiperescalador.
RunPod suele seguir siendo una buena opción cuando:
- Necesitas acceso rápido a GPU para experimentos.
- Estás probando ComfyUI, Stable Diffusion, flujos de trabajo de LoRA o generación de medios por lotes.
- Quieres un desarrollo sencillo basado en pods antes de diseñar un clúster de producción.
- Puedes tolerar cierta variabilidad de infraestructura mientras sigues explorando.
- Tu carga de trabajo puede reiniciarse o reconstruirse sin un incidente serio para el cliente.
Normalmente merece la pena evaluar el cambio cuando la carga de trabajo se vuelve costosa, constante, sensible a la seguridad, sensible a la latencia o visible para compras. En ese momento, deberías comparar las alternativas a RunPod en función de su adecuación a la carga de trabajo, no de la familiaridad con la marca.
Marco de comparación de alternativas a RunPod
Empieza con esta fórmula normalizada:
coste efectivo por carga de trabajo aceptada =
  cómputo
  + almacenamiento
  + instantáneas
  + ancho de banda y egreso
  + tiempo inactivo
  + arranques en frío
  + trabajos fallidos y reintentos
  + soporte
  + sobrecarga de ingeniería
  / tokens, trabajos, imágenes, vídeos, fine-tunes o solicitudes de cliente aceptados
Luego haz seis preguntas antes de comparar proveedores.
| Pregunta | Por qué cambia la respuesta |
|---|---|
| ¿Necesitas control de GPU o solo resultados de IA? | Si solo necesitas texto generado, imágenes, embeddings o transcripciones, una ruta por API puede ser operativamente más barata que alquilar GPUs. |
| ¿La carga de trabajo es interactiva o por lotes? | La inferencia interactiva necesita latencia p95/p99 y disponibilidad. Los trabajos por lotes pueden intercambiar tiempo en cola por menor coste. |
| ¿El trabajo se puede interrumpir? | La capacidad de marketplace y tipo spot puede funcionar para trabajos con checkpoints; puede ser peligrosa para trabajos largos y con estado. |
| ¿El modelo cabe en una sola GPU? | Las cargas de trabajo multinodo y con varias GPU añaden riesgo de topología, red, programador y ubicación. |
| ¿El uso es predecible? | La capacidad reservada o dedicada necesita suficiente uso base para superar la modalidad bajo demanda. |
| ¿Quién se encarga de las operaciones? | Los controladores de GPU, las imágenes CUDA, vLLM/SGLang, la limpieza de almacenamiento, la observabilidad y la respuesta a incidentes forman parte del coste real. |
Aquí es donde muchas comparaciones de alternativas a RunPod se quedan superficiales. Una lista de proveedores no basta. Necesitas un modelo de adquisición. Para la capacidad multinodo, combina este artículo con la lista de verificación de alquiler de clústeres de GPU.
Alternativas de nube de GPU a RunPod
Lambda Cloud
Lambda Cloud es una de las alternativas más claras a RunPod cuando quieres una nube de GPU especializada con opciones publicadas de instancias de GPU y un proceso de compra de infraestructura más convencional. Merece la pena evaluarla para capacidad H100, H200, B200, A100 y otra capacidad NVIDIA cuando tu carga de trabajo pasa de experimentos a entrenamiento o inferencia repetibles.
Usa Lambda cuando quieras:
- Instancias de nube de GPU sencillas.
- Un proveedor especializado de infraestructura de IA en lugar de un hyperscaler amplio.
- Un camino desde experimentos bajo demanda hacia capacidad reservada o comprometida.
- Una referencia que compras puede entender rápidamente.
Verifica la disponibilidad actual de instancias, la variante exacta de GPU, el almacenamiento local, la región, el soporte y si la cotización es bajo demanda, reservada u orientada a clúster. Usa la página oficial de Lambda GPU Cloud como punto de comprobación de origen y luego solicita una cotización si necesitas capacidad dedicada. Para las compensaciones entre familias de GPU, consulta la guía de Flatkey sobre la mejor GPU para inferencia LLM.
CoreWeave
CoreWeave es una sólida alternativa a RunPod para equipos que han pasado de un solo pod y necesitan capacidad de GPU en la nube a escala. Es más relevante para cargas de trabajo de IA en producción, entornos dedicados y compras empresariales de GPU que para experimentos puntuales de aficionado.
Evalúa CoreWeave cuando:
- Necesitas infraestructura de GPU de producción en lugar de un simple pod de desarrollo.
- Te importan las operaciones nativas de Kubernetes, el almacenamiento, la red y el soporte.
- Estás planificando capacidad sostenida de inferencia, entrenamiento o medios de IA.
- Necesitas una conversación con el proveedor sobre capacidad comprometida y condiciones empresariales.
La contrapartida es que CoreWeave no suele ser la ruta más ligera para un experimento pequeño. Debe estar en la lista corta cuando la planificación de capacidad, el soporte y la fiabilidad de producción importan más que conseguir el primer pod lo antes posible.
Crusoe Cloud
Crusoe Cloud merece la pena compararla para equipos de IA que quieren infraestructura de GPU dedicada o escalable con compras empresariales y un posicionamiento orientado a la sostenibilidad. A menudo forma parte de la misma lista corta que Lambda, CoreWeave, Nebius y Massed Compute para conversaciones sobre capacidad.
Usa Crusoe como alternativa a RunPod cuando:
- Estás pidiendo capacidad de clúster en lugar de alquiler puntual de GPU.
- Necesitas una cotización del proveedor con soporte, región y términos de capacidad.
- Quieres una conversación con una nube especializada en lugar de un proceso de cuotas de hyperscaler.
Comprueba el modelo exacto de GPU, la interconexión, el almacenamiento, el alcance del soporte y si tu carga de trabajo necesita Kubernetes autogestionado, Slurm o un entorno gestionado.
Massed Compute
Massed Compute es un punto de comparación útil para compradores que quieren precios de GPU publicados y además una vía hacia capacidad reservada o dedicada. Es una alternativa práctica a RunPod para equipos que necesitan una economía de nube de GPU sencilla pero que ya empiezan a plantearse preguntas empresariales.
Evalúa Massed Compute cuando:
- Necesitas capacidad estilo H100/A100/L40S con un punto de partida público claro.
- Quieres comparar tarifas de GPU bajo demanda frente a compromisos a más largo plazo.
- Estás creando una hoja de cálculo de compras para un clúster dedicado o un pool base de inferencia.
Usa la página oficial de precios de Massed Compute como una fila de origen en vivo y luego pregunta qué incluye en soporte, red, almacenamiento y condiciones reservadas.
Nebius AI Cloud
Nebius es una alternativa creíble a RunPod cuando el comprador quiere una nube nativa de IA con servicios de infraestructura gestionados alrededor de GPUs, no solo servidores en bruto. Es especialmente relevante cuando tu equipo quiere una plataforma en la nube para entrenamiento de modelos, inferencia, datos y orquestación, en lugar de instancias aisladas.
Evalúa Nebius cuando:
- Necesitas un entorno de nube de IA más amplio.
- Te importan Kubernetes, los servicios gestionados, el almacenamiento y la red alrededor de cargas de trabajo GPU.
- Quieres alternativas fuera de la lista estándar de hyperscalers de EE. UU.
Para el TCO, confirma la disponibilidad regional, el soporte, el almacenamiento, la salida de red, las cuotas, la mecánica de reserva y la disponibilidad de la generación de GPU.
Hyperstack
Hyperstack es una alternativa directa a RunPod para equipos que comparan proveedores de nube GPU por tipo de instancia, coste por hora y despliegue autoservicio. Es útil para acceder rápidamente a instancias GPU de NVIDIA sin asumir una gran plataforma en la nube.
Use Hyperstack cuando:
- Quiera un proveedor sencillo de nube GPU para experimentos, inferencia o trabajos por lotes.
- Esté comparando la disponibilidad de H100, H200, A100, L40S, GPU de clase RTX o GPU más nuevas.
- Necesite una referencia pública de precios antes de hablar con ventas.
Use la página oficial de precios de GPU de Hyperstack como referencia principal. Aun así, verifique el almacenamiento, el ancho de banda, las expectativas de disponibilidad, el soporte y si su GPU/región exacta está disponible cuando se inicie el trabajo.
Vultr Cloud GPU
Vultr debe figurar en la lista de alternativas a RunPod cuando su equipo quiere un proveedor de nube conocido con opciones de GPU, regiones globales y un empaquetado de infraestructura más simple que un mercado puramente GPU. Puede resultar atractivo para equipos que ya usan máquinas virtuales en la nube y quieren capacidad GPU sin adoptar un nuevo modelo operativo.
Evalúe Vultr cuando:
- Su carga de trabajo se parezca más a una VM convencional que a un clúster complejo.
- Necesite infraestructura en la nube global además de aceleración por GPU.
- Quiera un proveedor que encaje con los patrones existentes de operaciones en la nube.
Revise la cuota, la familia de GPU, la región, el almacenamiento persistente, la salida de datos, el soporte y si la carga de trabajo necesita una interconexión de gama alta que una VM GPU simple no puede ofrecer.
Alternativas de mercado a RunPod
Vast.ai
Vast.ai es una de las alternativas a RunPod más comunes para desarrolladores que buscan suministro flexible de GPU y un bajo coste de entrada. Es un mercado, por lo que la comparación de proveedores no es solo Vast.ai frente a RunPod. Es cada host, GPU, ubicación, puntuación de fiabilidad, disco, red y perfil de interrupción frente a su carga de trabajo.
Vast.ai suele encajar bien para:
- Experimentos con ComfyUI.
- Generación de imágenes por lotes.
- Trabajos de investigación cortos.
- Pruebas de inferencia flexibles.
- Cargas de trabajo que pueden guardar estado y reintentar.
Es menos adecuado para cargas que necesitan soporte predecible, cumplimiento normativo, redes privadas o disponibilidad estricta de cara al cliente. Use la página oficial de precios de Vast.ai como referencia en vivo del mercado, pero nunca compare solo la tarifa horaria de la GPU.
TensorDock
TensorDock es otra alternativa a RunPod de estilo mercado. Su página oficial de nube GPU describe un mercado de hosts independientes que compiten y fijan precios, lo que significa que los compradores deben evaluar cada opción de despliegue en lugar de tratar TensorDock como una nube única con tarifa fija.
TensorDock puede ser útil cuando:
- Quiere opciones flexibles de VM GPU.
- Necesita opciones de GPU de clase RTX o de centro de datos para proyectos cortos.
- Puede evaluar los detalles del host, el almacenamiento, el ancho de banda y la fiabilidad antes del lanzamiento.
Use la página oficial de nube GPU de TensorDock como referencia principal. En producción, pregunte si la capacidad seleccionada tiene el soporte, el aislamiento y las garantías operativas que necesita su carga de trabajo para clientes.
Alternativas a RunPod de hiperescaladores
AWS, Google Cloud y Azure no siempre son alternativas más baratas a RunPod. A menudo son alternativas más completas desde el punto de vista operativo.
AWS
AWS es relevante cuando la carga de trabajo necesita identidad empresarial, redes, cumplimiento, compras e integración con sistemas existentes de AWS. Para cargas de trabajo de clase H100, las instancias P5 de AWS son la principal referencia, y los EC2 Capacity Blocks son relevantes cuando necesita capacidad ML reservada para una ventana definida.
AWS puede encajar cuando:
- Ya ejecuta sus sistemas de datos, seguridad y despliegue en AWS.
- Necesita compras y soporte empresariales.
- Necesita un modelo de reserva definido para una ventana de entrenamiento o lanzamiento.
- Puede gestionar la complejidad de la nube y la administración de cuotas.
Revise instancias AWS P5 y EC2 Capacity Blocks para ML, y luego incluya EBS, transferencia de datos, soporte, NAT, observabilidad y tiempo de ingeniería en el TCO. Si la decisión trata específicamente sobre capacidad NVIDIA más antigua frente a más nueva, use las comparativas H100 vs A100 y H200 vs H100 como lecturas complementarias.
Google Cloud
Google Cloud es una alternativa a RunPod cuando su equipo quiere familias de máquinas optimizadas para aceleradores, controles empresariales y un entorno nativo en la nube en torno a datos, redes y Kubernetes. Es especialmente relevante para organizaciones que ya utilizan infraestructura de datos de Google Cloud.
Use Google Cloud cuando:
- Su carga de trabajo necesite proximidad de datos en la nube con BigQuery, GCS, GKE o Vertex AI.
- Necesite controles empresariales de identidad, auditoría y compras.
- Pueda planificar en torno a cuotas, regiones, disco y precios de red.
Use la documentación de máquinas optimizadas para aceleradores de Google Cloud y los precios de GPU de Compute Engine como referencias principales. Normalice los supuestos de GPU, máquina, disco, red y uso comprometido antes de compararlo con nubes GPU especializadas.
Azure
Azure es una alternativa práctica a RunPod para empresas que ya están estandarizadas en Microsoft cloud, identidad, seguridad, compras o sistemas de datos. La serie ND H100 v5 de Azure es un punto de verificación clave de referencia para cargas de trabajo de estilo clúster con H100.
Usa Azure cuando:
- Tu empresa ya compra mediante acuerdos con Microsoft.
- Necesitas seguridad, cumplimiento y controles de red empresariales.
- Necesitas máquinas virtuales con GPU vinculadas a una infraestructura de datos o aplicaciones más amplia de Azure.
Consulta la serie ND H100 v5 de Azure, y luego valida la disponibilidad regional, la cuota, los requisitos de InfiniBand, el almacenamiento, el soporte y la complejidad de implementación.
Alternativas sin servidor y de inferencia gestionada
No toda alternativa a RunPod debe ser una GPU alquilada. Si tu equipo quiere un endpoint, no una máquina, la inferencia gestionada puede eliminar gran parte del trabajo operativo.
Replicate
Replicate encaja bien cuando el equipo quiere ejecutar modelos a través de una API, desplegar versiones de modelos y evitar administrar hosts de GPU directamente. Es especialmente útil para equipos de producto que valoran lanzar rápidamente funciones respaldadas por modelos.
Replicate puede encajar en:
- Inferencia de modelos de imagen, vídeo, audio y de código abierto.
- Prototipos de producto que necesitan una API rápidamente.
- Equipos que prefieren la ergonomía de despliegue frente al control detallado de la GPU.
Usa los precios de Replicate como punto de verificación de referencia y luego verifica las opciones de hardware, el comportamiento de despliegue, los arranques en frío, los registros, el manejo de datos y si la carga de trabajo necesita kernels personalizados o redes privadas.
Together AI
Together AI es una alternativa a RunPod cuando la carga de trabajo se parece más a inferencia y ajuste fino de LLM que al alquiler general de máquinas virtuales con GPU. Debe estar en la lista corta para equipos que quieren inferencia gestionada, endpoints dedicados e infraestructura de servicio de modelos sin operar todo el stack.
Together AI puede encajar en:
- Endpoints de inferencia de LLM.
- Flujos de trabajo de ajuste fino y evaluación.
- Equipos que quieren infraestructura de servicio de modelos en lugar de gestión de pods en bruto.
Usa los precios de Together AI como punto de verificación de precios en vivo y comprueba si la carga de trabajo debe ir en inferencia sin servidor, endpoints dedicados, API por lotes o un acuerdo empresarial personalizado. Si vas a autohospedar, compara las pilas de servicio por separado con vLLM vs SGLang.
Alternativas de API de modelos y enrutadores
Las alternativas a RunPod que más se pasan por alto son las API de modelos y los enrutadores. Si tu producto no requiere pesos personalizados, kernels CUDA personalizados, ubicación privada de GPU o control de servicio de bajo nivel, alquilar GPU puede ser la abstracción equivocada.
El posicionamiento de Flatkey es útil para esta decisión: una clave, un saldo, una factura, enrutamiento compatible con OpenAI, endpoints oficiales de modelos, libros de consumo, controles de presupuesto y rutas de respaldo entre muchos modelos y herramientas. Eso no reemplaza un clúster de GPU dedicado cuando necesitas ser dueño de la pila de servicio. Sí reemplaza el clúster cuando lo que necesitas es una salida de IA fiable con gasto trazable. Para la presupuestación del lado del modelo, compara la hoja de cálculo de GPU con la comparación de precios de modelos de IA y la gestión del gasto en API de IA.
Usa una API de modelo o un enrutador cuando:
- Necesitas acceso a muchos modelos de texto, imagen o vídeo.
- El tráfico es intermitente y no justifica GPU reservadas.
- La elección del modelo cambia con frecuencia.
- No necesitas gestionar pesos, controladores, CUDA o kernels de servicio.
- La visibilidad de costes, la conmutación por error y la consolidación de facturación importan más que el control bruto de la GPU.
Usa GPU dedicadas cuando:
- Sirves pesos privados o personalizados.
- Necesitas kernels personalizados, cuantización, adaptadores o lógica de servicio.
- La residencia o el aislamiento de datos requieren tu propio entorno.
- El volumen de inferencia es lo bastante estable como para justificar capacidad comprometida.
- Puedes dotarte de personal para operaciones de GPU.
Esa es la pregunta central de compras: ¿estás comprando acceso al hardware o resultados aceptados?
Alternativas a RunPod para ComfyUI
Las búsquedas de runpod alternatives comfyui suelen venir de un dolor práctico: el flujo funciona, pero el almacenamiento, el tiempo de arranque, las versiones de imagen y la repetibilidad se están volviendo molestos.
Para ComfyUI, compara estas opciones:
| Opción | Mejor encaje | Advertencias |
|---|---|---|
| Pods de RunPod | Camino familiar si ya tienes plantillas y volúmenes | Limpieza de volúmenes persistentes, coste en inactividad, deriva de imágenes |
| Vast.ai o TensorDock | Oferta flexible de GPU para trabajos de imagen por lotes | Fiabilidad del host, almacenamiento, ancho de banda, reinicios |
| Hyperstack o Lambda | Modelo de instancia de nube GPU más convencional | Disponibilidad, coste por hora, responsabilidad de configuración |
| API al estilo Replicate | Funciones de producto que necesitan resultados de imagen a través de una API | Menor control del flujo de trabajo de bajo nivel |
| Ruta Flatkey/API de modelos | Experimentación con modelos de imagen/vídeo de múltiples proveedores | No sustituye a gráficos de ComfyUI personalizados que requieren control directo de nodos |
Para ComfyUI, no compares solo el modelo de GPU y la tarifa por hora. Mide también:
- Tiempo para descargar imágenes y pesos del modelo.
- Costo de almacenamiento persistente.
- Si los nodos personalizados sobreviven a las reconstrucciones.
- Tiempo de inactividad después de que finaliza un lote.
- Costo de transferencia de salida.
- Tasa de fallos por modelos faltantes, imágenes defectuosas o reinicios del host.
- Si el flujo de trabajo necesita una interfaz de usuario, un endpoint de API o una cola automatizada.
Las mejores alternativas a RunPod para ComfyUI suelen ser las que reducen el tiempo de reconstrucción y el almacenamiento abandonado, no las que tienen la hora de GPU visible más baja.
Lista de verificación para clústeres de GPU dedicados
Si el motivo del cambio es la capacidad empresarial, usa esta lista de verificación antes de firmar una hoja de términos.
| Requisito | Qué preguntar a cada proveedor |
|---|---|
| Forma de la GPU | Modelo exacto de GPU, memoria, PCIe/SXM/NVL, GPUs por nodo, CPU, RAM, NVMe local |
| Red | InfiniBand, RoCE, EFA, NVLink/NVSwitch, garantía de colocación, sobreasignación, evidencia de prueba NCCL |
| Almacenamiento | Scratch local, sistema de archivos compartido, región de almacenamiento de objetos, rendimiento de checkpoints, precios de snapshots |
| Programador | Kubernetes, Slurm, Ray, servicio gestionado, acceso de usuario, cuota, apagado por inactividad |
| Fiabilidad | Política de reemplazo de nodos, ventanas de mantenimiento, escalado de incidentes, SLA, política de reintento |
| Seguridad | Aislamiento de inquilinos, registros de auditoría, gestión de secretos, red privada, eliminación de datos |
| Controles de costos | Etiquetas por equipo, exportaciones de uso, alertas de presupuesto, detección de inactividad, chargeback |
| Contrato | Plazo mínimo, gasto mínimo, opciones de ráfaga, ruta de actualización, cancelación, alcance del soporte |
Ejecuta al menos una prueba de aceptación antes de que el contrato sea difícil de rescindir:
prueba de aceptación del clúster =
  desplegar contenedor de producción
  descargar pesos del modelo y conjunto de datos
  ejecutar un benchmark representativo
  ejecutar all-reduce de NCCL si es multinodo
  escribir y restaurar checkpoint
  simular un trabajo fallido
  exportar registros de costos y utilización
Si un proveedor no puede soportar un benchmark representativo, considera eso un riesgo de compra.
Replicate vs Together AI vs alternativas a RunPod
La consulta replicate vs together ai vs runpod alternatives mezcla tres categorías, así que compáralas por nivel de abstracción.
| Tipo de plataforma | Tú gestionas | El proveedor gestiona | Mejor ajuste |
|---|---|---|---|
| Nube de GPU al estilo RunPod | Contenedores, imágenes, almacenamiento, ciclo de vida de GPU, stack de serving | Infraestructura de GPU y primitivas de plataforma | Desarrolladores que necesitan control directo de la GPU |
| Implementación de modelos al estilo Replicate | Empaquetado del modelo y uso de la API | Una gran parte de la infraestructura de serving y la ergonomía de despliegue orientada al usuario | Equipos de producto que lanzan endpoints de modelo rápidamente |
| Plataforma de inferencia al estilo Together AI | Selección de modelo, elección de endpoint, diseño de carga de trabajo | Infraestructura de serving de LLM y operaciones de endpoints | Equipos centrados en inferencia/ajuste fino de LLM |
| Enrutador de modelos al estilo Flatkey | Llamadas a la API, presupuestos, política de enrutamiento de modelos | Capa de acceso multmodelo, facturación unificada, libro mayor de uso | Equipos que necesitan salidas oficiales de modelos, no propiedad de GPU |
No elijas la línea más barata. Elige el menor riesgo operativo para el trabajo.
Hoja de comparación de alternativas a RunPod
Usa esta hoja cuando compares proveedores de nube de GPU.
| Campo | Proveedor A | Proveedor B | Proveedor C |
|---|---|---|---|
| Modo de producto | Pod / VM / serverless / clúster reservado / API | ||
| Modelo y memoria de GPU | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| Región o host | |||
| Unidad de facturación | segundo, minuto, hora, mensual, bloque de capacidad | ||
| Compromiso mínimo | ninguno, mensual, anual, bloque reservado | ||
| Costo de almacenamiento | volúmenes, snapshots, almacenamiento de objetos, NVMe local | ||
| Costo de red | egress, enlace privado, entre regiones, IP pública | ||
| Coste de arranque | descarga de imagen, descarga de pesos, arranque en frío | ||
| Tasa de inactividad | minutos facturables sin trabajo útil | ||
| Multiplicador de fallos/reintentos | expulsiones, OOM, hosts defectuosos, fallos de arranque en frío | ||
| Soporte | autoservicio, ticket, soporte dedicado, SLA | ||
| Seguridad | aislamiento de inquilinos, registros de auditoría, secretos, eliminación | ||
| Unidad de salida aceptada | 1M tokens, imagen, video, ajuste fino, ejecución de entrenamiento | ||
| Costo efectivo por salida aceptada | calculado, no estimado |
Luego calcula:
costo horario efectivo =
  costo horario de la GPU
  + almacenamiento por hora
  + red por hora
  + soporte por hora
  + desperdicio por inactividad
  + desperdicio por reintentos
  + sobrecarga de ingeniería

costo por salida aceptada =
  costo horario efectivo / salidas aceptadas por hora
Así también decides si la capacidad dedicada supera a las API. Si el costo de la API por salida aceptada es menor después de incluir las operaciones de GPU, no alquiles el clúster solo porque la tarifa horaria de la GPU parezca atractiva.
Lista de verificación de fuentes para precios actuales
Los precios y la disponibilidad de GPU cambian con frecuencia. Antes de tomar una decisión de compra, vuelva a comprobar las filas de origen y registre la fecha. Para este borrador, la lista de verificación de fuentes se verificó para la disponibilidad de la página el 12 de octubre de 2026.
| Proveedor/categoría | Punto de control de la fuente | Qué capturar |
|---|---|---|
| RunPod | Precios de RunPod, Documentación de almacenamiento de pods de RunPod | Modo pod, modo serverless, capacidad segura/comunitaria, almacenamiento, volumen de red, supuestos de inactividad |
| Lambda | Lambda GPU Cloud | Modelo de GPU, forma de instancia, disponibilidad, términos reservados o de clúster |
| Vast.ai | Precios de Vast.ai | Host, fiabilidad, GPU, almacenamiento, ancho de banda, términos del marketplace |
| Massed Compute | Precios de Massed Compute | Tarifas bajo demanda, ruta de reserva, soporte y términos de clúster |
| Hyperstack | Precios de GPU de Hyperstack | SKU de GPU, región, almacenamiento, red, soporte |
| TensorDock | Nube de GPU de TensorDock | Host del marketplace, GPU, RAM/vCPU, almacenamiento, precios en el momento del despliegue |
| Replicate | Precios de Replicate | Precios de despliegue, hardware, arranques en frío, registros, política de datos |
| Together AI | Precios de Together AI | Serverless, endpoints dedicados, fine-tuning, economía de lotes |
| AWS | Instancias EC2 P5, Bloques de capacidad de EC2 | Región, cuota, familia de instancias, ventana de reserva, EBS, transferencia de datos, soporte |
| Google Cloud | Máquinas optimizadas para aceleradores, Precios de GPU | Familia de máquinas, precio de GPU, disco, red, descuentos por uso comprometido |
| Azure | Serie ND H100 v5 | Tamaño de VM, región, cuota, InfiniBand, soporte, almacenamiento |
Recomendación final
Haga una lista corta de alternativas a RunPod según el modelo operativo:
- Use marketplaces como Vast.ai o TensorDock para experimentos flexibles, lotes de ComfyUI y cargas de trabajo tolerantes a reintentos.
- Use nubes de GPU especializadas como Lambda, CoreWeave, Crusoe, Massed Compute, Nebius, Hyperstack o Vultr cuando necesite capacidad de GPU y soporte más predecibles.
- Use hiperescaladores cuando la identidad empresarial, las compras, el cumplimiento y la gravedad de los datos en la nube existente importen más que la simplicidad.
- Use plataformas de inferencia gestionadas como Replicate o Together AI cuando el comportamiento del endpoint importe más que el control de la VM.
- Use Flatkey u otro enrutador de API de modelos cuando necesite salidas oficiales de modelos de IA, visibilidad del uso, fallback y facturación unificada en lugar de propiedad directa de la GPU.
Las mejores alternativas a RunPod son las que reducen el costo del trabajo aceptado. Si un proveedor le ofrece una hora de GPU más barata pero aumenta el tiempo de inactividad, la sobrecarga de arranque, los trabajos fallidos, el desperdicio de almacenamiento o la carga de ingeniería, en realidad no es más barato.
Preguntas frecuentes
¿Cuáles son algunas alternativas a RunPod?
Entre las alternativas comunes a RunPod se incluyen Lambda Cloud, CoreWeave, Crusoe Cloud, Massed Compute, Nebius AI Cloud, Hyperstack, Vultr Cloud GPU, Vast.ai, TensorDock, Replicate, Together AI, AWS, Google Cloud, Azure y enrutadores de API de modelos como Flatkey. La opción correcta depende de si necesita pods, endpoints serverless, clústeres dedicados, marketplaces o acceso a modelos a nivel de API.
¿Cuál es la mejor alternativa a RunPod para ComfyUI?
Para experimentos con ComfyUI, Vast.ai, TensorDock, Hyperstack, Lambda y las nubes de GPU al estilo Paperspace suelen estar en la lista corta. Compare almacenamiento persistente, caché de pesos de modelos, tiempo de arranque, gestión de nodos personalizados, apagado por inactividad, transferencia de salidas y fiabilidad del host antes de comparar las tarifas horarias de GPU.
¿Son más baratas las alternativas a RunPod?
A veces, pero solo después de calcular el costo efectivo por salida aceptada. Una tarifa horaria de GPU más baja puede perder si la carga de trabajo pasa más tiempo descargando modelos, inactiva, reintentando trabajos fallidos o moviendo datos. Compare imágenes, tokens, videos o trabajos completados, no solo horas de GPU.
¿Debería usar Replicate o Together AI en lugar de RunPod?
Use Replicate o Together AI cuando quiera endpoints de modelos gestionados y no necesite control de GPU de bajo nivel. Use nubes de GPU al estilo RunPod cuando necesite contenedores personalizados, flujos de trabajo personalizados, acceso directo a GPU o control sobre la pila de servicio.
¿Cuándo debo usar Flatkey en lugar de alquilar GPU?
Use Flatkey cuando tu equipo necesite APIs oficiales de modelos, enrutamiento multi-modelo, una sola clave, un solo saldo, libros contables de uso, fallback y controles de presupuesto. Alquila GPUs cuando pesos personalizados, kernels personalizados, colocación privada o una utilización alta y estable hagan que el control directo de la infraestructura valga el costo operativo.


