
Альтернативы RunPod обычно появляются в разговоре после первого успешного прототипа. Разработчик запускает workflow в ComfyUI, fine-tune, скрипт пакетного инференса или endpoint vLLM на RunPod; затем команда задаёт более сложный вопрос: может ли это стать production-мощностью с предсказуемой стоимостью, поддержкой, хранилищем, сетью, безопасностью и условиями закупки?
Ответ зависит от того, что именно вы заменяете. Pod RunPod, endpoint RunPod Serverless, secure GPU instance, community GPU и разговор о корпоративных мощностях — это разные модели закупки. Правильные альтернативы RunPod для уикенд-пакета в ComfyUI — не те же самые, что и для приватного кластера H100, многонодовой training-задачи или сервиса инференса, обращённого к клиентам.
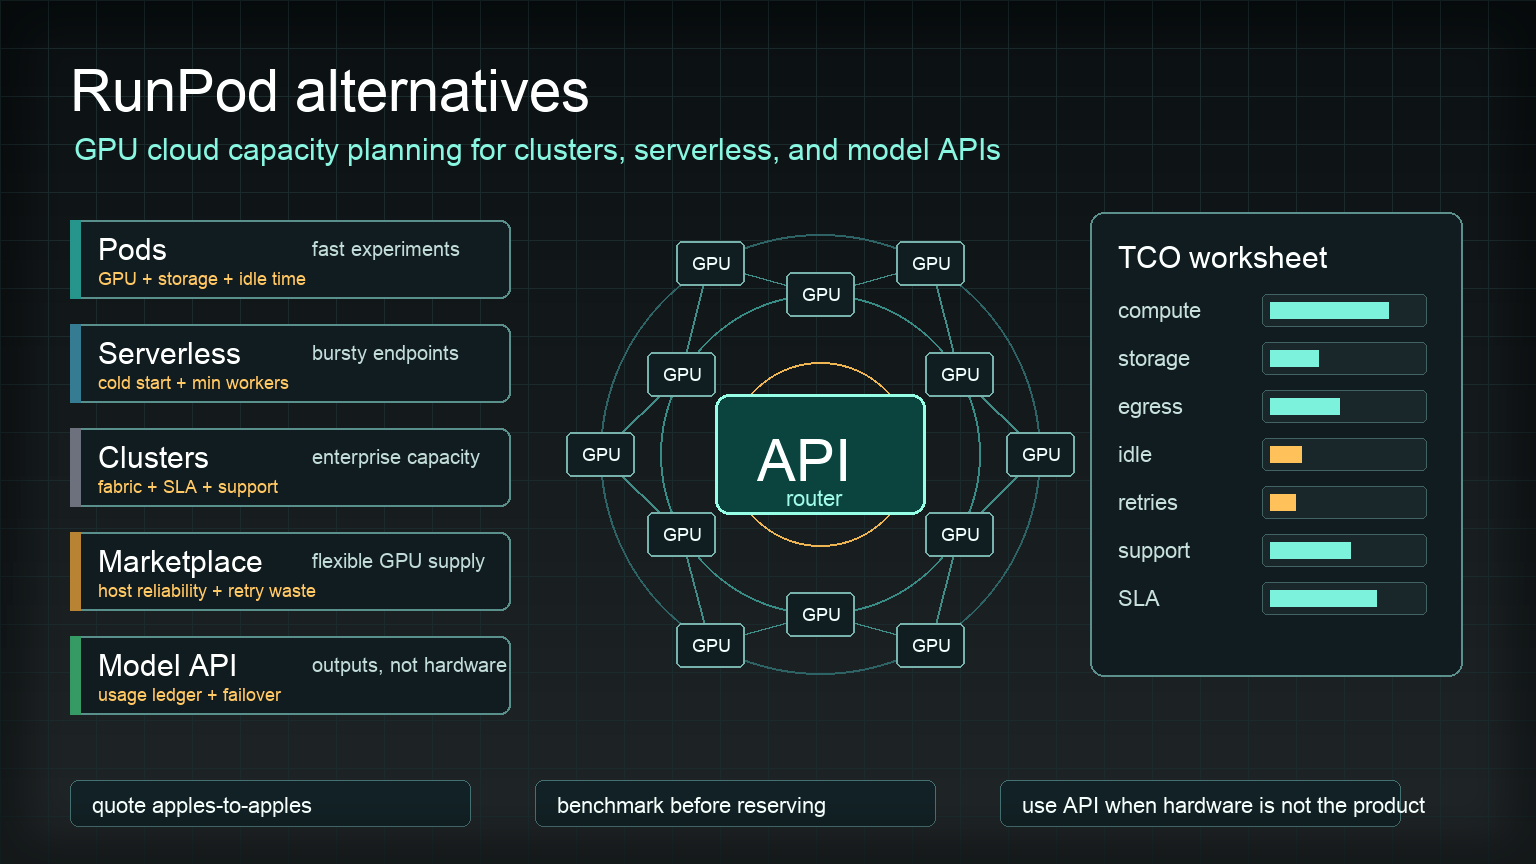
Это руководство сравнивает альтернативы RunPod для разработчиков и небольших и средних AI-команд, которым нужно больше, чем просто дешёвый час на GPU. Оно охватывает провайдеров GPU-облака, маркетплейсы, hyperscaler'ы, managed inference-платформы и маршруты через model API, а затем даёт вам worksheet для сравнения total cost of ownership вместо броских почасовых ставок. Если сначала вам нужен более широкий обзор ценовой модели, начните с руководства Flatkey по ценам аренды GPU.
Краткий ответ: лучшие альтернативы RunPod по типу нагрузки
Используйте эту таблицу, чтобы составить первичный шорт-лист. Рассматривайте её как карту решений, а не как универсальный рейтинг.
| Нагрузка | Сильные альтернативы RunPod для оценки | Почему они подходят | Что проверить перед переходом |
|---|---|---|---|
| Эксперименты в ComfyUI и пакетная обработка изображений | Vast.ai, TensorDock, Hyperstack, Paperspace/DigitalOcean, RunPod Community Cloud, если остаетесь на нём | Быстрый доступ к GPU, экономика маркетплейса или self-serve, хорошее соответствие гибкой пакетной работе | Постоянное хранилище, время запуска, надёжность хоста, пропускная способность, сценарий перезапуска, подходит ли GPU для production-данных |
| Стабильный односерверный инференс | Lambda Cloud, Hyperstack, Massed Compute, Nebius, Vultr, GPU VM в AWS/GCP/Azure | Более чистая модель инстансов, более широкие пути закупки, более предсказуемые инфраструктурные настройки | Доступность GPU, регион, поддержка, стоимость диска/сети, квота, наблюдаемость, autoscaling |
| Выделенные GPU-кластеры | Lambda reserved clusters, CoreWeave, Crusoe Cloud, Massed Compute, Nebius, AWS Capacity Blocks, reservations Google Cloud, Azure ND-series | Лучше подходят для зарезервированной мощности, поддержки, приватной сети и планирования многонодового кластера | Сетевой fabric, гарантия размещения, SLA поддержки, срок контракта, путь апгрейда, точка безубыточности по утилизации |
| Serverless endpoints для инференса | Replicate, Together AI dedicated endpoints, платформы в стиле Modal, cloud functions с поддержкой GPU, RunPod Serverless, если остаетесь на нём | Хорошо, когда вам важнее поведение развернутого инференса, чем прямой контроль над VM | Cold starts, минимальное число workers, цена за запрос, ограничения упаковки модели, логи, политика данных |
| Использование frontier-модели или multi-model API | Flatkey, роутеры в стиле OpenRouter, first-party model APIs | Позволяет избежать операций с GPU, когда ценность — в результате, а не в контроле над оборудованием | Доступность моделей, официальные endpoints, поведение fallback, журнал учёта использования, бюджетные ограничения, политика данных |
Для большинства команд лучшие альтернативы RunPod — это не один провайдер. Это разделённая архитектура:
- Используйте GPU из маркетплейса для экспериментов и всплесков пакетной обработки медиа.
- Используйте специализированное GPU-облако или hyperscaler для стабильной production-мощности.
- Используйте model API или router, когда продукту не нужен прямой контроль над весами, ядрами или размещением GPU.
Такое разделение не позволяет одной нагрузке навязать всем остальным неверную инфраструктурную модель.
Когда RunPod всё ещё хорошо подходит
Это не статья в духе «RunPod плохой». RunPod популярен, потому что сокращает время настройки. Разработчики могут запускать GPU pods, работать с notebooks и containers, экспериментировать с community- или secure-мощностями и использовать serverless endpoints, не начиная с процесса закупки у hyperscaler'а.
RunPod часто всё ещё хорошо подходит, когда:
- Вам нужен быстрый доступ к GPU для экспериментов.
- Вы тестируете ComfyUI, Stable Diffusion, LoRA-workflow или пакетную генерацию медиа.
- Вы хотите простую pod-ориентированную разработку перед проектированием production-кластера.
- Вы можете терпеть некоторую вариативность инфраструктуры, пока ещё исследуете варианты.
- Ваша нагрузка может быть перезапущена или пересобрана без серьёзного инцидента для клиента.
Переход обычно становится оправданным для оценки, когда нагрузка становится дорогой, постоянной, чувствительной к безопасности, чувствительной к задержке или заметной для закупок. В этот момент сравнивать альтернативы RunPod нужно по соответствию нагрузке, а не по узнаваемости бренда.
Фреймворк сравнения альтернатив RunPod
Начните с этой нормализованной формулы:
effective cost per accepted workload =
  compute
  + storage
  + snapshots
  + bandwidth and egress
  + idle time
  + cold starts
  + failed jobs and retries
  + support
  + engineering overhead
  / accepted tokens, jobs, images, videos, fine-tunes, or customer requests
Затем перед сравнением провайдеров задайте шесть вопросов.
| Вопрос | Почему это меняет ответ |
|---|---|
| Вам нужен контроль над GPU или только результаты ИИ? | Если вам нужны только сгенерированный текст, изображения, эмбеддинги или транскрипции, путь через API может быть дешевле в эксплуатации, чем аренда GPU. |
| Нагрузка интерактивная или пакетная? | Интерактивный инференс требует p95/p99 задержки и доступности. Пакетные задания могут обменивать время ожидания в очереди на более низкую стоимость. |
| Задача допускает прерывание? | Рыночные и spot-стиль мощности могут подойти для заданий с чекпоинтами; они могут быть опасны для длительных stateful-задач. |
| Помещается ли модель на один GPU? | Многo-GPU и multi-node нагрузки добавляют риски, связанные с топологией, сетью, планировщиком и размещением. |
| Предсказуема ли утилизация? | Резервируемая или выделенная мощность требует достаточного базового уровня использования, чтобы быть выгоднее on-demand. |
| Кто отвечает за операции? | Драйверы GPU, образы CUDA, vLLM/SGLang, очистка хранилища, наблюдаемость и реагирование на инциденты — часть реальной стоимости. |
Именно здесь многие сравнения альтернатив RunPod становятся поверхностными. Одного списка провайдеров недостаточно. Вам нужна модель закупок. Для multi-node мощностей сопоставьте эту статью с чек-листом аренды GPU-кластера.
Альтернативы RunPod в GPU-облаке
Lambda Cloud
Lambda Cloud — одна из самых понятных альтернатив RunPod, если вам нужен специализированный GPU-облако с опубликованными вариантами GPU-инстансов и более традиционной схемой закупки инфраструктуры. Его стоит рассмотреть для H100, H200, B200, A100 и других мощностей NVIDIA, когда ваша нагрузка переходит от экспериментов к воспроизводимому обучению или инференсу.
Используйте Lambda, если вам нужно:
- Простые GPU cloud-инстансы.
- Поставщик AI-инфраструктуры, а не широкий hyperscaler.
- Путь от on-demand экспериментов к резервируемой или законтрактованной мощности.
- Источник, который закупочный отдел сможет быстро понять.
Проверьте актуальную доступность инстансов, точную версию GPU, локальное хранилище, регион, поддержку и то, является ли предложение on-demand, reserved или cluster-oriented. Используйте официальную страницу Lambda GPU Cloud как контрольную точку по источнику, затем запросите коммерческое предложение, если вам нужна выделенная мощность. Для различий между семействами GPU см. руководство Flatkey по лучшим GPU для инференса LLM.
CoreWeave
CoreWeave — сильная альтернатива RunPod для команд, которые вышли за рамки одного pod и нуждаются в облачной GPU-мощности в масштабе. Он более актуален для production AI-нагрузок, выделенных сред и корпоративных закупок GPU, чем для разовых хобби-экспериментов.
Рассматривайте CoreWeave, если:
- Вам нужна production GPU-инфраструктура, а не простой dev pod.
- Вам важны Kubernetes-native операции, хранилище, сеть и поддержка.
- Вы планируете устойчивый инференс, обучение или AI media-мощности.
- Вам нужен разговор с провайдером о законтрактованной мощности и корпоративных условиях.
Компромисс в том, что CoreWeave обычно не является самым легковесным вариантом для маленького эксперимента. Он попадает в шорт-лист, когда планирование мощностей, поддержка и надежность production важнее, чем максимально быстрый запуск первого pod.
Crusoe Cloud
Crusoe Cloud стоит сравнить AI-командам, которым нужна выделенная или масштабируемая GPU-инфраструктура с корпоративными закупками и устойчивым позиционированием. Он часто входит в тот же шорт-лист, что и Lambda, CoreWeave, Nebius и Massed Compute, когда речь идет о мощностях.
Используйте Crusoe как альтернативу RunPod, когда:
- Вам нужна кластерная мощность, а не разовая аренда GPU.
- Вам нужно коммерческое предложение провайдера с условиями поддержки, региона и мощностей.
- Вам нужен разговор со специализированным облаком, а не процесс квотирования у hyperscaler.
Проверьте точную модель GPU, interconnect, хранилище, объем поддержки и нужно ли вашей нагрузке самостоятельно управляемый Kubernetes, Slurm или управляемая среда.
Massed Compute
Massed Compute — полезная точка сравнения для покупателей, которым нужны опубликованные цены на GPU плюс путь к резервируемой или выделенной мощности. Это практичная альтернатива RunPod для команд, которым нужна простая экономика GPU-облака, но которые уже начинают задавать корпоративные вопросы.
Оценивайте Massed Compute, если:
- Вам нужна мощность уровня H100/A100/L40S с понятной публичной отправной точкой.
- Вы хотите сравнить on-demand ставки на GPU с более долгосрочными обязательствами.
- Вы готовите закупочную таблицу для выделенного кластера или базового пула инференса.
Используйте официальную страницу ценообразования Massed Compute как живую строку источника, затем уточните, что входит в поддержку, сеть, хранилище и условия резервирования.
Nebius AI Cloud
Nebius — надежная альтернатива RunPod, когда покупателю нужен AI-native cloud с управляемыми инфраструктурными сервисами вокруг GPU, а не просто сырые серверы. Он особенно актуален, когда вашей команде нужна облачная платформа для обучения моделей, инференса, данных и оркестрации, а не изолированные инстансы.
Рассматривайте Nebius, если:
- Вам нужна более широкая AI cloud-среда.
- Вам важны Kubernetes, managed services, хранилище и сеть вокруг GPU-нагрузок.
- Вы хотите альтернативы за пределами стандартного списка US hyperscaler.
Для TCO подтвердите доступность по регионам, поддержку, сетевой egress, квоты, механику резервирования и доступность поколений GPU.
Hyperstack
Hyperstack — это прямая альтернатива RunPod для команд, которые сравнивают облачных GPU-провайдеров по типу инстанса, почасовой стоимости и self-service развёртыванию. Он полезен для быстрого доступа к экземплярам NVIDIA GPU без необходимости брать на себя крупную облачную платформу.
Используйте Hyperstack, если:
- Вам нужен простой облачный GPU-провайдер для экспериментов, инференса или пакетных задач.
- Вы сравниваете доступность GPU H100, H200, A100, L40S, RTX-класса или более новых моделей.
- Вам нужна публичная отправная точка по ценам до обращения в отдел продаж.
Используйте официальную страницу Hyperstack GPU pricing в качестве исходной контрольной точки. Тем не менее всё равно проверяйте хранилище, пропускную способность, ожидаемый uptime, поддержку и доступна ли именно ваша GPU/регион в момент запуска задачи.
Vultr Cloud GPU
Vultr стоит включить в список альтернатив RunPod, когда вашей команде нужен знакомый облачный провайдер с GPU-опциями, глобальными регионами и более простым пакетом инфраструктуры, чем у чистого GPU-маркетплейса. Он может быть привлекательным для команд, которые уже используют облачные VM и хотят GPU-мощности без перехода на новую операционную модель.
Оценивайте Vultr, если:
- Ваша нагрузка ближе к обычной VM, чем к сложному кластеру.
- Вам нужна глобальная облачная инфраструктура плюс GPU-ускорение.
- Вам нужен провайдер, который вписывается в существующие шаблоны облачной эксплуатации.
Проверьте квоту, семейство GPU, регион, постоянное хранилище, egress, поддержку и то, требует ли ваша нагрузка high-end interconnect, который простая GPU-VM не может обеспечить.
Маркетплейс-альтернативы RunPod
Vast.ai
Vast.ai — одна из самых распространённых альтернатив RunPod для разработчиков, которым нужна гибкая доступность GPU и низкий порог входа. Это маркетплейс, поэтому сравнение провайдеров — это не только Vast.ai против RunPod. Это каждый хост, GPU, локация, оценка надёжности, диск, сеть и профиль прерываний в сравнении с вашей нагрузкой.
Vast.ai часто хорошо подходит для:
- Экспериментов с ComfyUI.
- Пакетной генерации изображений.
- Краткосрочных исследовательских задач.
- Гибких тестов инференса.
- Нагрузок, которые могут делать checkpoint и повторять запуск.
Он менее подходит для нагрузок, которым нужна предсказуемая поддержка, соответствие требованиям комплаенса, частные сети или жёсткий customer-facing uptime. Используйте официальную страницу Vast.ai pricing как живую контрольную точку маркетплейса, но никогда не сравнивайте только почасовую ставку GPU.
TensorDock
TensorDock — ещё одна альтернатива RunPod в формате маркетплейса. Его официальная страница GPU cloud описывает маркетплейс независимых хостов, которые конкурируют и устанавливают цены, а значит покупателям следует оценивать каждый вариант развёртывания отдельно, а не воспринимать TensorDock как единое облако с фиксированными тарифами.
TensorDock может быть полезен, когда:
- Вам нужны гибкие варианты GPU VM.
- Вам нужны опции RTX-класса или дата-центровых GPU для краткосрочных проектов.
- Вы можете оценить детали хоста, хранилище, пропускную способность и надёжность до запуска.
Используйте официальную страницу TensorDock GPU cloud как исходную контрольную точку. Для production спросите, есть ли у выбранной мощности поддержка, изоляция и операционные гарантии, необходимые вашей клиентской нагрузке.
Альтернативы RunPod у гиперскейлеров
AWS, Google Cloud и Azure не всегда являются более дешёвыми альтернативами RunPod. Часто это более полнофункциональные с точки зрения эксплуатации альтернативы.
AWS
AWS актуален, когда нагрузке нужны корпоративная идентификация, сеть, соответствие требованиям, закупки и интеграция с существующими системами AWS. Для задач уровня H100 основным ориентиром являются инстансы AWS P5, а EC2 Capacity Blocks важны, когда вам нужна зарезервированная ML-мощность на определённое окно времени.
AWS может подойти, если:
- Вы уже запускаете системы данных, безопасности и развёртывания в AWS.
- Вам нужны корпоративные закупки и поддержка.
- Вам нужна определённая модель резервирования на период обучения или запуска.
- Вы можете справляться со сложностью облака и управлением квотами.
Проверьте AWS P5 instances и EC2 Capacity Blocks for ML, затем включите EBS, передачу данных, поддержку, NAT, наблюдаемость и инженерное время в TCO. Если решение конкретно касается старой и новой NVIDIA-мощности, используйте сравнения H100 vs A100 и H200 vs H100 как дополнительные материалы.
Google Cloud
Google Cloud — это альтернатива RunPod, когда вашей команде нужны оптимизированные под ускорители семейства машин, корпоративные механизмы контроля и облачно-нативная среда вокруг данных, сети и Kubernetes. Это особенно актуально для организаций, уже использующих инфраструктуру данных Google Cloud.
Используйте Google Cloud, если:
- Вашей нагрузке нужна облачная локальность данных с BigQuery, GCS, GKE или Vertex AI.
- Вам нужны корпоративные механизмы идентификации, аудита и закупок.
- Вы можете планировать с учётом квот, регионов, дисков и цен на сеть.
Используйте документацию Google Cloud по accelerator-optimized machine и Compute Engine GPU pricing как исходные контрольные точки. Приведите к единому виду допущения по GPU, машине, диску, сети и committed-use, прежде чем сравнивать с специализированными GPU-облаками.
Azure
Azure — практичная альтернатива RunPod для предприятий, которые уже стандартизированы на облачных сервисах Microsoft, идентификации, безопасности, закупках или системах данных. Серия Azure ND H100 v5 — ключевая отправная точка для рабочих нагрузок в стиле H100-кластера.
Используйте Azure, когда:
- Ваша компания уже закупает через соглашения Microsoft.
- Вам нужны корпоративные безопасность, соответствие требованиям и сетевые ограничения.
- Вам нужны GPU VM, связанные с более широкой инфраструктурой данных или приложений Azure.
Проверьте серии Azure ND H100 v5, затем уточните доступность в регионе, квоты, требования InfiniBand, хранилище, поддержку и сложность развертывания.
Serverless и альтернативы управляемого инференса
Не каждая альтернатива RunPod должна быть арендованным GPU. Если вашей команде нужен endpoint, а не машина, управляемый инференс может убрать значительную часть операционной работы.
Replicate
Replicate хорошо подходит, когда команде нужно запускать модели через API, разворачивать версии моделей и не управлять GPU-хостами напрямую. Это особенно полезно для продуктовых команд, которым важно быстро выпускать функции на основе моделей.
Replicate может подойти для:
- Инференса для изображений, видео, аудио и open-source моделей.
- Прототипов продуктов, которым быстро нужен API.
- Команд, которые предпочитают удобство развертывания, а не низкоуровневый контроль GPU.
Используйте цены Replicate как актуальную отправную точку, затем проверьте варианты оборудования, поведение развертывания, cold start, логи, обработку данных и необходимость в пользовательских ядрах или частной сети.
Together AI
Together AI — альтернатива RunPod, когда нагрузка ближе к инференсу и fine-tuning LLM, чем к общей аренде GPU VM. Это решение стоит рассматривать командам, которым нужны управляемый инференс, выделенные endpoints и инфраструктура для обслуживания моделей без эксплуатации всего стека.
Together AI может подойти для:
- LLM inference endpoints.
- Рабочих процессов fine-tuning и оценки.
- Команд, которым нужна инфраструктура для обслуживания моделей, а не управление «сырыми» pod'ами.
Используйте цены Together AI как актуальную проверку стоимости и уточните, относится ли ваша нагрузка к serverless-инференсу, выделенным endpoints, batch API или индивидуальному корпоративному соглашению. Если вы будете размещать решение самостоятельно, отдельно сравните стеки обслуживания с помощью vLLM vs SGLang.
Альтернативы Model API и router
Самые недооцененные альтернативы RunPod — это Model API и routers. Если вашему продукту не нужны пользовательские веса, собственные CUDA-ядра, частное размещение GPU или низкоуровневый контроль обслуживания, аренда GPU может быть неверной абстракцией.
Позиционирование Flatkey полезно для этого решения: один ключ, один баланс, один счет, маршрутизация, совместимая с OpenAI, официальные endpoints моделей, журналы использования, контроль бюджета и fallback-пути для множества моделей и инструментов. Это не заменяет выделенный GPU-кластер, когда вам нужно владеть стеком обслуживания. Но это заменяет кластер, когда вам нужен надежный AI-результат с отслеживаемыми затратами. Для бюджетирования на стороне моделей сравните таблицу по GPU с сравнением цен на AI-модели и управлением расходами на AI API.
Используйте Model API или router, когда:
- Вам нужен доступ к множеству текстовых, графических или видеомоделей.
- Трафик скачкообразный и не оправдывает резервирование GPU.
- Выбор модели часто меняется.
- Вам не нужно управлять весами, драйверами, CUDA или serving kernels.
- Важнее видимость затрат, fallback и консолидация биллинга, чем прямой контроль GPU.
Используйте выделенные GPU, когда:
- Вы обслуживаете приватные или пользовательские веса.
- Вам нужны пользовательские ядра, квантизация, адаптеры или логика обслуживания.
- Требования к размещению данных или изоляции требуют вашей собственной среды.
- Объем инференса достаточно стабилен, чтобы оправдать зафиксированную мощность.
- У вас есть персонал для эксплуатации GPU.
Это и есть основной вопрос закупок: вы покупаете доступ к оборудованию или приемлемые результаты?
Альтернативы RunPod для ComfyUI
Поиски по запросу runpod alternatives comfyui обычно вызваны практической проблемой: рабочий процесс работает, но хранилище, время запуска, версии образов и повторяемость начинают раздражать.
Для ComfyUI сравните следующие варианты:
| Вариант | Лучший сценарий | На что обратить внимание |
|---|---|---|
| RunPod pods | Знакомый путь, если у вас уже есть шаблоны и volumes | Очистка persistent volume, стоимость простоя, расхождение образов |
| Vast.ai или TensorDock | Гибкое предложение GPU для пакетных image-задач | Надежность хоста, хранилище, пропускная способность, перезапуски |
| Hyperstack или Lambda | Более привычная модель облачного GPU-инстанса | Доступность, почасовая стоимость, ответственность за настройку |
| Replicate-style APIs | Функции продукта, которым нужны image-результаты через API | Меньше низкоуровневого контроля рабочего процесса |
| Flatkey/model API route | Эксперименты с image/video-моделями от нескольких провайдеров | Не замена для пользовательских графов ComfyUI, которым нужен прямой контроль узлов |
Для ComfyUI не сравнивайте только модель GPU и почасовую ставку. Также измеряйте:
- Время на загрузку образов и весов модели.
- Стоимость постоянного хранилища.
- Сохраняются ли пользовательские узлы после пересборок.
- Время простоя после завершения пакета задач.
- Стоимость передачи выходных данных.
- Частота сбоев из-за отсутствующих моделей, плохих образов или перезапусков хоста.
- Нужен ли рабочему процессу UI, API-эндпоинт или автоматизированная очередь.
Лучшие альтернативы RunPod для ComfyUI обычно те, которые сокращают время пересборки и заброшенное хранилище, а не те, у которых самая низкая видимая почасовая ставка GPU.
Чек-лист для выделенного GPU-кластера
Если причина перехода — корпоративные мощности, используйте этот чек-лист до подписания term sheet.
| Требование | Что спрашивать у каждого провайдера |
|---|---|
| Конфигурация GPU | Точная модель GPU, память, PCIe/SXM/NVL, GPU на узел, CPU, RAM, локальный NVMe |
| Сеть | InfiniBand, RoCE, EFA, NVLink/NVSwitch, гарантия размещения, оверсабскрипция, подтверждение теста NCCL |
| Хранилище | Локальный scratch, общая файловая система, регион объектного хранилища, пропускная способность контрольных точек, цены на снимки |
| Планировщик | Kubernetes, Slurm, Ray, управляемый сервис, доступ пользователей, квота, отключение при простое |
| Надежность | Политика замены узлов, окна обслуживания, эскалация инцидентов, SLA, политика повторных попыток |
| Безопасность | Изоляция арендаторов, журналы аудита, работа с секретами, частная сеть, удаление данных |
| Контроль затрат | Теги по командам, экспорт использования, оповещения о бюджете, обнаружение простоя, распределение затрат |
| Контракт | Минимальный срок, минимальные обязательства по расходам, варианты всплеска нагрузки, путь обновления, отмена, объем поддержки |
Проведите как минимум один приемочный тест до того, как контракт станет трудно расторгнуть:
cluster acceptance test =
  deploy production container
  pull model weights and dataset
  run representative benchmark
  run NCCL all-reduce if multi-node
  write and restore checkpoint
  simulate one failed job
  export cost and utilization logs
Если провайдер не может поддержать репрезентативный бенчмарк, считайте это риском при покупке.
Replicate vs Together AI vs RunPod alternatives
Запрос replicate vs together ai vs runpod alternatives смешивает три категории, поэтому сравнивайте их по уровню абстракции.
| Тип платформы | Что вы управляете | Что управляет провайдер | Лучший сценарий |
|---|---|---|---|
| GPU-облако в стиле RunPod | Контейнеры, образы, хранилище, жизненный цикл GPU, стек обслуживания | GPU-инфраструктура и платформенные примитивы | Разработчики, которым нужен прямой контроль над GPU |
| Развертывание моделей в стиле Replicate | Упаковка модели и использование API | Значительную часть инфраструктуры обслуживания и удобства развертывания для пользователей | Продуктовые команды, быстро публикующие модельные endpoints |
| Платформа инференса в стиле Together AI | Выбор модели, выбор endpoint, проектирование рабочей нагрузки | Инфраструктура обслуживания LLM и операции с endpoint | Команды, сфокусированные на инференсе/дообучении LLM |
| Маршрутизатор моделей в стиле Flatkey | API-вызовы, бюджеты, политика маршрутизации моделей | Слой доступа к нескольким моделям, унифицированный биллинг, журнал использования | Команды, которым нужны официальные результаты моделей, а не владение GPU |
Не выбирайте самый дешевый пункт. Выбирайте наименьший операционный риск для задачи.
Сравнительная таблица альтернатив RunPod
Используйте эту таблицу при сравнении провайдеров GPU-облака.
| Поле | Провайдер A | Провайдер B | Провайдер C |
|---|---|---|---|
| Режим продукта | Pod / VM / serverless / зарезервированный кластер / API | ||
| Модель GPU и память | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| Регион или хост | |||
| Единица биллинга | секунда, минута, час, месяц, блок мощности | ||
| Минимальное обязательство | нет, месячное, годовое, зарезервированный блок | ||
| Стоимость хранения | volumes, snapshots, object storage, local NVMe | ||
| Стоимость сети | egress, private link, cross-region, public IP | ||
| Накладные расходы на запуск | загрузка образа, скачивание весов, холодный старт | ||
| Коэффициент простоя | оплачиваемые минуты без полезной работы | ||
| Множитель отказов/повторов | эвикции, OOM, плохие хосты, сбои холодного старта | ||
| Поддержка | self-serve, тикет, выделенная поддержка, SLA | ||
| Безопасность | изоляция арендаторов, журналы аудита, секреты, удаление | ||
| Принятая единица результата | 1 млн токенов, изображение, видео, fine-tune, training run | ||
| Эффективная стоимость за принятый результат | рассчитанная, а не угаданная |
Затем рассчитайте:
effective hourly cost =
  GPU hourly cost
  + storage per hour
  + network per hour
  + support per hour
  + idle waste
  + retry waste
  + engineering overhead

cost per accepted output =
  effective hourly cost / accepted outputs per hour
Так же вы решаете, превосходит ли выделенная мощность API. Если стоимость API за принятый результат ниже после учета операций с GPU, не арендуйте кластер только потому, что почасовая ставка GPU выглядит привлекательно.
Контрольный список источников для актуальных цен
Цены и доступность GPU часто меняются. Перед принятием решения о покупке повторно проверьте исходные строки и зафиксируйте дату. Для этого черновика контрольный список источников был проверен на доступность страниц 12 октября 2026 года.
| Поставщик/категория | Контрольная точка источника | Что зафиксировать |
|---|---|---|
| RunPod | Тарифы RunPod, Документация RunPod по хранилищу pods | Режим pod, serverless-режим, защищённые/общественные мощности, хранилище, сетевой том, допущения по простоям |
| Lambda | Lambda GPU Cloud | Модель GPU, конфигурация инстанса, доступность, условия резервации или кластера |
| Vast.ai | Тарифы Vast.ai | Хост, надёжность, GPU, хранилище, пропускная способность, условия маркетплейса |
| Massed Compute | Тарифы Massed Compute | Ставки по модели on-demand, путь резервирования, поддержка и условия кластера |
| Hyperstack | Тарифы Hyperstack на GPU | SKU GPU, регион, хранилище, сеть, поддержка |
| TensorDock | GPU cloud TensorDock | Хост маркетплейса, GPU, RAM/vCPU, хранилище, цена на момент развёртывания |
| Replicate | Тарифы Replicate | Стоимость развёртывания, аппаратное обеспечение, cold starts, логи, политика данных |
| Together AI | Тарифы Together AI | Serverless, выделенные endpoints, fine-tuning, экономика batch-обработки |
| AWS | Инстансы EC2 P5, EC2 Capacity Blocks | Регион, квота, семейство инстансов, окно резервации, EBS, передача данных, поддержка |
| Google Cloud | Машины, оптимизированные под ускорители, Цены на GPU | Семейство машин, цена GPU, диск, сеть, скидки за committed use |
| Azure | Серия ND H100 v5 | Размер VM, регион, квота, InfiniBand, поддержка, хранилище |
Итоговая рекомендация
Составляйте короткий список альтернатив RunPod по операционной модели:
- Используйте маркетплейсы, такие как Vast.ai или TensorDock, для гибких экспериментов, пакетных задач ComfyUI и рабочих нагрузок, устойчивых к повторным попыткам.
- Используйте специализированные GPU-облака, такие как Lambda, CoreWeave, Crusoe, Massed Compute, Nebius, Hyperstack или Vultr, когда вам нужны более предсказуемые GPU-мощности и поддержка.
- Используйте гиперскейлеры, когда корпоративная идентификация, закупки, соответствие требованиям и уже существующая «гравитация» облачных данных важнее простоты.
- Используйте управляемые платформы inference, такие как Replicate или Together AI, когда поведение endpoint важнее контроля над VM.
- Используйте Flatkey или другой маршрутизатор API моделей, когда вам нужны официальные выводы AI-моделей, видимость использования, fallback и единый биллинг, а не прямое владение GPU.
Лучшие альтернативы RunPod — это те, которые снижают стоимость принятой работы. Если провайдер предлагает более дешёвый час GPU, но увеличивает простой, накладные расходы на запуск, число неудачных заданий, потери на хранилище или инженерную нагрузку, то в реальности он не дешевле.
Часто задаваемые вопросы
Какие есть альтернативы RunPod?
К распространённым альтернативам RunPod относятся Lambda Cloud, CoreWeave, Crusoe Cloud, Massed Compute, Nebius AI Cloud, Hyperstack, Vultr Cloud GPU, Vast.ai, TensorDock, Replicate, Together AI, AWS, Google Cloud, Azure, а также маршрутизаторы API моделей, такие как Flatkey. Правильный выбор зависит от того, нужны ли вам pods, serverless-endpoints, выделенные кластеры, маркетплейсы или доступ к моделям на уровне API.
Какая лучшая альтернатива RunPod для ComfyUI?
Для экспериментов с ComfyUI в короткий список часто включают Vast.ai, TensorDock, Hyperstack, Lambda и GPU-облака в стиле Paperspace. Перед сравнением почасовых ставок GPU сравните постоянное хранилище, кэширование весов моделей, время запуска, управление пользовательскими нодами, автоматическое отключение в простое, передачу результатов и надёжность хоста.
Альтернативы RunPod дешевле?
Иногда да, но только после расчёта эффективной стоимости на один принятый результат. Более низкая почасовая ставка GPU может оказаться проигрышной, если рабочая нагрузка больше времени тратит на загрузку моделей, простои, повторные попытки неудачных заданий или передачу данных. Сравнивайте завершённые изображения, токены, видео или задания, а не только часы GPU.
Стоит ли использовать Replicate или Together AI вместо RunPod?
Используйте Replicate или Together AI, когда вам нужны управляемые endpoints моделей и не нужен низкоуровневый контроль над GPU. Используйте облака GPU в стиле RunPod, когда нужны собственные контейнеры, собственные рабочие процессы, прямой доступ к GPU или контроль над стеком обслуживания.
Когда следует использовать Flatkey вместо аренды GPU?
Используйте Flatkey, когда вашей команде нужны официальные API моделей, маршрутизация между несколькими моделями, один ключ, один баланс, журналы использования, резервный переход и контроль бюджета. Арендуйте GPU, когда пользовательские веса, пользовательские ядра, частное размещение или стабильная высокая загрузка делают прямой контроль над инфраструктурой оправданным с точки зрения операционных затрат.


