
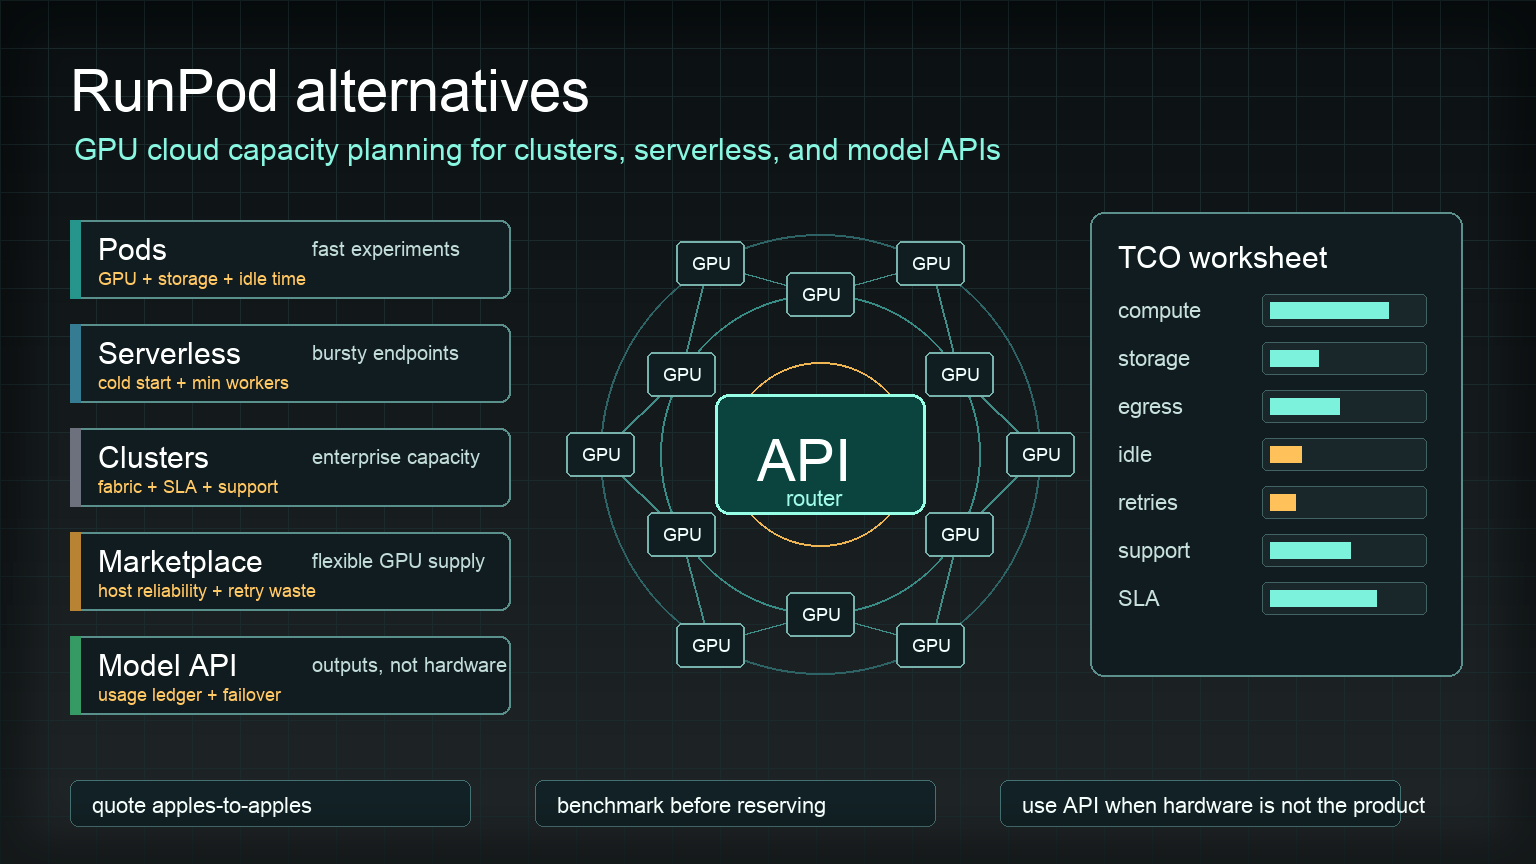
RunPodの代替案は、たいてい最初の成功したプロトタイプの後に検討され始めます。開発者がRunPod上でComfyUIのワークフロー、ファインチューニング、バッチ推論スクリプト、またはvLLMエンドポイントを動かし、その後チームがより難しい問いを投げかけます。つまり、これを予測可能なコスト、サポート、ストレージ、ネットワーク、セキュリティ、調達条件を備えた本番キャパシティにできるのか、ということです。
答えは、何を置き換えるのかによって変わります。RunPod pod、RunPod Serverlessエンドポイント、セキュアGPUインスタンス、コミュニティGPU、そしてエンタープライズキャパシティの話は、それぞれ異なる購買行動です。週末のComfyUIバッチに適したRunPod代替案は、プライベートなH100クラスター、マルチノードの学習ジョブ、または顧客向け推論サービスに適した代替案とは同じではありません。
このガイドでは、安価なGPU時間以上を必要とする開発者や中小規模のAIチーム向けにRunPodの代替案を比較します。GPUクラウドプロバイダー、マーケットプレイス、ハイパースケーラー、マネージド推論プラットフォーム、モデルAPIの選択肢を取り上げ、見出しの時間単価ではなく総所有コストを比較するためのワークシートも示します。まず広い料金モデルが必要な場合は、FlatkeyのGPUレンタル価格ガイドから始めてください。
簡単な答え: ワークロード別の最適なRunPod代替案
最初の候補リストを作るために、この表を使ってください。これは普遍的なランキングではなく、判断用の地図として扱ってください。
| ワークロード | 評価すべき有力なRunPod代替案 | 適している理由 | 切り替え前に確認すべきこと |
|---|---|---|---|
| ComfyUIの実験と画像バッチ | Vast.ai、TensorDock、Hyperstack、Paperspace/DigitalOcean、継続するならRunPod Community Cloud | 高速なGPUアクセス、マーケットプレイスまたはセルフサービスの経済性、柔軟なバッチ作業に適合 | 永続ストレージ、起動時間、ホストの信頼性、帯域幅、再起動ワークフロー、GPUが本番データに適しているか |
| 安定した単一ノード推論 | Lambda Cloud、Hyperstack、Massed Compute、Nebius、Vultr、AWS/GCP/AzureのGPU VM | より明確なインスタンスモデル、幅広い調達経路、より予測しやすいインフラ制御 | GPUの空き状況、リージョン、サポート、ディスク/ネットワークコスト、クォータ、可観測性、自動スケーリング |
| 専用GPUクラスター | Lambdaの予約クラスター、CoreWeave、Crusoe Cloud、Massed Compute、Nebius、AWS Capacity Blocks、Google Cloud reservations、Azure NDシリーズ | コミットしたキャパシティ、サポート、プライベートネットワーキング、マルチノードクラスター計画により適合 | ネットワークファブリック、配置保証、サポートSLA、契約期間、アップグレードパス、利用率の損益分岐点 |
| サーバーレス推論エンドポイント | Replicate、Together AIの専用エンドポイント、Modal風プラットフォーム、GPU対応クラウド関数、継続するならRunPod Serverless | 生のVM制御よりも、デプロイ済み推論の動作が重要な場合に適している | コールドスタート、最小ワーカー数、リクエスト単位の料金、モデルパッケージの制限、ログ、データポリシー |
| フロンティアモデルまたはマルチモデルAPIの利用 | Flatkey、OpenRouter風ルーター、ファーストパーティのモデルAPI | 価値がハードウェア制御ではなく出力にある場合、GPU運用を回避できる | モデルの可用性、公式エンドポイント、フォールバック動作、利用台帳、予算管理、データポリシー |
多くのチームにとって、最良のRunPod代替案は1社ではありません。分割アーキテクチャです:
- 実験や突発的なメディアバッチにはマーケットプレイスGPUを使う。
- 安定した本番キャパシティには、専門GPUクラウドまたはハイパースケーラーを使う。
- 重み、カーネル、GPU配置を直接制御する必要が製品にない場合は、モデルAPI/ルーターを使う。
この分割により、1つのワークロードが他のすべてのワークロードに誤ったインフラモデルを押し付けることを防げます。
RunPodが今でも適している場合
これは「RunPodはダメだ」という記事ではありません。RunPodが人気なのは、セットアップ時間を圧縮できるからです。開発者はGPU podを起動し、ノートブックやコンテナを実行し、コミュニティまたはセキュアなキャパシティで試し、ハイパースケーラーの調達プロセスを始めなくてもサーバーレスエンドポイントを使えます。
RunPodが今でも適していることが多いのは、次のような場合です:
- 実験のために高速なGPUアクセスが必要。
- ComfyUI、Stable Diffusion、LoRAワークフロー、またはバッチメディア生成を試している。
- 本番クラスターを設計する前に、シンプルなpodベースの開発をしたい。
- 探索段階のあいだ、ある程度のインフラのばらつきを許容できる。
- 顧客インシデントを起こさずに再起動または再構築できるワークロードである。
切り替えを検討する価値が出てくるのは、通常、ワークロードが高価になった、常時稼働になった、セキュリティ要件が厳しい、レイテンシが重要、または調達上見える形になったときです。その段階では、ブランドのなじみではなく、ワークロード適合性でRunPodの代替案を比較すべきです。
RunPod代替案の比較フレームワーク
まず、この正規化された式から始めてください:
accepted workloadあたりの実効コスト =
  compute
  + storage
  + snapshots
  + bandwidth and egress
  + idle time
  + cold starts
  + failed jobs and retries
  + support
  + engineering overhead
  / accepted tokens, jobs, images, videos, fine-tunes, or customer requests
次に、プロバイダーを比較する前に6つの質問をしてください。
| 質問 | それが答えを変える理由 |
|---|---|
| GPUの制御が必要ですか、それともAI出力だけで十分ですか? | 生成テキスト、画像、埋め込み、文字起こしだけが必要な場合は、API経由のほうがGPUを借りるより運用コストが安くなることがあります。 |
| ワークロードは対話型ですか、それともバッチですか? | 対話型推論ではp95/p99のレイテンシと可用性が必要です。バッチジョブなら、待ち時間を許容する代わりにコストを下げられます。 |
| ジョブは中断可能ですか? | マーケットプレイス型やスポット型のキャパシティは、チェックポイント対応のジョブには有効ですが、長時間のステートフルなジョブには危険です。 |
| モデルは1台のGPUに収まりますか? | マルチGPUおよびマルチノードのワークロードでは、トポロジー、ネットワーク、スケジューラ、配置のリスクが増えます。 |
| 利用率は予測可能ですか? | 予約済みまたは専有キャパシティは、オンデマンドを上回るために十分なベースライン利用率が必要です。 |
| 運用責任者は誰ですか? | GPUドライバ、CUDAイメージ、vLLM/SGLang、ストレージのクリーンアップ、可観測性、インシデント対応は、実際のコストの一部です。 |
ここで、多くのRunPod代替案比較は表面的になりがちです。プロバイダーの一覧だけでは不十分です。調達モデルが必要です。マルチノード容量については、この記事をGPUクラスターのレンタルチェックリストと組み合わせてください。
RunPodのGPUクラウド代替案
Lambda Cloud
Lambda Cloudは、公開されたGPUインスタンスのオプションと、より従来型のインフラ調達の流れを備えた専門GPUクラウドを求める場合、最も分かりやすいRunPod代替案の1つです。実験段階から、再現可能なトレーニングや推論へ移行するH100、H200、B200、A100、その他のNVIDIAキャパシティの評価に値します。
以下のような場合にLambdaを使います。
- 分かりやすいGPUクラウドインスタンスが必要。
- 広範なハイパースケーラーではなく、専門のAIインフラプロバイダーが必要。
- オンデマンドの実験から予約済みまたはコミット済みキャパシティへ移行したい。
- 調達担当がすぐ理解できるソース行が必要。
現在のインスタンス可用性、正確なGPUバリアント、ローカルストレージ、リージョン、サポート、および見積もりがオンデマンド、予約済み、またはクラスター指向のいずれかを確認してください。専有キャパシティが必要な場合は、公式のLambda GPU Cloudページをソース確認点として使い、その後見積もりを依頼してください。GPUファミリーのトレードオフについては、FlatkeyのLLM推論に最適なGPUガイドを参照してください。
CoreWeave
CoreWeaveは、単一のポッドを超えて拡大し、スケールしたクラウドGPUキャパシティが必要なチームにとって強力なRunPod代替案です。単発の趣味的な実験よりも、本番のAIワークロード、専用環境、エンタープライズ向けGPU調達により適しています。
次のような場合にCoreWeaveを評価してください。
- シンプルな開発用ポッドではなく、本番向けGPUインフラが必要。
- Kubernetesネイティブな運用、ストレージ、ネットワーク、サポートを重視している。
- 継続的な推論、トレーニング、またはAIメディア向けキャパシティを計画している。
- コミット済みキャパシティとエンタープライズ条件についてプロバイダーと話したい。
トレードオフとして、CoreWeaveは通常、小さな実験に対して最も軽量な選択肢ではありません。最速で最初のポッドを立てることよりも、キャパシティ計画、サポート、本番の信頼性が重要な場合に候補に入れるべきです。
Crusoe Cloud
Crusoe Cloudは、エンタープライズ調達とサステナビリティ志向のポジショニングを備えた、専有またはスケーラブルなGPUインフラを求めるAIチームにとって比較する価値があります。キャパシティに関する話では、Lambda、CoreWeave、Nebius、Massed Computeと同じ短リストに入ることがよくあります。
次のような場合にRunPod代替案としてCrusoeを使います。
- 単発のGPUレンタルではなく、クラスター容量を求めている。
- サポート、リージョン、キャパシティ条件を含むプロバイダー見積もりが必要。
- ハイパースケーラーのクォータ手続きではなく、専門クラウドとの会話を望んでいる。
正確なGPUモデル、相互接続、ストレージ、サポート範囲、そしてワークロードが自主管理のKubernetes、Slurm、またはマネージド環境を必要とするかを確認してください。
Massed Compute
Massed Computeは、公開されたGPU価格と、予約済みまたは専有キャパシティへの道筋の両方を求める購入者にとって有用な比較対象です。エンタープライズ向けの問いを持ち始めたチームにとって、シンプルなGPUクラウド経済性を備えた実用的なRunPod代替案です。
次のような場合にMassed Computeを評価してください。
- 明確な公開の起点を持つH100/A100/L40S系のキャパシティが必要。
- オンデマンドのGPU料金と長期コミットメントを比較したい。
- 専用クラスターまたはベースライン推論プールの調達ワークシートを作成している。
公式のMassed Compute pricingページをライブのソース行として使い、その後、サポート、ネットワーク、ストレージ、予約条件に何が含まれるかを確認してください。
Nebius AI Cloud
Nebiusは、GPUの生サーバーだけでなく、GPUの周辺にマネージドインフラサービスを備えたAIネイティブなクラウドを求める買い手にとって、信頼できるRunPod代替案です。特に、分離されたインスタンスではなく、モデルのトレーニング、推論、データ、オーケストレーションのためのクラウドプラットフォームをチームが望む場合に適しています。
次のような場合にNebiusを評価してください。
- より広範なAIクラウド環境が必要。
- GPUワークロードを取り巻くKubernetes、マネージドサービス、ストレージ、ネットワークを重視している。
- デフォルトの米国ハイパースケーラー短リスト以外の代替案を求めている。
TCOの観点では、リージョンの可用性、サポート、ストレージ、ネットワークのエグレス、クォータ、予約の仕組み、GPU世代の可用性を確認してください。
Hyperstack
Hyperstack は、インスタンスタイプ、時間単価、セルフサービスでのデプロイという観点で GPU クラウドプロバイダーを比較しているチームにとって、RunPod の直接的な代替手段です。大規模なクラウドプラットフォームを導入せずに、NVIDIA GPU インスタンスへ素早くアクセスしたい場合に有用です。
Hyperstack を使うべきケース:
- 実験、推論、バッチジョブ向けに、シンプルな GPU クラウドプロバイダーが欲しい。
- H100、H200、A100、L40S、RTX クラス、または新世代 GPU の利用可否を比較している。
- 営業に連絡する前に、公開価格の確認ポイントが必要。
確認用の基準として、公式の Hyperstack GPU pricing ページを使用してください。とはいえ、ストレージ、帯域幅、稼働率の期待値、サポート、そしてジョブ開始時に正確な GPU/リージョンが利用可能かどうかは、必ず確認しましょう。
Vultr Cloud GPU
Vultr は、GPU オプション、グローバルリージョン、そして純粋な GPU マーケットプレイスよりもシンプルなインフラパッケージを備えた、馴染みのあるクラウドプロバイダーをチームが求めている場合に、RunPod の代替候補として検討すべきです。既にクラウド VM を使っていて、新しい運用モデルを採用せずに GPU キャパシティを欲しいチームには魅力的です。
Vultr を評価すべきケース:
- ワークロードが複雑なクラスターよりも、従来型の VM に近い。
- GPU アクセラレーションとグローバルなクラウドインフラの両方が必要。
- 既存のクラウド運用パターンに合うプロバイダーが欲しい。
クォータ、GPU ファミリー、リージョン、永続ストレージ、エグレス、サポート、そしてシンプルな GPU VM では提供できない高性能インターコネクトがワークロードに必要かどうかを確認してください。
RunPod のマーケットプレイス代替案
Vast.ai
Vast.ai は、柔軟な GPU 供給と低い参入コストを求める開発者にとって、最も一般的な RunPod 代替案の 1 つです。これはマーケットプレイスなので、比較対象は Vast.ai 対 RunPod だけではありません。各ホスト、GPU、所在地、信頼性スコア、ディスク、ネットワーク、そして中断プロファイルと、あなたのワークロードを比較することになります。
Vast.ai は次の用途に適していることが多いです:
- ComfyUI の実験。
- バッチ画像生成。
- 短時間の研究ジョブ。
- 柔軟な推論テスト。
- チェックポイント保存と再試行が可能なワークロード。
予測可能なサポート、コンプライアンス、プライベートネットワーキング、または厳格な顧客向け稼働率が必要なワークロードには向いていません。生きたマーケットプレイスの基準として公式の Vast.ai pricing ページを使用してください。ただし、時間単価の GPU 料金だけで比較してはいけません。
TensorDock
TensorDock も、マーケットプレイス型の RunPod 代替案です。公式の GPU クラウドページでは、独立したホストが競争し価格を設定するマーケットプレイスであることが説明されており、購入者は TensorDock を単一の固定料金クラウドとして扱うのではなく、各デプロイメントオプションを評価すべきです。
TensorDock は次のような場合に役立ちます:
- 柔軟な GPU VM の選択肢が欲しい。
- 短期プロジェクト向けに RTX クラスまたはデータセンター GPU オプションが必要。
- 開始前にホスト詳細、ストレージ、帯域幅、信頼性を評価できる。
確認用の基準として、公式の TensorDock GPU cloud ページを使用してください。本番用途では、選択したキャパシティが、顧客ワークロードに必要なサポート、分離、運用上の保証を備えているかを確認してください。
RunPod のハイパースケーラー代替案
AWS、Google Cloud、Azure は、必ずしもより安価な RunPod 代替案ではありません。むしろ、運用面でより完全な代替案であることが多いです。
AWS
ワークロードにエンタープライズの ID、ネットワーキング、コンプライアンス、調達、そして既存の AWS システムとの統合が必要な場合、AWS が有力です。H100 クラスのワークロードでは AWS P5 インスタンスが主な基準点となり、定義された期間の予約済み ML キャパシティが必要な場合は EC2 Capacity Blocks が関連します。
AWS が適しているケース:
- すでに AWS 上でデータ、セキュリティ、デプロイのシステムを運用している。
- エンタープライズ向けの調達とサポートが必要。
- 学習やローンチの期間に対して、定義された予約モデルが必要。
- クラウドの複雑さとクォータ管理に対応できる。
AWS P5 instances と EC2 Capacity Blocks for ML を確認し、EBS、データ転送、サポート、NAT、可観測性、エンジニアリング工数を TCO に含めてください。判断が特に旧世代と新世代の NVIDIA キャパシティの比較である場合は、補助資料として H100 vs A100 と H200 vs H100 の比較を参照してください。
Google Cloud
Google Cloud は、アクセラレーター最適化のマシンファミリー、エンタープライズ制御、データ、ネットワーキング、Kubernetes を中心としたクラウドネイティブな環境を求めるチームにとって、RunPod の代替案です。特に、すでに Google Cloud のデータインフラを使っている組織に関連性が高いです。
Google Cloud を使うべきケース:
- ワークロードに BigQuery、GCS、GKE、または Vertex AI と連携したクラウドデータのローカリティが必要。
- エンタープライズの ID、監査、調達コントロールが必要。
- クォータ、リージョン、ディスク、ネットワーク料金を考慮した計画ができる。
ソースの基準点として、Google Cloud accelerator-optimized machine documentation と Compute Engine GPU pricing を使用してください。専用 GPU クラウドと比較する前に、GPU、マシン、ディスク、ネットワーク、そして確約利用の前提を正規化してください。
Azure
Azure は、Microsoft のクラウド、ID、セキュリティ、調達、またはデータシステムにすでに標準化されている企業にとって、実用的な RunPod の代替案です。Azure の ND H100 v5 シリーズは、H100 クラスター型ワークロードの重要なソース・チェックポイントです。
次のような場合は Azure を使用します。
- 会社がすでに Microsoft の契約経由で購入している。
- エンタープライズ向けのセキュリティ、コンプライアンス、ネットワーク制御が必要である。
- より広範な Azure のデータまたはアプリケーション基盤に紐づいた GPU VM が必要である。
Azure ND H100 v5 series を確認し、その後、リージョンでの利用可能性、クォータ、InfiniBand 要件、ストレージ、サポート、および導入の複雑さを検証します。
サーバーレスとマネージド推論の代替案
RunPod の代替案がすべてレンタル GPU である必要はありません。チームが求めているのがマシンではなくエンドポイントであれば、マネージド推論によって多くの運用作業を削減できます。
Replicate
Replicate は、API 経由でモデルを実行し、モデルバージョンをデプロイし、GPU ホストを直接管理するのを避けたいチームに適しています。特に、モデルを活用した機能を迅速にリリースしたいプロダクトチームに有用です。
Replicate は次の用途に適しています。
- 画像、動画、音声、およびオープンソースモデルの推論。
- API をすばやく必要とするプロダクトのプロトタイプ。
- 低レベルの GPU 制御よりもデプロイの使いやすさを優先するチーム。
Replicate の料金をソース・チェックポイントとして使用し、ハードウェアオプション、デプロイ動作、コールドスタート、ログ、データ処理、そしてワークロードにカスタムカーネルやプライベートネットワークが必要かどうかを確認してください。
Together AI
Together AI は、ワークロードが汎用の GPU VM レンタルというより LLM 推論やファインチューニングに近い場合の RunPod 代替案です。マネージド推論、専用エンドポイント、そしてスタック全体を運用せずにモデル提供インフラを求めるチームにとって、検討候補に入ります。
Together AI は次の用途に適しています。
- LLM 推論エンドポイント。
- ファインチューニングと評価のワークフロー。
- 生の pod 管理よりもモデル提供インフラを求めるチーム。
Together AI の料金を最新の料金チェックポイントとして使用し、ワークロードがサーバーレス推論、専用エンドポイント、バッチ API、またはカスタムのエンタープライズ契約のどれに属するかを確認してください。セルフホストする場合は、vLLM と SGLang の比較で提供スタックを別途比較してください。
モデル API とルーターの代替案
見落とされがちな RunPod 代替案は、モデル API とルーターです。製品にカスタム重み、カスタム CUDA カーネル、プライベート GPU 配置、または低レベルの提供制御が不要なら、GPU を借りるのは適切な抽象化ではないかもしれません。
この判断には Flatkey の位置づけが役立ちます。1つのキー、1つの残高、1つの請求書、OpenAI 互換ルーティング、公式モデルエンドポイント、利用台帳、予算管理、そして多くのモデルとツールにまたがるフォールバック経路。これは、提供スタックを自分で所有する必要があるときの専用 GPU クラスターの代替にはなりません。しかし、必要なのが追跡可能な支出で信頼できる AI 出力であれば、クラスターの代わりになります。モデル側の予算を比較する場合は、GPU のワークシートと AI モデルの価格比較、および AI API 支出管理を参照してください。
次のような場合はモデル API またはルーターを使用します。
- 多数のテキスト、画像、または動画モデルへのアクセスが必要である。
- トラフィックが突発的で、予約済み GPU を正当化できない。
- モデル選択が頻繁に変わる。
- 重み、ドライバー、CUDA、または提供カーネルを管理する必要がない。
- 生の GPU 制御よりも、コストの可視性、フォールバック、請求の集約のほうが重要である。
次のような場合は専用 GPU を使用します。
- プライベートまたはカスタム重みを提供する。
- カスタムカーネル、量子化、アダプター、または提供ロジックが必要である。
- データ所在地または分離の要件により、自前の環境が必要である。
- 推論量が安定しており、確約容量を正当化できる。
- GPU 運用を担当する体制がある。
これが調達の核心的な問いです。買っているのはハードウェアへのアクセスですか、それとも受け入れ可能な出力ですか。
ComfyUI 向け RunPod 代替案
runpod alternatives comfyui の検索は、たいてい実務上の悩みから来ています。つまり、ワークフローは動くものの、ストレージ、起動時間、イメージのバージョン、再現性が面倒になってきている、という状況です。
ComfyUI については、次の選択肢を比較してください。
| 選択肢 | 最適な用途 | 注意点 |
|---|---|---|
| RunPod pods | テンプレートとボリュームをすでに持っているなら馴染みのある経路 | 永続ボリュームのクリーンアップ、アイドルコスト、イメージのずれ |
| Vast.ai or TensorDock | バッチ画像ジョブ向けの柔軟な GPU 調達 | ホストの信頼性、ストレージ、帯域幅、再起動 |
| Hyperstack or Lambda | より一般的な GPU クラウドインスタンスモデル | 可用性、時間課金、セットアップ責任 |
| Replicate-style APIs | API 経由で画像出力を必要とするプロダクト機能 | 低レベルのワークフロー制御は限定的 |
| Flatkey/model API route | 複数プロバイダーにまたがる画像/動画モデルの実験 | 直接的なノード制御を必要とするカスタム ComfyUI グラフの代替ではない |
ComfyUI では、GPU のモデルと時間単価だけを比較しないでください。次の点も測定します。
- イメージとモデル重みを取得するのにかかる時間。
- 永続ストレージのコスト。
- カスタムノードが再ビルド後も存続するかどうか。
- バッチ完了後のアイドル時間。
- 出力転送料金。
- モデル不足、不正なイメージ、またはホスト再起動による失敗率。
- ワークフローにUI、APIエンドポイント、または自動キューが必要かどうか。
ComfyUI向けのRunPod代替案として最適なのは、見かけ上のGPU時間単価が最も低いものではなく、再ビルド時間と放置されたストレージを削減できるものです。
専用GPUクラスターのチェックリスト
切り替えの理由がエンタープライズ向けキャパシティである場合は、契約書に署名する前にこのチェックリストを使ってください。
| 要件 | 各プロバイダーに確認すること |
|---|---|
| GPU構成 | 正確なGPUモデル、メモリ、PCIe/SXM/NVL、ノードあたりのGPU数、CPU、RAM、ローカルNVMe |
| ネットワーク | InfiniBand、RoCE、EFA、NVLink/NVSwitch、配置保証、オーバーサブスクリプション、NCCLテストの証跡 |
| ストレージ | ローカルスクラッチ、共有ファイルシステム、オブジェクトストレージのリージョン、チェックポイントのスループット、スナップショット料金 |
| スケジューラ | Kubernetes、Slurm、Ray、マネージドサービス、ユーザーアクセス、クォータ、アイドル時シャットダウン |
| 信頼性 | ノード交換ポリシー、メンテナンス時間、インシデントエスカレーション、SLA、再試行ポリシー |
| セキュリティ | テナント分離、監査ログ、シークレットの取り扱い、プライベートネットワーク、データ削除 |
| コスト管理 | チーム別タグ、利用状況のエクスポート、予算アラート、アイドル検出、チャージバック |
| 契約 | 最低契約期間、最低利用額、バーストオプション、アップグレードパス、解約、サポート範囲 |
契約が簡単には解除できなくなる前に、少なくとも1回は受入テストを実施してください:
cluster acceptance test =
  deploy production container
  pull model weights and dataset
  run representative benchmark
  run NCCL all-reduce if multi-node
  write and restore checkpoint
  simulate one failed job
  export cost and utilization logs
プロバイダーが代表的なベンチマークをサポートできない場合は、それを調達上のリスクとして扱ってください。
Replicate vs Together AI vs RunPod代替案
検索クエリ replicate vs together ai vs runpod alternatives は3つのカテゴリを混在させているため、抽象化レベルで比較してください。
| プラットフォーム種別 | あなたが管理するもの | プロバイダーが管理するもの | 最適な用途 |
|---|---|---|---|
| RunPod型GPUクラウド | コンテナ、イメージ、ストレージ、GPUライフサイクル、サービングスタック | GPUインフラとプラットフォームの基盤要素 | GPUを直接制御する必要がある開発者 |
| Replicate型モデルデプロイ | モデルのパッケージ化とAPI利用 | サービングインフラの大部分と、ユーザー向けデプロイの使いやすさ | モデルエンドポイントを素早く出荷したいプロダクトチーム |
| Together AI型推論プラットフォーム | モデル選定、エンドポイント選択、ワークロード設計 | LLMサービングインフラとエンドポイント運用 | LLM推論/ファインチューニングに注力するチーム |
| Flatkey型モデルルーター | API呼び出し、予算、モデルルーティングポリシー | マルチモデルアクセス層、統合請求、利用台帳 | GPUの所有ではなく、公式なモデル出力を必要とするチーム |
最も安い項目を選ばないでください。仕事に対する運用リスクが最も低いものを選んでください。
RunPod代替案の比較ワークシート
GPUクラウドプロバイダーを比較するときは、このワークシートを使ってください。
| 項目 | プロバイダーA | プロバイダーB | プロバイダーC |
|---|---|---|---|
| 製品モード | Pod / VM / serverless / reserved cluster / API | ||
| GPUモデルとメモリ | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| リージョンまたはホスト | |||
| 課金単位 | 秒、分、時間、月次、キャパシティブロック | ||
| 最低コミット | なし、月次、年次、予約ブロック | ||
| ストレージコスト | ボリューム、スナップショット、オブジェクトストレージ、ローカルNVMe | ||
| ネットワークコスト | egress、プライベートリンク、クロスリージョン、パブリックIP | ||
| 起動オーバーヘッド | イメージ取得、重みのダウンロード、コールドスタート | ||
| アイドル率 | 有益な作業がない課金対象分数 | ||
| 失敗/再試行倍率 | エビクション、OOM、不良ホスト、コールドスタート失敗 | ||
| サポート | セルフサービス、チケット、専用サポート、SLA | ||
| セキュリティ | テナント分離、監査ログ、シークレット、削除 | ||
| 受け入れられる出力単位 | 100万トークン、画像、動画、ファインチューニング、学習実行 | ||
| 受け入れ出力あたりの実効コスト | 推測ではなく算出 |
次に、以下を計算してください:
effective hourly cost =
  GPU hourly cost
  + storage per hour
  + network per hour
  + support per hour
  + idle waste
  + retry waste
  + engineering overhead

cost per accepted output =
  effective hourly cost / accepted outputs per hour
これは、専用キャパシティがAPIより優れているかどうかを判断する方法でもあります。GPU運用コストを含めた後で、APIの受け入れ出力あたりのコストの方が低いなら、GPU時間単価が魅力的に見えるという理由だけでクラスターを借りてはいけません。
現在の価格に関するソースチェックリスト
価格とGPUの उपलब्ध状況は頻繁に変わります。購入を決定する前に、ソースの行を再確認し、日付を記録してください。この下書きでは、ソースチェックリストは2026年10月12日時点のページ公開状況で検証されました。
| プロバイダー/カテゴリ | ソースの確認先 | 記録する内容 |
|---|---|---|
| RunPod | RunPod pricing, RunPod pod storage docs | Podモード、サーバーレスモード、Secure/Communityキャパシティ、ストレージ、ネットワークボリューム、アイドル時の前提条件 |
| Lambda | Lambda GPU Cloud | GPUモデル、インスタンス形状、可用性、予約またはクラスター条件 |
| Vast.ai | Vast.ai pricing | ホスト、信頼性、GPU、ストレージ、帯域幅、マーケットプレイス条件 |
| Massed Compute | Massed Compute pricing | オンデマンド料金、予約経路、サポート、クラスター条件 |
| Hyperstack | Hyperstack GPU pricing | GPU SKU、リージョン、ストレージ、ネットワーキング、サポート |
| TensorDock | TensorDock GPU cloud | マーケットプレイスのホスト、GPU、RAM/vCPU、ストレージ、デプロイ時の価格 |
| Replicate | Replicate pricing | デプロイ価格、ハードウェア、コールドスタート、ログ、データポリシー |
| Together AI | Together AI pricing | サーバーレス、専用エンドポイント、ファインチューニング、バッチの経済性 |
| AWS | EC2 P5 instances, EC2 Capacity Blocks | リージョン、クォータ、インスタンスファミリー、予約期間、EBS、データ転送、サポート |
| Google Cloud | Accelerator-optimized machines, GPU pricing | マシンファミリー、GPU価格、ディスク、ネットワーク、確約利用割引 |
| Azure | ND H100 v5 series | VMサイズ、リージョン、クォータ、InfiniBand、サポート、ストレージ |
最終推奨
RunPodの代替案は、運用モデルごとに絞り込みます。
- マーケットプレイスを使う。Vast.aiやTensorDockは、柔軟な実験、ComfyUIのバッチ処理、再試行に強いワークロードに適しています。
- 専門GPUクラウドを使う。Lambda、CoreWeave、Crusoe、Massed Compute、Nebius、Hyperstack、Vultrなどは、より予測可能なGPUキャパシティとサポートが必要な場合に適しています。
- ハイパースケーラーを使う。企業ID、調達、コンプライアンス、既存クラウドのデータ重力が、シンプルさより重要な場合に適しています。
- マネージド推論プラットフォームを使う。ReplicateやTogether AIは、VMの制御よりもエンドポイントの挙動が重要な場合に適しています。
- Flatkeyまたは別のモデルAPIルーターを使う。GPUを直接所有するよりも、公式AIモデル出力、利用状況の可視化、フォールバック、統合請求が必要な場合に適しています。
最適なRunPod代替案とは、受け入れられた作業のコストを下げるものです。GPU 1時間あたりの価格が安くても、アイドル時間、起動オーバーヘッド、失敗ジョブ、ストレージの無駄、エンジニアリング負荷が増えるなら、実際には安くありません。
よくある質問
RunPodの代替案にはどのようなものがありますか?
一般的なRunPod代替案には、Lambda Cloud、CoreWeave、Crusoe Cloud、Massed Compute、Nebius AI Cloud、Hyperstack、Vultr Cloud GPU、Vast.ai、TensorDock、Replicate、Together AI、AWS、Google Cloud、Azure、およびFlatkeyのようなモデルAPIルーターが含まれます。最適な選択は、pods、サーバーレスエンドポイント、専用クラスター、マーケットプレイス、またはAPIレベルのモデルアクセスのどれが必要かによって決まります。
ComfyUIに最適なRunPod代替案は何ですか?
ComfyUIの実験では、Vast.ai、TensorDock、Hyperstack、Lambda、そしてPaperspace系のGPUクラウドがよく候補に挙がります。時間単価のGPU料金を比較する前に、永続ストレージ、モデル重みのキャッシュ、起動時間、カスタムノード管理、アイドル時のシャットダウン、出力転送、ホストの信頼性を比較してください。
RunPodの代替案はより安いですか?
場合によりますが、受け入れられた出力あたりの実効コストを計算した後でのみそう言えます。より低いGPU時間単価でも、モデルの取得、アイドル状態、失敗ジョブの再試行、データ移動に時間がかかるワークロードでは不利になることがあります。GPU時間だけでなく、完成した画像、トークン、動画、ジョブ単位で比較してください。
RunPodの代わりにReplicateやTogether AIを使うべきですか?
マネージドなモデルエンドポイントが必要で、低レベルのGPU制御が不要な場合は、ReplicateまたはTogether AIを使ってください。カスタムコンテナ、カスタムワークフロー、直接的なGPUアクセス、または提供スタックの制御が必要な場合は、RunPod型のGPUクラウドを使ってください。
GPUをレンタルする代わりにFlatkeyを使うべきなのはいつですか?
チームが公式モデルAPI、マルチモデルルーティング、1つのキー、1つの残高、使用台帳、フォールバック、予算管理を必要とする場合は、Flatkey を使用してください。カスタム重み、カスタムカーネル、プライベート配置、または安定した高稼働率により、運用コストに見合う直接的なインフラ制御が必要な場合は、GPU をレンタルしてください。


