
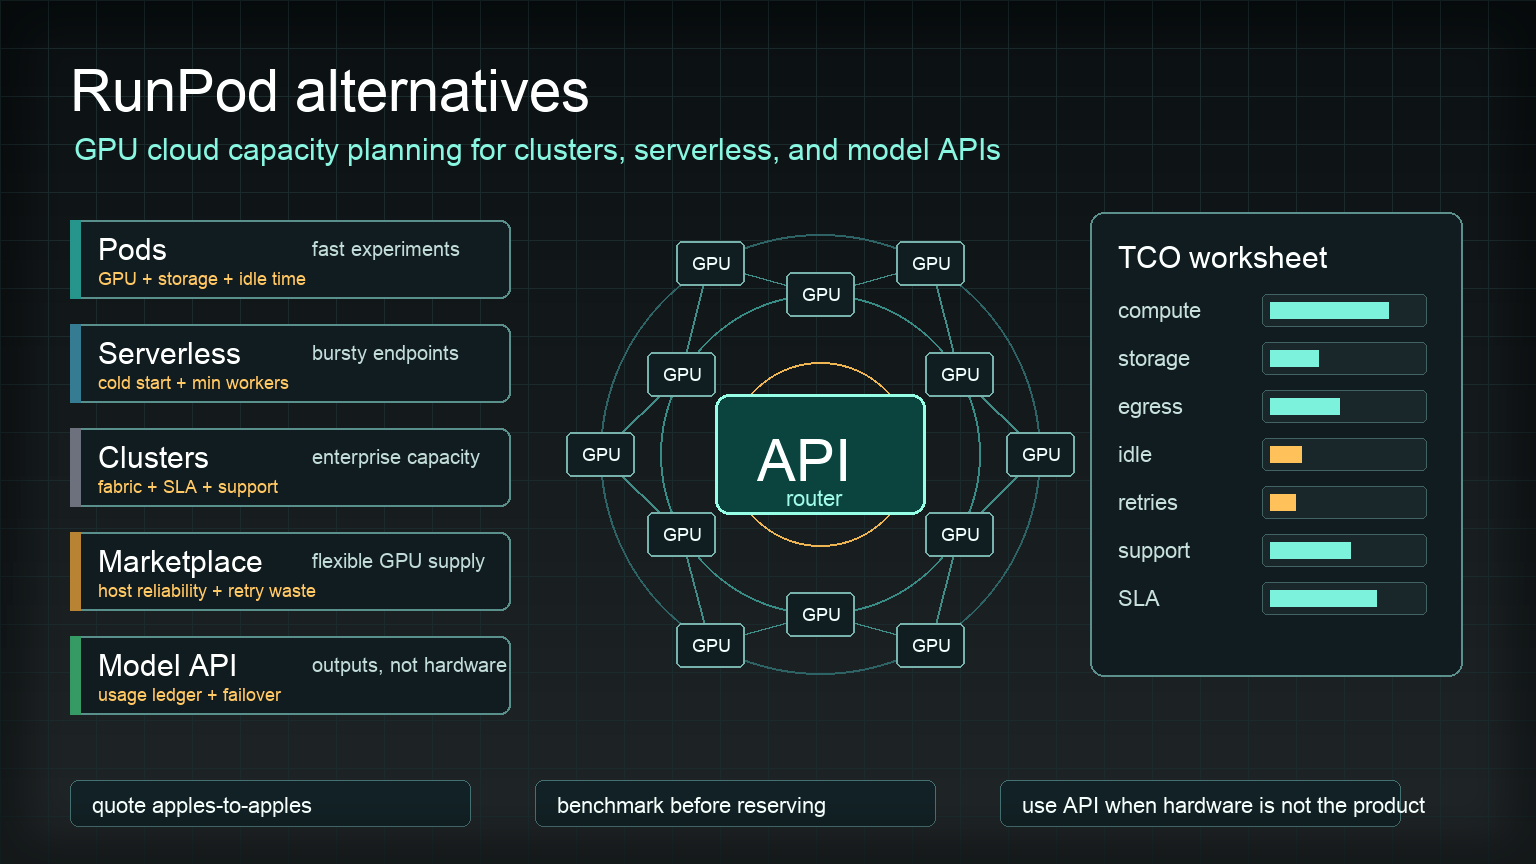
As alternativas ao RunPod geralmente entram na conversa depois do primeiro protótipo bem-sucedido. Um desenvolvedor consegue um workflow do ComfyUI, um fine-tune, um script de inferência em lote ou um endpoint vLLM em execução no RunPod; depois, a equipe faz uma pergunta mais difícil: isso pode se tornar capacidade de produção com custo previsível, suporte, armazenamento, rede, segurança e condições de aquisição?
A resposta depende do que você está substituindo. Um pod do RunPod, um endpoint do RunPod Serverless, uma instância segura de GPU, uma GPU comunitária e uma conversa sobre capacidade empresarial são movimentos de compra diferentes. As alternativas certas ao RunPod para um lote de ComfyUI de fim de semana não são as mesmas que as alternativas certas para um cluster privado de H100, um job de treinamento multinó, ou um serviço de inferência voltado ao cliente.
Este guia compara alternativas ao RunPod para desenvolvedores e equipes de IA pequenas e médias que precisam de mais do que uma hora barata de GPU. Ele cobre provedores de nuvem de GPU, marketplaces, hyperscalers, plataformas de inferência gerenciada e rotas de API de modelos, e depois oferece uma planilha para comparar o custo total de propriedade em vez de tarifas horárias em destaque. Se você precisar primeiro do modelo de preços mais amplo, comece com o guia da Flatkey sobre preços de aluguel de GPU.
A resposta rápida: melhores alternativas ao RunPod por carga de trabalho
Use esta tabela para montar a primeira lista curta. Trate-a como um mapa de decisão, não como um ranking universal.
| Carga de trabalho | Fortes alternativas ao RunPod para avaliar | Por que se encaixam | O que verificar antes de trocar |
|---|---|---|---|
| Experimentos com ComfyUI e lotes de imagens | Vast.ai, TensorDock, Hyperstack, Paperspace/DigitalOcean, RunPod Community Cloud se continuar | Acesso rápido à GPU, economia de marketplace ou self-service, boa opção para trabalho em lote flexível | Armazenamento persistente, tempo de inicialização, confiabilidade do host, largura de banda, fluxo de reinicialização, se a GPU é adequada para dados de produção |
| Inferência estável em nó único | Lambda Cloud, Hyperstack, Massed Compute, Nebius, Vultr, VMs de GPU da AWS/GCP/Azure | Modelo de instância mais limpo, caminhos de aquisição mais amplos, controles de infraestrutura mais previsíveis | Disponibilidade de GPU, região, suporte, custo de disco/rede, cota, observabilidade, autoscaling |
| Clusters de GPU dedicados | Clusters reservados da Lambda, CoreWeave, Crusoe Cloud, Massed Compute, Nebius, Capacity Blocks da AWS, reservas do Google Cloud, série ND da Azure | Melhor opção para capacidade comprometida, suporte, rede privada e planejamento de cluster multinó | Tecido de rede, garantia de posicionamento, SLA de suporte, prazo contratual, caminho de upgrade, ponto de equilíbrio de utilização |
| Endpoints de inferência serverless | Replicate, endpoints dedicados da Together AI, plataformas no estilo Modal, funções em nuvem com suporte a GPU, RunPod Serverless se continuar | Bom quando você precisa mais de comportamento de inferência implantado do que de controle bruto da VM | Cold starts, workers mínimos, preço por requisição, limites de empacotamento do modelo, logs, política de dados |
| Uso de modelos de fronteira ou APIs multi-modelo | Flatkey, roteadores no estilo OpenRouter, APIs de modelos nativas | Evita operações de GPU quando o valor está no resultado, não no controle do hardware | Disponibilidade do modelo, endpoints oficiais, comportamento de fallback, registro de uso, controles de orçamento, política de dados |
Para a maioria das equipes, as melhores alternativas ao RunPod não são um único provedor. Elas são uma arquitetura dividida:
- Use GPUs de marketplace para experimentos e lotes de mídia com picos.
- Use uma nuvem de GPU especializada ou um hyperscaler para capacidade de produção estável.
- Use uma API/roteador de modelos quando o produto não precisar de controle direto sobre pesos, kernels ou posicionamento da GPU.
Essa divisão evita que uma carga de trabalho force o modelo de infraestrutura errado sobre todas as outras cargas de trabalho.
Quando o RunPod ainda é uma boa opção
Este não é um artigo do tipo "RunPod é ruim". O RunPod é popular porque comprime o tempo de configuração. Os desenvolvedores podem iniciar pods de GPU, executar notebooks e contêineres, experimentar capacidade comunitária ou segura e usar endpoints serverless sem começar por um processo de aquisição de um hyperscaler.
O RunPod muitas vezes ainda é uma boa opção quando:
- Você precisa de acesso rápido à GPU para experimentos.
- Você está testando ComfyUI, Stable Diffusion, fluxos de trabalho de LoRA ou geração em lote de mídia.
- Você quer desenvolvimento simples baseado em pods antes de projetar um cluster de produção.
- Você consegue tolerar alguma variação de infraestrutura enquanto ainda está explorando.
- Sua carga de trabalho pode ser reiniciada ou reconstruída sem um incidente sério com clientes.
A troca normalmente passa a valer a pena quando a carga de trabalho se torna cara, constante, sensível à segurança, sensível à latência ou visível para aquisição. Nesse ponto, você deve comparar alternativas ao RunPod com base na adequação à carga de trabalho, não na familiaridade com a marca.
Estrutura de comparação das alternativas ao RunPod
Comece com esta fórmula normalizada:
custo efetivo por carga de trabalho aceita =
  computação
  + armazenamento
  + snapshots
  + largura de banda e egress
  + tempo ocioso
  + cold starts
  + jobs falhados e retries
  + suporte
  + overhead de engenharia
  / tokens, jobs, imagens, vídeos, fine-tunes ou solicitações de clientes aceitos
Depois faça seis perguntas antes de comparar fornecedores.
| Pergunta | Por que isso muda a resposta |
|---|---|
| Você precisa de controle da GPU ou apenas de saídas de IA? | Se você só precisa de texto, imagens, embeddings ou transcrições gerados, uma abordagem via API pode ser mais barata operacionalmente do que alugar GPUs. |
| A carga de trabalho é interativa ou em lote? | A inferência interativa precisa de latência p95/p99 e disponibilidade. Jobs em lote podem trocar tempo de fila por menor custo. |
| O job é interrompível? | Capacidade de marketplace e no estilo spot pode funcionar para jobs com checkpoint; ela pode ser perigosa para jobs longos e com estado. |
| O modelo cabe em uma GPU? | Cargas de trabalho com várias GPUs e vários nós adicionam risco de topologia, rede, scheduler e posicionamento. |
| O uso é previsível? | Capacidade reservada ou dedicada precisa de utilização de base suficiente para superar a demanda sob demanda. |
| Quem é o responsável pelas operações? | Drivers de GPU, imagens CUDA, vLLM/SGLang, limpeza de armazenamento, observabilidade e resposta a incidentes fazem parte do custo real. |
É aqui que muitas comparações de alternativas ao RunPod se tornam superficiais. Uma lista de provedores não é suficiente. Você precisa de um modelo de aquisição. Para capacidade multinó, combine este artigo com o checklist de aluguel de cluster GPU.
Alternativas de nuvem GPU ao RunPod
Lambda Cloud
A Lambda Cloud é uma das alternativas mais claras ao RunPod quando você quer uma nuvem GPU especializada com opções de instâncias GPU publicadas e um movimento de compra de infraestrutura mais convencional. Vale a pena avaliá-la para capacidade H100, H200, B200, A100 e outras da NVIDIA quando sua carga de trabalho está saindo de experimentos e indo para treinamento ou inferência repetíveis.
Use a Lambda quando você quiser:
- Instâncias de nuvem GPU diretas e simples.
- Um provedor de infraestrutura de IA especializado, em vez de um hyperscaler amplo.
- Um caminho de experimentos sob demanda para capacidade reservada ou comprometida.
- Uma linha de origem que o procurement consiga entender rapidamente.
Verifique a disponibilidade atual das instâncias, a variante exata da GPU, o armazenamento local, a região, o suporte e se a cotação é sob demanda, reservada ou orientada a cluster. Use a página oficial da Lambda GPU Cloud como ponto de verificação da fonte e, depois, solicite uma cotação se precisar de capacidade dedicada. Para trade-offs entre famílias de GPU, veja o guia da Flatkey sobre a melhor GPU para inferência de LLM.
CoreWeave
A CoreWeave é uma alternativa forte ao RunPod para equipes que já passaram de um único pod e precisam de capacidade GPU em escala na nuvem. Ela é mais relevante para cargas de trabalho de IA em produção, ambientes dedicados e procurement empresarial de GPU do que para experimentos avulsos de hobby.
Avalie a CoreWeave quando:
- Você precisa de infraestrutura GPU de produção em vez de um pod simples de desenvolvimento.
- Você se importa com operações nativas de Kubernetes, armazenamento, rede e suporte.
- Está planejando inferência sustentada, treinamento ou capacidade para mídia com IA.
- Você precisa de uma conversa com o provedor sobre capacidade comprometida e termos empresariais.
A desvantagem é que a CoreWeave geralmente não é o caminho mais leve para um experimento pequeno. Ela entra na lista curta quando planejamento de capacidade, suporte e confiabilidade em produção importam mais do que o primeiro pod mais rápido possível.
Crusoe Cloud
A Crusoe Cloud vale a comparação para equipes de IA que querem infraestrutura GPU dedicada ou escalável com procurement empresarial e posicionamento orientado a sustentabilidade. Ela costuma entrar na mesma lista curta que Lambda, CoreWeave, Nebius e Massed Compute em conversas sobre capacidade.
Use a Crusoe como alternativa ao RunPod quando:
- Você está pedindo capacidade de cluster em vez de aluguel pontual de GPU.
- Você precisa de uma cotação do provedor com suporte, região e termos de capacidade.
- Você quer uma conversa com uma nuvem especializada em vez de um processo de cotação de hyperscaler.
Verifique o modelo exato da GPU, a interconexão, o armazenamento, o escopo de suporte e se sua carga de trabalho precisa de Kubernetes autogerenciado, Slurm ou de um ambiente gerenciado.
Massed Compute
A Massed Compute é um ponto de comparação útil para compradores que querem preços de GPU publicados mais um caminho para capacidade reservada ou dedicada. É uma alternativa prática ao RunPod para equipes que precisam de uma economia simples de nuvem GPU, mas já estão começando a fazer perguntas empresariais.
Avalie a Massed Compute quando:
- Você precisa de capacidade no estilo H100/A100/L40S com um ponto de partida público claro.
- Você quer comparar taxas de GPU sob demanda com compromissos de mais longo prazo.
- Você está montando uma planilha de procurement para um cluster dedicado ou um pool base de inferência.
Use a página oficial de preços da Massed Compute como uma linha de fonte ao vivo e, depois, pergunte o que está incluído em suporte, rede, armazenamento e termos reservados.
Nebius AI Cloud
A Nebius é uma alternativa credível ao RunPod quando o comprador quer uma nuvem nativa de IA com serviços de infraestrutura gerenciada ao redor das GPUs, e não apenas servidores brutos. Ela é especialmente relevante quando sua equipe quer uma plataforma de nuvem para treinamento de modelos, inferência, dados e orquestração, em vez de instâncias isoladas.
Avalie a Nebius quando:
- Você precisa de um ambiente de nuvem de IA mais amplo.
- Você se importa com Kubernetes, serviços gerenciados, armazenamento e rede ao redor de cargas de trabalho GPU.
- Você quer alternativas fora da lista curta padrão de hyperscalers dos EUA.
Para o TCO, confirme disponibilidade por região, suporte, saída de rede, quota, mecânica de reserva e disponibilidade da geração de GPU.
Hyperstack
O Hyperstack é uma alternativa direta ao RunPod para equipes que comparam provedores de cloud GPU por tipo de instância, custo por hora e implantação self-service. Ele é útil para acesso rápido a instâncias NVIDIA GPU sem assumir uma grande plataforma de cloud.
Use o Hyperstack quando:
- Você quer um provedor de cloud GPU simples para experimentos, inferência ou jobs em lote.
- Você está comparando a disponibilidade de GPU H100, H200, A100, L40S, da classe RTX ou mais novas.
- Você precisa de um ponto de verificação de preços público antes de contatar a equipe de vendas.
Use a página oficial de preços de GPU do Hyperstack como ponto de verificação de origem. Ainda assim, verifique armazenamento, largura de banda, expectativas de uptime, suporte e se a sua GPU/região exata está disponível quando o job começar.
Vultr Cloud GPU
A Vultr deve entrar na lista de alternativas ao RunPod quando sua equipe quer um provedor de cloud conhecido com opções de GPU, regiões globais e um empacotamento de infraestrutura mais simples do que um marketplace de GPU puro. Ela pode ser atraente para equipes que já usam VMs de cloud e querem capacidade GPU sem adotar um novo modelo operacional.
Avalie a Vultr quando:
- Sua carga de trabalho é mais parecida com uma VM convencional do que com um cluster complexo.
- Você precisa de infraestrutura de cloud global mais aceleração por GPU.
- Você quer um provedor que se encaixe nos padrões existentes de operações de cloud.
Verifique quota, família de GPU, região, armazenamento persistente, egress, suporte e se a carga de trabalho precisa de interconexão de alto nível que uma simples VM com GPU não pode oferecer.
Alternativas de marketplace ao RunPod
Vast.ai
A Vast.ai é uma das alternativas mais comuns ao RunPod para desenvolvedores em busca de oferta flexível de GPU e baixo custo inicial. Ela é um marketplace, então a comparação de provedores não é apenas Vast.ai versus RunPod. É cada host, GPU, localidade, score de confiabilidade, disco, rede e perfil de interrupção versus sua carga de trabalho.
A Vast.ai costuma ser uma boa opção para:
- Experimentos com ComfyUI.
- Geração de imagens em lote.
- Jobs curtos de pesquisa.
- Testes de inferência flexíveis.
- Cargas de trabalho que podem fazer checkpoint e tentar novamente.
Ela é mais fraca para cargas de trabalho que precisam de suporte previsível, conformidade, rede privada ou uptime rigoroso voltado ao cliente. Use a página oficial de preços da Vast.ai como um ponto de verificação do marketplace em tempo real, mas nunca compare apenas a taxa horária da GPU.
TensorDock
A TensorDock é outra alternativa ao RunPod no estilo marketplace. Sua página oficial de cloud GPU descreve um marketplace de hosts independentes que competem e definem preços, o que significa que os compradores devem avaliar cada opção de implantação em vez de tratar a TensorDock como uma única cloud com taxa fixa.
A TensorDock pode ser útil quando:
- Você quer opções flexíveis de VM com GPU.
- Você precisa de opções de GPU da classe RTX ou de data center para projetos curtos.
- Você consegue avaliar detalhes do host, armazenamento, largura de banda e confiabilidade antes do início.
Use a página oficial de cloud GPU da TensorDock como ponto de verificação de origem. Em produção, pergunte se a capacidade selecionada tem o suporte, o isolamento e as garantias operacionais de que sua carga de trabalho de cliente precisa.
Alternativas hyperscaler ao RunPod
AWS, Google Cloud e Azure nem sempre são alternativas mais baratas ao RunPod. Muitas vezes, são alternativas mais completas do ponto de vista operacional.
AWS
A AWS é relevante quando a carga de trabalho precisa de identidade empresarial, rede, conformidade, compras e integração com sistemas AWS existentes. Para cargas de trabalho da classe H100, as instâncias P5 da AWS são o principal ponto de verificação de origem, e os EC2 Capacity Blocks são relevantes quando você precisa de capacidade de ML reservada para uma janela definida.
A AWS pode se encaixar quando:
- Você já executa sistemas de dados, segurança e implantação na AWS.
- Você precisa de compras e suporte empresariais.
- Você precisa de um modelo de reserva definido para uma janela de treinamento ou lançamento.
- Você consegue lidar com a complexidade da cloud e o gerenciamento de quotas.
Verifique as instâncias AWS P5 e os EC2 Capacity Blocks for ML, e então inclua EBS, transferência de dados, suporte, NAT, observabilidade e tempo de engenharia no TCO. Se a decisão for especificamente sobre capacidade NVIDIA mais antiga versus mais nova, use as comparações H100 vs A100 e H200 vs H100 como leituras complementares.
Google Cloud
O Google Cloud é uma alternativa ao RunPod quando sua equipe quer famílias de máquinas otimizadas para aceleradores, controles empresariais e um ambiente nativo de cloud em torno de dados, rede e Kubernetes. Ele é especialmente relevante para organizações que já usam infraestrutura de dados do Google Cloud.
Use o Google Cloud quando:
- Sua carga de trabalho precisa de proximidade de dados na cloud com BigQuery, GCS, GKE ou Vertex AI.
- Você precisa de controles empresariais de identidade, auditoria e compras.
- Você consegue planejar em torno de quota, regiões, disco e preços de rede.
Use a documentação de máquinas otimizadas para aceleradores do Google Cloud e a precificação de GPU do Compute Engine como pontos de verificação de origem. Normalize as suposições de GPU, máquina, disco, rede e uso comprometido antes de compará-lo com clouds de GPU especializadas.
Azure
Azure é uma alternativa prática ao RunPod para empresas já padronizadas em cloud, identidade, segurança, compras ou sistemas de dados da Microsoft. A série ND H100 v5 da Azure é um checkpoint-chave de fonte para workloads no estilo de cluster H100.
Use a Azure quando:
- Sua empresa já compra por meio de contratos Microsoft.
- Você precisa de segurança, compliance e controles de rede empresariais.
- Você precisa de VMs GPU vinculadas a uma infraestrutura mais ampla de dados ou aplicações da Azure.
Consulte a série ND H100 v5 da Azure, depois valide disponibilidade regional, quota, requisitos de InfiniBand, armazenamento, suporte e complexidade de implantação.
Alternativas serverless e de inferência gerenciada
Nem toda alternativa ao RunPod deve ser uma GPU alugada. Se sua equipe quer um endpoint, e não uma máquina, a inferência gerenciada pode remover grande parte do trabalho operacional.
Replicate
O Replicate é uma boa opção quando a equipe quer executar modelos por meio de uma API, implantar versões de modelo e evitar gerenciar hosts GPU diretamente. É especialmente útil para equipes de produto que se preocupam em lançar rapidamente recursos com suporte de modelos.
O Replicate pode ser adequado para:
- Inferência de modelos de imagem, vídeo, áudio e open source.
- Protótipos de produto que precisam rapidamente de uma API.
- Equipes que preferem ergonomia de implantação em vez de controle de GPU em baixo nível.
Use o preço do Replicate como checkpoint de fonte e, em seguida, verifique opções de hardware, comportamento de implantação, cold starts, logs, tratamento de dados e se o workload precisa de kernels personalizados ou rede privada.
Together AI
O Together AI é uma alternativa ao RunPod quando o workload está mais próximo de inferência e fine-tuning de LLM do que do aluguel geral de VMs GPU. Ele merece estar na lista curta para equipes que querem inferência gerenciada, endpoints dedicados e infraestrutura de serving de modelos sem operar toda a stack.
O Together AI pode ser adequado para:
- Endpoints de inferência de LLM.
- Workflows de fine-tuning e avaliação.
- Equipes que querem infraestrutura de serving de modelos em vez de gerenciamento bruto de pods.
Use o preço do Together AI como checkpoint de preço em tempo real e verifique se o workload deve ficar em inferência serverless, endpoints dedicados, APIs em lote ou um contrato empresarial personalizado. Se você for self-host, compare as stacks de serving separadamente com vLLM vs SGLang.
Alternativas de API de modelo e roteador
As alternativas ao RunPod mais negligenciadas são APIs de modelo e roteadores. Se o seu produto não requer pesos personalizados, kernels CUDA personalizados, posicionamento privado de GPU ou controle de serving em baixo nível, alugar GPUs pode ser a abstração errada.
O posicionamento da Flatkey é útil para essa decisão: uma chave, um saldo, uma fatura, roteamento compatível com OpenAI, endpoints oficiais de modelos, registros de uso, controles de orçamento e caminhos de fallback entre muitos modelos e ferramentas. Isso não substitui um cluster de GPU dedicado quando você precisa controlar a stack de serving. Mas substitui o cluster quando o que você precisa é de saída de IA confiável com gastos rastreáveis. Para orçamento do lado do modelo, compare a planilha de GPU com a comparação de preços de modelos de IA e gestão de gastos com API de IA.
Use uma API de modelo ou roteador quando:
- Você precisa acessar muitos modelos de texto, imagem ou vídeo.
- O tráfego é intermitente e não justifica GPUs reservadas.
- A escolha do modelo muda com frequência.
- Você não precisa gerenciar pesos, drivers, CUDA ou kernels de serving.
- Visibilidade de custos, fallback e consolidação de faturamento importam mais do que o controle bruto da GPU.
Use GPUs dedicadas quando:
- Você serve pesos privados ou personalizados.
- Você precisa de kernels personalizados, quantização, adapters ou lógica de serving.
- A residência de dados ou o isolamento exigem seu próprio ambiente.
- O volume de inferência é estável o suficiente para justificar capacidade contratada.
- Você pode manter operações de GPU com equipe.
Essa é a questão central de procurement: você está comprando acesso ao hardware ou saídas aceitas?
Alternativas ao RunPod para ComfyUI
As buscas por runpod alternatives comfyui geralmente vêm de uma dor prática: o workflow funciona, mas armazenamento, tempo de inicialização, versões de imagem e repetibilidade estão começando a incomodar.
Para ComfyUI, compare estas opções:
| Opção | Melhor ajuste | Pontos de atenção |
|---|---|---|
| Pods do RunPod | Caminho familiar se você já tem templates e volumes | Limpeza de volume persistente, custo ocioso, drift de imagem |
| Vast.ai ou TensorDock | Oferta flexível de GPU para jobs de imagem em lote | Confiabilidade do host, armazenamento, largura de banda, reinicializações |
| Hyperstack ou Lambda | Modelo de instância de cloud GPU mais convencional | Disponibilidade, custo por hora, responsabilidade pela configuração |
| APIs estilo Replicate | Recursos de produto que precisam de saídas de imagem por meio de uma API | Menos controle de workflow em baixo nível |
| Caminho Flatkey/API de modelo | Experimentação multi-provider com modelos de imagem/vídeo | Não é substituto para grafos ComfyUI personalizados que exigem controle direto de nós |
Para ComfyUI, não compare apenas o modelo de GPU e a taxa por hora. Meça também:
- Tempo para baixar imagens e pesos do modelo.
- Custo de armazenamento persistente.
- Se os nós personalizados sobrevivem a rebuilds.
- Tempo ocioso após a conclusão de um lote.
- Custo de transferência de saída.
- Taxa de falha por modelos ausentes, imagens incorretas ou reinicializações do host.
- Se o fluxo de trabalho precisa de uma UI, endpoint de API ou fila automatizada.
As melhores alternativas ao RunPod para ComfyUI costumam ser as que reduzem o tempo de rebuild e o armazenamento abandonado, não as que têm a menor hora de GPU visível.
Lista de verificação para clusters GPU dedicados
Se o motivo da mudança for capacidade empresarial, use esta lista antes de assinar uma term sheet.
| Requisito | O que perguntar a cada provedor |
|---|---|
| Formato da GPU | Modelo exato da GPU, memória, PCIe/SXM/NVL, GPUs por nó, CPU, RAM, NVMe local |
| Rede | InfiniBand, RoCE, EFA, NVLink/NVSwitch, garantia de posicionamento, oversubscription, evidência de teste NCCL |
| Armazenamento | Scratch local, sistema de arquivos compartilhado, região de object storage, throughput de checkpoints, preço de snapshots |
| Agendador | Kubernetes, Slurm, Ray, serviço gerenciado, acesso do usuário, quota, desligamento por inatividade |
| Confiabilidade | Política de substituição de nós, janelas de manutenção, escalonamento de incidentes, SLA, política de retentativa |
| Segurança | Isolamento de tenant, logs de auditoria, tratamento de segredos, rede privada, exclusão de dados |
| Controles de custo | Tags por equipe, exportações de uso, alertas de orçamento, detecção de ociosidade, chargeback |
| Contrato | Prazo mínimo, gasto mínimo, opções de burst, caminho de upgrade, cancelamento, escopo do suporte |
Execute pelo menos um teste de aceitação antes que o contrato se torne difícil de encerrar:
teste de aceitação do cluster =
  implantar contêiner de produção
  baixar pesos do modelo e dataset
  executar benchmark representativo
  executar all-reduce do NCCL se for multi-nó
  gravar e restaurar checkpoint
  simular uma tarefa com falha
  exportar custos e logs de utilização
Se um provedor não puder suportar um benchmark representativo, trate isso como um risco de compra.
Replicate vs Together AI vs alternativas ao RunPod
A consulta replicate vs together ai vs runpod alternatives mistura três categorias, então compare-as pelo nível de abstração.
| Tipo de plataforma | Você gerencia | O provedor gerencia | Melhor opção para |
|---|---|---|---|
| Cloud de GPU no estilo RunPod | Contêineres, imagens, armazenamento, ciclo de vida da GPU, stack de serving | Infraestrutura de GPU e primitivas da plataforma | Desenvolvedores que precisam de controle direto da GPU |
| Implantação de modelo no estilo Replicate | Empacotamento do modelo e uso da API | Grande parte da infraestrutura de serving e da ergonomia de implantação voltada ao usuário | Equipes de produto que publicam endpoints de modelo rapidamente |
| Plataforma de inferência no estilo Together AI | Seleção de modelo, escolha do endpoint, design da carga de trabalho | Infraestrutura de serving de LLM e operações de endpoint | Equipes focadas em inferência/fine-tuning de LLM |
| Roteador de modelos no estilo Flatkey | Chamadas de API, orçamentos, política de roteamento de modelos | Camada de acesso multi-modelo, faturamento unificado, ledger de uso | Equipes que precisam de saídas oficiais de modelos, não da posse da GPU |
Não escolha o item de linha mais barato. Escolha o menor risco operacional para a tarefa.
Planilha de comparação de alternativas ao RunPod
Use esta planilha ao comparar provedores de cloud de GPU.
| Campo | Provedor A | Provedor B | Provedor C |
|---|---|---|---|
| Modo do produto | Pod / VM / serverless / cluster reservado / API | ||
| Modelo e memória da GPU | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| Região ou host | |||
| Unidade de cobrança | segundo, minuto, hora, mensal, bloco de capacidade | ||
| Compromisso mínimo | nenhum, mensal, anual, bloco reservado | ||
| Custo de armazenamento | volumes, snapshots, object storage, NVMe local | ||
| Custo de rede | egress, link privado, cross-region, IP público | ||
| Overhead de inicialização | download da imagem, download dos pesos, cold start | ||
| Taxa de ociosidade | minutos faturáveis sem trabalho útil | ||
| Multiplicador de falha/retentativa | evictions, OOM, hosts ruins, falhas de cold start | ||
| Suporte | self-service, ticket, suporte dedicado, SLA | ||
| Segurança | isolamento de tenant, logs de auditoria, segredos, exclusão | ||
| Unidade de saída aceita | 1M tokens, imagem, vídeo, fine-tune, execução de treinamento | ||
| Custo efetivo por saída aceita | calculado, não estimado |
Depois calcule:
custo horário efetivo =
  custo horário da GPU
  + armazenamento por hora
  + rede por hora
  + suporte por hora
  + desperdício por ociosidade
  + desperdício por retentativa
  + overhead de engenharia

custo por saída aceita =
  custo horário efetivo / saídas aceitas por hora
É assim também que você decide se a capacidade dedicada supera as APIs. Se o custo da API por saída aceita for menor depois de incluir as operações de GPU, não alugue o cluster só porque a taxa horária da GPU parece atrativa.
Checklist de fonte para preços atuais
Preços e disponibilidade de GPU mudam com frequência. Antes de tomar uma decisão de compra, verifique novamente as linhas de origem e registre a data. Para este rascunho, a checklist de fonte foi verificada quanto à disponibilidade da página em 12 de outubro de 2026.
| Fornecedor/categoria | Ponto de verificação da fonte | O que capturar |
|---|---|---|
| RunPod | Preços do RunPod, Documentação de armazenamento de pods do RunPod | Modo pod, modo serverless, capacidade segura/comunitária, armazenamento, volume de rede, suposições de ociosidade |
| Lambda | Lambda GPU Cloud | Modelo de GPU, formato da instância, disponibilidade, termos reservados ou de cluster |
| Vast.ai | Preços do Vast.ai | Host, confiabilidade, GPU, armazenamento, largura de banda, termos do marketplace |
| Massed Compute | Preços do Massed Compute | Tarifas sob demanda, caminho de reserva, suporte e termos de cluster |
| Hyperstack | Preços de GPU da Hyperstack | SKU da GPU, região, armazenamento, rede, suporte |
| TensorDock | Cloud GPU do TensorDock | Host do marketplace, GPU, RAM/vCPU, armazenamento, preços no momento da implantação |
| Replicate | Preços do Replicate | Preço de implantação, hardware, cold starts, logs, política de dados |
| Together AI | Preços do Together AI | Serverless, endpoints dedicados, fine-tuning, economia em lotes |
| AWS | Instâncias EC2 P5, EC2 Capacity Blocks | Região, quota, família da instância, janela de reserva, EBS, transferência de dados, suporte |
| Google Cloud | Máquinas otimizadas para aceleradores, Preços de GPU | Família da máquina, preço da GPU, disco, rede, descontos por uso comprometido |
| Azure | Série ND H100 v5 | Tamanho da VM, região, quota, InfiniBand, suporte, armazenamento |
Recomendação final
Faça uma pré-seleção de alternativas ao RunPod por modelo operacional:
- Use marketplaces como Vast.ai ou TensorDock para experimentos flexíveis, lotes do ComfyUI e workloads tolerantes a novas tentativas.
- Use nuvens especializadas em GPU como Lambda, CoreWeave, Crusoe, Massed Compute, Nebius, Hyperstack ou Vultr quando você precisar de capacidade de GPU e suporte mais previsíveis.
- Use hyperscalers quando identidade empresarial, procurement, conformidade e a gravidade de dados na nuvem existente forem mais importantes do que a simplicidade.
- Use plataformas de inferência gerenciada como Replicate ou Together AI quando o comportamento do endpoint for mais importante do que o controle da VM.
- Use o Flatkey ou outro roteador de API de modelo quando você precisar de saídas oficiais de modelos de IA, visibilidade de uso, fallback e faturamento unificado, em vez de propriedade direta da GPU.
As melhores alternativas ao RunPod são as que reduzem o custo do trabalho aceito. Se um fornecedor lhe der uma hora de GPU mais barata, mas aumentar o tempo ocioso, a sobrecarga de inicialização, as tarefas com falha, o desperdício de armazenamento ou a carga de engenharia, ele não é realmente mais barato.
Perguntas frequentes
Quais são algumas alternativas ao RunPod?
Alternativas comuns ao RunPod incluem Lambda Cloud, CoreWeave, Crusoe Cloud, Massed Compute, Nebius AI Cloud, Hyperstack, Vultr Cloud GPU, Vast.ai, TensorDock, Replicate, Together AI, AWS, Google Cloud, Azure e roteadores de API de modelo como o Flatkey. A escolha certa depende de você precisar de pods, endpoints serverless, clusters dedicados, marketplaces ou acesso a modelos via API.
Qual é a melhor alternativa ao RunPod para ComfyUI?
Para experimentos com ComfyUI, Vast.ai, TensorDock, Hyperstack, Lambda e clouds de GPU no estilo do Paperspace são pré-seleções comuns. Compare armazenamento persistente, cache de pesos de modelos, tempo de inicialização, gerenciamento de nós personalizados, desligamento por inatividade, transferência de saída e confiabilidade do host antes de comparar as tarifas horárias de GPU.
As alternativas ao RunPod são mais baratas?
Às vezes, mas apenas depois de calcular o custo efetivo por saída aceita. Uma tarifa horária de GPU mais baixa pode sair perdendo se a workload passar mais tempo baixando modelos, ociosa, refazendo tarefas com falha ou movendo dados. Compare imagens, tokens, vídeos ou trabalhos concluídos, e não apenas horas de GPU.
Devo usar Replicate ou Together AI em vez do RunPod?
Use Replicate ou Together AI quando quiser endpoints de modelo gerenciados e não precisar de controle de baixo nível sobre a GPU. Use clouds de GPU no estilo RunPod quando precisar de contêineres personalizados, fluxos de trabalho personalizados, acesso direto à GPU ou controle sobre a pilha de serving.
Quando devo usar o Flatkey em vez de alugar GPUs?
Use Flatkey when your team needs official model APIs, roteamento multi-modelo, uma chave, um saldo, registros de uso, fallback e controles de orçamento. Alugue GPUs quando pesos personalizados, kernels personalizados, colocação privada ou alta utilização estável tornem o controle direto da infraestrutura valioso o suficiente para justificar o custo operacional.


