
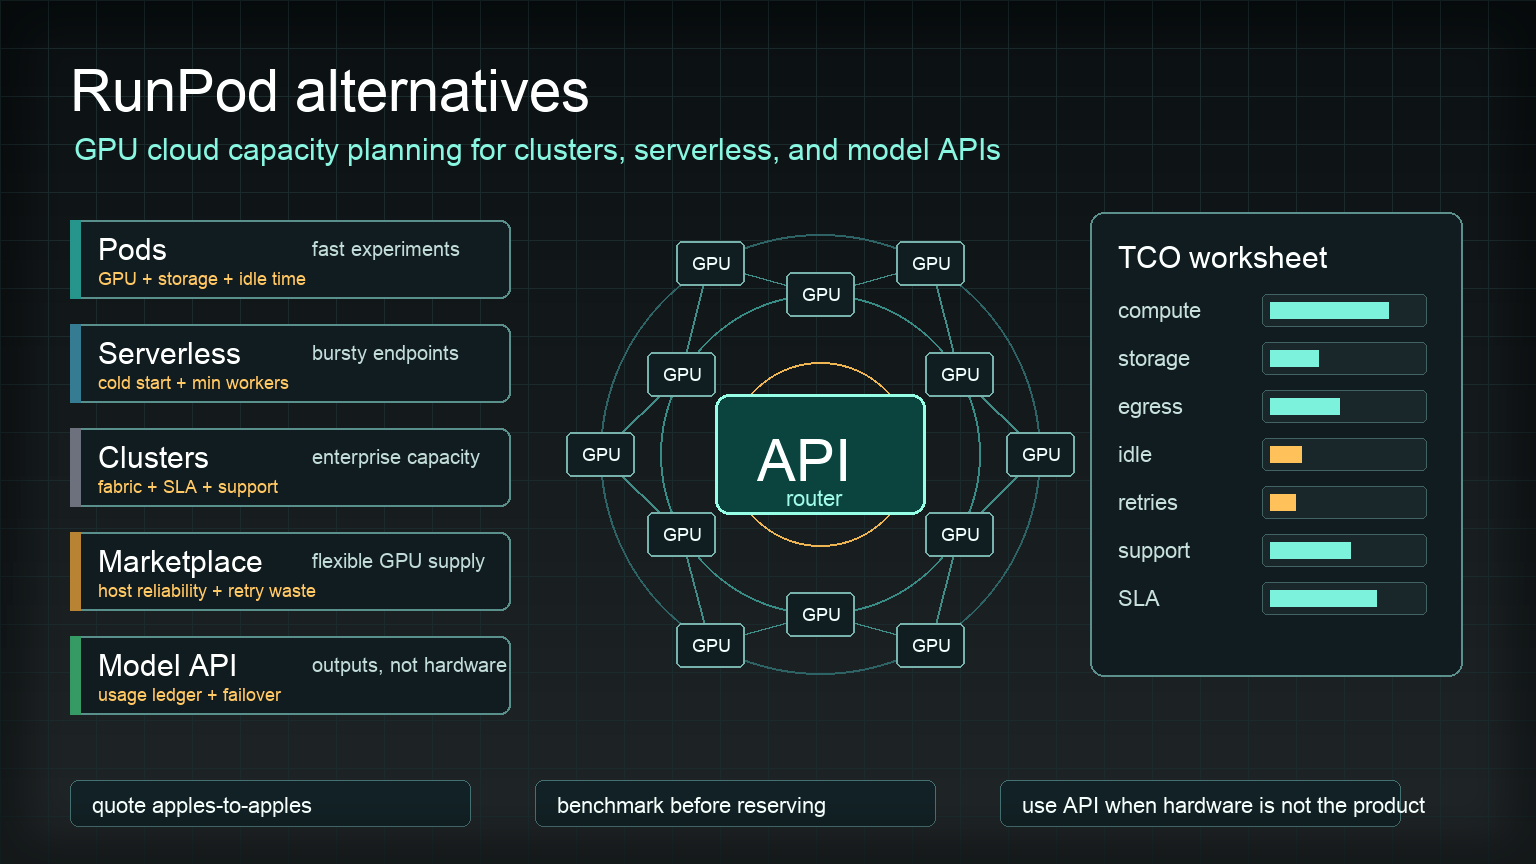
Alternatif RunPod biasanya mulai dibahas setelah prototipe pertama berhasil. Seorang developer membuat workflow ComfyUI, fine-tune, skrip batch inference, atau endpoint vLLM berjalan di RunPod; lalu tim mengajukan pertanyaan yang lebih sulit: apakah ini bisa menjadi kapasitas produksi dengan biaya, dukungan, penyimpanan, jaringan, keamanan, dan ketentuan pengadaan yang dapat diprediksi?
Jawabannya bergantung pada apa yang Anda ganti. Pod RunPod, endpoint RunPod Serverless, instans GPU aman, GPU komunitas, dan pembahasan kapasitas enterprise adalah gerakan pembelian yang berbeda. Alternatif RunPod yang tepat untuk batch ComfyUI di akhir pekan tidak sama dengan alternatif yang tepat untuk klaster H100 privat, job training multi-node, atau layanan inference yang dihadapi pelanggan.
Panduan ini membandingkan alternatif RunPod untuk developer dan tim AI kecil hingga menengah yang membutuhkan lebih dari sekadar jam GPU murah. Panduan ini mencakup penyedia cloud GPU, marketplace, hyperscaler, platform inference terkelola, dan rute API model, lalu memberi Anda lembar kerja untuk membandingkan total cost of ownership alih-alih tarif per jam yang ditampilkan di depan. Jika Anda perlu memahami model harga yang lebih luas terlebih dahulu, mulailah dengan panduan Flatkey tentang harga sewa GPU.
Jawaban singkat: alternatif RunPod terbaik berdasarkan beban kerja
Gunakan tabel ini untuk menyusun daftar awal. Anggap ini sebagai peta keputusan, bukan peringkat universal.
| Beban kerja | Alternatif RunPod kuat untuk dievaluasi | Mengapa cocok | Yang perlu diverifikasi sebelum berpindah |
|---|---|---|---|
| Eksperimen ComfyUI dan batch gambar | Vast.ai, TensorDock, Hyperstack, Paperspace/DigitalOcean, RunPod Community Cloud jika tetap bertahan | Akses GPU cepat, ekonomi marketplace atau self-serve, cocok untuk pekerjaan batch yang fleksibel | Penyimpanan persisten, waktu startup, keandalan host, bandwidth, alur kerja restart, apakah GPU cocok untuk data produksi |
| Inference node tunggal yang stabil | Lambda Cloud, Hyperstack, Massed Compute, Nebius, Vultr, AWS/GCP/Azure GPU VM | Model instans yang lebih bersih, jalur pengadaan yang lebih luas, kontrol infrastruktur yang lebih dapat diprediksi | Ketersediaan GPU, region, dukungan, biaya disk/jaringan, kuota, observabilitas, autoscaling |
| Klaster GPU khusus | Lambda reserved clusters, CoreWeave, Crusoe Cloud, Massed Compute, Nebius, AWS Capacity Blocks, reservasi Google Cloud, Azure seri ND | Lebih cocok untuk kapasitas terikat, dukungan, jaringan privat, dan perencanaan klaster multi-node | Fabric jaringan, jaminan penempatan, SLA dukungan, jangka waktu kontrak, jalur upgrade, titik impas utilisasi |
| Endpoint inference serverless | Replicate, endpoint dedicated Together AI, platform bergaya Modal, fungsi cloud dengan dukungan GPU, RunPod Serverless jika tetap bertahan | Cocok ketika Anda membutuhkan perilaku inference yang sudah dideploy lebih dari sekadar kontrol VM mentah | Cold start, worker minimum, harga per permintaan, batasan packaging model, log, kebijakan data |
| Penggunaan model frontier atau API multi-model | Flatkey, router bergaya OpenRouter, API model first-party | Menghindari operasi GPU ketika nilainya ada pada output, bukan kontrol perangkat keras | Ketersediaan model, endpoint resmi, perilaku fallback, ledger penggunaan, kontrol anggaran, kebijakan data |
Untuk sebagian besar tim, alternatif RunPod terbaik bukanlah satu penyedia. Melainkan arsitektur terpisah:
- Gunakan GPU marketplace untuk eksperimen dan batch media yang meledak-ledak.
- Gunakan cloud GPU spesialis atau hyperscaler untuk kapasitas produksi yang stabil.
- Gunakan API/router model ketika produk tidak memerlukan kontrol langsung atas bobot, kernel, atau penempatan GPU.
Pemisahan itu mencegah satu beban kerja memaksakan model infrastruktur yang salah ke semua beban kerja lainnya.
Kapan RunPod masih menjadi pilihan yang baik
Ini bukan artikel "RunPod buruk". RunPod populer karena memangkas waktu penyiapan. Developer dapat meluncurkan pod GPU, menjalankan notebook dan container, bereksperimen dengan kapasitas komunitas atau aman, dan menggunakan endpoint serverless tanpa memulai dari proses pengadaan hyperscaler.
RunPod sering kali masih cocok ketika:
- Anda membutuhkan akses GPU cepat untuk eksperimen.
- Anda sedang menguji ComfyUI, Stable Diffusion, alur kerja LoRA, atau pembuatan media batch.
- Anda menginginkan pengembangan berbasis pod yang sederhana sebelum merancang klaster produksi.
- Anda dapat mentoleransi sedikit variasi infrastruktur saat masih dalam tahap eksplorasi.
- Beban kerja Anda dapat di-restart atau dibangun ulang tanpa insiden pelanggan yang serius.
Perpindahan biasanya layak dievaluasi ketika beban kerja menjadi mahal, terus-menerus, sensitif terhadap keamanan, sensitif terhadap latensi, atau terlihat dalam pengadaan. Pada titik itu, Anda harus membandingkan alternatif RunPod berdasarkan kecocokan beban kerja, bukan keakraban merek.
Kerangka perbandingan alternatif RunPod
Mulailah dengan formula terstandarisasi ini:
biaya efektif per beban kerja yang diterima =
  komputasi
  + penyimpanan
  + snapshot
  + bandwidth dan egress
  + waktu idle
  + cold start
  + job gagal dan retry
  + dukungan
  + overhead engineering
  / token, job, gambar, video, fine-tune, atau permintaan pelanggan yang diterima
Lalu ajukan enam pertanyaan sebelum membandingkan penyedia.
| Pertanyaan | Mengapa ini mengubah jawabannya |
|---|---|
| Apakah Anda membutuhkan kontrol GPU atau hanya output AI? | Jika Anda hanya memerlukan teks, gambar, embedding, atau transkripsi yang dihasilkan, rute API bisa lebih murah secara operasional daripada menyewa GPU. |
| Apakah bebannya interaktif atau batch? | Inferensi interaktif membutuhkan latensi p95/p99 dan ketersediaan. Pekerjaan batch dapat menukar waktu antre untuk biaya yang lebih rendah. |
| Apakah pekerjaan dapat diinterupsi? | Kapasitas marketplace dan spot-style dapat bekerja untuk pekerjaan yang checkpointed; tetapi bisa berbahaya untuk pekerjaan jangka panjang yang stateful. |
| Apakah model muat di satu GPU? | Beban kerja multi-GPU dan multi-node menambah risiko topologi, jaringan, scheduler, dan placement. |
| Apakah utilisasi dapat diprediksi? | Kapasitas reserved atau dedicated membutuhkan utilisasi baseline yang cukup untuk mengalahkan on-demand. |
| Siapa yang mengelola operasional? | Driver GPU, image CUDA, vLLM/SGLang, pembersihan storage, observabilitas, dan respons insiden adalah bagian dari biaya sebenarnya. |
Di sinilah banyak perbandingan alternatif RunPod menjadi dangkal. Daftar penyedia saja tidak cukup. Anda membutuhkan model pengadaan. Untuk kapasitas multi-node, padukan artikel ini dengan daftar periksa sewa klaster GPU.
Alternatif cloud GPU untuk RunPod
Lambda Cloud
Lambda Cloud adalah salah satu alternatif RunPod yang paling jelas ketika Anda menginginkan cloud GPU spesialis dengan opsi instance GPU yang dipublikasikan dan alur pembelian infrastruktur yang lebih konvensional. Ini layak dievaluasi untuk H100, H200, B200, A100, dan kapasitas NVIDIA lainnya ketika beban kerja Anda bergerak dari eksperimen menuju pelatihan atau inferensi yang berulang.
Gunakan Lambda ketika Anda menginginkan:
- Instance cloud GPU yang sederhana.
- Penyedia infrastruktur AI spesialis, bukan hyperscaler umum.
- Jalur dari eksperimen on-demand menuju kapasitas reserved atau committed.
- Baris sumber yang dapat cepat dipahami oleh tim procurement.
Verifikasi ketersediaan instance saat ini, varian GPU yang tepat, penyimpanan lokal, wilayah, dukungan, dan apakah penawarannya bersifat on-demand, reserved, atau berorientasi klaster. Gunakan halaman resmi Lambda GPU Cloud sebagai titik pemeriksaan sumber, lalu minta penawaran jika Anda memerlukan kapasitas dedicated. Untuk trade-off keluarga GPU, lihat panduan Flatkey tentang GPU terbaik untuk inferensi LLM.
CoreWeave
CoreWeave adalah alternatif RunPod yang kuat untuk tim yang telah melampaui satu pod dan membutuhkan kapasitas cloud GPU dalam skala besar. Ini lebih relevan untuk beban kerja AI produksi, lingkungan dedicated, dan pengadaan GPU enterprise daripada eksperimen hobi satu kali.
Evaluasi CoreWeave ketika:
- Anda membutuhkan infrastruktur GPU produksi alih-alih pod dev sederhana.
- Anda peduli pada operasi native Kubernetes, storage, jaringan, dan dukungan.
- Anda merencanakan inferensi berkelanjutan, pelatihan, atau kapasitas media AI.
- Anda memerlukan pembicaraan dengan penyedia tentang kapasitas committed dan ketentuan enterprise.
Trade-off-nya adalah CoreWeave biasanya bukan jalur paling ringan untuk eksperimen kecil. Ini layak masuk shortlist ketika perencanaan kapasitas, dukungan, dan keandalan produksi lebih penting daripada pod pertama secepat mungkin.
Crusoe Cloud
Crusoe Cloud layak dibandingkan untuk tim AI yang menginginkan infrastruktur GPU dedicated atau skalabel dengan pengadaan enterprise dan posisi yang berorientasi keberlanjutan. Ini sering masuk shortlist yang sama dengan Lambda, CoreWeave, Nebius, dan Massed Compute untuk percakapan kapasitas.
Gunakan Crusoe sebagai alternatif RunPod ketika:
- Anda meminta kapasitas klaster, bukan sewa GPU satu kali.
- Anda memerlukan penawaran penyedia dengan dukungan, wilayah, dan ketentuan kapasitas.
- Anda menginginkan percakapan cloud spesialis alih-alih proses kuota hyperscaler.
Periksa model GPU yang tepat, interconnect, storage, cakupan dukungan, dan apakah beban kerja Anda memerlukan Kubernetes yang dikelola sendiri, Slurm, atau lingkungan terkelola.
Massed Compute
Massed Compute adalah titik perbandingan yang berguna bagi pembeli yang menginginkan harga GPU yang dipublikasikan plus jalur menuju kapasitas reserved atau dedicated. Ini adalah alternatif RunPod yang praktis untuk tim yang membutuhkan ekonomi cloud GPU sederhana tetapi mulai mengajukan pertanyaan enterprise.
Evaluasi Massed Compute ketika:
- Anda membutuhkan kapasitas gaya H100/A100/L40S dengan titik awal publik yang jelas.
- Anda ingin membandingkan tarif GPU on-demand dengan komitmen jangka panjang.
- Anda sedang menyusun lembar kerja pengadaan untuk klaster dedicated atau baseline inference pool.
Gunakan halaman harga Massed Compute resmi sebagai baris sumber langsung, lalu tanyakan apa saja yang termasuk dalam dukungan, jaringan, storage, dan ketentuan reserved.
Nebius AI Cloud
Nebius adalah alternatif RunPod yang kredibel ketika pembeli menginginkan cloud native AI dengan layanan infrastruktur terkelola di sekitar GPU, bukan sekadar server mentah. Ini sangat relevan ketika tim Anda menginginkan platform cloud untuk pelatihan model, inferensi, data, dan orkestrasi, bukan instance terisolasi.
Evaluasi Nebius ketika:
- Anda membutuhkan lingkungan cloud AI yang lebih luas.
- Anda peduli pada Kubernetes, layanan terkelola, storage, dan jaringan di sekitar beban kerja GPU.
- Anda menginginkan alternatif di luar shortlist default hyperscaler AS.
Untuk TCO, konfirmasikan ketersediaan wilayah, dukungan, egress storage, kuota, mekanisme reservasi, dan ketersediaan generasi GPU.
Hyperstack
Hyperstack adalah alternatif langsung RunPod untuk tim yang membandingkan penyedia cloud GPU berdasarkan jenis instans, biaya per jam, dan deployment self-serve. Ini berguna untuk akses cepat ke instans GPU NVIDIA tanpa harus berurusan dengan platform cloud besar.
Gunakan Hyperstack ketika:
- Anda menginginkan penyedia cloud GPU yang sederhana untuk eksperimen, inferensi, atau batch job.
- Anda membandingkan ketersediaan H100, H200, A100, L40S, kelas RTX, atau GPU yang lebih baru.
- Anda memerlukan checkpoint harga publik sebelum menghubungi tim sales.
Gunakan halaman resmi harga GPU Hyperstack sebagai checkpoint sumber. Tetap verifikasi storage, bandwidth, ekspektasi uptime, dukungan, dan apakah GPU/wilayah yang Anda butuhkan tersedia saat job dimulai.
Vultr Cloud GPU
Vultr layak masuk daftar alternatif RunPod ketika tim Anda menginginkan penyedia cloud yang familiar dengan opsi GPU, region global, dan pengemasan infrastruktur yang lebih sederhana dibandingkan marketplace GPU murni. Ini bisa menarik bagi tim yang sudah menggunakan VM cloud dan menginginkan kapasitas GPU tanpa mengadopsi model operasional baru.
Evaluasi Vultr ketika:
- Workload Anda lebih dekat ke VM konvensional daripada klaster yang kompleks.
- Anda memerlukan infrastruktur cloud global plus akselerasi GPU.
- Anda menginginkan penyedia yang cocok dengan pola operasi cloud yang sudah ada.
Periksa kuota, keluarga GPU, region, persistent storage, egress, dukungan, dan apakah workload memerlukan interkoneksi kelas atas yang tidak bisa disediakan oleh VM GPU sederhana.
Alternatif marketplace untuk RunPod
Vast.ai
Vast.ai adalah salah satu alternatif RunPod yang paling umum bagi developer yang mengejar pasokan GPU yang fleksibel dan biaya masuk yang rendah. Ini adalah sebuah marketplace, jadi perbandingan penyedia bukan hanya Vast.ai versus RunPod. Melainkan setiap host, GPU, lokasi, skor reliabilitas, disk, jaringan, dan profil gangguan versus workload Anda.
Vast.ai sering cocok untuk:
- Eksperimen ComfyUI.
- Generasi gambar batch.
- Job riset singkat.
- Pengujian inferensi yang fleksibel.
- Workload yang dapat checkpoint dan retry.
Platform ini lebih lemah untuk workload yang membutuhkan dukungan yang dapat diprediksi, kepatuhan, jaringan privat, atau uptime yang ketat untuk customer-facing. Gunakan halaman resmi harga Vast.ai sebagai checkpoint marketplace langsung, tetapi jangan pernah membandingkan hanya tarif GPU per jam.
TensorDock
TensorDock adalah alternatif RunPod bergaya marketplace lainnya. Halaman cloud GPU resminya menjelaskan marketplace host independen yang bersaing dan menetapkan harga, yang berarti pembeli harus mengevaluasi setiap opsi deployment alih-alih memperlakukan TensorDock sebagai cloud dengan tarif tetap tunggal.
TensorDock dapat berguna ketika:
- Anda menginginkan pilihan VM GPU yang fleksibel.
- Anda memerlukan opsi GPU kelas RTX atau data center untuk proyek singkat.
- Anda bisa menilai detail host, storage, bandwidth, dan reliabilitas sebelum peluncuran.
Gunakan halaman resmi cloud GPU TensorDock sebagai checkpoint sumber. Untuk produksi, tanyakan apakah kapasitas yang dipilih memiliki dukungan, isolasi, dan jaminan operasional yang dibutuhkan workload pelanggan Anda.
Alternatif hyperscaler untuk RunPod
AWS, Google Cloud, dan Azure tidak selalu merupakan alternatif RunPod yang lebih murah. Mereka sering kali merupakan alternatif yang lebih lengkap secara operasional.
AWS
AWS relevan ketika workload memerlukan identitas enterprise, jaringan, kepatuhan, pengadaan, dan integrasi dengan sistem AWS yang sudah ada. Untuk workload kelas H100, instans AWS P5 adalah checkpoint sumber utama, dan EC2 Capacity Blocks relevan ketika Anda memerlukan kapasitas ML yang dipesan untuk jangka waktu tertentu.
AWS dapat cocok ketika:
- Anda sudah menjalankan sistem data, keamanan, dan deployment di AWS.
- Anda memerlukan pengadaan dan dukungan enterprise.
- Anda membutuhkan model reservasi yang jelas untuk jendela pelatihan atau peluncuran.
- Anda bisa menangani kompleksitas cloud dan manajemen kuota.
Periksa instans AWS P5 dan EC2 Capacity Blocks for ML, lalu masukkan EBS, transfer data, dukungan, NAT, observabilitas, dan waktu engineering ke dalam TCO. Jika keputusan ini secara spesifik tentang kapasitas NVIDIA yang lebih lama versus yang lebih baru, gunakan perbandingan H100 vs A100 dan H200 vs H100 sebagai bacaan pendamping.
Google Cloud
Google Cloud adalah alternatif RunPod ketika tim Anda menginginkan machine family yang dioptimalkan untuk akselerator, kontrol enterprise, dan lingkungan cloud-native di sekitar data, jaringan, dan Kubernetes. Ini sangat relevan untuk organisasi yang sudah menggunakan infrastruktur data Google Cloud.
Gunakan Google Cloud ketika:
- Workload Anda memerlukan locality data cloud dengan BigQuery, GCS, GKE, atau Vertex AI.
- Anda memerlukan kontrol identitas, audit, dan pengadaan enterprise.
- Anda bisa merencanakan kuota, region, disk, dan harga jaringan.
Gunakan dokumentasi machine yang dioptimalkan untuk akselerator Google Cloud dan harga GPU Compute Engine sebagai checkpoint sumber. Normalisasi asumsi GPU, machine, disk, jaringan, dan committed-use sebelum membandingkannya dengan cloud GPU spesialis.
Azure
Azure adalah alternatif RunPod yang praktis untuk perusahaan yang sudah distandardisasi pada cloud, identitas, keamanan, procurement, atau sistem data Microsoft. Seri Azure ND H100 v5 adalah titik acuan utama sumber untuk workload bergaya klaster H100.
Gunakan Azure ketika:
- Perusahaan Anda sudah berbelanja melalui perjanjian Microsoft.
- Anda membutuhkan keamanan, kepatuhan, dan kontrol jaringan tingkat enterprise.
- Anda membutuhkan VM GPU yang terhubung ke infrastruktur data atau aplikasi Azure yang lebih luas.
Periksa seri Azure ND H100 v5, lalu validasi ketersediaan regional, kuota, kebutuhan InfiniBand, storage, dukungan, dan kompleksitas deployment.
Alternatif serverless dan managed inference
Tidak setiap alternatif RunPod harus berupa GPU sewaan. Jika tim Anda menginginkan endpoint, bukan mesin, managed inference dapat mengurangi banyak pekerjaan operasional.
Replicate
Replicate sangat cocok ketika tim ingin menjalankan model melalui API, mendeploy versi model, dan menghindari pengelolaan host GPU secara langsung. Ini sangat berguna untuk tim produk yang peduli merilis fitur berbasis model dengan cepat.
Replicate dapat cocok untuk:
- Inferensi model gambar, video, audio, dan open-source.
- Prototipe produk yang perlu API dengan cepat.
- Tim yang lebih memilih kemudahan deployment daripada kontrol GPU tingkat rendah.
Gunakan harga Replicate sebagai titik acuan sumber, lalu verifikasi opsi hardware, perilaku deployment, cold start, log, penanganan data, dan apakah workload membutuhkan custom kernel atau private networking.
Together AI
Together AI adalah alternatif RunPod ketika workload lebih dekat ke inferensi dan fine-tuning LLM daripada sewa VM GPU umum. Ini layak masuk shortlist untuk tim yang menginginkan managed inference, endpoint khusus, dan infrastruktur penyajian model tanpa mengoperasikan seluruh stack.
Together AI dapat cocok untuk:
- Endpoint inferensi LLM.
- Workflow fine-tuning dan evaluasi.
- Tim yang menginginkan infrastruktur penyajian model, bukan manajemen pod mentah.
Gunakan harga Together AI sebagai titik acuan harga langsung dan verifikasi apakah workload sebaiknya berada pada serverless inference, endpoint khusus, batch API, atau perjanjian enterprise kustom. Jika Anda akan self-host, bandingkan stack serving secara terpisah dengan vLLM vs SGLang.
Alternatif model API dan router
Alternatif RunPod yang paling sering terlewat adalah model API dan router. Jika produk Anda tidak memerlukan custom weights, custom kernel CUDA, penempatan GPU privat, atau kontrol serving tingkat rendah, menyewa GPU bisa menjadi abstraksi yang salah.
Positioning Flatkey berguna untuk keputusan ini: satu key, satu saldo, satu invoice, routing yang kompatibel dengan OpenAI, endpoint model resmi, ledger penggunaan, kontrol anggaran, dan jalur fallback di banyak model serta tools. Itu tidak menggantikan klaster GPU khusus saat Anda perlu memiliki stack serving. Namun itu menggantikan klaster ketika yang Anda butuhkan adalah output AI yang andal dengan pengeluaran yang dapat dilacak. Untuk budgeting di sisi model, bandingkan worksheet GPU dengan perbandingan harga model AI dan manajemen pengeluaran AI API.
Gunakan model API atau router ketika:
- Anda membutuhkan akses ke banyak model teks, gambar, atau video.
- Traffic bersifat bursty dan tidak membenarkan GPU yang dipesan.
- Pilihan model sering berubah.
- Anda tidak perlu mengelola weights, driver, CUDA, atau kernel serving.
- Visibilitas biaya, fallback, dan konsolidasi billing lebih penting daripada kontrol GPU mentah.
Gunakan GPU khusus ketika:
- Anda melayani weights privat atau kustom.
- Anda membutuhkan custom kernel, quantization, adapter, atau logika serving.
- Kepatuhan residensi data atau isolasi mengharuskan lingkungan Anda sendiri.
- Volume inferensi cukup stabil untuk membenarkan kapasitas komitmen.
- Anda memiliki staf untuk operasi GPU.
Itulah pertanyaan procurement intinya: apakah Anda membeli akses hardware atau output yang dapat diterima?
Alternatif RunPod untuk ComfyUI
Pencarian untuk runpod alternatives comfyui biasanya muncul dari masalah praktis: workflow berjalan, tetapi storage, waktu startup, versi image, dan repeatability mulai merepotkan.
Untuk ComfyUI, bandingkan opsi berikut:
| Opsi | Kecocokan terbaik | Hal yang perlu diawasi |
|---|---|---|
| Pod RunPod | Jalur yang sudah dikenal jika Anda sudah punya template dan volume | Pembersihan persistent volume, biaya idle, image drift |
| Vast.ai atau TensorDock | Pasokan GPU fleksibel untuk job gambar batch | Keandalan host, storage, bandwidth, restart |
| Hyperstack atau Lambda | Model instance cloud GPU yang lebih konvensional | Ketersediaan, biaya per jam, tanggung jawab setup |
| API gaya Replicate | Fitur produk yang membutuhkan output gambar melalui API | Kontrol workflow tingkat rendah yang lebih sedikit |
| Jalur Flatkey/model API | Eksperimen model gambar/video multi-provider | Bukan pengganti graph ComfyUI kustom yang memerlukan kontrol node langsung |
Untuk ComfyUI, jangan hanya membandingkan model GPU dan tarif per jam. Ukur juga:
- Waktu untuk menarik image dan bobot model.
- Biaya penyimpanan persisten.
- Apakah node kustom tetap bertahan setelah rebuild.
- Waktu idle setelah batch selesai.
- Biaya transfer output.
- Tingkat kegagalan akibat model yang hilang, image yang buruk, atau restart host.
- Apakah alur kerja memerlukan UI, endpoint API, atau antrean otomatis.
Alternatif RunPod terbaik untuk ComfyUI biasanya adalah yang mengurangi waktu rebuild dan penyimpanan yang terbengkalai, bukan yang memiliki biaya GPU per jam terendah yang terlihat.
Daftar periksa klaster GPU khusus
Jika alasan beralih adalah kapasitas enterprise, gunakan daftar periksa ini sebelum menandatangani term sheet.
| Persyaratan | Apa yang harus ditanyakan ke setiap penyedia |
|---|---|
| Bentuk GPU | Model GPU yang tepat, memori, PCIe/SXM/NVL, GPU per node, CPU, RAM, NVMe lokal |
| Jaringan | InfiniBand, RoCE, EFA, NVLink/NVSwitch, jaminan penempatan, oversubscription, bukti pengujian NCCL |
| Penyimpanan | Scratch lokal, shared filesystem, region object storage, throughput checkpoint, harga snapshot |
| Penjadwal | Kubernetes, Slurm, Ray, layanan terkelola, akses pengguna, kuota, shutdown saat idle |
| Keandalan | Kebijakan penggantian node, jendela pemeliharaan, eskalasi insiden, SLA, kebijakan retry |
| Keamanan | Isolasi tenant, log audit, penanganan secret, jaringan privat, penghapusan data |
| Kontrol biaya | Tag per tim, ekspor penggunaan, peringatan anggaran, deteksi idle, chargeback |
| Kontrak | Jangka minimum, minimum belanja, opsi burst, jalur upgrade, pembatalan, cakupan dukungan |
Jalankan setidaknya satu pengujian penerimaan sebelum kontrak menjadi sulit untuk dihentikan:
cluster acceptance test =
  deploy production container
  pull model weights and dataset
  run representative benchmark
  run NCCL all-reduce if multi-node
  write and restore checkpoint
  simulate one failed job
  export cost and utilization logs
Jika penyedia tidak dapat mendukung benchmark yang representatif, perlakukan itu sebagai risiko pembelian.
Replicate vs Together AI vs alternatif RunPod
Kueri replicate vs together ai vs runpod alternatives mencampur tiga kategori, jadi bandingkan berdasarkan tingkat abstraksinya.
| Jenis platform | Yang Anda kelola | Yang dikelola penyedia | Cocok untuk |
|---|---|---|---|
| Cloud GPU ala RunPod | Container, image, storage, lifecycle GPU, serving stack | Infrastruktur GPU dan primitive platform | Pengembang yang membutuhkan kontrol GPU langsung |
| Deployment model ala Replicate | Pengemasan model dan penggunaan API | Sebagian besar infrastruktur serving dan ergonomi deployment yang berhadapan dengan pengguna | Tim produk yang ingin meluncurkan endpoint model dengan cepat |
| Platform inferensi ala Together AI | Pemilihan model, pilihan endpoint, desain workload | Infrastruktur serving LLM dan operasi endpoint | Tim yang berfokus pada inferensi/fine-tuning LLM |
| Router model ala Flatkey | Panggilan API, anggaran, kebijakan routing model | Lapisan akses multi-model, penagihan terpadu, ledger penggunaan | Tim yang membutuhkan output model resmi, bukan kepemilikan GPU |
Jangan memilih item biaya yang paling murah. Pilih risiko operasional terendah untuk pekerjaan tersebut.
Lembar kerja perbandingan alternatif RunPod
Gunakan lembar kerja ini saat membandingkan penyedia cloud GPU.
| Bidang | Penyedia A | Penyedia B | Penyedia C |
|---|---|---|---|
| Mode produk | Pod / VM / serverless / klaster terpesan / API | ||
| Model GPU dan memori | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| Region atau host | |||
| Satuan penagihan | detik, menit, jam, bulanan, blok kapasitas | ||
| Komitmen minimum | tidak ada, bulanan, tahunan, blok terpesan | ||
| Biaya storage | volume, snapshot, object storage, NVMe lokal | ||
| Biaya jaringan | egress, private link, lintas region, IP publik | ||
| Overhead startup | pull image, unduh bobot, cold start | ||
| Tingkat idle | menit yang dapat ditagih tanpa pekerjaan yang berguna | ||
| Pengganda kegagalan/retry | eviction, OOM, host buruk, kegagalan cold-start | ||
| Dukungan | self-serve, tiket, dukungan khusus, SLA | ||
| Keamanan | isolasi tenant, log audit, secret, penghapusan | ||
| Satuan output yang diterima | 1M token, gambar, video, fine-tune, run pelatihan | ||
| Biaya efektif per output yang diterima | dihitung, bukan ditebak |
Kemudian hitung:
biaya efektif per jam =
  biaya GPU per jam
  + storage per jam
  + jaringan per jam
  + dukungan per jam
  + pemborosan idle
  + pemborosan retry
  + overhead engineering

biaya per output yang diterima =
  biaya efektif per jam / output yang diterima per jam
Ini juga cara Anda memutuskan apakah kapasitas khusus mengalahkan API. Jika biaya API per output yang diterima lebih rendah setelah Anda memasukkan operasi GPU, jangan sewa klaster hanya karena tarif GPU per jam terlihat menarik.
Daftar periksa sumber untuk harga terkini
Harga dan ketersediaan GPU sering berubah. Sebelum membuat keputusan pembelian, periksa ulang baris sumber dan catat tanggalnya. Untuk draf ini, daftar periksa sumber telah diverifikasi untuk ketersediaan halaman pada 12 Oktober 2026.
| Penyedia/kategori | Titik pemeriksaan sumber | Yang perlu dicatat |
|---|---|---|
| RunPod | Harga RunPod, Dokumentasi penyimpanan pod RunPod | Mode pod, mode serverless, kapasitas aman/komunitas, penyimpanan, volume jaringan, asumsi idle |
| Lambda | Lambda GPU Cloud | Model GPU, bentuk instance, ketersediaan, ketentuan reserved atau cluster |
| Vast.ai | Harga Vast.ai | Host, keandalan, GPU, penyimpanan, bandwidth, ketentuan marketplace |
| Massed Compute | Harga Massed Compute | Tarif on-demand, jalur reservasi, dukungan, dan ketentuan cluster |
| Hyperstack | Harga GPU Hyperstack | SKU GPU, region, penyimpanan, jaringan, dukungan |
| TensorDock | Cloud GPU TensorDock | Host marketplace, GPU, RAM/vCPU, penyimpanan, harga saat deploy |
| Replicate | Harga Replicate | Harga deployment, perangkat keras, cold start, log, kebijakan data |
| Together AI | Harga Together AI | Serverless, endpoint khusus, fine-tuning, ekonomi batch |
| AWS | Instance EC2 P5, EC2 Capacity Blocks | Region, kuota, keluarga instance, jendela reservasi, EBS, transfer data, dukungan |
| Google Cloud | Mesin yang dioptimalkan untuk akselerator, Harga GPU | Keluarga mesin, harga GPU, disk, jaringan, diskon committed-use |
| Azure | Seri ND H100 v5 | Ukuran VM, region, kuota, InfiniBand, dukungan, penyimpanan |
Rekomendasi akhir
Jajaki alternatif RunPod berdasarkan model operasional:
- Gunakan marketplace seperti Vast.ai atau TensorDock untuk eksperimen fleksibel, batch ComfyUI, dan beban kerja yang toleran terhadap retry.
- Gunakan cloud GPU spesialis seperti Lambda, CoreWeave, Crusoe, Massed Compute, Nebius, Hyperstack, atau Vultr ketika Anda membutuhkan kapasitas GPU dan dukungan yang lebih dapat diprediksi.
- Gunakan hyperscaler ketika identitas enterprise, pengadaan, kepatuhan, dan gravitasi data cloud yang sudah ada lebih penting daripada kesederhanaan.
- Gunakan platform inferensi terkelola seperti Replicate atau Together AI ketika perilaku endpoint lebih penting daripada kontrol VM.
- Gunakan Flatkey atau router API model lainnya ketika Anda membutuhkan output model AI resmi, visibilitas penggunaan, fallback, dan penagihan terpadu, bukan kepemilikan GPU langsung.
Alternatif RunPod terbaik adalah yang mengurangi biaya dari pekerjaan yang diterima. Jika penyedia memberi Anda jam GPU yang lebih murah tetapi meningkatkan waktu idle, overhead startup, job yang gagal, pemborosan penyimpanan, atau beban engineering, sebenarnya itu tidak lebih murah.
Pertanyaan yang sering diajukan
Apa saja alternatif RunPod?
Alternatif RunPod yang umum mencakup Lambda Cloud, CoreWeave, Crusoe Cloud, Massed Compute, Nebius AI Cloud, Hyperstack, Vultr Cloud GPU, Vast.ai, TensorDock, Replicate, Together AI, AWS, Google Cloud, Azure, dan router API model seperti Flatkey. Pilihan yang tepat bergantung pada apakah Anda membutuhkan pod, endpoint serverless, cluster khusus, marketplace, atau akses model di level API.
Apa alternatif RunPod terbaik untuk ComfyUI?
Untuk eksperimen ComfyUI, Vast.ai, TensorDock, Hyperstack, Lambda, dan cloud GPU bergaya Paperspace adalah shortlist yang umum. Bandingkan penyimpanan persisten, caching bobot model, waktu startup, pengelolaan node kustom, shutdown saat idle, transfer output, dan keandalan host sebelum membandingkan tarif GPU per jam.
Apakah alternatif RunPod lebih murah?
Terkadang, tetapi hanya setelah Anda menghitung biaya efektif per output yang diterima. Tarif GPU per jam yang lebih rendah bisa kalah jika beban kerja menghabiskan lebih banyak waktu untuk menarik model, diam dalam keadaan idle, mengulangi job yang gagal, atau memindahkan data. Bandingkan gambar, token, video, atau job yang selesai, bukan hanya jam GPU.
Haruskah saya menggunakan Replicate atau Together AI alih-alih RunPod?
Gunakan Replicate atau Together AI ketika Anda menginginkan endpoint model terkelola dan tidak membutuhkan kontrol GPU tingkat rendah. Gunakan cloud GPU ala RunPod ketika Anda membutuhkan container kustom, workflow kustom, akses GPU langsung, atau kontrol atas stack serving.
Kapan saya harus menggunakan Flatkey alih-alih menyewa GPU?
Gunakan Flatkey saat tim Anda membutuhkan API model resmi, routing multi-model, satu kunci, satu saldo, buku besar penggunaan, fallback, dan kontrol anggaran. Sewa GPU saat bobot kustom, kernel kustom, penempatan privat, atau utilisasi tinggi yang stabil membuat kendali langsung atas infrastruktur layak dengan biaya operasionalnya.


