
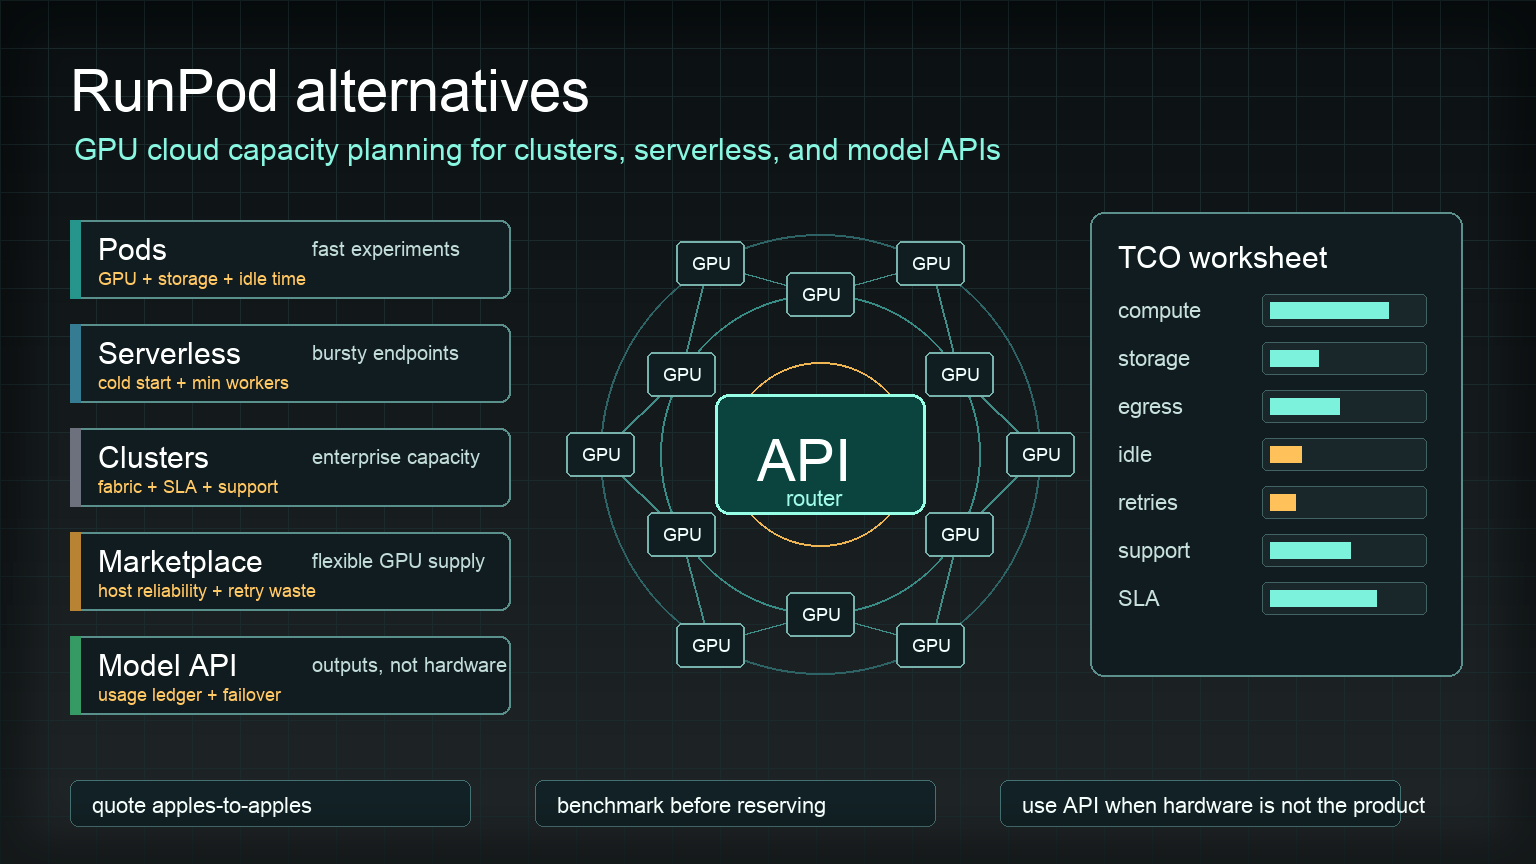
Các lựa chọn thay thế RunPod thường được cân nhắc sau khi nguyên mẫu đầu tiên thành công. Một nhà phát triển dựng được workflow ComfyUI, fine-tune, script suy luận hàng loạt, hoặc endpoint vLLM chạy trên RunPod; rồi nhóm sẽ đặt ra một câu hỏi khó hơn: liệu điều này có thể trở thành năng lực sản xuất với chi phí, hỗ trợ, lưu trữ, mạng, bảo mật và điều khoản mua sắm có thể dự đoán được không?
Câu trả lời phụ thuộc vào thứ bạn đang thay thế. Một pod RunPod, endpoint RunPod Serverless, GPU instance an toàn, GPU cộng đồng và cuộc thảo luận về năng lực doanh nghiệp là những mô hình mua sắm khác nhau. Các lựa chọn thay thế RunPod phù hợp cho một batch ComfyUI cuối tuần không giống với lựa chọn thay thế phù hợp cho một cụm H100 riêng tư, công việc huấn luyện multi-node, hay dịch vụ suy luận hướng tới khách hàng.
Hướng dẫn này so sánh các lựa chọn thay thế RunPod cho nhà phát triển và các nhóm AI nhỏ đến vừa cần nhiều hơn một giờ GPU giá rẻ. Nội dung bao gồm nhà cung cấp đám mây GPU, marketplace, hyperscaler, nền tảng suy luận được quản lý và các hướng API mô hình, sau đó cung cấp cho bạn một bảng tính để so sánh tổng chi phí sở hữu thay vì chỉ nhìn vào mức giá theo giờ. Nếu bạn cần mô hình định giá rộng hơn trước, hãy bắt đầu với hướng dẫn của Flatkey về giá thuê GPU.
Câu trả lời nhanh: các lựa chọn thay thế RunPod tốt nhất theo khối lượng công việc
Hãy dùng bảng này để xây dựng danh sách rút gọn ban đầu. Xem nó như một bản đồ quyết định, không phải một bảng xếp hạng phổ quát.
| Khối lượng công việc | Các lựa chọn thay thế RunPod mạnh để đánh giá | Vì sao chúng phù hợp | Cần xác minh gì trước khi chuyển đổi |
|---|---|---|---|
| Thử nghiệm ComfyUI và batch tạo ảnh | Vast.ai, TensorDock, Hyperstack, Paperspace/DigitalOcean, RunPod Community Cloud nếu tiếp tục dùng | Truy cập GPU nhanh, kinh tế theo mô hình marketplace hoặc tự phục vụ, phù hợp với công việc batch linh hoạt | Lưu trữ bền vững, thời gian khởi động, độ tin cậy của host, băng thông, quy trình khởi động lại, GPU có phù hợp với dữ liệu sản xuất hay không |
| Suy luận một nút ổn định | Lambda Cloud, Hyperstack, Massed Compute, Nebius, Vultr, AWS/GCP/Azure GPU VM | Mô hình instance rõ ràng hơn, nhiều đường mua sắm hơn, kiểm soát hạ tầng có tính dự đoán cao hơn | Khả dụng GPU, khu vực, hỗ trợ, chi phí ổ đĩa/mạng, quota, khả năng quan sát, autoscaling |
| Cụm GPU chuyên dụng | Lambda reserved clusters, CoreWeave, Crusoe Cloud, Massed Compute, Nebius, AWS Capacity Blocks, Google Cloud reservations, Azure ND-series | Phù hợp hơn với năng lực cam kết, hỗ trợ, mạng riêng và lập kế hoạch cụm multi-node | Fabric mạng, bảo đảm vị trí, SLA hỗ trợ, thời hạn hợp đồng, lộ trình nâng cấp, điểm hòa vốn sử dụng |
| Endpoint suy luận serverless | Replicate, Together AI dedicated endpoints, nền tảng kiểu Modal, cloud functions có hỗ trợ GPU, RunPod Serverless nếu tiếp tục dùng | Tốt khi bạn cần hành vi suy luận đã triển khai hơn là quyền kiểm soát VM thô | Thời gian cold start, worker tối thiểu, định giá theo yêu cầu, giới hạn đóng gói mô hình, log, chính sách dữ liệu |
| Sử dụng API mô hình frontier hoặc đa mô hình | Flatkey, bộ định tuyến kiểu OpenRouter, API mô hình chính chủ | Tránh vận hành GPU khi giá trị nằm ở đầu ra, không phải ở việc kiểm soát phần cứng | Khả dụng mô hình, endpoint chính thức, hành vi dự phòng, sổ ghi usage, kiểm soát ngân sách, chính sách dữ liệu |
Với đa số nhóm, các lựa chọn thay thế RunPod tốt nhất không phải là một nhà cung cấp duy nhất. Chúng là một kiến trúc phân tách:
- Dùng GPU marketplace cho thử nghiệm và các batch media tăng đột biến.
- Dùng một đám mây GPU chuyên biệt hoặc hyperscaler cho năng lực sản xuất ổn định.
- Dùng API/bộ định tuyến mô hình khi sản phẩm không cần kiểm soát trực tiếp weights, kernels, hay vị trí đặt GPU.
Sự phân tách đó ngăn một khối lượng công việc áp đặt sai mô hình hạ tầng lên mọi khối lượng công việc khác.
Khi RunPod vẫn là lựa chọn phù hợp
Đây không phải là bài viết "RunPod tệ". RunPod phổ biến vì nó rút ngắn thời gian thiết lập. Nhà phát triển có thể khởi chạy GPU pod, chạy notebook và container, thử nghiệm năng lực cộng đồng hoặc năng lực an toàn, và dùng endpoint serverless mà không phải bắt đầu từ quy trình mua sắm của hyperscaler.
RunPod thường vẫn phù hợp khi:
- Bạn cần truy cập GPU nhanh cho thử nghiệm.
- Bạn đang kiểm tra ComfyUI, Stable Diffusion, workflow LoRA hoặc tạo media batch.
- Bạn muốn phát triển theo kiểu pod đơn giản trước khi thiết kế cụm sản xuất.
- Bạn có thể chấp nhận một mức biến động hạ tầng nào đó trong lúc còn đang khám phá.
- Khối lượng công việc của bạn có thể khởi động lại hoặc dựng lại mà không gây sự cố nghiêm trọng cho khách hàng.
Việc chuyển đổi thường đáng cân nhắc khi khối lượng công việc trở nên đắt đỏ, liên tục, nhạy cảm về bảo mật, nhạy cảm về độ trễ, hoặc xuất hiện trong quy trình mua sắm. Lúc đó, bạn nên so sánh các lựa chọn thay thế RunPod theo mức độ phù hợp với khối lượng công việc, không phải theo mức độ quen thuộc với thương hiệu.
Khung so sánh các lựa chọn thay thế RunPod
Hãy bắt đầu với công thức chuẩn hóa này:
chi phí hiệu dụng trên mỗi khối lượng công việc được chấp nhận =
  compute
  + lưu trữ
  + snapshot
  + băng thông và egress
  + thời gian nhàn rỗi
  + cold start
  + job thất bại và retry
  + hỗ trợ
  + chi phí kỹ thuật vận hành
  / token, job, ảnh, video, fine-tune hoặc yêu cầu khách hàng được chấp nhận
Sau đó, hãy đặt sáu câu hỏi trước khi so sánh các nhà cung cấp.
| Câu hỏi | Tại sao điều đó làm thay đổi câu trả lời |
|---|---|
| Bạn cần quyền kiểm soát GPU hay chỉ cần đầu ra AI? | Nếu bạn chỉ cần văn bản, hình ảnh, embedding hoặc bản ghi chép được tạo ra, một lộ trình API có thể rẻ hơn về mặt vận hành so với việc thuê GPU. |
| Khối lượng công việc là tương tác hay theo lô? | Suy luận tương tác cần độ trễ p95/p99 và tính sẵn sàng. Các tác vụ theo lô có thể đánh đổi thời gian chờ để lấy chi phí thấp hơn. |
| Công việc có thể bị gián đoạn không? | Năng lực theo kiểu marketplace và spot có thể hoạt động với các tác vụ có checkpoint; nhưng chúng có thể rất rủi ro với các công việc dài, có trạng thái. |
| Mô hình có vừa với một GPU không? | Khối lượng công việc nhiều GPU và nhiều node làm tăng rủi ro về topology, mạng, bộ lập lịch và phân bổ. |
| Mức sử dụng có thể dự đoán được không? | Năng lực dành riêng hoặc được đặt trước cần mức sử dụng nền đủ cao để tốt hơn so với on-demand. |
| Ai chịu trách nhiệm vận hành? | Driver GPU, ảnh CUDA, vLLM/SGLang, dọn dẹp lưu trữ, khả năng quan sát và phản ứng sự cố đều là một phần của chi phí thực tế. |
Đây là nơi nhiều so sánh về các lựa chọn thay thế RunPod trở nên hời hợt. Một danh sách nhà cung cấp là chưa đủ. Bạn cần một mô hình mua sắm. Với năng lực nhiều node, hãy kết hợp bài viết này với checklist thuê cụm GPU.
Các lựa chọn thay thế cloud GPU cho RunPod
Lambda Cloud
Lambda Cloud là một trong những lựa chọn thay thế RunPod rõ ràng nhất khi bạn muốn một cloud GPU chuyên biệt với các tùy chọn phiên bản GPU được công bố và một quy trình mua hạ tầng truyền thống hơn. Đáng để đánh giá cho H100, H200, B200, A100 và các năng lực NVIDIA khác khi khối lượng công việc của bạn đang chuyển từ thử nghiệm sang huấn luyện hoặc suy luận lặp lại.
Hãy dùng Lambda khi bạn muốn:
- Các phiên bản cloud GPU đơn giản.
- Một nhà cung cấp hạ tầng AI chuyên biệt thay vì một hyperscaler đa ngành.
- Con đường từ thử nghiệm on-demand sang năng lực được đặt trước hoặc cam kết.
- Một dòng nguồn mà bộ phận mua sắm có thể hiểu nhanh.
Hãy kiểm tra tình trạng sẵn có của phiên bản hiện tại, biến thể GPU chính xác, bộ nhớ cục bộ, khu vực, hỗ trợ, và việc báo giá là on-demand, reserved hay định hướng theo cụm. Sử dụng trang chính thức Lambda GPU Cloud làm mốc nguồn, sau đó yêu cầu báo giá nếu bạn cần năng lực dành riêng. Với các đánh đổi giữa các dòng GPU, xem hướng dẫn GPU tốt nhất cho suy luận LLM của Flatkey.
CoreWeave
CoreWeave là một lựa chọn thay thế RunPod mạnh mẽ cho các nhóm đã vượt ra khỏi một pod đơn lẻ và cần năng lực cloud GPU ở quy mô lớn. Nó phù hợp hơn cho khối lượng công việc AI sản xuất, môi trường dành riêng và mua sắm GPU cho doanh nghiệp hơn là cho các thử nghiệm cá nhân một lần.
Hãy đánh giá CoreWeave khi:
- Bạn cần hạ tầng GPU sản xuất thay vì một pod dev đơn giản.
- Bạn quan tâm đến vận hành native Kubernetes, lưu trữ, mạng và hỗ trợ.
- Bạn đang lên kế hoạch cho năng lực suy luận, huấn luyện hoặc media AI bền vững.
- Bạn cần trao đổi với nhà cung cấp về năng lực cam kết và các điều khoản doanh nghiệp.
Điểm đánh đổi là CoreWeave thường không phải là con đường nhẹ nhất cho một thử nghiệm nhỏ. Nó phù hợp trong danh sách rút gọn khi lập kế hoạch năng lực, hỗ trợ và độ tin cậy sản xuất quan trọng hơn việc có pod đầu tiên nhanh nhất.
Crusoe Cloud
Crusoe Cloud đáng để so sánh cho các nhóm AI muốn hạ tầng GPU dành riêng hoặc có thể mở rộng với việc mua sắm theo doanh nghiệp và định vị hướng tới tính bền vững. Nó thường nằm trong cùng danh sách rút gọn với Lambda, CoreWeave, Nebius và Massed Compute trong các cuộc trao đổi về năng lực.
Hãy dùng Crusoe như một lựa chọn thay thế RunPod khi:
- Bạn đang hỏi về năng lực cụm thay vì thuê GPU một lần.
- Bạn cần báo giá từ nhà cung cấp với các điều khoản về hỗ trợ, khu vực và năng lực.
- Bạn muốn một cuộc trao đổi về cloud chuyên biệt thay vì quy trình quota của hyperscaler.
Hãy kiểm tra mô hình GPU chính xác, interconnect, lưu trữ, phạm vi hỗ trợ, và liệu khối lượng công việc của bạn có cần Kubernetes tự quản, Slurm hay một môi trường được quản lý hay không.
Massed Compute
Massed Compute là một điểm so sánh hữu ích cho người mua muốn có giá GPU được công bố cùng với con đường tiến tới năng lực được đặt trước hoặc dành riêng. Đây là một lựa chọn thay thế RunPod thực tế cho các nhóm cần kinh tế cloud GPU đơn giản nhưng đang bắt đầu đặt ra các câu hỏi ở cấp doanh nghiệp.
Hãy đánh giá Massed Compute khi:
- Bạn cần năng lực kiểu H100/A100/L40S với một điểm khởi đầu công khai rõ ràng.
- Bạn muốn so sánh giá GPU on-demand với các cam kết dài hạn hơn.
- Bạn đang xây dựng bảng tính mua sắm cho một cụm dành riêng hoặc một pool suy luận nền tảng.
Hãy dùng trang bảng giá Massed Compute chính thức như một dòng nguồn trực tiếp, rồi hỏi xem hỗ trợ, mạng, lưu trữ và các điều khoản reserved bao gồm những gì.
Nebius AI Cloud
Nebius là một lựa chọn thay thế RunPod đáng tin cậy khi người mua muốn một cloud gốc AI với các dịch vụ hạ tầng được quản lý xung quanh GPU, chứ không chỉ là máy chủ thô. Nó đặc biệt phù hợp khi nhóm của bạn muốn một nền tảng cloud cho huấn luyện mô hình, suy luận, dữ liệu và điều phối thay vì các phiên bản rời rạc.
Hãy đánh giá Nebius khi:
- Bạn cần một môi trường cloud AI rộng hơn.
- Bạn quan tâm đến Kubernetes, dịch vụ được quản lý, lưu trữ và mạng xung quanh khối lượng công việc GPU.
- Bạn muốn các lựa chọn thay thế ngoài danh sách rút gọn mặc định của hyperscaler tại Mỹ.
Về TCO, hãy xác nhận khả dụng theo khu vực, hỗ trợ, lưu trữ, lưu lượng ra mạng, quota, cơ chế đặt trước và khả dụng của thế hệ GPU.
Hyperstack
Hyperstack là một lựa chọn thay thế trực tiếp cho RunPod dành cho các nhóm đang so sánh các nhà cung cấp đám mây GPU theo loại phiên bản, chi phí theo giờ và triển khai tự phục vụ. Nó hữu ích để truy cập nhanh vào các phiên bản GPU NVIDIA mà không phải gánh một nền tảng đám mây lớn.
Hãy dùng Hyperstack khi:
- Bạn muốn một nhà cung cấp đám mây GPU đơn giản cho thử nghiệm, suy luận hoặc các công việc batch.
- Bạn đang so sánh mức độ sẵn có của H100, H200, A100, L40S, dòng RTX hoặc các GPU mới hơn.
- Bạn cần một mốc giá công khai trước khi làm việc với bộ phận kinh doanh.
Hãy dùng trang giá GPU của Hyperstack chính thức làm mốc tham chiếu nguồn. Tuy nhiên, vẫn cần xác minh lưu trữ, băng thông, kỳ vọng về thời gian hoạt động, hỗ trợ và liệu GPU/khu vực chính xác của bạn có sẵn khi công việc bắt đầu hay không.
Vultr Cloud GPU
Vultr xứng đáng có mặt trong danh sách các lựa chọn thay thế RunPod khi nhóm của bạn muốn một nhà cung cấp đám mây quen thuộc với các tùy chọn GPU, khu vực toàn cầu và cách đóng gói hạ tầng đơn giản hơn so với một thị trường GPU thuần túy. Nó có thể hấp dẫn với các nhóm vốn đã dùng máy ảo đám mây và muốn có năng lực GPU mà không cần áp dụng một mô hình vận hành mới.
Hãy đánh giá Vultr khi:
- Khối lượng công việc của bạn gần với một VM truyền thống hơn là một cụm phức tạp.
- Bạn cần hạ tầng đám mây toàn cầu cùng tăng tốc GPU.
- Bạn muốn một nhà cung cấp phù hợp với các mẫu vận hành đám mây hiện có.
Kiểm tra hạn mức, họ GPU, khu vực, lưu trữ bền vững, lưu lượng ra ngoài, hỗ trợ và liệu khối lượng công việc có cần liên kết nội bộ cao cấp mà một VM GPU đơn giản không thể cung cấp hay không.
Các lựa chọn thay thế RunPod dạng marketplace
Vast.ai
Vast.ai là một trong những lựa chọn thay thế RunPod phổ biến nhất cho các nhà phát triển tìm kiếm nguồn cung GPU linh hoạt và chi phí khởi điểm thấp. Đây là một marketplace, vì vậy việc so sánh nhà cung cấp không chỉ là Vast.ai so với RunPod. Mà là từng host, GPU, vị trí, điểm độ tin cậy, ổ đĩa, mạng và hồ sơ gián đoạn so với khối lượng công việc của bạn.
Vast.ai thường phù hợp với:
- Thử nghiệm ComfyUI.
- Tạo ảnh hàng loạt.
- Các công việc nghiên cứu ngắn.
- Kiểm thử suy luận linh hoạt.
- Các khối lượng công việc có thể checkpoint và thử lại.
Nó kém phù hợp hơn với các khối lượng công việc cần hỗ trợ có thể dự đoán, tuân thủ, mạng riêng, hoặc thời gian hoạt động nghiêm ngặt phục vụ khách hàng. Hãy dùng trang giá của Vast.ai chính thức như một mốc tham chiếu marketplace trực tiếp, nhưng đừng bao giờ chỉ so sánh mức giá GPU theo giờ.
TensorDock
TensorDock là một lựa chọn thay thế RunPod theo kiểu marketplace khác. Trang GPU cloud chính thức của họ mô tả một marketplace gồm các host độc lập cạnh tranh và tự đặt giá, nghĩa là người mua nên đánh giá từng tùy chọn triển khai thay vì xem TensorDock như một đám mây có mức giá cố định duy nhất.
TensorDock có thể hữu ích khi:
- Bạn muốn các lựa chọn VM GPU linh hoạt.
- Bạn cần các tùy chọn GPU dòng RTX hoặc GPU trung tâm dữ liệu cho các dự án ngắn hạn.
- Bạn có thể đánh giá chi tiết host, lưu trữ, băng thông và độ tin cậy trước khi triển khai.
Hãy dùng trang GPU cloud của TensorDock chính thức làm mốc tham chiếu nguồn. Với môi trường production, hãy hỏi xem năng lực được chọn có mức hỗ trợ, cách ly và các đảm bảo vận hành mà khối lượng công việc khách hàng của bạn cần hay không.
Các lựa chọn thay thế RunPod từ hyperscaler
AWS, Google Cloud và Azure không phải lúc nào cũng là các lựa chọn thay thế RunPod rẻ hơn. Chúng thường là các lựa chọn thay thế hoàn chỉnh hơn về mặt vận hành.
AWS
AWS phù hợp khi khối lượng công việc cần nhận dạng doanh nghiệp, mạng, tuân thủ, mua sắm và tích hợp với các hệ thống AWS hiện có. Với các khối lượng công việc H100, các phiên bản AWS P5 là mốc tham chiếu nguồn chính, và EC2 Capacity Blocks phù hợp khi bạn cần năng lực ML được dành trước cho một khoảng thời gian xác định.
AWS có thể phù hợp khi:
- Bạn đã vận hành dữ liệu, bảo mật và hệ thống triển khai trên AWS.
- Bạn cần quy trình mua sắm và hỗ trợ cấp doanh nghiệp.
- Bạn cần một mô hình đặt trước xác định cho cửa sổ huấn luyện hoặc ra mắt.
- Bạn có thể xử lý độ phức tạp của đám mây và quản lý hạn mức.
Hãy kiểm tra phiên bản AWS P5 và EC2 Capacity Blocks cho ML, sau đó bao gồm EBS, truyền dữ liệu, hỗ trợ, NAT, khả năng quan sát và thời gian kỹ thuật trong TCO. Nếu quyết định cụ thể là về năng lực NVIDIA cũ so với mới, hãy dùng các so sánh H100 so với A100 và H200 so với H100 như tài liệu đọc bổ trợ.
Google Cloud
Google Cloud là một lựa chọn thay thế RunPod khi nhóm của bạn muốn các dòng máy tối ưu cho bộ tăng tốc, các kiểm soát cấp doanh nghiệp và một môi trường cloud-native xung quanh dữ liệu, mạng và Kubernetes. Nó đặc biệt phù hợp với các tổ chức đã sử dụng hạ tầng dữ liệu của Google Cloud.
Hãy dùng Google Cloud khi:
- Khối lượng công việc của bạn cần vị trí dữ liệu trên đám mây với BigQuery, GCS, GKE hoặc Vertex AI.
- Bạn cần các kiểm soát nhận dạng, kiểm toán và mua sắm cấp doanh nghiệp.
- Bạn có thể lập kế hoạch quanh hạn mức, khu vực, đĩa và giá mạng.
Hãy dùng tài liệu máy tối ưu cho bộ tăng tốc của Google Cloud và giá GPU của Compute Engine làm mốc tham chiếu nguồn. Hãy chuẩn hóa giả định về GPU, máy, đĩa, mạng và mức cam kết trước khi so sánh với các đám mây GPU chuyên biệt.
Azure
Azure là một lựa chọn thay thế RunPod thực tế cho các doanh nghiệp đã chuẩn hóa trên các hệ thống đám mây, danh tính, bảo mật, mua sắm hoặc dữ liệu của Microsoft. Dòng ND H100 v5 của Azure là một điểm kiểm tra nguồn quan trọng cho khối lượng công việc kiểu cụm H100.
Sử dụng Azure khi:
- Công ty của bạn đã mua hàng thông qua các thỏa thuận với Microsoft.
- Bạn cần bảo mật, tuân thủ và các kiểm soát mạng ở cấp doanh nghiệp.
- Bạn cần các máy ảo GPU gắn với hạ tầng dữ liệu hoặc ứng dụng rộng hơn của Azure.
Kiểm tra dòng Azure ND H100 v5, sau đó xác thực tính khả dụng theo khu vực, quota, yêu cầu InfiniBand, lưu trữ, hỗ trợ và độ phức tạp khi triển khai.
Các lựa chọn thay thế serverless và suy luận được quản lý
Không phải mọi lựa chọn thay thế RunPod đều nên là một GPU thuê. Nếu nhóm của bạn muốn một endpoint chứ không phải một máy, suy luận được quản lý có thể loại bỏ rất nhiều công việc vận hành.
Replicate
Replicate là lựa chọn phù hợp khi nhóm muốn chạy mô hình thông qua API, triển khai các phiên bản mô hình và tránh phải trực tiếp quản lý các máy chủ GPU. Nó đặc biệt hữu ích cho các nhóm sản phẩm quan tâm đến việc nhanh chóng ra mắt các tính năng dựa trên mô hình.
Replicate có thể phù hợp với:
- Suy luận cho mô hình hình ảnh, video, âm thanh và mã nguồn mở.
- Các nguyên mẫu sản phẩm cần API nhanh chóng.
- Các nhóm ưu tiên sự tiện lợi khi triển khai hơn là kiểm soát GPU ở mức thấp.
Sử dụng bảng giá Replicate làm điểm kiểm tra nguồn, sau đó xác minh các tùy chọn phần cứng, hành vi triển khai, thời gian khởi động lạnh, nhật ký, cách xử lý dữ liệu và việc khối lượng công việc có cần kernel tùy chỉnh hoặc mạng riêng hay không.
Together AI
Together AI là một lựa chọn thay thế RunPod khi khối lượng công việc gần với suy luận LLM và fine-tuning hơn là thuê máy ảo GPU nói chung. Nó xứng đáng có mặt trong danh sách rút gọn cho các nhóm muốn suy luận được quản lý, endpoint dành riêng và hạ tầng phục vụ mô hình mà không phải vận hành toàn bộ stack.
Together AI có thể phù hợp với:
- Endpoint suy luận LLM.
- Quy trình fine-tuning và đánh giá.
- Các nhóm muốn hạ tầng phục vụ mô hình hơn là quản lý pod thô.
Sử dụng bảng giá Together AI làm điểm kiểm tra giá trực tiếp và xác minh xem khối lượng công việc có thuộc về suy luận serverless, endpoint dành riêng, batch API hay một thỏa thuận doanh nghiệp tùy chỉnh hay không. Nếu bạn sẽ tự vận hành (self-host), hãy so sánh riêng các stack phục vụ với vLLM vs SGLang.
Các lựa chọn thay thế API mô hình và bộ định tuyến
Những lựa chọn thay thế RunPod thường bị bỏ qua nhất là API mô hình và bộ định tuyến. Nếu sản phẩm của bạn không cần trọng số tùy chỉnh, kernel CUDA tùy chỉnh, vị trí đặt GPU riêng, hoặc kiểm soát phục vụ ở mức thấp, thì việc thuê GPU có thể là một trừu tượng hóa sai.
Định vị của Flatkey hữu ích cho quyết định này: một khóa, một số dư, một hóa đơn, định tuyến tương thích OpenAI, các endpoint mô hình chính thức, sổ cái sử dụng, kiểm soát ngân sách và các đường dự phòng trên nhiều mô hình và công cụ. Điều đó không thay thế một cụm GPU chuyên dụng khi bạn cần sở hữu stack phục vụ. Nhưng nó thay thế cụm đó khi điều bạn cần là đầu ra AI đáng tin cậy với chi tiêu có thể truy vết. Về phía ngân sách mô hình, hãy so sánh bảng tính GPU với so sánh giá mô hình AI và quản lý chi tiêu AI API.
Sử dụng API mô hình hoặc bộ định tuyến khi:
- Bạn cần truy cập nhiều mô hình văn bản, hình ảnh hoặc video.
- Lưu lượng truy cập tăng đột biến và không đủ để biện minh cho GPU dành riêng.
- Việc lựa chọn mô hình thay đổi thường xuyên.
- Bạn không cần quản lý weights, driver, CUDA hoặc các kernel phục vụ.
- Khả năng quan sát chi phí, dự phòng và hợp nhất thanh toán quan trọng hơn quyền kiểm soát GPU thô.
Sử dụng GPU chuyên dụng khi:
- Bạn phục vụ các weights riêng tư hoặc tùy chỉnh.
- Bạn cần kernel tùy chỉnh, quantization, adapters hoặc logic phục vụ.
- Yêu cầu cư trú dữ liệu hoặc cô lập đòi hỏi môi trường riêng của bạn.
- Khối lượng suy luận đủ ổn định để biện minh cho năng lực cam kết.
- Bạn có thể bố trí nhân sự vận hành GPU.
Đó là câu hỏi mua sắm cốt lõi: bạn đang mua quyền truy cập phần cứng hay đầu ra được chấp nhận?
Các lựa chọn thay thế RunPod cho ComfyUI
Các lượt tìm kiếm runpod alternatives comfyui thường xuất phát từ một vấn đề thực tế: quy trình chạy được, nhưng lưu trữ, thời gian khởi động, phiên bản hình ảnh và khả năng lặp lại đang trở nên phiền phức.
Đối với ComfyUI, hãy so sánh các tùy chọn sau:
| Tùy chọn | Phù hợp nhất | Điểm cần lưu ý |
|---|---|---|
| RunPod pods | Lựa chọn quen thuộc nếu bạn đã có templates và volumes | Dọn dẹp persistent volume, chi phí nhàn rỗi, lệch image |
| Vast.ai hoặc TensorDock | Nguồn GPU linh hoạt cho các công việc batch hình ảnh | Độ tin cậy của host, lưu trữ, băng thông, khởi động lại |
| Hyperstack hoặc Lambda | Mô hình instance cloud GPU truyền thống hơn | Tính khả dụng, chi phí theo giờ, trách nhiệm thiết lập |
| API kiểu Replicate | Các tính năng sản phẩm cần đầu ra hình ảnh qua API | Ít kiểm soát hơn đối với quy trình ở mức thấp |
| Đường đi Flatkey/API mô hình | Thử nghiệm nhiều nhà cung cấp mô hình hình ảnh/video | Không thay thế cho các đồ thị ComfyUI tùy chỉnh cần kiểm soát node trực tiếp |
Đối với ComfyUI, đừng chỉ so sánh model GPU và giá theo giờ. Hãy đo lường thêm:
- Thời gian để kéo image và trọng số mô hình.
- Chi phí lưu trữ bền vững.
- Liệu các node tùy chỉnh có sống sót sau các lần rebuild hay không.
- Thời gian nhàn rỗi sau khi một batch hoàn tất.
- Chi phí truyền đầu ra.
- Tỷ lệ lỗi do thiếu mô hình, image lỗi, hoặc host khởi động lại.
- Liệu workflow có cần UI, endpoint API hay hàng đợi tự động hay không.
Những lựa chọn thay thế RunPod tốt nhất cho ComfyUI thường là những lựa chọn giảm thời gian rebuild và dung lượng lưu trữ bị bỏ quên, chứ không phải những lựa chọn có giá GPU theo giờ thấp nhất trên bề mặt.
Danh sách kiểm tra cụm GPU chuyên dụng
Nếu lý do chuyển đổi là năng lực doanh nghiệp, hãy dùng danh sách kiểm tra này trước khi ký term sheet.
| Yêu cầu | Cần hỏi từng nhà cung cấp điều gì |
|---|---|
| GPU shape | Model GPU chính xác, bộ nhớ, PCIe/SXM/NVL, số GPU mỗi node, CPU, RAM, local NVMe |
| Mạng | InfiniBand, RoCE, EFA, NVLink/NVSwitch, cam kết vị trí, oversubscription, bằng chứng kiểm tra NCCL |
| Lưu trữ | Local scratch, shared filesystem, vùng object storage, throughput checkpoint, giá snapshot |
| Bộ lập lịch | Kubernetes, Slurm, Ray, dịch vụ quản lý, quyền truy cập người dùng, quota, tự tắt khi nhàn rỗi |
| Độ tin cậy | Chính sách thay thế node, cửa sổ bảo trì, nâng cấp sự cố, SLA, chính sách thử lại |
| Bảo mật | Cô lập tenant, nhật ký audit, xử lý secrets, mạng riêng, xóa dữ liệu |
| Kiểm soát chi phí | Tag theo nhóm, xuất mức sử dụng, cảnh báo ngân sách, phát hiện nhàn rỗi, phân bổ chi phí |
| Hợp đồng | Thời hạn tối thiểu, mức chi tiêu tối thiểu, tùy chọn burst, lộ trình nâng cấp, hủy bỏ, phạm vi hỗ trợ |
Hãy chạy ít nhất một bài kiểm thử chấp nhận trước khi hợp đồng trở nên khó thoát:
cluster acceptance test =
  deploy production container
  pull model weights and dataset
  run representative benchmark
  run NCCL all-reduce if multi-node
  write and restore checkpoint
  simulate one failed job
  export cost and utilization logs
Nếu một nhà cung cấp không thể hỗ trợ một benchmark đại diện, hãy xem đó là rủi ro mua hàng.
Replicate vs Together AI vs các lựa chọn thay thế RunPod
Câu truy vấn replicate vs together ai vs runpod alternatives trộn lẫn ba loại khác nhau, vì vậy hãy so sánh chúng theo mức độ trừu tượng.
| Loại nền tảng | Bạn quản lý | Nhà cung cấp quản lý | Phù hợp nhất |
|---|---|---|---|
| Đám mây GPU kiểu RunPod | Containers, images, storage, vòng đời GPU, serving stack | Hạ tầng GPU và các primitive của nền tảng | Nhà phát triển cần kiểm soát GPU trực tiếp |
| Triển khai mô hình kiểu Replicate | Đóng gói mô hình và việc sử dụng API | Một phần lớn hạ tầng serving và tính tiện dụng khi triển khai cho người dùng cuối | Các nhóm sản phẩm cần triển khai endpoint mô hình nhanh chóng |
| Nền tảng inference kiểu Together AI | Lựa chọn mô hình, chọn endpoint, thiết kế workload | Hạ tầng phục vụ LLM và vận hành endpoint | Các nhóm tập trung vào inference/fine-tuning LLM |
| Model router kiểu Flatkey | Lệnh gọi API, ngân sách, chính sách định tuyến mô hình | Lớp truy cập đa mô hình, hóa đơn hợp nhất, sổ cái sử dụng | Các nhóm cần đầu ra mô hình chính thức, không cần sở hữu GPU |
Đừng chọn hạng mục rẻ nhất. Hãy chọn rủi ro vận hành thấp nhất cho công việc đó.
Bảng so sánh các lựa chọn thay thế RunPod
Hãy dùng bảng này khi so sánh các nhà cung cấp đám mây GPU.
| Trường | Nhà cung cấp A | Nhà cung cấp B | Nhà cung cấp C |
|---|---|---|---|
| Chế độ sản phẩm | Pod / VM / serverless / cụm dành riêng / API | ||
| Model GPU và bộ nhớ | H100 SXM, H100 PCIe, H200, B200, L40S, RTX 4090 | ||
| Vùng hoặc host | |||
| Đơn vị tính phí | giây, phút, giờ, theo tháng, block năng lực | ||
| Cam kết tối thiểu | không có, theo tháng, theo năm, block dành riêng | ||
| Chi phí lưu trữ | volumes, snapshots, object storage, local NVMe | ||
| Chi phí mạng | egress, private link, cross-region, public IP | ||
| Chi phí khởi động | image pull, tải trọng số, cold start | ||
| Tỷ lệ nhàn rỗi | phút tính phí không có công việc hữu ích | ||
| Hệ số lỗi/thử lại | eviction, OOM, host lỗi, lỗi cold-start | ||
| Hỗ trợ | tự phục vụ, ticket, hỗ trợ riêng, SLA | ||
| Bảo mật | cô lập tenant, nhật ký audit, secrets, xóa dữ liệu | ||
| Đơn vị đầu ra được chấp nhận | 1M token, ảnh, video, fine-tune, lần chạy training | ||
| Chi phí hiệu dụng trên mỗi đầu ra được chấp nhận | được tính, không phải đoán |
Sau đó tính:
effective hourly cost =
  GPU hourly cost
  + storage per hour
  + network per hour
  + support per hour
  + idle waste
  + retry waste
  + engineering overhead

cost per accepted output =
  effective hourly cost / accepted outputs per hour
Đây cũng là cách bạn quyết định liệu năng lực chuyên dụng có tốt hơn API hay không. Nếu chi phí API trên mỗi đầu ra được chấp nhận thấp hơn sau khi tính cả vận hành GPU, đừng thuê cụm chỉ vì mức giá GPU theo giờ trông hấp dẫn.
Danh sách kiểm tra nguồn cho giá hiện tại
Giá cả và khả năng sẵn có của GPU thay đổi thường xuyên. Trước khi đưa ra quyết định mua, hãy kiểm tra lại các hàng nguồn và ghi lại ngày tháng. Với bản nháp này, danh sách kiểm tra nguồn đã được xác minh tính sẵn có của trang vào ngày 12 tháng 10 năm 2026.
| Nhà cung cấp/danh mục | Mốc kiểm tra nguồn | Cần ghi lại gì |
|---|---|---|
| RunPod | Giá RunPod, Tài liệu lưu trữ pod RunPod | Chế độ pod, chế độ serverless, năng lực secure/community, lưu trữ, dung lượng mạng, giả định khi nhàn rỗi |
| Lambda | Lambda GPU Cloud | Mô hình GPU, cấu hình instance, khả năng sẵn có, điều khoản reserved hoặc cluster |
| Vast.ai | Giá Vast.ai | Host, độ tin cậy, GPU, lưu trữ, băng thông, điều khoản marketplace |
| Massed Compute | Giá Massed Compute | Đơn giá theo nhu cầu, lộ trình đặt trước, hỗ trợ và điều khoản cluster |
| Hyperstack | Giá GPU Hyperstack | SKU GPU, khu vực, lưu trữ, kết nối mạng, hỗ trợ |
| TensorDock | Cloud GPU TensorDock | Host trên marketplace, GPU, RAM/vCPU, lưu trữ, giá tại thời điểm triển khai |
| Replicate | Giá Replicate | Giá triển khai, phần cứng, cold start, nhật ký, chính sách dữ liệu |
| Together AI | Giá Together AI | Serverless, endpoint chuyên dụng, fine-tuning, kinh tế học theo lô |
| AWS | Instance EC2 P5, EC2 Capacity Blocks | Khu vực, hạn ngạch, họ instance, cửa sổ đặt chỗ, EBS, truyền dữ liệu, hỗ trợ |
| Google Cloud | Máy tối ưu cho accelerator, Giá GPU | Họ máy, giá GPU, đĩa, mạng, giảm giá cam kết sử dụng |
| Azure | Dòng ND H100 v5 | Kích thước VM, khu vực, hạn ngạch, InfiniBand, hỗ trợ, lưu trữ |
Khuyến nghị cuối cùng
Hãy rút gọn các lựa chọn thay thế RunPod theo mô hình vận hành:
- Dùng marketplace như Vast.ai hoặc TensorDock cho các thử nghiệm linh hoạt, các lô ComfyUI, và khối lượng công việc có thể chấp nhận thử lại.
- Dùng các cloud GPU chuyên biệt như Lambda, CoreWeave, Crusoe, Massed Compute, Nebius, Hyperstack, hoặc Vultr khi bạn cần năng lực GPU và hỗ trợ có thể dự đoán hơn.
- Dùng hyperscaler khi danh tính doanh nghiệp, mua sắm, tuân thủ, và lực hút dữ liệu đám mây sẵn có quan trọng hơn sự đơn giản.
- Dùng nền tảng suy luận được quản lý như Replicate hoặc Together AI khi hành vi endpoint quan trọng hơn quyền kiểm soát VM.
- Dùng Flatkey hoặc một model API router khác khi bạn cần đầu ra mô hình AI chính thức, khả năng hiển thị mức sử dụng, cơ chế dự phòng, và thanh toán hợp nhất thay vì sở hữu GPU trực tiếp.
Những lựa chọn thay thế RunPod tốt nhất là những lựa chọn giúp giảm chi phí cho công việc được chấp nhận. Nếu một nhà cung cấp cho bạn giờ GPU rẻ hơn nhưng làm tăng thời gian nhàn rỗi, chi phí khởi động, số job thất bại, lãng phí lưu trữ, hoặc gánh nặng kỹ thuật, thì thực ra nó không hề rẻ hơn.
Các câu hỏi thường gặp
Một số lựa chọn thay thế RunPod là gì?
Các lựa chọn thay thế RunPod phổ biến bao gồm Lambda Cloud, CoreWeave, Crusoe Cloud, Massed Compute, Nebius AI Cloud, Hyperstack, Vultr Cloud GPU, Vast.ai, TensorDock, Replicate, Together AI, AWS, Google Cloud, Azure, và các model API router như Flatkey. Lựa chọn phù hợp phụ thuộc vào việc bạn cần pods, endpoint serverless, cluster chuyên dụng, marketplace hay quyền truy cập mô hình ở cấp API.
Lựa chọn thay thế RunPod tốt nhất cho ComfyUI là gì?
Đối với các thử nghiệm ComfyUI, Vast.ai, TensorDock, Hyperstack, Lambda, và các cloud GPU kiểu Paperspace thường nằm trong danh sách rút gọn. Hãy so sánh lưu trữ bền vững, bộ nhớ đệm trọng số mô hình, thời gian khởi động, quản lý custom node, tự tắt khi nhàn rỗi, truyền đầu ra, và độ tin cậy của host trước khi so sánh giá GPU theo giờ.
Các lựa chọn thay thế RunPod có rẻ hơn không?
Đôi khi có, nhưng chỉ sau khi bạn tính được chi phí hiệu dụng trên mỗi đầu ra được chấp nhận. Một mức giá GPU theo giờ thấp hơn có thể thua nếu khối lượng công việc phải mất nhiều thời gian hơn để tải mô hình, chờ nhàn rỗi, thử lại job thất bại, hoặc di chuyển dữ liệu. Hãy so sánh số ảnh, token, video, hoặc job hoàn thành, không chỉ giờ GPU.
Tôi có nên dùng Replicate hoặc Together AI thay vì RunPod không?
Hãy dùng Replicate hoặc Together AI khi bạn muốn các endpoint mô hình được quản lý và không cần kiểm soát GPU ở mức thấp. Hãy dùng các cloud GPU kiểu RunPod khi bạn cần container tùy chỉnh, workflow tùy chỉnh, truy cập GPU trực tiếp, hoặc kiểm soát ngăn phục vụ.
Khi nào tôi nên dùng Flatkey thay vì thuê GPU?
Sử dụng Flatkey khi đội ngũ của bạn cần các API mô hình chính thức, định tuyến đa mô hình, một khóa, một số dư, sổ cái sử dụng, cơ chế dự phòng và kiểm soát ngân sách. Thuê GPU khi trọng số tùy chỉnh, kernel tùy chỉnh, vị trí triển khai riêng hoặc mức sử dụng cao ổn định khiến việc kiểm soát hạ tầng trực tiếp xứng đáng với chi phí vận hành.


