
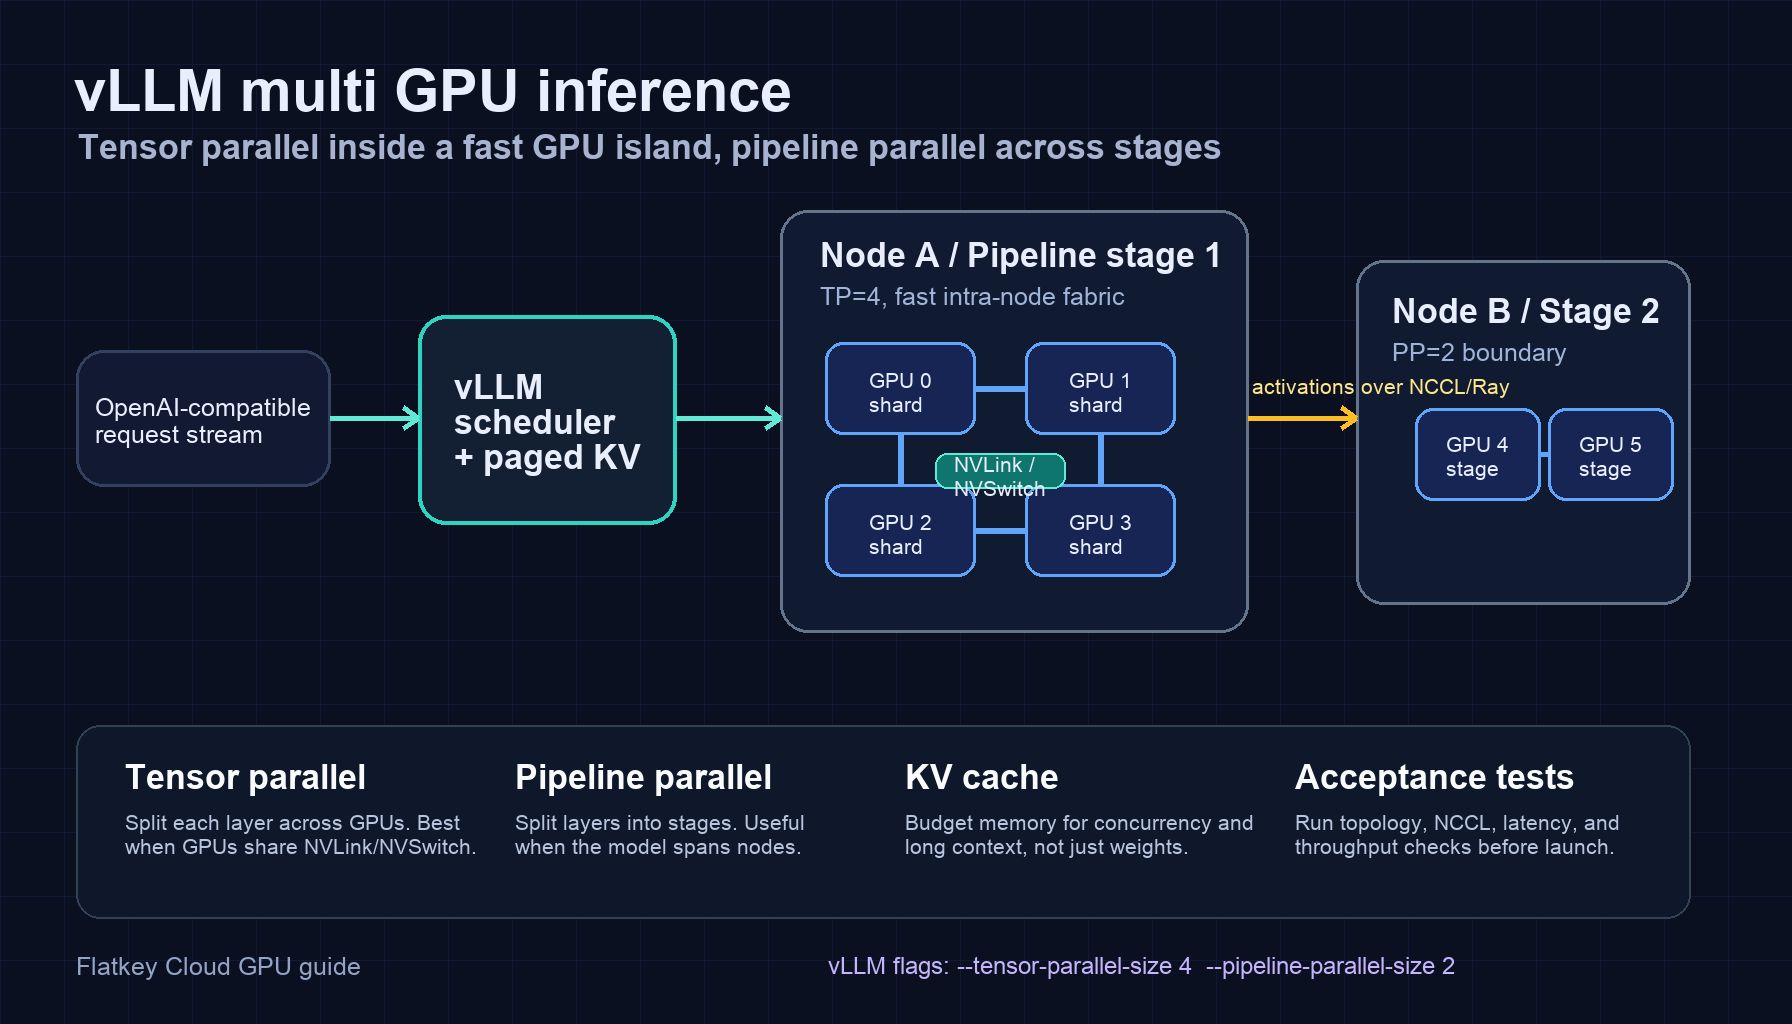
МногoGPU inference в vLLM обычно начинается по одной из трёх причин: веса модели не помещаются на одной GPU, KV cache для требуемого контекста и concurrency не помещается на одной GPU, либо одна GPU не может обеспечить нужный показатель tokens-per-second и time-to-first-token. Настройка — это не только решение про --tensor-parallel-size. Также нужно согласовать tensor parallelism, pipeline parallelism, backend executor и физическую топологию GPU.
Короткая версия:
- Сначала используйте tensor parallelism, когда модель помещается на нескольких GPU в одном быстром GPU-island, особенно на узле с 8 H100/H200/B200 и NVLink или NVSwitch.
- Добавляйте pipeline parallelism, когда модель должна охватывать несколько узлов или когда tensor parallelism в одиночку создаёт слишком много межузлового трафика.
- Считайте
tp * ppкак число GPU workers, используемых одной репликой vLLM. - Перед тем как считать настройку production-ready, проведите benchmark с вашей реальной длиной prompt, длиной output, формой batch и quantization модели.
- Если вашей команде нужен только OpenAI-compatible endpoint, а не прямой контроль над оборудованием, сравните GPU-путь с managed model/API baseline, например Flatkey, прежде чем арендовать и обслуживать кластер.
Это руководство даёт практический пример vLLM multi gpu inference, diagram архитектуры, команды запуска и проверки, которые обычно выявляют плохие multi-GPU setup до того, как это сделают пользователи.
Архитектура multi-GPU-инференса vLLM
В vLLM tensor parallelism делит вычисления каждого transformer layer между несколькими GPU workers. Pipeline parallelism делит layers модели на stages, так что разные группы GPU выполняют разные части модели. Для production serving эти решения влияют не только на память: они меняют collective communication, scheduling запросов, радиус отказа и то, станет ли сеть при scale-out узким местом.
Типичная стартовая архитектура выглядит так:
| Layer | Практический выбор | Почему это важно |
|---|---|---|
| API surface | vllm serve с OpenAI-compatible server |
Позволяет application teams сохранить OpenAI-style clients, меняя при этом serving backend. |
| Tensor parallel group | Один узел или один NVLink/NVSwitch island | Tensor parallel layers часто обмениваются данными, поэтому медленные межузловые каналы быстро мешают. |
| Pipeline stages | Разделение на уровне узла или стойки, когда модель не помещается в один узел | Pipeline parallelism может уменьшить объём межузловой коммуникации по сравнению с размещением одной tensor-parallel group на всех GPU. |
| Distributed backend | Multiprocessing для одного узла, Ray, когда нужна orchestration на несколько узлов | Оставляйте single-node serving простым; используйте Ray, когда workers должны охватывать несколько машин. |
| KV cache plan | Закладывайте budget для длины prompt, длины output и concurrency | Веса — это только отправная точка; serving с длинным контекстом может упереться в KV cache. |
| Acceptance test | Topology, NCCL, cold load, TTFT, throughput и restart при сбое | Большинство плохих deployment выглядят нормально, пока не приходит реалистичный traffic. |
Для смежного взгляда на инфраструктуру см. GPU cluster architecture guide. Для sizing памяти используйте LLM GPU memory requirements worksheet, когда он станет доступен.
Tensor parallel и pipeline parallel в vLLM
Самое полезное правило выбора простое:
Используйте tensor parallelism внутри быстрого GPU-island. Используйте pipeline parallelism, чтобы пересекать более медленные границы.
Tensor parallelism — хороший первый шаг, когда:
- модель слишком велика для одной GPU, но помещается на 2, 4 или 8 GPU в одном узле;
- ваш GPU-узел имеет высокоскоростные связи GPU-to-GPU;
- latency важна, и вы хотите, чтобы каждый запрос проходил через одну logical model replica без долгого pipeline bubble;
- семейство модели хорошо поддерживается tensor parallel execution в vLLM.
Pipeline parallelism становится полезным, когда:
- модель не помещается в один узел даже после quantization или перехода на lower precision;
- иначе tensor-parallel group слишком часто пересекала бы Ethernet или InfiniBand;
- вы хотите, чтобы каждый узел владел stage модели, а не чтобы каждый layer участвовал в межузловых collectives;
- вы можете принять overhead от scheduling и bubbles, который сопровождает pipeline stages.
Не предполагайте, что tp=8 всегда лучше, чем tp=4, или что pp=2 автоматически повышает throughput. Для vLLM multi gpu inference правильная конфигурация зависит от размера модели, давления на память, interconnect, длины sequence и того, какую batch concurrency может выдержать ваша workload.
Пример multi-GPU-инференса vLLM на одном узле
По возможности начинайте с одного узла. Его проще отлаживать, дешевле benchmark-ить, и он избегает multi-node networking как первой области отказа.
Пример: один сервер с 4 GPU, одна реплика vLLM, tensor parallel size 4.
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
Используйте такую конфигурацию, когда модель хорошо помещается на четырёх GPU, а узел имеет быструю коммуникацию GPU-to-GPU. Для узла с 8 GPU проверьте и --tensor-parallel-size 4, и --tensor-parallel-size 8; большая группа может улучшить запас по памяти, но может добавить overhead коммуникации.
Базовый smoke test:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "Дайте мне однострочную проверку состояния GPU."}],
    "max_tokens": 64
  }'
Если это не работает, не переходите к multi-node. Сначала исправьте загрузку модели, видимость CUDA, видимость NCCL, совместимость драйвера/runtime и давление на память GPU.
Пример multi-node с tensor и pipeline parallelism
Когда вам нужно больше GPU, чем может предоставить один узел, по возможности держите группу tensor-parallel внутри каждого узла, а затем используйте pipeline parallelism между узлами.
Пример целевой конфигурации:
- два узла;
- четыре GPU на узел;
- размер tensor parallel: 4;
- размер pipeline parallel: 2;
- общее число workers:
4 * 2 = 8.
Концептуальный запуск:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
В реальном кластере запустите Ray на head-узле, подключите worker-узлы к этому Ray-кластеру, сделайте хранилище модели доступным для всех узлов и перед запуском сервера vLLM убедитесь, что все workers видят нужное число GPU. Зафиксируйте точную версию vLLM, образ CUDA, ветку драйвера и ревизию модели в runbook, чтобы последующая пересборка незаметно не изменила поведение.
Именно здесь качество инфраструктуры становится качеством продукта. Если второй узел подключен через слабую сеть, если NCCL выбирает не тот интерфейс или если путь к кэшу модели медленный, пользователи увидят это как вариативность задержки, долгие cold start или сбои запросов.
Выбор backend: multiprocessing или Ray
Для поддержки vLLM multi-gpu inference используйте самый простой backend executor, который подходит для развертывания:
| Развертывание | Рекомендуемый backend | Примечания |
|---|---|---|
| Один сервер, несколько GPU | Multiprocessing или значение по умолчанию vLLM для вашей версии | Проще в эксплуатации; меньше движущихся частей. |
| Несколько серверов | Ray | Нужен, когда workers распределены по узлам и требуется координация на уровне кластера. |
| Multi-node serving в Kubernetes | Ray плюс явное планирование pod/network/storage | Сделайте планирование, размещение и health checks видимыми, а не надеясь, что serving process найдёт правильные GPU. |
Выбор backend не следует рассматривать отдельно от топологии. Если Ray нужен только потому, что модель слишком велика для одного сервера, следующий вопрос — может ли pipeline parallelism сохранить большую часть высокочастотной коммуникации внутри каждого узла.
Оценка памяти перед выбором TP и PP
План vLLM multi gpu inference должен закладывать память в таком порядке:
- Weights: параметры модели после dtype или quantization.
- KV cache: длина prompt, длина output, batch concurrency и dtype кэша.
- Накладные расходы runtime: CUDA graphs, поведение allocator, буферы коммуникации, накладные расходы tokenizer/server и запас безопасности.
- Операционный запас: rolling restarts, reload модели, telemetry и периодические всплески prompt.
Tensor parallelism распределяет веса модели и часть вычислений между GPU, но не делает трафик бесплатным. Pipeline parallelism может снизить давление на память на каждом stage, но он создаёт вопросы баланса stage. Stage pipeline с большим давлением на память или более медленными kernels станет ограничителем throughput для всей replica.
Практические варианты для первого теста:
| Ситуация с моделью/runtime | Первый вариант TP/PP для проверки |
|---|---|
| Модель 7B или 8B, обычный context | tp=1, одна GPU, масштабируйте replicas горизонтально |
| Модель 32B, высокая concurrency | tp=2 или tp=4 на одном узле |
| Модель класса 70B, BF16/FP16 | tp=4 или tp=8 на одном узле с большой памятью |
| Очень большая dense-модель, распределённая по узлам | tp=4, pp=2 или tp=8, pp=2, в зависимости от размера узла |
| MoE-модель | Отдельно проверьте рекомендации vLLM по expert-parallel; не рассматривайте MoE как dense-модель по умолчанию |
Эта таблица — отправная точка, а не результат benchmark. Фактическая стоимость обслуженного output зависит от реальных prompt, реальных output, частоты retry, поведения очереди и принятия по качеству.
Проверки topology, которые имеют значение
Перед публикацией multi-GPU endpoint соберите у провайдера или на машине следующие данные:
- вывод
nvidia-smi topo -mдля каждого узла; - делят ли GPU внутри узла NVLink или NVSwitch;
- сетевую fabric между узлами, включая InfiniBand, RoCE, EFA или Ethernet;
- видимые для NCCL интерфейсы и использует ли трафик нужный путь;
- путь к хранилищу весов модели и не загружают ли несколько узлов данные с медленного общего диска;
- память GPU, статус MIG, power caps и версии driver/CUDA.
Например, системы NVIDIA DGX H100/H200 документированы как восьми-GPU системы с NVSwitch/NVLink connectivity между GPU и вариантами сети 400 Gb/s. Узлы на обычных PCIe всё равно могут хорошо обслуживать vLLM, но следует ожидать иной профиль коммуникации и соответствующим образом проводить benchmark.
Для справки по interconnect см. NVLink vs NVSwitch. Для терминологии по покупке и топологии кластера полезным дополнением будет руководство по аренде GPU-кластера.
Приёмочное тестирование в production
Запустите staged-тест вместо одного запроса по «счастливому пути».
- Тест топологии: сохраните
nvidia-smi topo -m, инвентарь NIC и окружение NCCL. - Тест холодной загрузки: измерьте время от запуска контейнера до первого успешно сгенерированного токена.
- Тест короткого запроса: низкая длина промпта, умеренная длина вывода, ожидаемая чатовая нагрузка.
- Тест длинного запроса: реалистичная длина контекста, близкая к требованиям вашего продукта.
- Проверка конкуренции: увеличивайте число одновременных запросов, пока p95 времени до первого токена или p95 задержки между токенами не превысит ваш лимит.
- Тест с тяжёлым выводом: используйте нагрузки, которые генерируют длинные завершения, а не только запросы на классификацию.
- Тест отказа: завершите один процесс worker или один узел и убедитесь, что балансировщик нагрузки удаляет реплику.
- Тест перезапуска: выполните rolling restart процесса vLLM и убедитесь, что кэш модели, состояние Ray и health checks восстанавливаются корректно.
Отслеживайте как минимум следующие метрики:
| Метрика | Почему это важно |
|---|---|
| Время до первого токена | Пользователи ощущают это сразу в чатах и agent workflows. |
| Задержка между токенами | Показывает стабильность decode после начала генерации. |
| Токенов в секунду на реплику | Помогает сравнивать конфигурации TP/PP. |
| Запас по памяти GPU | Позволяет предсказать, приведут ли всплески длинного контекста к OOM. |
| Время в очереди | Отделяет пропускную способность сервинга от задержки приложения. |
| Rate ошибок и повторных попыток | Преобразует нестабильность инфраструктуры в реальные затраты. |
| Доля принятых ответов | Позволяет не оптимизировать дешёвые токены, которые пользователи отклоняют. |
Паттерны устранения неполадок
Модель загружается, но пропускная способность хуже при большем количестве GPU.
Группа TP может быть слишком большой для топологии, либо у рабочей нагрузки может не хватать параллелизма, чтобы компенсировать затраты на коммуникации. Проверьте меньший TP, больше реплик или другую форму batch/concurrency.
Запуск на нескольких узлах зависает.
Проверьте членство Ray, правила брандмауэра, выбор интерфейса NCCL, сетевые настройки контейнера и может ли каждый узел достичь одного и того же пути к модели. Не начинайте отладку с уровня API.
Одна GPU уходит в OOM, хотя у остальных есть запас.
Ищите неравномерные стадии pipeline, разные SKU GPU, фрагментацию памяти или проблему с назначением rank. Убедитесь, что каждый worker использует нужную видимую GPU.
Задержки резко возрастают на длинных промптах.
Вероятные причины — давление на KV cache, стоимость prefill и очереди планировщика. Прежде чем менять железо, протестируйте отдельные диапазоны длины промпта.
Эндпоинт работает в терминале, но не работает за load balancer.
Проверьте таймаут streaming, idle timeout, путь health-check, лимиты на размер тела запроса и не отправляет ли load balancer трафик на реплику до того, как модель прогрелась.
Когда не стоит запускать vLLM multi GPU inference самостоятельно
Запуск vLLM — правильный выбор, когда вам нужен контроль на уровне модели, private weights, custom kernels, custom quantization или эксперименты на уровне оборудования. Но это не автоматически правильный выбор, если бизнес-требование звучит просто как «дайте нашему приложению надёжный OpenAI-compatible API».
Прежде чем арендовать multi-node GPU cluster, сравните путь self-hosted с managed model/API:
| Требование | Self-host vLLM на GPUs | Managed model/API baseline |
|---|---|---|
| Custom/private weights | Отлично подходит | Обычно недостаточно |
| Hardware experiments | Отлично подходит | Не в этом смысл |
| Быстрая интеграция в продукт | Больше операционной работы | Отлично подходит |
| Переключение между моделями | Вы управляете каждым стеком | Один gateway может упростить доступ |
| Биллинг и видимость использования | Нужно построить или интегрировать | Часто включено |
| Обработка отказов | Это ваша зона ответственности | Провайдер/gateway берет на себя больше |
Flatkey — это точка сравнения, когда вам нужен один OpenAI-compatible key, один баланс и доступ к официальным model endpoints без самостоятельной эксплуатации GPU serving layer. Если прямой контроль над железом не является требованием продукта, сравните решение с model/API baseline, прежде чем брать на себя cluster operations.
Частые вопросы
Поддерживает ли vLLM inference на нескольких GPU?
Да. vLLM поддерживает multi-GPU inference через tensor parallelism и pipeline parallelism, с вариантами executor, которые охватывают serving на одном узле и на нескольких узлах. Точный путь поддержки зависит от версии vLLM, архитектуры модели, топологии GPU и backend развертывания.
Какой размер tensor parallel лучше всего для vLLM?
Лучший размер tensor parallel — это минимальное значение TP, которое дает достаточно запаса по памяти и пропускной способности для вашей нагрузки. Начните с GPU в одном быстром узле, затем сравните tp=2, tp=4 или tp=8 на реальных длинах prompt и output.
Когда следует использовать pipeline parallelism в vLLM?
Используйте pipeline parallelism, когда требования модели или KV-cache вынуждают выйти за пределы одного узла, либо когда лучше держать tensor-parallel communication внутри каждого узла, чем строить одну cross-node TP group.
Нужен ли Ray для multi-GPU serving в vLLM?
Ray обычно является практичным выбором для multi-node serving в vLLM. Для одного узла multiprocessing backend или backend по умолчанию для вашей версии vLLM может быть проще.
Как понять, что setup для vLLM multi GPU inference готов к production?
Он готов к production только после проверок topology, тестов холодной загрузки, реалистичных benchmark по prompt/concurrency, health checks, тестов перезапуска и документирования поведения при сбоях. Одного успешного запроса curl недостаточно.


