
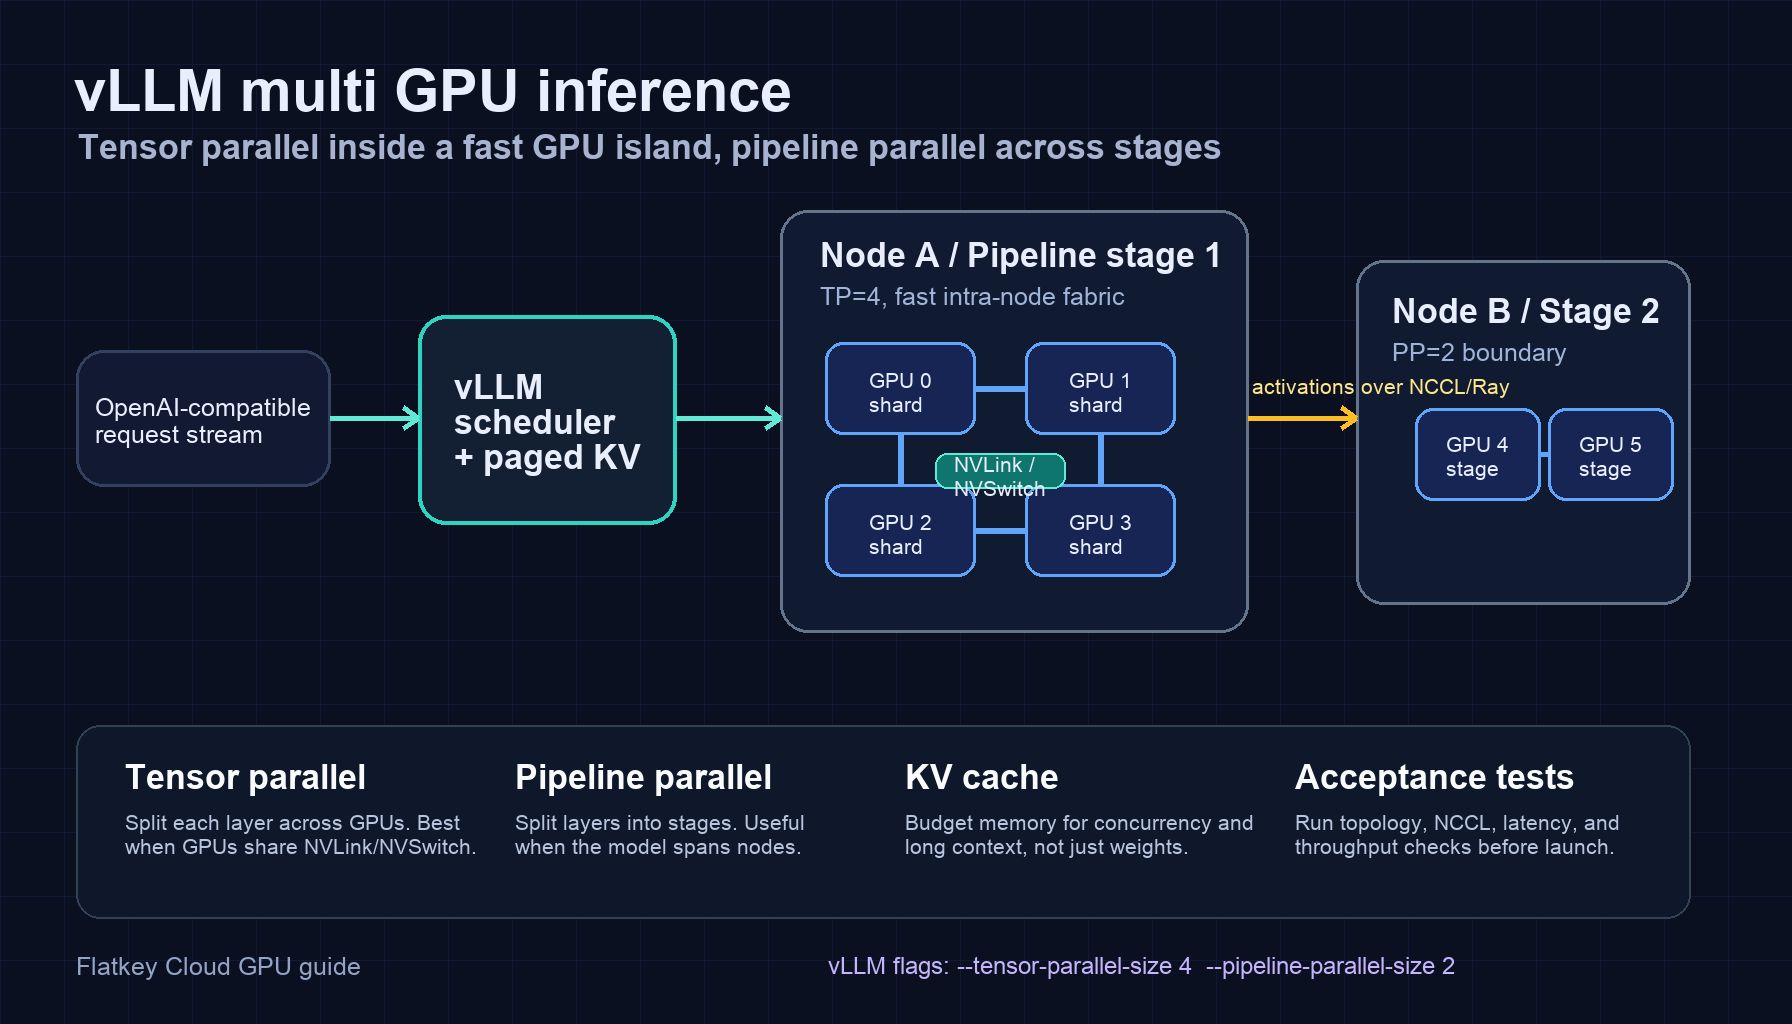
vLLM 多 GPU 推理通常始于以下三种原因之一:模型权重无法放入一张 GPU,所需上下文和并发的 KV cache 无法放入一张 GPU,或者一张 GPU 无法提供你需要的每秒 token 数和首 token 时间目标。配置不仅仅是一个 --tensor-parallel-size 的决定。你还需要匹配张量并行、流水线并行、执行器后端以及物理 GPU 拓扑。
简而言之:
- 当模型可以分布在同一个高速 GPU 域内的多张 GPU 上时,优先使用张量并行,尤其是带有 NVLink 或 NVSwitch 的 8-GPU H100/H200/B200 节点。
- 当模型必须跨多个节点,或者张量并行单独使用会产生过多跨节点通信时,增加流水线并行。
- 将
tp * pp视为一个 vLLM 副本使用的 GPU worker 数量。 - 在宣布配置可用于生产之前,请使用真实的 prompt 长度、输出长度、批次形态和模型量化方式进行基准测试。
- 如果你的团队只需要一个 OpenAI 兼容端点,而不需要直接的硬件控制,那么在你租用并运维集群之前,请将 GPU 方案与 Flatkey 之类的托管模型/API 基线进行比较。
本指南提供一个实用的 vLLM 多 GPU 推理示例、架构图、启动命令,以及通常能在用户之前发现错误多 GPU 配置的检查项。
vLLM 多 GPU 推理架构
在 vLLM 中,张量并行会将每个 transformer 层的工作分散到多个 GPU worker 上。流水线并行会把模型层拆分为多个阶段,因此不同的 GPU 组运行模型的不同部分。对于生产服务,这些选择影响的不仅仅是内存:它们还会改变集合通信、请求调度、故障影响范围,以及横向扩展网络是否会成为瓶颈。
一个常见的起始架构是:
| 层 | 实际选择 | 重要原因 |
|---|---|---|
| API 接口 | 使用带 OpenAI 兼容服务器的 vllm serve |
让应用团队可以继续使用 OpenAI 风格客户端,同时更换服务后端。 |
| 张量并行组 | 一个节点或一个 NVLink/NVSwitch 域 | 张量并行层通信频繁,因此跨节点慢链路会很快带来性能损失。 |
| 流水线阶段 | 当模型无法放入单个节点时,按节点级或机架级拆分 | 与把一个张量并行组横跨所有 GPU 放置相比,流水线并行可以减少跨节点通信量。 |
| 分布式后端 | 单节点使用多进程,需要多节点编排时使用 Ray | 保持单节点服务简单;当 worker 必须跨机器时使用 Ray。 |
| KV cache 规划 | 为 prompt 长度、输出长度和并发预留预算 | 权重只是起点;长上下文服务可能会受 KV cache 限制。 |
| 验收测试 | 拓扑、NCCL、冷启动加载、TTFT、吞吐量和故障重启 | 大多数糟糕部署在真实流量到来之前看起来都没问题。 |
有关相邻基础设施视角,请参阅 GPU 集群架构指南。关于内存容量规划,请在可用后使用 LLM GPU 内存需求工作表。
vLLM 中的张量并行与流水线并行
最有用的决策规则很简单:
在高速 GPU 域内部使用张量并行。使用流水线并行跨越较慢的边界。
在以下情况下,张量并行是一个很好的第一步:
- 模型对一张 GPU 来说太大,但可以在一个节点内分布到 2、4 或 8 张 GPU 上;
- 你的 GPU 节点具有高带宽的 GPU 间互联;
- 延迟很重要,并且你希望每个请求都通过一个逻辑模型副本,而不经历很长的流水线气泡;
- 模型家族对 vLLM 的张量并行执行支持良好。
在以下情况下,流水线并行会变得有用:
- 即使经过量化或降低精度后,模型仍然无法放入单个节点;
- 如果不使用流水线并行,张量并行组就不得不过于频繁地跨以太网或 InfiniBand 通信;
- 你希望每个节点拥有模型的一个阶段,而不是让每一层都参与跨节点集合通信;
- 你可以接受流水线阶段带来的调度和气泡开销。
不要假设 tp=8 总是比 tp=4 更好,也不要假设 pp=2 会自动提升吞吐量。对于 vLLM 多 GPU 推理,正确的形态取决于模型大小、内存压力、互连、序列长度,以及你的工作负载能维持多少批处理并发。
单节点 vLLM 多 GPU 推理示例
如果可以,先从单节点开始。这样更容易调试,基准测试成本更低,并且避免了将多节点网络作为第一个故障域。
示例:一台 4-GPU 服务器,一个 vLLM 副本,张量并行大小为 4。
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
当模型可以干净地分布到四张 GPU 上,并且节点具有快速的 GPU 间通信时,使用这种形态。对于 8-GPU 节点,请同时测试 --tensor-parallel-size 4 和 --tensor-parallel-size 8;更大的组可能改善内存余量,但也可能增加通信开销。
基本冒烟测试:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "给我一句话的 GPU 健康检查。"}],
    "max_tokens": 64
  }'
如果这一步失败了,不要马上进入多节点。先修复模型下载、CUDA 可见性、NCCL 可见性、驱动/运行时兼容性以及 GPU 内存压力问题。
使用张量并行和流水线并行的多节点示例
当你需要的 GPU 数量超过单个节点可提供的规模时,如果可能,尽量将张量并行组限制在每个节点内,然后在节点之间使用流水线并行。
示例目标形态:
- 两个节点;
- 每个节点四块 GPU;
- 张量并行大小为 4;
- 流水线并行大小为 2;
- 总 worker 数:
4 * 2 = 8。
概念性启动方式:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
在真实集群中,先在头节点启动 Ray,将工作节点加入该 Ray 集群,让所有节点都能访问模型存储,并在启动 vLLM 服务器之前确认所有 worker 都看到了预期的 GPU 数量。把你精确使用的 vLLM 版本、CUDA 镜像、驱动分支和模型 revision 记录到 runbook 中,这样后续重建时就不会悄悄改变行为。
从这里开始,基础设施质量就会直接体现为产品质量。如果第二个节点通过较弱的网络连接,如果 NCCL 选择了错误的接口,或者模型缓存路径很慢,用户会把它感知为延迟波动、很长的冷启动时间或请求失败。
后端选择:multiprocessing 还是 Ray
对于 vLLM 多 GPU 推理支持,请使用最适合部署场景的最简单执行器后端:
| 部署场景 | 建议后端 | 说明 |
|---|---|---|
| 单机,多 GPU | Multiprocessing 或该版本 vLLM 的默认后端 | 更容易运维;需要处理的组件更少。 |
| 多机 | Ray | 当 worker 横跨多个节点并需要集群级协调时,这是必需的。 |
| Kubernetes 多节点服务 | Ray 加上显式的 pod/网络/存储规划 | 让调度、放置和健康检查可见,而不是指望服务进程自己找到正确的 GPU。 |
后端选择不应与拓扑割裂。如果你使用 Ray 只是因为模型太大,单台服务器放不下,那么下一个问题就是流水线并行是否能把大部分高频通信限制在每个节点内部。
在选择 TP 和 PP 之前进行内存评估
vLLM 多 GPU 推理方案应按以下顺序预算内存:
- 权重: dtype 或量化之后的模型参数。
- KV 缓存: 提示长度、输出长度、批次并发以及缓存 dtype。
- 运行时开销: CUDA graphs、分配器行为、通信缓冲区、tokenizer/服务器开销以及安全余量。
- 运维余量: 滚动重启、模型重载、遥测以及偶发的提示词峰值。
张量并行会把模型权重和部分计算工作分散到多块 GPU 上,但它并不会让通信变得免费。流水线并行可以降低每个 stage 的内存压力,但会引入 stage 均衡问题。内存压力更大或 kernel 更慢的流水线 stage,会成为整个副本的吞吐瓶颈。
实用的首次尝试选择:
| 模型/运行时场景 | 首先测试的 TP/PP 形态 |
|---|---|
| 7B 或 8B 模型,普通上下文 | tp=1,一块 GPU,横向扩展副本 |
| 32B 模型,高并发 | 在单节点上使用 tp=2 或 tp=4 |
| 70B 级模型,BF16/FP16 | 在单台高内存节点上使用 tp=4 或 tp=8 |
| 跨节点的超大稠密模型 | 根据节点规模使用 tp=4, pp=2 或 tp=8, pp=2 |
| MoE 模型 | 请单独查看 vLLM 的 expert-parallel 指南;不要默认把 MoE 当作稠密模型处理 |
这张表只是起点,不是基准测试结果。你最终接受的输出成本取决于真实提示词、真实输出、重试率、排队行为以及质量验收标准。
需要关注的拓扑检查
在发布多 GPU 端点之前,请从提供商或机器上收集以下信息:
- 每个节点的
nvidia-smi topo -m输出; - 节点内 GPU 是否共享 NVLink 或 NVSwitch;
- 节点之间的网络结构,包括 InfiniBand、RoCE、EFA 或以太网;
- NCCL 可见的接口,以及流量是否走在预期路径上;
- 模型权重的存储路径,以及多个节点是否从较慢的共享磁盘加载;
- GPU 内存、MIG 状态、功耗上限以及驱动/CUDA 版本。
例如,NVIDIA DGX H100/H200 系统文档中描述它们是八 GPU 系统,具有 NVSwitch/NVLink GPU 到 GPU 连接能力以及 400 Gb/s 网络选项。普通 PCIe 节点也仍然可以很好地服务 vLLM,但你应当预期不同的通信特征,并据此进行基准测试。
有关互连背景,请参见 NVLink vs NVSwitch。关于集群采购和拓扑术语,GPU 集群租用指南 是一个很有用的补充。
生产验收测试
运行分阶段测试,而不是只做一个单一的理想路径提示。
- 拓扑测试:保存
nvidia-smi topo -m、NIC 清单和 NCCL 环境。 - 冷启动加载测试:测量从容器启动到第一个成功 token 的时间。
- 短提示测试:低提示长度、中等输出长度,符合预期的聊天工作负载。
- 长提示测试:接近你的产品需求的真实上下文长度。
- 并发扫描:逐步增加并发请求,直到 p95 首 token 时间或 p95 token 间延迟超过你的上限。
- 重输出测试:使用生成长文本的工作负载,而不只是分类提示。
- 故障测试:终止一个工作进程或一个节点,并验证负载均衡器已移除该副本。
- 重启测试:滚动重启 vLLM 进程,并确认模型缓存、Ray 状态和健康检查能够干净恢复。
至少跟踪以下指标:
| 指标 | 为什么重要 |
|---|---|
| 首 token 时间 | 用户在聊天和 agent 工作流中会立即感受到这一点。 |
| token 间延迟 | 显示生成开始后的解码稳定性。 |
| 每个副本的每秒 token 数 | 有助于比较 TP/PP 方案。 |
| GPU 内存余量 | 可预测长上下文峰值是否会导致 OOM。 |
| 排队时间 | 将服务容量与应用延迟区分开来。 |
| 错误和重试率 | 将基础设施不稳定性转化为真实成本。 |
| 被接受的输出率 | 避免为了优化廉价 token 而忽略用户拒绝的结果。 |
故障排查模式
模型已加载,但 GPU 越多吞吐量反而更差。
TP 组可能对该拓扑来说过大,或者工作负载的并发度不足,无法摊薄通信开销。请测试更小的 TP、更多副本,或不同的 batch/并发形态。
多节点启动卡住。
检查 Ray 成员关系、防火墙规则、NCCL 接口选择、容器网络,以及每个节点是否都能访问相同的模型路径。不要先从 API 层排查这个问题。
只有一块 GPU 发生 OOM,而其他 GPU 还有余量。
查看 pipeline stage 是否不均衡、GPU 型号是否不同、是否存在内存碎片,或者是否有 rank 分配问题。确认每个 worker 都在使用预期的可见 GPU。
长提示词下延迟飙升。
KV cache 压力、prefill 成本以及调度队列排队很可能是主要原因。在更换硬件之前,先测试不同提示长度区间。
端点在终端里可用,但放到负载均衡器后就失败。
检查流式超时、空闲超时、健康检查路径、请求体大小限制,以及负载均衡器是否在模型尚未预热时就把流量发送到某个副本。
何时不该自己运行 vLLM 多 GPU 推理
当你需要模型级控制、私有权重、自定义 kernel、自定义量化,或硬件级实验时,运行 vLLM 是正确选择。但如果业务需求只是“给我们的应用提供一个可靠的 OpenAI 兼容 API”,它并不一定是最佳选择。
在租用多节点 GPU 集群之前,请将自托管方案与托管模型/API 方案进行比较:
| 需求 | 在 GPU 上自托管 vLLM | 托管模型/API 基线 |
|---|---|---|
| 自定义/私有权重 | 非常适合 | 通常不够 |
| 硬件实验 | 非常适合 | 不是重点 |
| 快速产品集成 | 运维工作更多 | 非常适合 |
| 多模型切换 | 需要你运维每一套栈 | 一个网关即可简化访问 |
| 计费和使用可见性 | 需要自行构建或集成 | 通常已包含 |
| 故障处理 | 由你负责 | 由提供商/网关承担更多 |
当你希望拥有一个 OpenAI 兼容密钥、一个余额,并且无需自己运维 GPU 推理层就能访问官方模型端点时,Flatkey 就是一个对比基线。如果直接控制硬件不是产品需求,请在投入集群运维之前,先与模型/API 基线进行基准比较。
常见问题
vLLM 支持多 GPU 推理吗?
支持。vLLM 通过张量并行和流水线并行支持多 GPU 推理,并提供可覆盖单节点和多节点服务的执行器选项。具体支持路径取决于你的 vLLM 版本、模型架构、GPU 拓扑和部署后端。
vLLM 最佳的张量并行大小是多少?
最佳的张量并行大小,是在满足你的工作负载所需内存余量和吞吐量前提下,TP 值尽可能小的配置。先从一个高速节点中的 GPU 开始,然后用真实的提示词长度和输出长度对 tp=2、tp=4 或 tp=8 进行基准测试。
我应该在什么时候使用 vLLM 的流水线并行?
当模型或 KV-cache 需求迫使你超出单节点范围时,或者把张量并行通信限制在每个节点内比构建跨节点 TP 组更合适时,就使用流水线并行。
vLLM 多 GPU 服务是否必须使用 Ray?
对于多节点 vLLM 服务,Ray 通常是更实用的选择。对于单节点,你的 vLLM 版本所对应的多进程后端或默认后端可能更简单。
我如何判断一个 vLLM 多 GPU 推理配置是否已准备好投入生产?
只有在完成拓扑检查、冷启动加载测试、真实提示词/并发基准测试、健康检查、重启测试,并记录故障行为之后,才算具备生产就绪条件。单次成功的 curl 请求还远远不够。


