
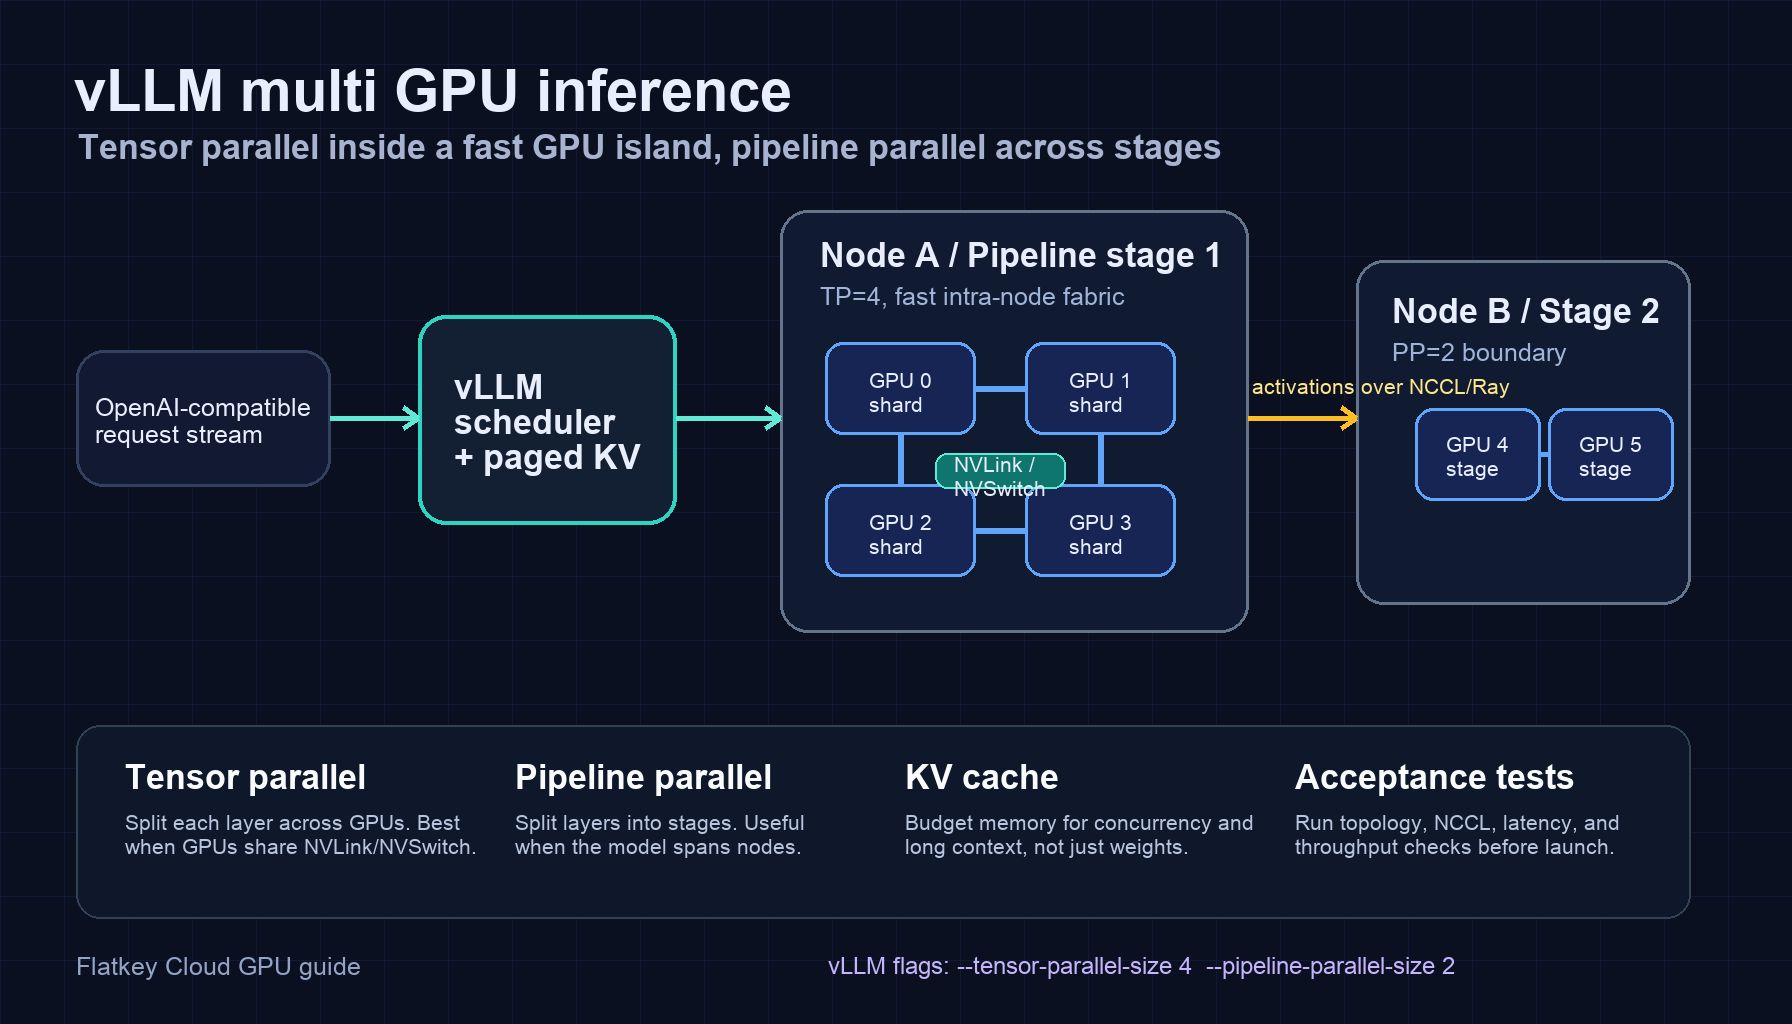
vLLM のマルチ GPU 推論は通常、次の3つの理由のいずれかで始まります。モデルの重みが1枚の GPU に収まらない、必要なコンテキストと同時実行数に対する KV キャッシュが1枚の GPU に収まらない、または1枚の GPU では必要な tokens-per-second と time-to-first-token の目標を達成できない、というものです。セットアップは --tensor-parallel-size の決定だけではありません。tensor parallelism、pipeline parallelism、executor backend、そして物理的な GPU トポロジーも揃える必要があります。
要点は次のとおりです。
- モデルが同じ高速 GPU アイランド内の複数 GPU に収まる場合、特に NVLink または NVSwitch を備えた 8-GPU の H100/H200/B200 ノードでは、まず tensor parallelism を使います。
- モデルが複数ノードにまたがる必要がある場合、または tensor parallel だけではノード間通信が多すぎる場合は、pipeline parallelism を追加します。
tp * ppを、1つの vLLM レプリカが使用する GPU ワーカー数として扱います。- セットアップを本番対応と呼ぶ前に、実際のプロンプト長、出力長、バッチ形状、モデル量子化でベンチマークを行います。
- チームが必要としているのが OpenAI 互換のエンドポイントだけで、ハードウェアを直接制御する必要がないなら、クラスタを借りて運用する前に、GPU パスと Flatkey のようなマネージドモデル/API ベースラインを比較してください。
このガイドでは、実践的な vLLM マルチ GPU 推論の例、アーキテクチャ図、起動コマンド、そして通常はユーザーより先に不適切なマルチ GPU セットアップを検出できるチェック項目を紹介します。
vLLMマルチGPU推論アーキテクチャ
vLLM では、tensor parallelism によって各 transformer layer の処理を複数の GPU ワーカーに分割します。pipeline parallelism はモデルの層をステージに分け、異なる GPU グループがモデルの異なる部分を実行するようにします。本番サービングでは、これらの選択はメモリ以上の影響を与えます。通信集約、リクエストスケジューリング、障害の影響範囲、そしてスケールアウトのネットワークがボトルネックになるかどうかが変わります。
一般的な開始時のアーキテクチャは次のとおりです。
| Layer | 実用上の選択 | 重要な理由 |
|---|---|---|
| API surface | vllm serve と OpenAI 互換サーバー |
アプリケーションチームは OpenAI スタイルのクライアントを使い続けながら、サービングバックエンドを変更できます。 |
| Tensor parallel group | 1つのノード、または1つの NVLink/NVSwitch アイランド | Tensor parallel の層は頻繁に通信するため、遅いノード間リンクはすぐに悪影響を及ぼします。 |
| Pipeline stages | モデルが1ノードに収まらない場合はノード単位またはラック単位で分割 | Pipeline parallelism は、すべての GPU にまたがる1つの tensor-parallel group を置く場合と比べて、ノード間通信量を減らせます。 |
| Distributed backend | 1ノードなら multiprocessing、マルチノードのオーケストレーションが必要なら Ray | 単一ノードのサービングはシンプルに保ち、ワーカーが複数マシンにまたがる場合に Ray を使います。 |
| KV cache plan | プロンプト長、出力長、同時実行数のための予算を確保 | 重みは出発点にすぎません。長文コンテキストのサービングは KV キャッシュが制約になることがあります。 |
| Acceptance test | トポロジー、NCCL、コールドロード、TTFT、スループット、障害復旧 | 多くの不適切なデプロイは、現実的なトラフィックが来るまで問題なく見えます。 |
近接するインフラ視点については、GPU cluster architecture guide を参照してください。メモリ見積もりについては、公開されたら LLM GPU memory requirements worksheet を使ってください。
vLLMのTensor ParallelとPipeline Parallel
最も役立つ判断基準はシンプルです。
高速な GPU アイランド内では tensor parallelism を使い、遅い境界をまたぐには pipeline parallelism を使います。
tensor parallelism は次のような場合に最初の選択肢として適しています。
- モデルが1枚の GPU には大きすぎるが、1つのノード内の 2、4、または8枚の GPU には収まる場合;
- GPU ノードに高帯域の GPU 間リンクがある場合;
- レイテンシが重要で、長い pipeline bubble を作らずに各リクエストを1つの論理モデルレプリカで処理したい場合;
- 対象のモデルファミリーが vLLM の tensor parallel 実行で十分にサポートされている場合。
pipeline parallelism が有効になるのは次のような場合です。
- 量子化や低精度化をしてもモデルが1つのノードに収まらない場合;
- tensor-parallel group が Ethernet や InfiniBand を頻繁にまたぐことになる場合;
- 各ノードにモデルのステージを持たせ、すべての層がノード間 collective に参加しない構成にしたい場合;
- pipeline stages に伴うスケジューリングと bubble のオーバーヘッドを許容できる場合。
tp=8 が常に tp=4 より良い、あるいは pp=2 が自動的にスループットを改善する、と決めつけないでください。vLLM のマルチ GPU 推論では、最適な形状はモデルサイズ、メモリ圧迫、インターコネクト、シーケンス長、そしてワークロードがどれだけのバッチ同時実行を維持できるかによって決まります。
単一ノードでのvLLMマルチGPU推論例
可能なら、まずは1ノードから始めてください。デバッグがしやすく、ベンチマークも安く済み、最初の障害ドメインとしてマルチノードネットワークを避けられます。
例: 4-GPU サーバー1台、vLLM レプリカ1つ、tensor parallel size 4。
CUDA_VISIBLE_DEVICES=0,1,2,3 \
vllm serve meta-llama/Llama-3.1-70B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4
モデルが4枚の GPU にきれいに収まり、そのノードに高速な GPU 間通信がある場合は、この形を使ってください。8-GPU ノードでは、--tensor-parallel-size 4 と --tensor-parallel-size 8 の両方を試してください。より大きなグループはメモリの余裕を増やせますが、通信オーバーヘッドが増えることがあります。
Basic smoke test:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-70B-Instruct",
    "messages": [{"role": "user", "content": "1文でGPUのヘルスチェックをしてください。"}],
    "max_tokens": 64
  }'
これが失敗する場合、まだマルチノードに進まないでください。まず、モデルのダウンロード、CUDA の可視性、NCCL の可視性、ドライバ/ランタイムの互換性、GPU メモリ圧迫を修正します。
Tensor 並列と pipeline 並列を使ったマルチノードの例
1つのノードで提供できる以上の GPU が必要な場合は、可能であれば tensor-parallel グループを各ノード内に収め、そのうえでノード間に pipeline 並列を使用します。
目標とする構成の例:
- 2ノード;
- ノードあたり4 GPU;
- tensor parallel サイズ 4;
- pipeline parallel サイズ 2;
- 総ワーカー数:
4 * 2 = 8。
概念的な起動例:
vllm serve meta-llama/Llama-3.1-405B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
実際のクラスタでは、まず head ノードで Ray を起動し、worker ノードをその Ray クラスタに参加させ、モデルストレージがすべてのノードから到達可能であることを確認し、vLLM サーバーを起動する前に、すべてのワーカーが意図した GPU 数を認識していることを確認します。後で再ビルドしても挙動が静かに変わらないように、正確な vLLM バージョン、CUDA イメージ、ドライバブランチ、モデルリビジョンを runbook に固定してください。
ここが、インフラの品質がプロダクトの品質になる分岐点です。2台目のノードが弱いネットワークで接続されていたり、NCCL が誤ったインターフェースを選んだり、モデルキャッシュのパスが遅かったりすると、ユーザーはそれをレイテンシのばらつき、長いコールドスタート、リクエスト失敗として体感します。
バックエンドの選択: multiprocessing か Ray か
vLLM のマルチGPU推論サポートでは、デプロイに合う最もシンプルな executor backend を使います:
| デプロイ | 推奨バックエンド | 注記 |
|---|---|---|
| 1台のマシン、複数GPU | Multiprocessing またはそのバージョンの vLLM デフォルト | 運用しやすく、構成要素が少ない。 |
| 複数マシン | Ray | ワーカーがノードをまたぎ、クラスタレベルの調整が必要な場合に必要。 |
| Kubernetes のマルチノード serving | Ray と、明示的な pod/network/storage 設計 | サービスプロセスが適切な GPU を見つけることを期待するのではなく、スケジューリング、配置、ヘルスチェックを見える化します。 |
バックエンドの選択はトポロジから切り離すべきではありません。モデルが1台のサーバーに収まらないために Ray が必要なだけなら、次の問いは pipeline 並列で高頻度通信の大半を各ノード内に収められるかどうかです。
TP と PP を選ぶ前のメモリ見積もり
vLLM のマルチGPU推論計画では、次の順序でメモリを見積もるべきです:
- 重み: dtype または量子化後のモデルパラメータ。
- KV キャッシュ: プロンプト長、出力長、バッチ同時実行数、キャッシュの dtype。
- ランタイムオーバーヘッド: CUDA graphs、アロケータの挙動、通信バッファ、tokenizer/server のオーバーヘッド、および安全な余裕。
- 運用上の余裕: ローリング再起動、モデル再読み込み、テレメトリ、そして時折発生するプロンプトの急増。
Tensor 並列はモデル重みと一部の計算負荷を GPU 間に分散しますが、通信を無料にするわけではありません。Pipeline 並列はステージごとのメモリ圧を下げられますが、ステージ間のバランスという課題を生みます。メモリ圧が大きい、またはカーネルが遅い pipeline ステージが、そのレプリカ全体のスループット上限になります。
実用的な最初の試行構成:
| モデル/ランタイムの状況 | 最初に試す TP/PP 構成 |
|---|---|
| 7B または 8B モデル、通常のコンテキスト | tp=1、1 GPU、レプリカを水平スケール |
| 32B モデル、高同時実行 | 1ノード上で tp=2 または tp=4 |
| 70B クラスのモデル、BF16/FP16 | 高メモリの1ノード上で tp=4 または tp=8 |
| ノードをまたぐ非常に大きい dense モデル | ノードサイズに応じて tp=4, pp=2 または tp=8, pp=2 |
| MoE モデル | vLLM の expert-parallel ガイダンスを別途確認する。MoE をデフォルトで dense モデルとして扱わないこと。 |
この表は出発点であり、ベンチマーク結果ではありません。実際の出力コストは、実際のプロンプト、実際の出力、再試行率、キューイングの挙動、品質受け入れに依存します。
重要なトポロジチェック
マルチGPU エンドポイントを公開する前に、プロバイダーまたはマシンから次の情報を収集してください:
- 各ノードの
nvidia-smi topo -mの出力; - ノード内で GPU が NVLink または NVSwitch を共有しているかどうか;
- InfiniBand、RoCE、EFA、Ethernet を含むノード間のネットワークファブリック;
- NCCL から見えるインターフェースと、トラフィックが意図した経路を使っているかどうか;
- モデル重みのストレージパスと、複数ノードが遅い共有ディスクからロードしていないかどうか;
- GPU メモリ、MIG 状態、電力制限、ドライバ/CUDA のバージョン。
たとえば NVIDIA DGX H100/H200 システムは、NVSwitch/NVLink による GPU 間接続と 400 Gb/s のネットワークオプションを備えた 8 GPU システムとして文書化されています。汎用の PCIe ノードでも vLLM は十分に運用できますが、通信プロファイルは異なるため、それに応じてベンチマークする必要があります。
インターコネクトの背景については、NVLink vs NVSwitch を参照してください。クラスタ購入とトポロジの用語については、GPU クラスタレンタルガイド が役立つ補足資料です。
本番受け入れテスト
単一の正常系プロンプトではなく、段階的なテストを実施してください。
- トポロジーテスト:
nvidia-smi topo -m、NIC インベントリ、NCCL 環境を保存します。 - コールドロードテスト: コンテナ起動から最初に成功したトークンまでの時間を測定します。
- 短いプロンプトのテスト: 短いプロンプト長、中程度の出力長、想定されるチャット負荷を使います。
- 長いプロンプトのテスト: 製品要件に近い、現実的なコンテキスト長を使います。
- 同時実行数スイープ: p95 の最初のトークンまでの時間、または p95 のトークン間レイテンシが許容上限を超えるまで、同時リクエスト数を増やします。
- 出力重視テスト: 分類プロンプトだけでなく、長い応答を生成するワークロードを使います。
- 障害テスト: 1 つのワーカープロセスまたは 1 台のノードを停止し、ロードバランサーがレプリカを削除することを確認します。
- 再起動テスト: vLLM プロセスをロールし、モデルキャッシュ、Ray の状態、ヘルスチェックが正常に回復することを確認します。
少なくとも次のメトリクスを追跡してください:
| メトリクス | 重要な理由 |
|---|---|
| 最初のトークンまでの時間 | チャットやエージェントのワークフローでは、ユーザーが即座に体感します。 |
| トークン間レイテンシ | 生成開始後のデコード安定性を示します。 |
| レプリカあたりの 1 秒あたりトークン数 | TP/PP の構成を比較するのに役立ちます。 |
| GPU メモリの余裕 | 長コンテキストのスパイクで OOM になるかを予測できます。 |
| キュー時間 | サービング क्षमताとアプリケーションレイテンシを分離します。 |
| エラー率とリトライ率 | インフラの不安定さを実コストに変換します。 |
| 受理された出力率 | ユーザーが拒否する安価なトークンの最適化を避けられます。 |
トラブルシューティングのパターン
モデルは読み込まれるが、GPUを増やすとスループットが悪化する。
TPグループがトポロジーに対して大きすぎる可能性があるか、ワークロードに通信を償却できるだけの並列性がない可能性があります。より小さいTP、より多いレプリカ、または別のバッチ/並列度の形状を試してください。
マルチノード起動がハングする。
Rayのメンバーシップ、ファイアウォールルール、NCCLのインターフェース選択、コンテナのネットワーク設定、そして各ノードが同じモデルパスに到達できるかを確認してください。まずAPI層からこれをデバッグしないでください。
1枚のGPUだけがOOMになり、他は余裕がある。
パイプライン段階の不均衡、異なるGPU SKU、メモリ断片化、またはランク割り当ての問題を確認してください。各ワーカーが意図した可視GPUを使用していることを確認してください。
長いプロンプトでレイテンシが急増する。
KVキャッシュの圧迫、prefillコスト、スケジューラのキューイングが主な原因と考えられます。ハードウェアを変更する前に、プロンプト長ごとのバケットを分けてテストしてください。
エンドポイントは端末では動くが、ロードバランサーの背後では失敗する。
ストリーミングのタイムアウト、アイドルタイムアウト、ヘルスチェックのパス、リクエスト本文の制限、そしてモデルが温まる前にロードバランサーがトラフィックをレプリカへ送っていないかを確認してください。
vLLMのマルチGPU推論を自分で実行すべきでない場合
モデルレベルの制御、プライベートな重み、カスタムカーネル、カスタム量子化、あるいはハードウェアレベルの実験が必要な場合は、vLLMを実行するのが適切です。ビジネス要件が単に「アプリに信頼できるOpenAI互換APIを提供してほしい」である場合に、自動的に適切な選択になるわけではありません。
マルチノードGPUクラスターを借りる前に、セルフホストの構成を管理されたモデル/API構成と比較してください。
| 要件 | GPU上でvLLMをセルフホスト | 管理されたモデル/APIの基準 |
|---|---|---|
| カスタム/プライベートな重み | 非常に適している | 通常は不十分 |
| ハードウェア実験 | 非常に適している | 主目的ではない |
| 高速な製品統合 | 運用作業が多い | 非常に適している |
| 複数モデルの切り替え | 各スタックを自分で運用する | 1つのゲートウェイでアクセスを簡素化できる |
| 課金と利用状況の可視化 | 自分で構築または統合する | 多くの場合含まれている |
| 障害対応 | 自分で責任を持つ | プロバイダー/ゲートウェイがより多くを処理する |
Flatkeyは、1つのOpenAI互換キー、1つの残高、そしてGPU提供レイヤーを自分で運用せずに公式モデルエンドポイントへアクセスしたい場合の比較対象です。直接のハードウェア制御が製品要件でないなら、クラスター運用に踏み切る前にモデル/APIの基準と比較してベンチマークしてください。
よくある質問
vLLMはマルチGPU推論をサポートしていますか?
はい。vLLMはテンソル並列とパイプライン並列を通じてマルチGPU推論をサポートしており、シングルノードとマルチノードのサービスに対応する実行方式があります。具体的な対応パスは、vLLMのバージョン、モデルアーキテクチャ、GPUトポロジー、デプロイバックエンドによって異なります。
vLLMで最適なテンソル並列サイズは何ですか?
最適なテンソル並列サイズは、ワークロードに対して十分なメモリの余裕とスループットを得られる最小のTP値です。まず1つの高速なノード内のGPUから始め、実際のプロンプト長と出力長に対してtp=2、tp=4、またはtp=8をベンチマークしてください。
vLLMでパイプライン並列を使うべきなのはいつですか?
モデルまたはKVキャッシュ要件が1ノードを超えることを強いる場合、またはテンソル並列の通信を各ノード内に閉じ込める方が、ノードをまたぐ単一のTPグループを作るより良い場合に、パイプライン並列を使ってください。
vLLMのマルチGPU提供にRayは必須ですか?
Rayは通常、マルチノードvLLM提供の実用的な選択肢です。1ノードの場合は、マルチプロセスバックエンドや、vLLMのバージョンに対するデフォルトバックエンドの方が簡単な場合があります。
vLLMのマルチGPU推論構成が本番運用に耐えうるかどうかは、どう判断しますか?
トポロジー確認、コールドロードテスト、現実的なプロンプト/並列度ベンチマーク、ヘルスチェック、再起動テスト、障害時の挙動が文書化された後でのみ、本番運用に耐えうると言えます。curlの単一成功リクエストだけでは不十分です。


