Apa Itu AI Factory? Klaster GPU, Data, Model, dan Operasi
Apa itu AI factory? AI factory adalah sistem operasi di sekitar AI perusahaan: kapasitas GPU, pipeline data, pelatihan atau fine-tuning model, penyajian inference, evaluasi, tata kelola, dan operasi biaya yang bekerja sebagai satu loop produksi yang dapat diulang.
Metafora ini penting karena AI tidak dihasilkan oleh GPU saja. Klaster GPU adalah ruang mesin, tetapi AI factory juga membutuhkan data yang dikurasi, scheduler, penyimpanan, jaringan, model registry, alur deployment, observabilitas, kontrol keamanan, dan model finansial untuk memutuskan kapan menyewa GPU, memesan klaster, menggunakan API terkelola, atau menggabungkan ketiganya.
NVIDIA mempopulerkan istilah ini seputar infrastruktur yang mengubah data menjadi kecerdasan, dan vendor seperti Dell Technologies dan HPE kini menggunakan "AI factory" untuk menggambarkan platform AI perusahaan full-stack. Bagi builder, pertanyaan yang berguna bukan lagi "siapa yang memiliki frasanya?" melainkan lebih praktis: bagian apa saja yang harus ada sebelum workload AI Anda menjadi sebuah factory, bukan sekadar eksperimen sekali jalan?
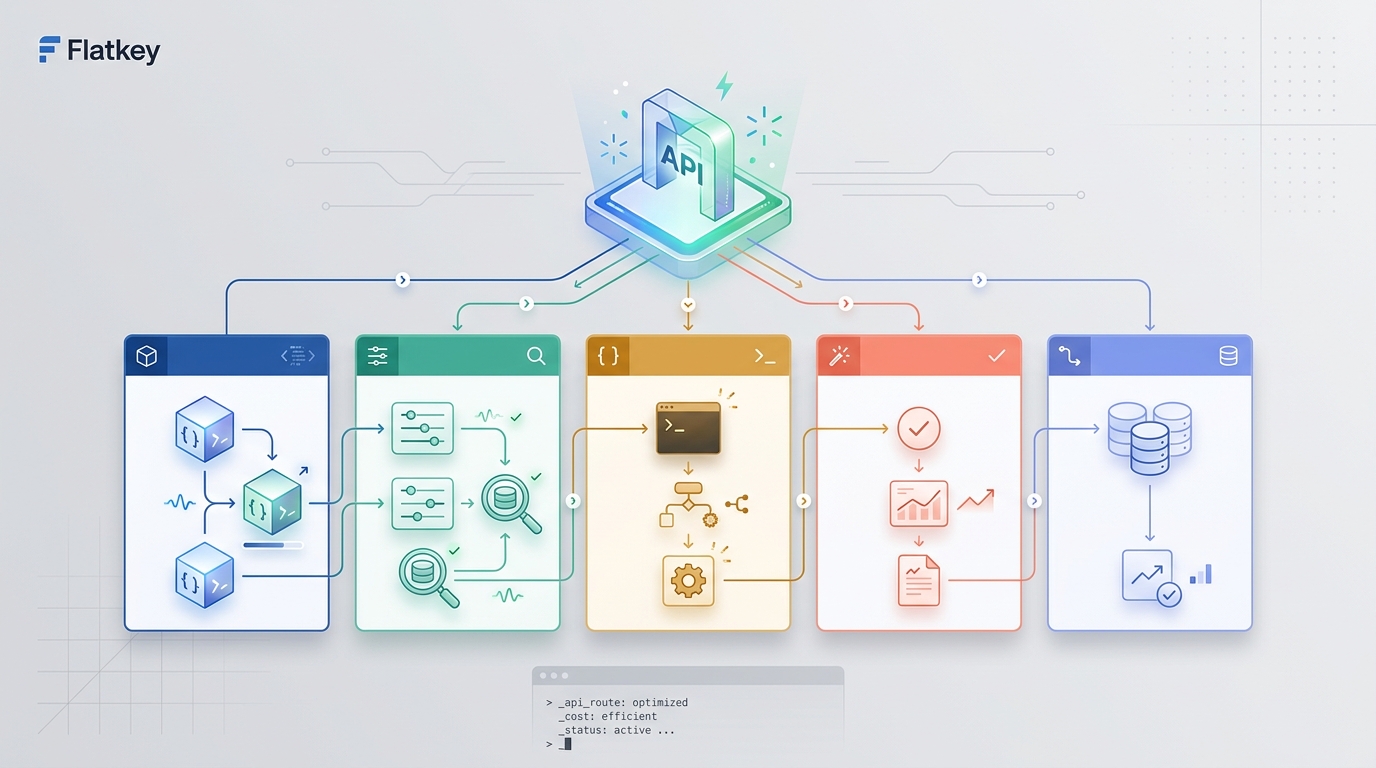
Panduan ini mendefinisikan apa itu AI factory, menjelaskan cara kerja AI factory, memetakan lapisan platform inti, dan menunjukkan di mana Flatkey cocok ketika sebuah tim menginginkan akses model/API tanpa harus mengoperasikan sendiri setiap lapisan infrastruktur GPU.
Definisi singkat: apa itu AI factory?
AI factory adalah lingkungan produksi yang mengubah data mentah, prompt, model, komputasi, dan umpan balik operasional menjadi output AI yang dapat digunakan. Dalam istilah bisnis, ini adalah sistem yang dapat diulang untuk membuat, menerapkan, mengukur, dan meningkatkan kemampuan AI.
Cara sederhana untuk memahaminya:
| Lapisan factory | Fungsinya | Pemilik umum |
|---|---|---|
| Kapasitas GPU dan akselerator | Menjalankan training, fine-tuning, batch inference, atau workload inference real-time | Infrastruktur, platform, sistem ML |
| Jaringan dan penyimpanan | Memindahkan dataset, checkpoint, embedding, log, dan artefak model tanpa hambatan | Infrastruktur, SRE, platform data |
| Pipeline data | Melakukan ingest, membersihkan, memberi label, memfilter, dan menyegarkan data yang digunakan oleh model dan aplikasi | Data engineering, platform ML |
| Siklus hidup model | Memilih foundation model, melakukan fine-tuning, evaluasi, versioning, dan peluncuran | ML engineering, produk AI |
| Serving dan routing | Mengirimkan output model melalui API, batch job, agen, atau aplikasi | Backend, platform, engineering AI |
| Operasi | Memantau latensi, error, utilisasi, biaya, keamanan, akses, dan pergeseran kualitas | SRE, FinOps, keamanan, tata kelola |
Jadi, ketika seseorang bertanya "apa itu AI factory?", jawaban terbaik adalah: itu adalah stack produksi penuh untuk AI, bukan hanya ruangan penuh GPU.
Bagaimana cara kerja AI factory?
AI factory bekerja dengan mengubah empat input menjadi loop output yang dikelola:
- Data masuk melalui event pelanggan, dokumen, kode, log, media, data sintetis, dataset publik, atau pemanggilan alat.
- Compute menjalankan data melalui job training, proses fine-tuning, pipeline retrieval, job embedding, batch inference, atau inference real-time.
- Model menghasilkan output melalui checkpoint, API yang di-host, model router, atau agen khusus domain.
- Operasi mengukur apakah output cukup andal, terjangkau, terkelola, dan berguna untuk tetap berada di produksi.
Loop itu berulang. AI factory yang matang mengumpulkan umpan balik dari pengguna dan sistem, mengubah umpan balik itu menjadi data evaluasi, meningkatkan prompt atau model, dan merilis versi berikutnya melalui deployment yang terkontrol.
Inilah sebabnya pembahasan AI factory mencakup desain pusat data sekaligus operasi produk. Sebuah klaster dapat melatih atau menyajikan model, tetapi factory hanya ada ketika tim dapat berulang kali menjawab:
- Workload mana yang memerlukan kontrol GPU langsung?
- Workload mana yang dapat menggunakan API model terkelola?
- Data mana yang diizinkan mencapai model mana?
- Output mana yang lolos evaluasi?
- Kegagalan mana yang harus di-retry, fail over, atau dihentikan?
- Tim, pelanggan, produk, atau lingkungan mana yang menimbulkan biaya?
AI factory vs klaster GPU
Klaster GPU adalah sumber daya komputasi. AI factory adalah sistem produksi yang menggunakan sumber daya komputasi.
Pembedaan ini penting karena banyak program AI yang mahal gagal pada lapisan di atas klaster. Tim membeli kapasitas, lalu menemukan bahwa pergerakan data, penyimpanan checkpoint, serving model, observabilitas, kontrol akses, dan atribusi biaya adalah penghalang yang sebenarnya.
Gunakan panduan sewa klaster GPU ketika Anda perlu membandingkan kapasitas GPU multi-node, topologi, jaringan, dan acceptance test. Gunakan model AI factory ketika Anda perlu memutuskan bagaimana komputasi, data, deployment model, dan operasi menjadi kapabilitas AI yang tahan lama.
| Pertanyaan | Jawaban klaster GPU | Jawaban AI factory |
|---|---|---|
| Apa yang kita beli? | Node, GPU, fabric jaringan, storage, dukungan | Sistem produksi AI yang dapat diulang |
| Apa yang dioptimalkan? | Throughput, utilisasi, ketersediaan, penyelesaian job | Output bisnis, kualitas, biaya, tata kelola, kecepatan iterasi |
| Siapa yang mengoperasikannya? | Infra, platform, SRE, sistem ML | Infra plus data, ML, produk, keamanan, keuangan |
| Apa yang bisa salah? | Jaringan jenuh, job gagal, GPU menganggur, kontensi antrean | Model yang salah, data yang lemah, output tidak aman, biaya membengkak, tata kelola yang hilang |
| Apa pertanyaan ekonomi unitnya? | Biaya per jam GPU atau per job | Biaya per output yang diterima, fitur, pelanggan, atau alur kerja |
Untuk pemodelan biaya, padukan artikel ini dengan lembar kerja TCO klaster GPU. Anggaran AI factory harus mencakup klaster, tetapi juga storage, egress, waktu engineering, kegagalan, evaluasi, observabilitas, dan tata kelola.
Lapisan platform AI factory
Apa itu platform AI factory? Ini adalah lapisan perangkat lunak dan infrastruktur yang memungkinkan tim menjalankan factory sebagai produk, bukan sekumpulan skrip.
Dalam praktiknya, platform AI factory biasanya mencakup tujuh lapisan.
1. Kapasitas dan perangkat keras
Lapisan ini mencakup GPU atau akselerator, host CPU, memori, penyimpanan lokal, desain rak, daya, pendinginan, dan pusat data atau region cloud tempat beban kerja berjalan.
Untuk pelatihan dan inferensi batch besar, tim memperhatikan kinerja multi-node, fabric jaringan, kecepatan checkpoint, dan perilaku scheduler. Untuk inferensi real-time, tim memperhatikan antrean, cold start, latensi ekor, autoscaling, dan uptime. Model kapasitas yang tepat bisa berupa sewa GPU on-demand, kapasitas GPU terreservasi, private GPU cloud, GPU serverless, colocation, atau klaster internal.
2. Jaringan dan penyimpanan
Beban kerja AI sering dibatasi oleh perpindahan, bukan matematika mentah. Job pelatihan memindahkan dataset dan checkpoint. Sistem retrieval memindahkan embedding dan dokumen sumber. Pembuatan media memindahkan file besar. Workflow agent mungkin memanggil tool, basis data, dan browser.
Artinya, platform AI factory membutuhkan lokalitas penyimpanan yang dapat diprediksi, aturan retensi data, rencana backup, dan jalur jaringan yang sesuai dengan beban kerja. Klaster dengan GPU cepat dan storage yang lemah tetap bisa berkinerja buruk.
3. Pipeline data
Pipeline data menentukan dari apa factory diizinkan untuk belajar dan dengan apa ia merespons. Ini mencakup ingestion, filtering, labeling, deduplikasi, penanganan privasi, batasan izin, pengecekan kualitas, dan jadwal penyegaran.
Untuk retrieval-augmented generation, pipeline data mungkin lebih penting daripada pilihan model. Untuk fine-tuning, masalah kualitas kecil bisa berubah menjadi kegagalan berulang di downstream. Untuk agent, tool data dan web menjadi bagian dari permukaan input factory.
4. Siklus hidup model
Siklus hidup model mencakup pemilihan model, desain prompt, fine-tuning, evaluasi, versioning, regression test, rollback, dan catatan rilis. Di sini tim memutuskan apakah akan menggunakan API model frontier, model open-weight di GPU sewaan, model gambar/video khusus, atau jalur hibrida.
Flatkey relevan di sini ketika tim ingin membandingkan dan merutekan lintas API model resmi tanpa mengelola banyak kunci provider dan saldo terpisah. Flatkey memberi developer satu key, satu saldo, dan satu invoice di ratusan model resmi dan tool pay-per-call, yang bisa lebih sederhana daripada mengubah setiap beban kerja menjadi infrastruktur milik sendiri.
5. Serving, routing, dan integrasi aplikasi
Serving mengubah model yang telah dilatih atau dipilih menjadi endpoint yang andal. Routing menentukan model, provider, region, atau jalur fallback mana yang harus menangani setiap permintaan.
Di sinilah AI factory bertemu aplikasi. Coding agent, copilot dukungan pelanggan, pipeline gambar, workflow video, atau tool riset internal tidak seharusnya perlu mengetahui setiap detail infrastruktur. Mereka membutuhkan API yang stabil, latensi yang dapat diprediksi, biaya yang dapat dilacak, dan mode kegagalan yang dapat dipulihkan.
Jika tim Anda sedang memutuskan apakah akan memiliki lapisan serving, baca GPU cloud vs model API. Ringkasnya: miliki serving GPU ketika kontrol hardware, model khusus, isolasi data, atau ekonomi unit membenarkan beban operasional; gunakan API model ketika kecepatan, keluasan, failover, dan beban platform yang lebih rendah lebih penting.
6. Observabilitas, evaluasi, dan tata kelola
AI factory harus mengukur lebih dari sekadar uptime. Ia harus melacak volume permintaan, latensi, error, retry, biaya, pilihan model, versi prompt, sumber data, filter keamanan, skor evaluasi, dan output yang diterima.
Tata kelola berada di samping observabilitas. Tim membutuhkan kontrol akses, audit log, aturan retensi, persetujuan vendor, batasan data pelanggan, dan jalur eskalasi untuk output yang tidak aman atau berkualitas rendah. Tanpa kontrol tersebut, factory mungkin meningkatkan risiko lebih cepat daripada nilai.
7. FinOps dan ritme operasional
AI factory mengubah komputasi menjadi output, tetapi tim keuangan tetap perlu mengetahui berapa biaya output tersebut. Model operasional harus mengatribusikan pengeluaran berdasarkan produk, lingkungan, pelanggan, tim, atau alur kerja.
Metrik unit yang berguna meliputi:
- Biaya per output yang diterima
- Biaya per aksi pengguna yang diselesaikan
- Biaya per panggilan tool yang berhasil
- Utilisasi GPU לפי kelas beban kerja
- Pemborosan dari retry dan kegagalan
- Tingkat hit cache
- Waktu tunggu antrean
- Tingkat fallback model
Nilai Flatkey paling kuat ketika tim menginginkan penggunaan model dan alat pada buku besar bersama, alih-alih akun penyedia yang terfragmentasi. Itu tidak menggantikan klaster GPU untuk infrastruktur kustom, tetapi dapat mengurangi kompleksitas untuk beban kerja model/API yang tidak memerlukan kontrol perangkat keras langsung.
Apa itu AI factory dalam istilah NVIDIA?
Dalam diskusi NVIDIA, apa yang biasanya dimaksud dengan AI factory? NVIDIA menggunakan istilah ini untuk menggambarkan infrastruktur yang mengubah data perusahaan menjadi kecerdasan, dengan GPU, jaringan berakselerasi, perangkat lunak, dan pola deployment yang bekerja bersama. Materi AI factory NVIDIA dan arsitektur referensi enterprise mereka berfokus pada desain full-stack, bukan hanya akselerator individual.
Pembingkaian itu berguna, tetapi juga dapat mengarahkan pembaca ke sudut pandang perangkat keras. Pembeli yang praktis harus menerjemahkan konsep NVIDIA menjadi daftar periksa operasional:
- Workload mana yang membutuhkan GPU NVIDIA secara langsung?
- Model mana yang dilatih, di-fine-tune, atau disajikan pada GPU tersebut?
- Sumber data mana yang memasok model?
- Stack perangkat lunak mana yang menjadwalkan dan mengamati job?
- Aplikasi mana yang mengonsumsi output?
- Tim mana yang bertanggung jawab atas keandalan, keamanan, dan biaya?
Jensen Huang sering membingkai AI factory sebagai generasi berikutnya dari pusat data karena mereka memproduksi token atau kecerdasan dari data dan energi. Anggap itu sebagai narasi makro. Implementasi Anda tetap membutuhkan sizing workload, tata kelola, desain tingkat layanan, dan model biaya.
Apa itu AI factory dalam konteks bisnis?
Dalam konteks bisnis, AI factory adalah kapabilitas organisasi. Ini memberi tim cara yang berulang untuk merilis fitur AI, workflow agen, kopilot internal, produk data, dan operasi otomatis.
Factory seharusnya menjawab pertanyaan bisnis dalam istilah operasional:
| Pertanyaan bisnis | Terjemahan AI factory |
|---|---|
| Bisakah kita meluncurkan fitur AI ini dengan aman? | Perizinan data, evaluasi model, fallback, log audit |
| Bisakah kita melakukan scale tanpa biaya mengejutkan? | Anggaran, batas laju, buku besar penggunaan, routing model, utilisasi GPU |
| Bisakah kita meningkatkan kualitas dari waktu ke waktu? | Loop umpan balik, set evaluasi, tes regresi, versioning prompt/model |
| Bisakah tim memakai ulang platform? | API bersama, template, observabilitas, kontrol akses |
| Bisakah kita mengganti model atau penyedia? | Lapisan abstraksi, rute yang kompatibel dengan OpenAI, benchmark model |
Ini juga alasan mengapa AI factory tidak otomatis menjadi investasi yang tepat untuk setiap tim. Jika produk hanya membutuhkan teks standar, gambar, video, pencarian, browser, enrichment, atau panggilan alat agen, gateway model dan alat yang dikelola mungkin lebih cepat mencapai produksi. Jika produk membutuhkan bobot model kustom, kontrol data plane privat, inferensi volume tinggi, atau pipeline media khusus, factory berbasis GPU mungkin layak.
Bangun, sewa, atau gunakan API model?
Strategi AI factory yang tepat biasanya bersifat hibrida.
Bangun atau alokasikan kapasitas GPU ketika:
- Anda menjalankan inferensi volume tinggi secara stabil dan dapat menjaga GPU tetap terutilisasi.
- Anda membutuhkan bobot model kustom, penyajian model privat, atau kernel khusus.
- Anda dapat mengoperasikan penyimpanan, jaringan, penjadwalan, keamanan, dan respons insiden.
- Biaya workload per output yang diterima lebih rendah setelah memasukkan semua biaya tersembunyi.
Sewa klaster GPU ketika:
- Anda membutuhkan lonjakan pelatihan, fine-tuning, evaluasi, atau inferensi batch.
- Anda ingin memvalidasi bentuk workload sebelum membeli atau mengalokasikan kapasitas.
- Anda memerlukan akselerator, region, atau topologi tertentu untuk proyek yang terdefinisi.
- Anda dapat mentoleransi pekerjaan setup dan pengujian penerimaan.
Gunakan API model atau gateway ketika:
- Anda membutuhkan akses cepat ke banyak model dan modalitas.
- Workload sering berubah.
- Failover penyedia lebih penting daripada kontrol perangkat keras mentah.
- Tim Anda menginginkan satu API key, satu tagihan, dan kontrol penggunaan, bukan akun penyedia yang tersebar.
- Anda membutuhkan alat seperti pencarian, otomasi browser, enrichment data, atau API media dalam workflow yang sama.
Untuk banyak tim, AI factory bukan satu tempat. Ini adalah model operasional yang mencakup GPU sewaan, API terkelola, layanan internal, dan alat agen.
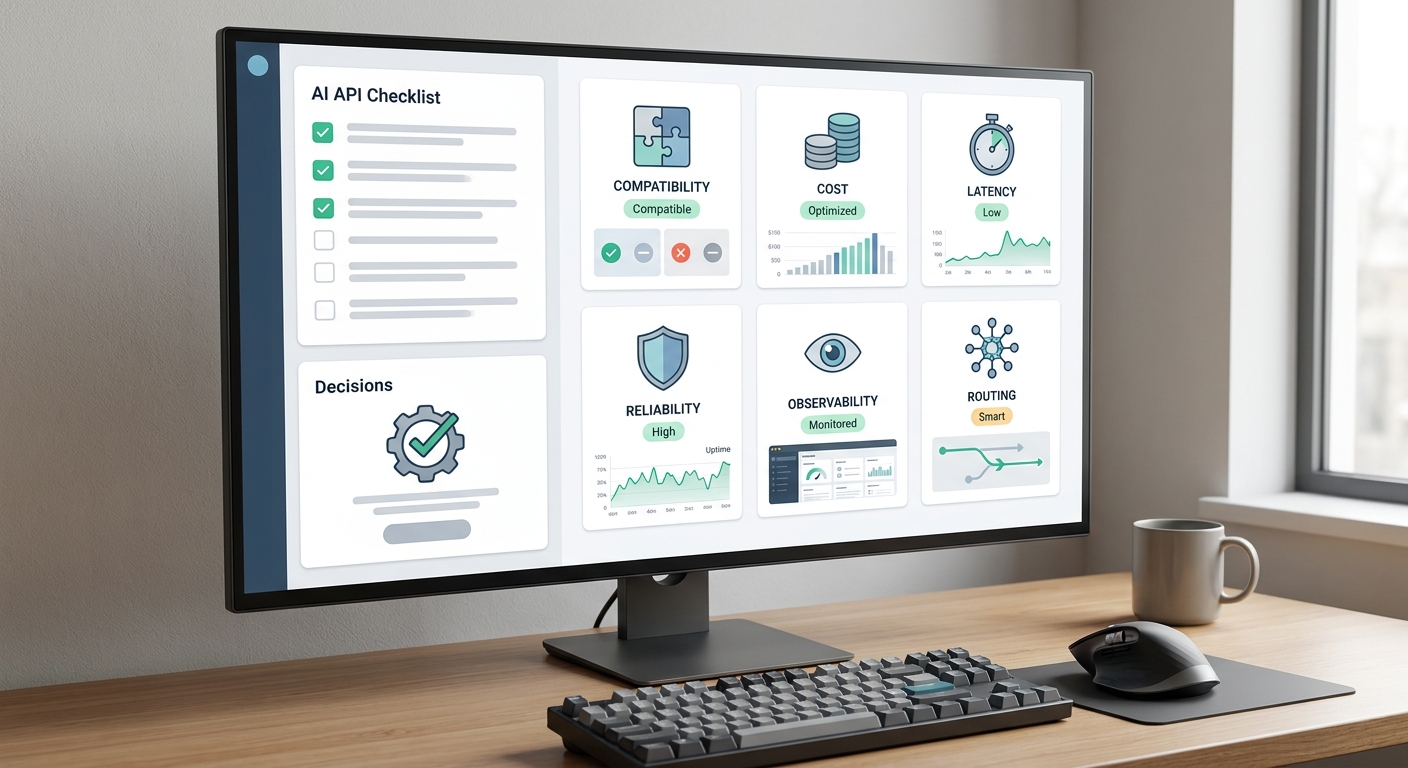
Daftar periksa evaluasi AI factory
Sebelum berinvestasi pada platform AI factory, ajukan pertanyaan-pertanyaan ini:
- Workload: Apakah kita melatih, fine-tuning, membuat embedding, menyajikan, menghasilkan media, menjalankan agen, atau semuanya?
- Latensi: Workload mana yang real time, batch, asinkron, atau human-in-the-loop?
- Data: Dataset, dokumen, log, dan output alat mana yang memasok sistem, dan siapa yang dapat mengaksesnya?
- Strategi model: Model mana yang dimiliki, disewa, open-weight, frontier API, multimodal, atau spesialis?
- Serving: Apakah aplikasi membutuhkan endpoint internal yang stabil, API yang kompatibel dengan OpenAI, atau akses klaster langsung?
- Keandalan: Apa yang terjadi saat model, penyedia, node GPU, jalur penyimpanan, atau antrean gagal?
- Biaya: Berapa biaya per output yang diterima setelah retry, waktu idle, penyimpanan, egress, engineering, dan dukungan?
- Tata kelola: Bagaimana prompt, output, sumber data, pengguna, dan versi model diaudit?
- Portabilitas: Bisakah workload berpindah antar penyedia, region, keluarga model, atau tipe GPU?
- Kepemilikan: Tim mana yang memiliki factory setelah peluncuran?
Jika tim Anda belum dapat menjawab pertanyaan-pertanyaan itu, mulailah lebih kecil. Gunakan API terkelola untuk jalur produksi pertama, ukur penggunaan nyata, lalu pindahkan workload yang jelas-jelas membenarkan kontrol GPU langsung ke platform AI factory yang lebih formal.
Kesalahan umum
Kesalahan pertama adalah memperlakukan AI factory sebagai proyek pengadaan. Membeli GPU tidak sama dengan membangun sistem produksi AI.
Kesalahan kedua adalah mengabaikan operasi data. Kualitas data yang buruk, izin yang tidak jelas, pipeline retrieval yang lemah, dan set evaluasi yang tidak tersedia menciptakan risiko hilir yang lebih besar daripada pilihan model saja.
Kesalahan ketiga adalah hanya mengukur harga GPU per jam. Untuk AI produksi, ukur pekerjaan berguna yang selesai. Harga sewa GPU hanya salah satu input; waktu antre, retry, pekerjaan yang gagal, penyimpanan, perpindahan data, dan waktu staf juga penting.
Kesalahan keempat adalah membangun factory khusus untuk beban kerja yang seharusnya menggunakan API. Jika rute model resmi yang dikelola sudah cukup baik, biaya peluang menjalankan infrastruktur bisa melebihi penghematannya.
Kesalahan kelima adalah melewatkan desain kegagalan. Sistem AI gagal melalui overload, drift model, insiden penyedia, penolakan kebijakan, retrieval yang buruk, error alat, dan retry yang tak terkendali. Factory perlu kontrol sebelum traffic datang.
Pertanyaan yang sering diajukan
Apa itu AI factory dan bagaimana cara kerjanya?
AI factory adalah sistem produksi yang mengubah data, model, komputasi, dan umpan balik operasional menjadi output AI. Cara kerjanya adalah dengan menggabungkan kapasitas GPU atau API, pipeline data, manajemen siklus hidup model, serving, observabilitas, tata kelola, dan operasi biaya ke dalam loop yang dapat diulang.
Apa itu platform AI factory?
Platform AI factory adalah infrastruktur dan tumpukan perangkat lunak yang digunakan untuk menjalankan loop tersebut. Ini dapat mencakup klaster GPU, penyimpanan, jaringan, scheduler, pipeline data, registry model, endpoint serving, pemantauan, tata kelola, kontrol biaya, dan gateway model/API.
Apa itu AI factory NVIDIA?
Dalam kerangka NVIDIA, AI factory adalah infrastruktur terakselerasi yang mengubah data perusahaan menjadi intelijen menggunakan GPU, jaringan, perangkat lunak, dan arsitektur referensi. Inti yang berguna adalah bahwa AI factory membutuhkan tumpukan lengkap di sekitar GPU: data, model, deployment, observabilitas, dan operasi.
Apa itu AI factory NVIDIA Jensen Huang?
Ketika Jensen Huang berbicara tentang AI factory, ia biasanya menggambarkan pergeseran dari pusat data tradisional yang menyimpan dan menyajikan informasi ke pusat data terakselerasi yang menghasilkan token, prediksi, atau intelijen. Bagi operator, visi itu tetap harus diterjemahkan menjadi sizing beban kerja, tata kelola data, model serving, dan kontrol biaya.
Apa itu AI factory dalam konteks bisnis?
Dalam konteks bisnis, AI factory adalah kapabilitas yang dapat diulang untuk meluncurkan dan meningkatkan fitur AI. Ini memberi tim cara yang terkontrol untuk mengubah data perusahaan dan kapasitas model eksternal menjadi alur kerja yang berguna, sambil melacak kualitas, biaya, risiko, dan kepemilikan.
Inti kesimpulan
Apa itu AI factory? Ini adalah sistem produksi yang mengubah AI dari eksperimen terisolasi menjadi kapabilitas operasional. Klaster GPU itu penting, tetapi hanya satu lapisan. Factory juga membutuhkan pipeline data, manajemen siklus hidup model, serving, routing, evaluasi, tata kelola, dan kontrol finansial.
Untuk beban kerja yang memerlukan model kustom atau kontrol hardware langsung, rencanakan seluruh tumpukan AI factory sebelum membeli kapasitas. Untuk beban kerja yang dapat menggunakan API model resmi dan alat, Flatkey dapat menyediakan jalur yang lebih sederhana: satu kunci, satu saldo, satu invoice, dan routing lintas model serta alat bayar-per-panggil sementara tim Anda mempelajari beban kerja mana yang benar-benar membutuhkan factory sendiri.
Sumber dan bacaan lanjutan
- NVIDIA: AI Factory
- NVIDIA Docs: Gambaran Desain AI Factory
- Dell Technologies: Dell AI Factory dengan NVIDIA
- HPE: Apa itu AI factory?
- Flatkey: TCO klaster GPU
- Flatkey: Cloud GPU vs API model