AIファクトリーとは? GPUクラスター、データ、モデル、運用
AIファクトリーとは何でしょうか? AIファクトリーとは、エンタープライズAIを支えるオペレーティングシステムのようなものです。GPU क्षमता、データパイプライン、モデルの学習またはファインチューニング、推論サービング、評価、ガバナンス、コスト運用が、1つの反復可能な生産ループとして連携して機能します。
この比喩が重要なのは、AIはGPUだけで生み出されるものではないからです。GPUクラスターはエンジンルームに相当しますが、AIファクトリーには、整備されたデータ、スケジューラ、ストレージ、ネットワーキング、モデルレジストリ、デプロイワークフロー、可観測性、セキュリティ制御、そしてGPUをいつ借りるか、クラスターを予約するか、マネージドAPIを使うか、あるいはその3つを組み合わせるかを判断するための財務モデルも必要です。
NVIDIAは、データをインテリジェンスへ変換するインフラを指す言葉としてこの用語を広めました。また、Dell TechnologiesやHPEのようなベンダーは現在、「AIファクトリー」という言葉を使ってフルスタックのエンタープライズAIプラットフォームを表現しています。構築者にとって本当に重要なのは、「誰がこの言葉の権利を持つか」よりも、実際には、AIワークロードが一度きりの実験ではなくファクトリーになる前に、どのような要素が存在していなければならないのか、という点です。
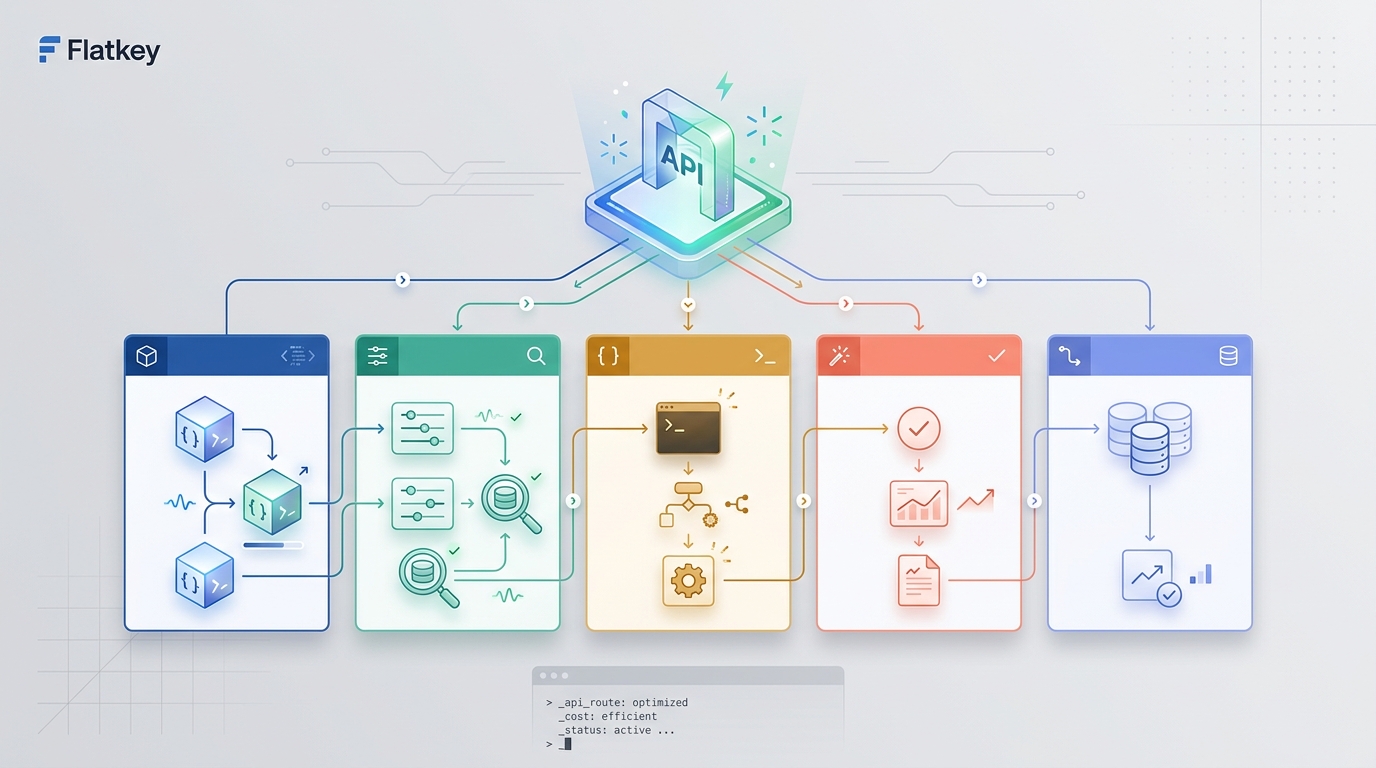
このガイドでは、AIファクトリーとは何かを定義し、AIファクトリーがどのように機能するかを説明し、コアとなるプラットフォーム層を整理し、チームがGPUインフラの各層を自前で運用せずにモデル/APIへアクセスしたい場合にFlatkeyがどこに当てはまるのかを示します。
簡単な定義: AIファクトリーとは?
AIファクトリーとは、生データ、プロンプト、モデル、コンピュート、運用フィードバックを、利用可能なAI出力へ変換する生産環境です。ビジネスの観点では、AI機能を作成、展開、測定、改善するための反復可能なシステムです。
次のように考えると分かりやすいでしょう。
| ファクトリー層 | 役割 | 主な担当 |
|---|---|---|
| GPUおよびアクセラレータ容量 | 学習、ファインチューニング、バッチ推論、リアルタイム推論のワークロードを実行する | インフラ、プラットフォーム、MLシステム |
| ネットワークとストレージ | データセット、チェックポイント、埋め込み、ログ、モデルアーティファクトをボトルネックなく移動する | インフラ、SRE、データプラットフォーム |
| データパイプライン | モデルやアプリケーションが使用するデータを取り込み、クレンジングし、ラベル付けし、フィルタリングし、更新する | データエンジニアリング、MLプラットフォーム |
| モデルライフサイクル | 基盤モデルを選定し、ファインチューニングし、評価し、バージョン管理し、展開する | MLエンジニアリング、AIプロダクト |
| サービングとルーティング | API、バッチジョブ、エージェント、またはアプリケーションを通じてモデル出力を提供する | バックエンド、プラットフォーム、AIエンジニアリング |
| 運用 | レイテンシ、エラー、利用率、コスト、安全性、アクセス、品質の劣化を監視する | SRE、FinOps、セキュリティ、ガバナンス |
したがって、「AIファクトリーとは何か?」と聞かれたら、最も適切な答えは、GPUが並んだ部屋そのものではなく、AIのための完全な生産スタックだ、ということです。
AIファクトリーはどのように機能するのか?
AIファクトリーは、4つの入力を管理された出力ループへ変換することで機能します。
- データは、顧客イベント、文書、コード、ログ、メディア、合成データ、公開データセット、またはツール呼び出しを通じて入力されます。
- コンピュートは、データを学習ジョブ、ファインチューニング実行、検索パイプライン、埋め込みジョブ、バッチ推論、またはリアルタイム推論に通します。
- モデルは、チェックポイント、ホスト型API、モデルルーター、またはドメイン固有エージェントを通じて出力を生成します。
- 運用は、出力が信頼でき、手頃なコストで、ガバナンスが効き、本番で使い続けるのに十分有用かどうかを測定します。
このループは繰り返されます。成熟したAIファクトリーは、ユーザーやシステムからのフィードバックを収集し、そのフィードバックを評価データへ変換し、プロンプトやモデルを改善し、制御されたデプロイメントを通じて次のバージョンをリリースします。
そのため、AIファクトリーの議論には、データセンター設計とプロダクト運用の両方が含まれます。クラスターはモデルを学習または提供できますが、チームが次の問いに繰り返し答えられるようになって初めて、ファクトリーは成立します。
- どのワークロードに直接的なGPU制御が必要か?
- どのワークロードはマネージドモデルAPIを使えるか?
- どのデータがどのモデルに到達することを許可されているか?
- どの出力が評価を通過するか?
- どの障害を再試行し、フェイルオーバーし、停止すべきか?
- どのチーム、顧客、プロダクト、または環境がそのコストを生み出したか?
AIファクトリー vs GPUクラスター
GPUクラスターはコンピュートリソースです。AIファクトリーは、そのコンピュートリソースを使う生産システムです。
この違いが重要なのは、多くの高コストなAIプロジェクトがクラスターより上位の層で失敗するからです。チームは容量を購入したものの、データ移動、チェックポイント保存、モデルサービング、可観測性、アクセス制御、コスト配賦こそが本当の障害だと気づきます。
複数ノードのGPU容量、トポロジー、ネットワーキング、受け入れテストを比較したい場合は、GPUクラスターのレンタルガイドを参照してください。コンピュート、データ、モデルのデプロイ、運用がどのように持続的なAI機能になるかを判断したい場合は、AIファクトリーモデルを使います。
| 質問 | GPUクラスターの答え | AIファクトリーの答え |
|---|---|---|
| 何を購入しているのか? | ノード、GPU、ネットワークファブリック、ストレージ、サポート | 再現可能なAI生産システム |
| 何が最適化されるのか? | スループット、利用率、可用性、ジョブ完了 | ビジネス成果、品質、コスト、ガバナンス、反復速度 |
| 誰が運用するのか? | インフラ、プラットフォーム、SRE、MLシステム | インフラに加えてデータ、ML、プロダクト、セキュリティ、財務 |
| 何が問題になり得るのか? | 輻輳したネットワーク、失敗したジョブ、アイドル状態のGPU、キューの競合 | 誤ったモデル、弱いデータ、安全でない出力、暴走するコスト、欠けたガバナンス |
| 単位経済性の問いは何か? | GPU時間またはジョブあたりのコスト | 承認済みの出力、機能、顧客、またはワークフローあたりのコスト |
コストモデリングでは、この記事とGPUクラスターTCOワークシートを組み合わせてください。AIファクトリーの予算にはクラスターだけでなく、ストレージ、エグレス、エンジニアリング時間、障害、評価、オブザーバビリティ、ガバナンスも含めるべきです。
AIファクトリーのプラットフォームレイヤー
AIファクトリープラットフォームとは何でしょうか? それは、チームがスクリプトの集合ではなく、製品としてファクトリーを運用できるようにするソフトウェアとインフラのレイヤーです。
実際には、AIファクトリープラットフォームは通常7つのレイヤーで構成されます。
1. キャパシティとハードウェア
このレイヤーには、GPUまたはアクセラレータ、CPUホスト、メモリ、ローカルストレージ、ラック設計、電力、冷却、そしてワークロードが実行されるデータセンターまたはクラウドリージョンが含まれます。
トレーニングや大規模バッチ推論では、チームはマルチノード性能、ネットワークファブリック、チェックポイント速度、スケジューラの挙動を重視します。リアルタイム推論では、キューイング、コールドスタート、レイテンシのテール、自動スケーリング、稼働率が重要です。適切なキャパシティモデルは、オンデマンドGPUレンタル、予約済みGPUキャパシティ、プライベートGPUクラウド、サーバーレスGPU、コロケーション、または社内クラスターになり得ます。
2. ネットワークとストレージ
AIワークロードは、純粋な計算よりも移動によって制約されることがよくあります。トレーニングジョブはデータセットとチェックポイントを移動します。検索システムは埋め込みとソースドキュメントを移動します。メディア生成は大容量ファイルを移動します。エージェントワークフローはツール、データベース、ブラウザを呼び出すことがあります。
つまり、AIファクトリープラットフォームには、予測可能なストレージの局所性、データ保持ルール、バックアップ計画、そしてワークロードに合ったネットワーク経路が必要です。高速なGPUを備えていても、ストレージが弱いクラスターは性能が出ないことがあります。
3. データパイプライン
データパイプラインは、ファクトリーが何を学習し、何に応答することを許されるかを決定します。これには、取り込み、フィルタリング、ラベリング、重複排除、プライバシー処理、権限境界、品質チェック、更新スケジュールが含まれます。
検索拡張生成では、モデル選択よりもデータパイプラインのほうが重要な場合があります。ファインチューニングでは、小さな品質問題が下流で繰り返し失敗を引き起こすことがあります。エージェントでは、データツールとWebツールがファクトリーの入力面の一部になります。
4. モデルのライフサイクル
モデルのライフサイクルには、モデル選択、プロンプト設計、ファインチューニング、評価、バージョン管理、回帰テスト、ロールバック、リリースノートが含まれます。ここでは、チームがフロンティアモデルAPIを使うのか、レンタルGPU上のオープンウェイトモデルを使うのか、専用の画像/動画モデルを使うのか、あるいはハイブリッド方式を採るのかを決めます。
Flatkeyは、チームが多くのプロバイダーキーや個別の残高を管理せずに、公式モデルAPI間で比較し、ルーティングしたい場合にここで役立ちます。Flatkeyは、何百もの公式モデルと従量課金ツールに対して、1つのキー、1つの残高、1つの請求書を開発者に提供するため、すべてのワークロードを自前のインフラに変えるよりもシンプルな場合があります。
5. サービング、ルーティング、アプリケーション統合
サービングは、学習済みまたは選択済みのモデルを信頼性の高いエンドポイントに変えます。ルーティングは、各リクエストをどのモデル、プロバイダー、リージョン、またはフォールバック経路で処理するかを決定します。
ここでAIファクトリーはアプリケーションと接続されます。コーディングエージェント、カスタマーサポートのコパイロット、画像パイプライン、動画ワークフロー、社内調査ツールは、すべてのインフラ詳細を知る必要はありません。必要なのは、安定したAPI、予測可能なレイテンシ、追跡可能なコスト、そして復旧可能な障害モードです。
サービング層を自前で持つべきかを判断しているなら、GPUクラウド vs モデルAPIをお読みください。短く言うと、ハードウェア制御、カスタムモデル、データ分離、または単位経済性が運用負荷を正当化するならGPUサービングを自前で持ち、速度、幅広さ、フェイルオーバー、より低いプラットフォーム負担が重要ならモデルAPIを使います。
6. オブザーバビリティ、評価、ガバナンス
AIファクトリーは稼働率以上のものを測定しなければなりません。リクエスト量、レイテンシ、エラー、再試行、コスト、モデル選択、プロンプトのバージョン、データソース、安全性フィルター、評価スコア、承認済み出力を追跡すべきです。
ガバナンスはオブザーバビリティと並んで存在します。チームには、アクセス制御、監査ログ、保持ルール、ベンダー承認、顧客データの境界、安全でない出力や品質の低い出力に対するエスカレーション経路が必要です。これらの制御がなければ、ファクトリーは価値よりもリスクを速く拡大してしまう可能性があります。
7. FinOpsと運用サイクル
AIファクトリーは計算を成果に変えますが、財務チームはその成果がいくらかかるのかを知る必要があります。運用モデルは、プロダクト、環境、顧客、チーム、またはワークフローごとに支出を配賦すべきです。
有用な単位指標には以下が含まれます:
- 承認済み出力あたりのコスト
- 完了したユーザーアクションあたりのコスト
- 成功したツール呼び出しあたりのコスト
- ワークロードクラス別のGPU利用率
- 再試行と失敗による無駄
- キャッシュヒット率
- キュー待ち時間
- モデルのフォールバック率
Flatkey の価値は、チームが分断されたプロバイダーアカウントではなく、共有台帳上でモデルとツールの利用を管理したいときに最も強く発揮されます。これはカスタムインフラ向けの GPU クラスターを置き換えるものではありませんが、直接的なハードウェア制御を必要としないモデル/API ワークロードでは、複雑さを軽減できます。
NVIDIA の用語では AI ファクトリーとは何ですか?
AI factory NVIDIA の議論は通常、何を指すのでしょうか? NVIDIA はこの用語を、GPU、アクセラレーテッドネットワーキング、ソフトウェア、デプロイメントパターンが連携して、企業データをインテリジェンスへ変換するインフラを指すために使っています。NVIDIA の AI factory 資料とエンタープライズ参照アーキテクチャは、個々のアクセラレータだけでなく、フルスタック設計に焦点を当てています。
この枠組みは有用ですが、読者をハードウェア視点へ偏らせる可能性もあります。実際の導入者は、NVIDIA の概念を次の運用チェックリストに落とし込むべきです。
- どのワークロードが NVIDIA GPU を直接必要とするか?
- それらの GPU 上で、どのモデルが学習、ファインチューニング、または提供されるか?
- どのデータソースがモデルに入力されるか?
- どのソフトウェアスタックがジョブをスケジュールし、監視するか?
- どのアプリケーションが出力を利用するか?
- 信頼性、セキュリティ、コストはどのチームが責任を持つか?
Jensen Huang は、AI ファクトリーをデータセンターの次世代として捉えることがよくあります。データとエネルギーからトークンやインテリジェンスを生産するからです。これはマクロな物語として受け止めてください。実装には、依然としてワークロードのサイジング、ガバナンス、サービスレベル設計、コストモデルが必要です。
ビジネスコンテキストでは AI ファクトリーとは何ですか?
ビジネスコンテキストでは、AI ファクトリーは組織能力です。チームが AI 機能、エージェントワークフロー、社内コパイロット、データ製品、自動化運用を繰り返し実行できる方法を提供します。
ファクトリーは、運用上の観点でビジネス上の問いに答えられる必要があります。
| ビジネス上の問い | AI ファクトリーへの言い換え |
|---|---|
| この AI 機能を安全にリリースできるか? | データ権限、モデル評価、フォールバック、監査ログ |
| 予想外のコストなしにスケールできるか? | 予算、レート制限、利用台帳、モデルルーティング、GPU 利用率 |
| 時間の経過とともに品質を改善できるか? | フィードバックループ、評価セット、回帰テスト、プロンプト/モデルのバージョニング |
| チームはプラットフォームを再利用できるか? | 共有 API、テンプレート、可観測性、アクセス制御 |
| モデルやプロバイダーを切り替えられるか? | 抽象化レイヤー、OpenAI 互換ルート、モデルベンチマーク |
これが、AI ファクトリーがすべてのチームにとって自動的に最適な投資ではない理由でもあります。プロダクトが標準的なテキスト、画像、動画、検索、ブラウザー、エンリッチメント、またはエージェントのツール呼び出しだけを必要とするなら、マネージドモデルとツールゲートウェイの方が、より早く本番に到達できる場合があります。プロダクトがカスタムモデル重み、プライベートなデータプレーン制御、大量推論、または特殊なメディアパイプラインを必要とするなら、GPU ベースのファクトリーが正当化されるかもしれません。
構築するか、借りるか、モデル API を使うか?
適切な AI ファクトリー戦略は、通常ハイブリッドです。
次の場合は、GPU 容量を構築または確保します。
- 安定的で高ボリュームな推論を行い、GPU を高稼働率に保てる。
- カスタムモデル重み、プライベートなモデル提供、または特殊なカーネルが必要。
- ストレージ、ネットワーキング、スケジューリング、セキュリティ、インシデント対応を運用できる。
- 隠れコストをすべて含めた後でも、ワークロードの受理済み出力あたりのコストが低い。
次の場合は GPU クラスターを借ります。
- 学習、ファインチューニング、評価、またはバッチ推論の突発的な需要がある。
- 容量を購入または確保する前に、ワークロードの形状を検証したい。
- 定義済みプロジェクトのために、特定のアクセラレータ、リージョン、またはトポロジーが必要。
- セットアップと受け入れテストの作業を許容できる。
次の場合は、モデル API またはゲートウェイを使います。
- 多くのモデルとモダリティへ素早くアクセスしたい。
- ワークロードが頻繁に変わる。
- 生のハードウェア制御よりも、プロバイダーのフェイルオーバーが重要。
- 散在するプロバイダーアカウントではなく、1つの API キー、1つの請求書、利用制御を求めている。
- 同じワークフロー内で、検索、ブラウザー自動化、データエンリッチメント、またはメディア API のようなツールが必要。
多くのチームにとって、AI ファクトリーは単一の場所ではありません。レンタル GPU、マネージド API、社内サービス、エージェントツールにまたがる運用モデルです。
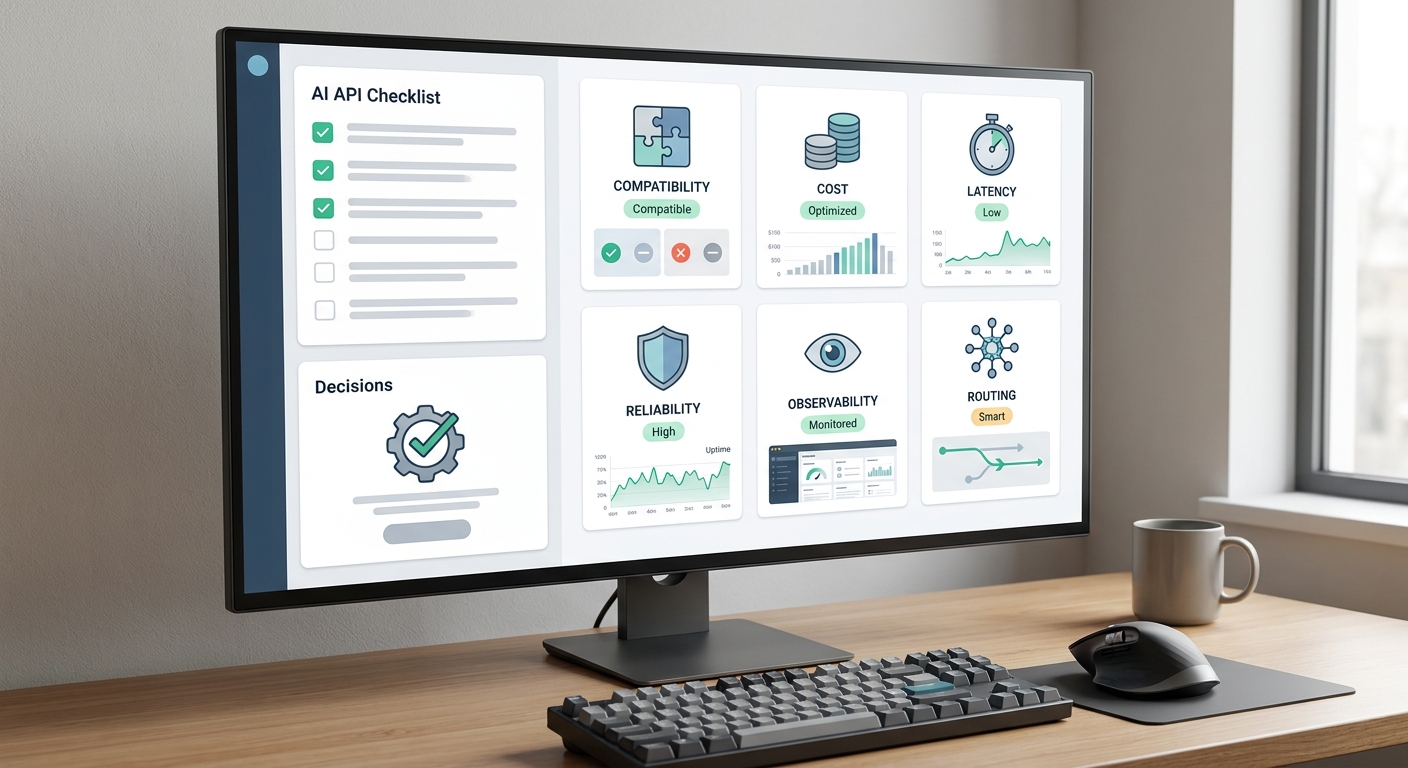
AI ファクトリーの評価チェックリスト
AI ファクトリープラットフォームに投資する前に、次の質問をしてください。
- ワークロード: 学習、ファインチューニング、埋め込み、提供、メディア生成、エージェント実行、あるいはそれらすべてを行うのか?
- レイテンシー: どのワークロードがリアルタイム、バッチ、非同期、またはヒューマン・イン・ザ・ループか?
- データ: どのデータセット、ドキュメント、ログ、ツール出力がシステムに入力され、誰がそれにアクセスできるか?
- モデル戦略: どのモデルが自社保有、借用、オープンウェイト、フロンティア API、マルチモーダル、または特化型か?
- 提供: アプリケーションは安定した内部エンドポイント、OpenAI 互換 API、または直接のクラスターアクセスを必要とするか?
- 信頼性: モデル、プロバイダー、GPU ノード、ストレージパス、またはキューが失敗したとき、何が起こるか?
- コスト: 再試行、アイドル時間、ストレージ、エグレス、エンジニアリング、サポートを含めた受理済み出力あたりのコストはどれくらいか?
- ガバナンス: プロンプト、出力、データソース、ユーザー、モデルバージョンはどのように監査されるか?
- ポータビリティ: ワークロードはプロバイダー、リージョン、モデルファミリー、GPU 種別の間で移動できるか?
- 責任者: ローンチ後、このファクトリーをどのチームが所有するか?
これらの質問に答えられないなら、もっと小さく始めてください。最初の本番経路ではマネージド API を使い、実際の利用状況を測定し、その後、直接的な GPU 制御が明確に正当化されるワークロードを、より正式な AI ファクトリープラットフォームへ移してください。
よくある間違い
最初の間違いは、AIファクトリーを調達プロジェクトとして扱うことです。GPUを購入することは、AI本番運用システムを構築することと同じではありません。
2つ目の間違いは、データ運用を無視することです。データ品質の低さ、権限の不明確さ、弱い検索パイプライン、評価セットの欠如は、モデル選定だけよりも大きな下流リスクを生みます。
3つ目の間違いは、時間あたりのGPU価格だけを測ることです。本番AIでは、完了した有用な作業を測定してください。GPUレンタル価格は入力の1つにすぎません。待ち時間、再試行、失敗したジョブ、ストレージ、データ移動、スタッフの時間も重要です。
4つ目の間違いは、APIを使うべきワークロードのために独自のファクトリーを構築することです。管理された公式モデルの利用で十分であれば、インフラを運用する機会費用が節約を上回る可能性があります。
5つ目の間違いは、失敗設計を省略することです。AIシステムは、過負荷、モデルドリフト、プロバイダーの障害、ポリシー拒否、不適切な検索、ツールエラー、暴走する再試行によって失敗します。ファクトリーには、トラフィックが到達する前に制御が必要です。
よくある質問
AIファクトリーとは何で、どのように機能しますか?
AIファクトリーは、データ、モデル、コンピュート、運用フィードバックをAI出力に変換する本番システムです。GPUまたはAPIのキャパシティ、データパイプライン、モデルのライフサイクル管理、サービング、可観測性、ガバナンス、コスト運用を、繰り返し可能なループとして組み合わせることで機能します。
AIファクトリープラットフォームとは何ですか?
AIファクトリープラットフォームとは、そのループを実行するために使われるインフラとソフトウェアスタックです。GPUクラスター、ストレージ、ネットワーキング、スケジューラ、データパイプライン、モデルレジストリ、サービングエンドポイント、監視、ガバナンス、コスト制御、モデル/APIゲートウェイなどが含まれる場合があります。
AIファクトリー NVIDIAとは何ですか?
NVIDIAの定義では、AIファクトリーは、GPU、ネットワーキング、ソフトウェア、リファレンスアーキテクチャを使って企業データを知能に変える加速化インフラです。重要なのは、AIファクトリーにはGPUの周辺に完全なスタックが必要だという点です。つまり、データ、モデル、デプロイ、可観測性、運用です。
AIファクトリー NVIDIA Jensen Huangとは何ですか?
Jensen HuangがAIファクトリーについて語るとき、通常は、情報を保存して提供する従来のデータセンターから、トークン、予測、または知能を生成する加速化データセンターへの移行を説明しています。運用担当者にとっては、そのビジョンをワークロードの規模設定、データガバナンス、モデルサービング、コスト制御に落とし込む必要があります。
ビジネス文脈でのAIファクトリーとは何ですか?
ビジネス文脈では、AIファクトリーはAI機能を継続的に提供し改善するための再現可能な能力です。これにより、チームは企業データと外部のモデルキャパシティを有用なワークフローへ変換しつつ、品質、コスト、リスク、責任の所在を追跡できます。
要点
AIファクトリーとは何か? それは、AIを孤立した実験から運用能力へ変える本番システムです。GPUクラスターは重要ですが、あくまで1層にすぎません。ファクトリーには、データパイプライン、モデルのライフサイクル管理、サービング、ルーティング、評価、ガバナンス、財務管理も必要です。
カスタムモデルや直接的なハードウェア制御が必要なワークロードでは、キャパシティを購入する前にAIファクトリー全体のスタックを計画してください。公式モデルAPIやツールを使えるワークロードでは、Flatkeyはよりシンプルな道を提供できます。1つのキー、1つの残高、1つの請求書、そしてモデルや従量課金ツール全体にわたるルーティングにより、チームがどのワークロードに本当に独自のファクトリーが必要かを学ぶ間も対応できます。
出典と参考資料
- NVIDIA: AI Factory
- NVIDIA Docs: AI Factory Design Overview
- Dell Technologies: Dell AI Factory with NVIDIA
- HPE: What is an AI factory?
- Flatkey: GPU cluster TCO
- Flatkey: GPU cloud vs model API