Что такое AI Factory? Кластеры GPU, данные, модели и операции
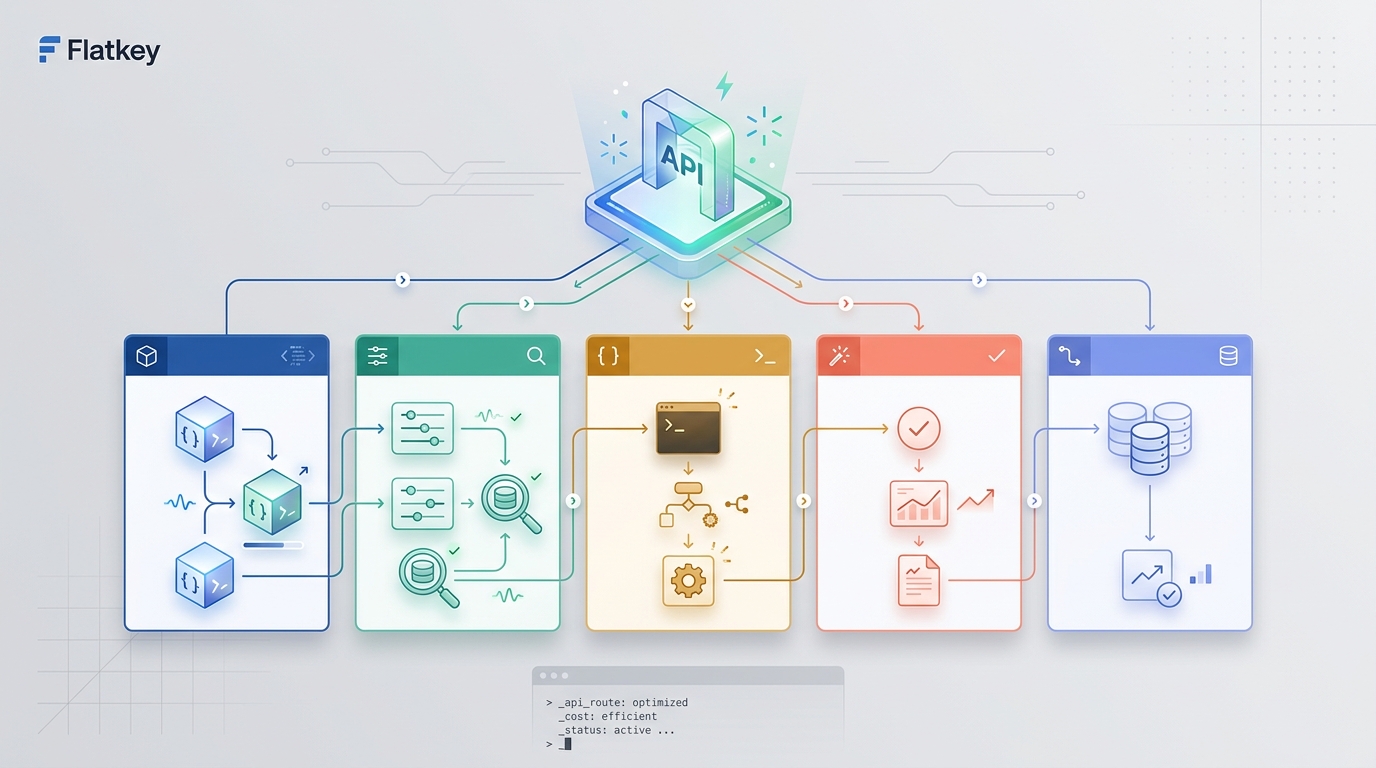
Что такое AI factory? AI factory — это операционная система вокруг корпоративного ИИ: мощности GPU, конвейеры данных, обучение или дообучение моделей, обслуживание инференса, оценка, управление и операционные затраты, работающие как один повторяемый производственный цикл.
Метафора важна, потому что ИИ создается не одними лишь GPU. Кластер GPU — это машинное отделение, но AI factory также нужны курируемые данные, планировщики, хранилище, сеть, реестры моделей, рабочие процессы развертывания, наблюдаемость, средства безопасности и финансовая модель для принятия решения, когда арендовать GPU, резервировать кластеры, использовать управляемые API или комбинировать все три подхода.
NVIDIA популяризировала этот термин применительно к инфраструктуре, которая превращает данные в интеллект, а такие вендоры, как Dell Technologies и HPE, теперь используют выражение "AI factory" для описания полнофункциональных корпоративных платформ ИИ. Для разработчиков полезнее не столько вопрос «кому принадлежит фраза?», сколько практический: какие компоненты должны существовать, прежде чем ваша нагрузка ИИ станет фабрикой, а не разовым экспериментом?
В этом руководстве дается определение того, что такое AI factory, объясняется, как AI factory работает, описываются основные уровни платформы и показывается, где Flatkey вписывается в ситуацию, когда команде нужен доступ к моделям/API без необходимости самостоятельно управлять каждым уровнем GPU-инфраструктуры.
Краткое определение: что такое AI factory?
AI factory — это производственная среда, которая преобразует сырые данные, промпты, модели, вычисления и операционную обратную связь в полезные результаты ИИ. В бизнес-терминах это повторяемая система для создания, развертывания, измерения и улучшения возможностей ИИ.
Проще всего думать об этом так:
| Уровень фабрики | Что он делает | Типичный владелец |
|---|---|---|
| Мощности GPU и ускорителей | Запускает обучение, дообучение, пакетный инференс или задачи инференса в реальном времени | Инфраструктура, платформа, ML systems |
| Сеть и хранилище | Передает наборы данных, контрольные точки, эмбеддинги, логи и артефакты модели без узких мест | Инфраструктура, SRE, платформа данных |
| Конвейеры данных | Собирает, очищает, размечает, фильтрует и обновляет данные, используемые моделями и приложениями | Data engineering, ML platform |
| Жизненный цикл модели | Выбирает базовые модели, дообучает, оценивает, версионирует и внедряет их | ML engineering, AI product |
| Сервисинг и маршрутизация | Доставляет результаты модели через API, пакетные задания, агентов или приложения | Backend, platform, AI engineering |
| Операции | Отслеживает задержку, ошибки, загрузку, затраты, безопасность, доступ и дрейф качества | SRE, FinOps, security, governance |
Так что, когда кто-то спрашивает «что такое AI factory?», лучший ответ такой: это полный производственный стек для ИИ, а не просто помещение, полное GPU.
Как работает AI factory?
AI factory работает, превращая четыре входных компонента в управляемый цикл результата:
- Данные поступают через события клиентов, документы, код, журналы, медиа, синтетические данные, публичные наборы данных или вызовы инструментов.
- Вычисления обрабатывают данные в ходе задач обучения, запусков дообучения, конвейеров retrieval, задач embedding, пакетного инференса или инференса в реальном времени.
- Модели формируют результаты через контрольные точки, размещенные API, маршрутизаторы моделей или специализированные доменные агенты.
- Операции измеряют, достаточно ли надежны, доступны по цене, управляемы и полезны результаты, чтобы оставаться в продакшене.
Этот цикл повторяется. Зрелая AI factory собирает обратную связь от пользователей и систем, превращает ее в данные для оценки, улучшает промпты или модели и выпускает следующую версию через контролируемое развертывание.
Именно поэтому разговор об AI factory включает и проектирование дата-центра, и продуктовые операции. Кластер может обучать модель или обслуживать ее, но фабрика существует только тогда, когда команда может снова и снова ответить:
- Какие задачи требуют прямого контроля над GPU?
- Какие задачи могут использовать управляемый API модели?
- Какие данные разрешено передавать какой модели?
- Какие результаты проходят оценку?
- Какие сбои нужно повторить, переключить на резерв или остановить?
- Какая команда, клиент, продукт или среда создали затраты?
AI factory и GPU-кластер: в чем разница
Кластер GPU — это вычислительный ресурс. AI factory — это производственная система, которая использует вычислительные ресурсы.
Разница важна, потому что многие дорогостоящие ИИ-проекты проваливаются на уровне выше кластера. Команда покупает мощности, а затем обнаруживает, что именно перемещение данных, хранение контрольных точек, обслуживание моделей, наблюдаемость, контроль доступа и распределение затрат являются реальными узкими местами.
Используйте руководство по аренде GPU-кластера, когда нужно сравнить многонодовые мощности GPU, топологию, сеть и приемочные тесты. Используйте модель AI factory, когда нужно определить, как вычисления, данные, развертывание моделей и операции становятся устойчивой возможностью ИИ.
| Вопрос | Ответ для GPU-кластера | Ответ для AI factory |
|---|---|---|
| Что мы покупаем? | Ноды, GPU, сетевую фабрику, хранилище, поддержку | Повторяемую систему производства ИИ |
| Что оптимизируется? | Пропускная способность, утилизация, доступность, завершение задач | Бизнес-результат, качество, затраты, управление, скорость итераций |
| Кто этим управляет? | Инфраструктура, платформа, SRE, ML systems | Инфраструктура плюс данные, ML, продукт, безопасность, финансы |
| Что может пойти не так? | Перегруженная сеть, сбои задач, простаивающие GPU, конкуренция за очередь | Неправильная модель, слабые данные, небезопасный вывод, неконтролируемый рост затрат, отсутствие управления |
| Какой здесь вопрос unit economics? | Стоимость GPU-часа или задачи | Стоимость одного принятого результата, функции, клиента или workflow |
Для моделирования затрат используйте вместе с этой статьей рабочий лист TCO GPU-кластера. Бюджет AI factory должен включать кластер, но также хранилище, egress, инженерное время, сбои, оценку, observability и управление.
Уровни платформы AI factory
Что такое платформа AI factory? Это слой программного обеспечения и инфраструктуры, который позволяет командам запускать factory как продукт, а не как набор скриптов.
На практике платформа AI factory обычно включает семь уровней.
1. Мощности и оборудование
Этот уровень включает GPU или ускорители, CPU-хосты, память, локальное хранилище, проектирование стоек, питание, охлаждение и дата-центр или облачный регион, где выполняется нагрузка.
Для обучения и крупномасштабного batch-инференса команды учитывают производительность в многонодовой конфигурации, сетевую фабрику, скорость checkpoint и поведение scheduler. Для инференса в реальном времени команды учитывают очереди, cold starts, задержку на хвостах, autoscaling и uptime. Правильная модель мощностей может включать аренду GPU по запросу, зарезервированные GPU-мощности, частное GPU-облако, serverless GPU, colocation или внутренний кластер.
2. Сеть и хранилище
Нагрузки ИИ часто ограничены перемещением данных, а не чистой математикой. Задания обучения перемещают датасеты и checkpoints. Системы поиска перемещают embeddings и исходные документы. Генерация медиа перемещает большие файлы. Workflow агентов может вызывать инструменты, базы данных и браузеры.
Это значит, что платформе AI factory нужны предсказуемая локальность хранилища, правила хранения данных, планы резервного копирования и сетевые пути, соответствующие нагрузке. Кластер с быстрыми GPU и слабым хранилищем все равно может работать хуже.
3. Конвейеры данных
Конвейеры данных определяют, на чем factory разрешено учиться и с чем она может отвечать. Они охватывают ingestion, фильтрацию, разметку, дедупликацию, обработку приватности, границы разрешений, проверки качества и расписания обновления.
Для retrieval-augmented generation конвейер данных может быть важнее выбора модели. Для fine-tuning небольшие проблемы с качеством могут превращаться в повторяющиеся downstream-сбои. Для агентов инструменты данных и веб-инструменты становятся частью входной поверхности factory.
4. Жизненный цикл модели
Жизненный цикл модели охватывает выбор модели, проектирование prompt, fine-tuning, оценку, версионирование, regression tests, откаты и release notes. Здесь команда решает, использовать ли API frontier-модели, модель с открытыми весами на арендованных GPU, специализированную модель для изображений/видео или гибридный подход.
Flatkey здесь важен, когда команде нужно сравнивать и маршрутизировать запросы между официальными API моделей, не управляя множеством ключей провайдеров и отдельными балансами. Flatkey дает разработчикам один ключ, один баланс и один счет для сотен официальных моделей и pay-per-call инструментов, что может быть проще, чем превращать каждую нагрузку в собственную инфраструктуру.
5. Сервинг, маршрутизация и интеграция приложений
Сервинг превращает обученную или выбранную модель в надежный endpoint. Маршрутизация определяет, какая модель, провайдер, регион или fallback-путь должны обрабатывать каждый запрос.
Именно здесь AI factory соприкасается с приложениями. Кодирующему агенту, copilot для поддержки клиентов, конвейеру изображений, видеопроцессу или внутреннему исследовательскому инструменту не нужно знать все детали инфраструктуры. Ему нужен стабильный API, предсказуемая задержка, отслеживаемая стоимость и восстанавливаемые режимы отказа.
Если ваша команда решает, владеть ли слоем сервинга, прочитайте GPU cloud vs model API. Коротко: владейте GPU-serving, когда контроль над оборудованием, кастомные модели, изоляция данных или unit economics оправдывают операционную нагрузку; используйте model APIs, когда важнее скорость, широта выбора, failover и меньшая нагрузка на платформу.
6. Observability, оценка и управление
AI factory должна измерять не только uptime. Она должна отслеживать объем запросов, задержку, ошибки, повторные попытки, стоимость, выбор модели, версии prompt, источники данных, safety filters, оценки и принятые результаты.
Управление идет рядом с observability. Командам нужны контроль доступа, audit logs, правила хранения, одобрение поставщиков, границы данных клиентов и пути эскалации для небезопасных или низкокачественных результатов. Без этих контролей factory может масштабировать риск быстрее, чем ценность.
7. FinOps и операционный ритм
AI factory превращают вычисления в результаты, но финансовым командам все равно нужно знать, сколько эти результаты стоят. Операционная модель должна распределять расходы по продукту, среде, клиенту, команде или workflow.
Полезные unit metrics включают:
- Стоимость за принятый результат
- Стоимость за завершенное действие пользователя
- Стоимость за успешный вызов инструмента
- Утилизация GPU по классу нагрузки
- Потери из-за повторных попыток и сбоев
- Процент попадания в cache
- Время ожидания в очереди
- Частота fallback на другую модель
Ценность Flatkey особенно высока, когда командам нужно использовать модели и инструменты через общий журнал вместо разрозненных учетных записей провайдеров. Это не заменяет кластер GPU для кастомной инфраструктуры, но может снизить сложность для рабочих нагрузок с моделями/API, которым не нужен прямой контроль над оборудованием.
Что такое AI factory в терминологии NVIDIA?
О чем обычно идет речь в обсуждении «What is an AI factory NVIDIA»? NVIDIA использует этот термин для описания инфраструктуры, которая превращает корпоративные данные в интеллект, когда GPU, ускоренные сети, ПО и шаблоны развертывания работают вместе. Материалы NVIDIA по AI factory и эталонная корпоративная архитектура сосредоточены на full-stack-дизайне, а не только на отдельных ускорителях.
Такой подход полезен, но он также может смещать внимание читателей в сторону аппаратной части. Практическому заказчику следует перевести концепцию NVIDIA в рабочий чек-лист:
- Каким рабочим нагрузкам нужны NVIDIA GPU напрямую?
- Какие модели обучаются, дообучаются или обслуживаются на этих GPU?
- Какие источники данных питают модели?
- Какой программный стек планирует и отслеживает задания?
- Какие приложения используют результаты?
- Какая команда отвечает за надежность, безопасность и затраты?
Дженсен Хуанг часто описывает AI factories как следующее поколение дата-центров, потому что они производят токены или интеллект из данных и энергии. Воспринимайте это как макро-нарратив. Вашему внедрению по-прежнему нужны оценка объема нагрузок, governance, проектирование уровней сервиса и модель затрат.
Что такое AI factory в бизнес-контексте?
В бизнес-контексте AI factory — это организационная способность. Она дает командам повторяемый способ выпускать AI-функции, агентные рабочие процессы, внутренние copilot'ы, продукты данных и автоматизированные операции.
Фабрика должна отвечать на бизнес-вопросы в операционных терминах:
| Бизнес-вопрос | Перевод в термины AI factory |
|---|---|
| Можем ли мы безопасно запустить эту AI-функцию? | Разрешения на данные, оценка модели, fallback, журналы аудита |
| Можем ли мы масштабироваться без неожиданного роста затрат? | Бюджеты, лимиты скорости, журнал использования, маршрутизация моделей, утилизация GPU |
| Можем ли мы со временем повышать качество? | Контуры обратной связи, наборы оценок, регрессионные тесты, версионирование промптов/моделей |
| Могут ли команды повторно использовать платформу? | Общие API, шаблоны, observability, контроль доступа |
| Можем ли мы переключать модели или провайдеров? | Слой абстракции, OpenAI-compatible маршруты, бенчмарки моделей |
Именно поэтому AI factory не является автоматически правильной инвестицией для каждой команды. Если продукту нужны только стандартные текст, изображение, видео, поиск, браузер, обогащение данных или вызовы инструментов агента, управляемая модель и gateway для инструментов могут быстрее вывести решение в продакшн. Если же продукту нужны кастомные веса модели, частный контроль над data plane, высокообъемный inference или специализированные мультимедийные пайплайны, может быть оправдана фабрика на базе GPU.
Строить, арендовать или использовать API моделей?
Правильная стратегия AI factory обычно гибридная.
Строить или резервировать GPU-мощности, когда:
- У вас постоянный, высокообъемный inference, и GPU можно загружать эффективно.
- Вам нужны кастомные веса модели, частное обслуживание моделей или специализированные kernel'ы.
- Вы можете обеспечивать хранение, сети, планирование, безопасность и реагирование на инциденты.
- Стоимость нагрузки на одно принятый выход ниже после учета всех скрытых затрат.
Арендовать кластеры GPU, когда:
- Вам нужны всплески для обучения, дообучения, оценки или пакетного inference.
- Вы хотите проверить профиль нагрузки, прежде чем покупать или резервировать мощности.
- Вам нужны определенные ускорители, регионы или топологии для конкретного проекта.
- Вы можете позволить себе работу по настройке и приемочному тестированию.
Использовать API моделей или gateway, когда:
- Вам нужен быстрый доступ ко многим моделям и модальностям.
- Рабочая нагрузка часто меняется.
- Отказоустойчивость между провайдерами важнее, чем прямой контроль над оборудованием.
- Вашей команде нужен один API-ключ, один счет и контроль использования вместо разрозненных учетных записей провайдеров.
- В одном workflow вам нужны инструменты вроде поиска, автоматизации браузера, обогащения данных или media API.
Для многих команд AI factory — это не одно место. Это операционная модель, которая охватывает арендованные GPU, управляемые API, внутренние сервисы и инструменты агента.
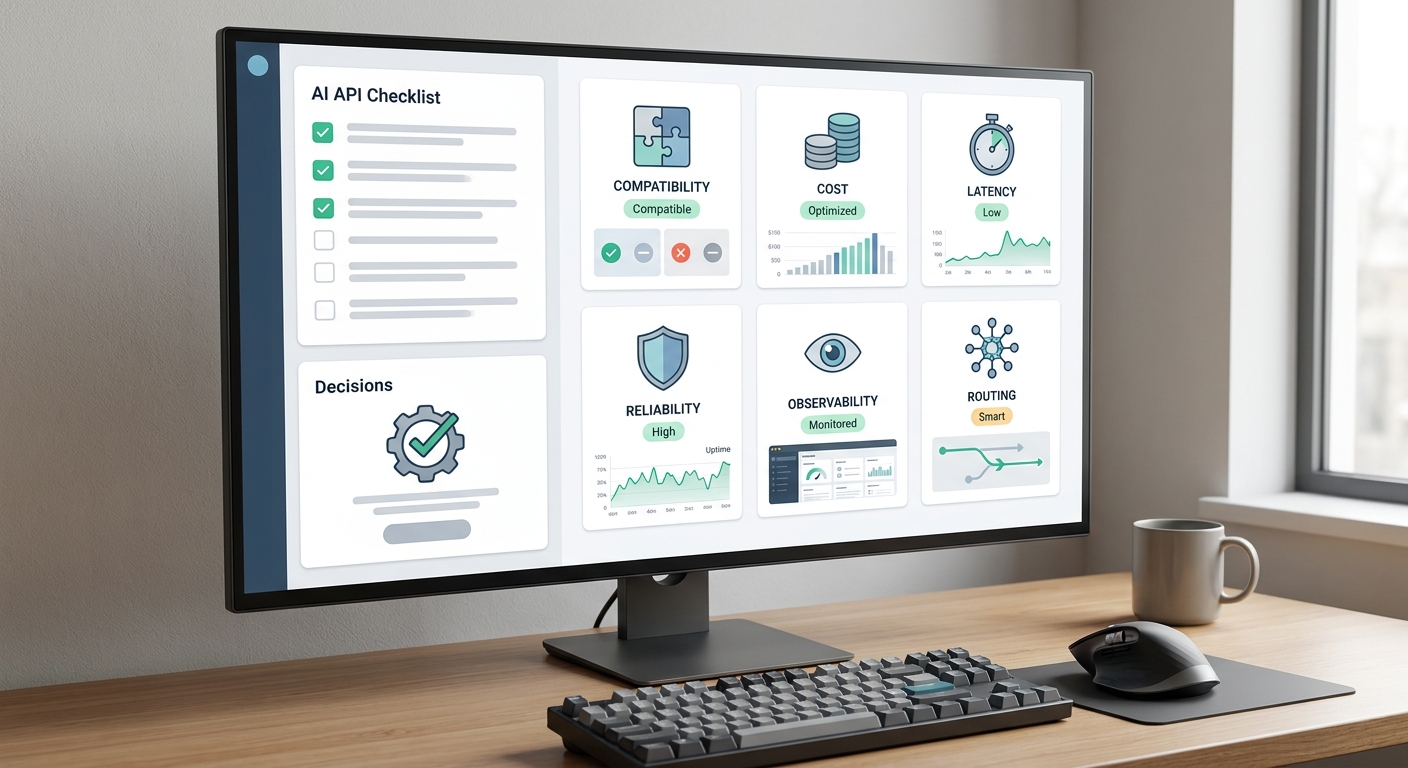
Чек-лист оценки AI factory
Прежде чем инвестировать в платформу AI factory, задайте эти вопросы:
- Нагрузка: Мы обучаем, дообучаем, создаем embeddings, обслуживаем, генерируем медиа, запускаем агентов или делаем все это?
- Задержка: Какие нагрузки работают в реальном времени, пакетно, асинхронно или с участием человека в цикле?
- Данные: Какие наборы данных, документы, логи и результаты инструментов питают систему, и у кого есть доступ к ним?
- Стратегия моделей: Какие модели являются собственными, арендованными, open-weight, frontier API, мультимодальными или специализированными?
- Serving: Нужны ли приложениям стабильная внутренняя конечная точка, OpenAI-compatible API или прямой доступ к кластеру?
- Надежность: Что происходит, когда выходит из строя модель, провайдер, узел GPU, путь к хранилищу или очередь?
- Затраты: Какова стоимость одного принятого результата после ретраев, простоя, хранения, egress, инженерной поддержки и сопровождения?
- Governance: Как аудируются промпты, результаты, источники данных, пользователи и версии моделей?
- Портируемость: Можно ли перенести нагрузку между провайдерами, регионами, семействами моделей или типами GPU?
- Владение: Какая команда будет владеть фабрикой после запуска?
Если ваша команда не может ответить на эти вопросы, начните с меньшего. Используйте управляемые API для первого production-пути, измерьте реальное использование, а затем переносите нагрузки, которые явно оправдывают прямой контроль над GPU, в более формальную платформу AI factory.
Распространённые ошибки
Первая ошибка — воспринимать AI factory как проект закупок. Покупка GPU — это не то же самое, что построение производственной системы ИИ.
Вторая ошибка — игнорировать операции с данными. Плохое качество данных, неясные права доступа, слабые пайплайны поиска и отсутствующие наборы для оценки создают больше рисков на последующих этапах, чем один только выбор модели.
Третья ошибка — измерять только почасовую цену GPU. Для производственного ИИ измеряйте выполненную полезную работу. Цены аренды GPU — лишь один из факторов; время в очереди, повторные попытки, неудачные задания, хранилище, перемещение данных и время сотрудников тоже имеют значение.
Четвёртая ошибка — строить собственную фабрику для задач, которые должны использовать API. Если достаточно управляемого официального маршрута к модели, альтернативные издержки эксплуатации инфраструктуры могут превысить экономию.
Пятая ошибка — пропускать проектирование отказоустойчивости. Системы ИИ дают сбои из-за перегрузки, дрейфа модели, инцидентов у провайдера, отказов по политике, плохого поиска, ошибок инструментов и бесконечных повторных попыток. Фабрике нужны механизмы контроля до того, как появится трафик.
Часто задаваемые вопросы
Что такое AI factory и как она работает?
AI factory — это производственная система, которая превращает данные, модели, вычислительные ресурсы и операционную обратную связь в результаты ИИ. Она работает, объединяя GPU- или API-мощности, пайплайны данных, управление жизненным циклом модели, обслуживание, наблюдаемость, управление и операции с затратами в повторяемый цикл.
Что такое платформа AI factory?
Платформа AI factory — это инфраструктура и программный стек, используемые для работы этого цикла. Она может включать GPU-кластеры, хранилище, сеть, планировщики, пайплайны данных, реестры моделей, конечные точки обслуживания, мониторинг, управление, контроль затрат и шлюзы моделей/API.
Что такое AI factory NVIDIA?
В трактовке NVIDIA AI factory — это ускоренная инфраструктура, которая превращает корпоративные данные в интеллект с помощью GPU, сетей, программного обеспечения и эталонных архитектур. Полезный вывод в том, что AI factory нужен полный стек вокруг GPU: данные, модели, развёртывание, наблюдаемость и операции.
Что такое AI factory NVIDIA Jensen Huang?
Когда Дженсен Хуанг говорит об AI factory, он обычно описывает переход от традиционных дата-центров, которые хранят и предоставляют информацию, к ускоренным дата-центрам, которые производят токены, прогнозы или интеллект. Для операторов это видение всё равно нужно преобразовать в расчёт размеров нагрузки, управление данными, обслуживание моделей и контроль затрат.
Что такое AI factory в бизнес-контексте?
В бизнес-контексте AI factory — это повторяемая возможность внедрять и улучшать функции ИИ. Она даёт командам управляемый способ превращать корпоративные данные и внешнюю вычислительную мощность моделей в полезные рабочие процессы, одновременно отслеживая качество, стоимость, риски и ответственность.
Итог
Что такое AI factory? Это производственная система, которая превращает ИИ из отдельных экспериментов в рабочую способность. Кластеры GPU важны, но это только один слой. Фабрике также нужны пайплайны данных, управление жизненным циклом моделей, обслуживание, маршрутизация, оценка, управление и финансовый контроль.
Для задач, которым нужны собственные модели или прямой контроль над оборудованием, спланируйте весь стек AI factory до покупки мощностей. Для задач, которые могут использовать официальные API моделей и инструменты, Flatkey может предложить более простой путь: один ключ, один баланс, один счёт и маршрутизацию между моделями и pay-per-call инструментами, пока ваша команда выясняет, какие задачи действительно требуют собственной фабрики.
Источники и дополнительное чтение
- NVIDIA: AI Factory
- NVIDIA Docs: Обзор дизайна AI Factory
- Dell Technologies: Dell AI Factory with NVIDIA
- HPE: Что такое AI factory?
- Flatkey: TCO GPU-кластера
- Flatkey: GPU cloud vs model API