Qu’est-ce qu’une usine d’IA ? Clusters GPU, données, modèles et opérations
Qu’est-ce qu’une usine d’IA ? Une usine d’IA est le système d’exploitation de l’IA en entreprise : capacité GPU, pipelines de données, entraînement ou fine-tuning de modèles, service d’inférence, évaluation, gouvernance et opérations de coûts fonctionnant comme une boucle de production unique et répétable.
La métaphore est importante, car l’IA ne se produit pas uniquement grâce aux GPU. Un cluster GPU est la salle des machines, mais une usine d’IA a aussi besoin de données sélectionnées, d’ordonnanceurs, de stockage, de mise en réseau, de registres de modèles, de workflows de déploiement, d’observabilité, de contrôles de sécurité et d’un modèle financier pour décider quand louer des GPU, réserver des clusters, utiliser des API gérées ou combiner les trois.
NVIDIA a popularisé le terme autour d’une infrastructure qui transforme les données en intelligence, et des fournisseurs tels que Dell Technologies et HPE utilisent désormais « usine d’IA » pour décrire des plateformes d’IA d’entreprise full-stack. Pour les bâtisseurs, la question utile n’est pas tant « qui possède l’expression ? » que la suivante, plus pratique : quelles pièces doivent exister avant que votre charge de travail IA devienne une usine plutôt qu’une expérience ponctuelle ?
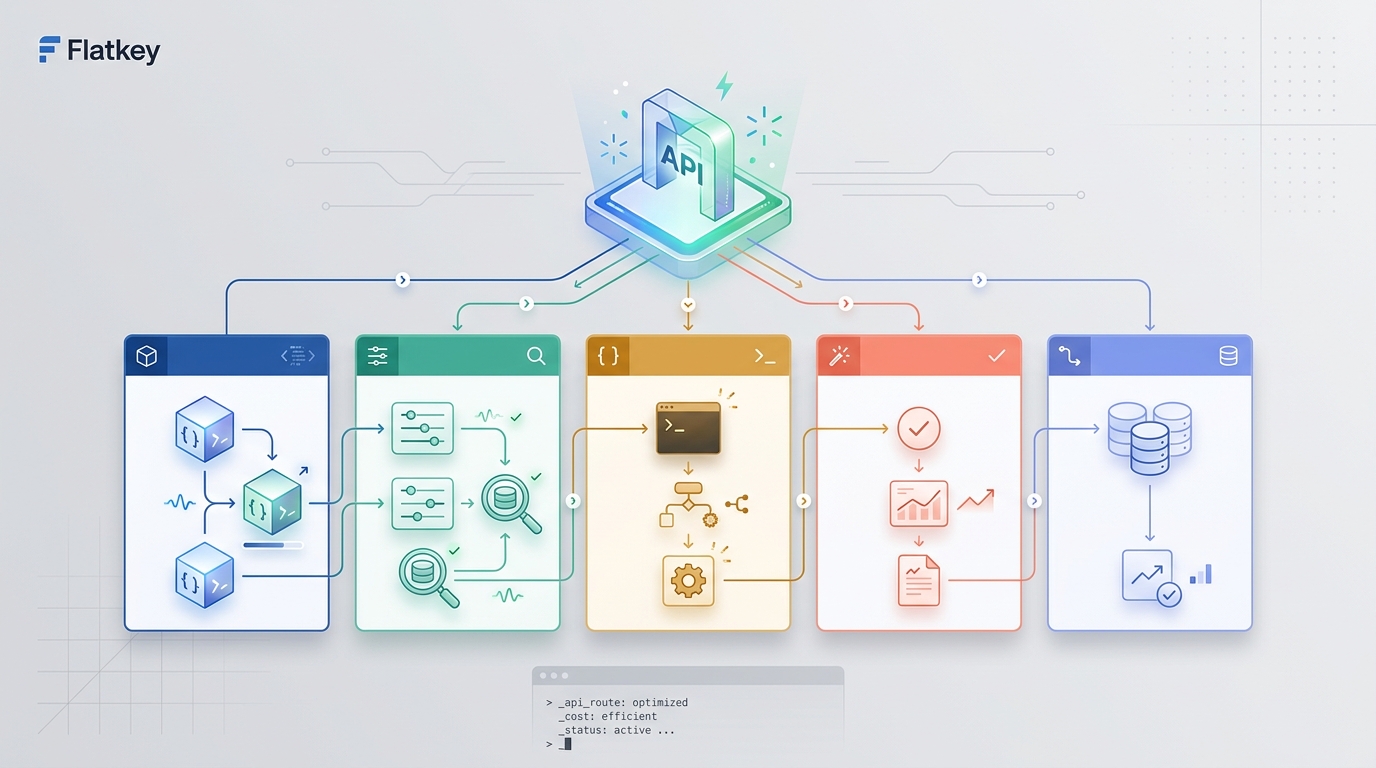
Ce guide définit ce qu’est une usine d’IA, explique comment fonctionne une usine d’IA, cartographie les couches clés de la plateforme et montre où Flatkey s’insère lorsqu’une équipe veut accéder à des modèles/API sans exploiter elle-même chaque couche de l’infrastructure GPU.
La définition rapide : qu’est-ce qu’une usine d’IA ?
Une usine d’IA est un environnement de production qui convertit des données brutes, des prompts, des modèles, du calcul et des retours opérationnels en sorties d’IA utilisables. En termes métier, c’est un système répétable pour créer, déployer, mesurer et améliorer les capacités d’IA.
Une façon simple de l’envisager :
| Couche de l’usine | Ce qu’elle fait | Propriétaire habituel |
|---|---|---|
| Capacité GPU et accélérateurs | Exécute les charges de travail d’entraînement, de fine-tuning, d’inférence par lot ou d’inférence en temps réel | Infrastructure, plateforme, systèmes ML |
| Réseau et stockage | Déplace les jeux de données, checkpoints, embeddings, journaux et artefacts de modèles sans goulots d’étranglement | Infrastructure, SRE, plateforme de données |
| Pipelines de données | Ingestent, nettoient, étiquettent, filtrent et actualisent les données utilisées par les modèles et les applications | Ingénierie des données, plateforme ML |
| Cycle de vie des modèles | Sélectionne les modèles fondamentaux, les fine-tune, les évalue, les versionne et les déploie | Ingénierie ML, produit IA |
| Service et routage | Diffuse les sorties de modèle via des API, des jobs par lots, des agents ou des applications | Backend, plateforme, ingénierie IA |
| Opérations | Surveille la latence, les erreurs, l’utilisation, les coûts, la sécurité, l’accès et la dérive de qualité | SRE, FinOps, sécurité, gouvernance |
Donc, lorsque quelqu’un demande « qu’est-ce qu’une usine d’IA ? », la meilleure réponse est : c’est la pile de production complète de l’IA, pas seulement une salle remplie de GPU.
Comment fonctionne une usine d’IA ?
Une usine d’IA fonctionne en transformant quatre entrées en une boucle de sortie gérée :
- Données entrent via des événements clients, des documents, du code, des journaux, des médias, des données synthétiques, des jeux de données publics ou des appels d’outils.
- Calcul fait passer les données par des jobs d’entraînement, des sessions de fine-tuning, des pipelines de récupération, des jobs d’embedding, de l’inférence par lot ou de l’inférence en temps réel.
- Modèles produisent des sorties via des checkpoints, des API hébergées, des routeurs de modèles ou des agents spécifiques à un domaine.
- Opérations mesurent si les sorties sont suffisamment fiables, abordables, gouvernées et utiles pour rester en production.
Cette boucle se répète. Une usine d’IA mature collecte les retours des utilisateurs et des systèmes, transforme ces retours en données d’évaluation, améliore les prompts ou les modèles et déploie la version suivante via un déploiement contrôlé.
C’est pourquoi la discussion sur l’usine d’IA inclut à la fois la conception du centre de données et les opérations produit. Un cluster peut entraîner ou servir un modèle, mais l’usine n’existe que lorsque l’équipe peut répondre de manière répétée aux questions suivantes :
- Quels workloads nécessitent un contrôle direct des GPU ?
- Quels workloads peuvent utiliser une API de modèle gérée ?
- Quelles données sont autorisées à atteindre quel modèle ?
- Quelles sorties passent l’évaluation ?
- Quels échecs doivent être retentés, basculés ou arrêtés ?
- Quelle équipe, quel client, quel produit ou quel environnement a généré le coût ?
Usine d’IA vs cluster GPU
Un cluster GPU est une ressource de calcul. Une usine d’IA est un système de production qui utilise des ressources de calcul.
La distinction est importante, car de nombreux programmes d’IA coûteux échouent au niveau situé au-dessus du cluster. L’équipe achète de la capacité, puis découvre que le déplacement des données, le stockage des checkpoints, le service des modèles, l’observabilité, le contrôle d’accès et l’imputation des coûts sont les vrais obstacles.
Utilisez un guide de location de cluster GPU lorsque vous devez comparer la capacité GPU multi-nœuds, la topologie, la mise en réseau et les tests d’acceptation. Utilisez un modèle d’usine d’IA lorsque vous devez décider comment le calcul, les données, le déploiement des modèles et les opérations deviennent une capacité IA durable.
| Question | Réponse « cluster GPU » | Réponse « usine d’IA » |
|---|---|---|
| Que sommes-nous en train d’acheter ? | Nœuds, GPU, fabric réseau, stockage, support | Un système de production d’IA répétable |
| Qu’optimise-t-on ? | Débit, utilisation, disponibilité, achèvement des tâches | Résultat business, qualité, coût, gouvernance, vitesse d’itération |
| Qui l’exploite ? | Infra, plateforme, SRE, systèmes ML | Infra plus données, ML, produit, sécurité, finance |
| Qu’est-ce qui peut mal tourner ? | Réseau saturé, tâches en échec, GPU inactifs, contention de file d’attente | Modèle inadapté, données faibles, sortie non sûre, coût incontrôlé, gouvernance absente |
| Quelle est la question d’économie unitaire ? | Coût par heure GPU ou par tâche | Coût par sortie acceptée, fonctionnalité, client ou flux de travail |
Pour la modélisation des coûts, associez cet article au tableau de calcul du TCO d’un cluster GPU. Le budget d’une usine d’IA doit inclure le cluster, mais aussi le stockage, l’egress, le temps d’ingénierie, les échecs, l’évaluation, l’observabilité et la gouvernance.
Les couches de la plateforme d’usine d’IA
Qu’est-ce qu’une plateforme d’usine d’IA ? C’est la couche logicielle et d’infrastructure qui permet aux équipes d’exploiter l’usine comme un produit plutôt que comme une collection de scripts.
En pratique, une plateforme d’usine d’IA comprend généralement sept couches.
1. Capacité et matériel
Cette couche comprend les GPU ou accélérateurs, les hôtes CPU, la mémoire, le stockage local, la conception des racks, l’alimentation, le refroidissement et le centre de données ou la région cloud où s’exécute la charge de travail.
Pour l’entraînement et l’inférence batch à grande échelle, les équipes se soucient des performances multi-nœuds, du fabric réseau, de la vitesse des points de contrôle et du comportement du planificateur. Pour l’inférence en temps réel, elles se soucient de la mise en file d’attente, des démarrages à froid, des queues de latence, de l’autoscaling et de la disponibilité. Le bon modèle de capacité peut être la location de GPU à la demande, une capacité GPU réservée, un cloud GPU privé, un GPU serverless, la colocation ou un cluster interne.
2. Réseau et stockage
Les charges de travail d’IA sont souvent limitées par les déplacements, et non par les calculs bruts. Les tâches d’entraînement déplacent des jeux de données et des points de contrôle. Les systèmes de recherche vectorielle déplacent des embeddings et des documents sources. La génération de médias déplace de gros fichiers. Les workflows d’agents peuvent appeler des outils, des bases de données et des navigateurs.
Cela signifie qu’une plateforme d’usine d’IA a besoin d’une localisation de stockage prévisible, de règles de conservation des données, de plans de sauvegarde et de chemins réseau adaptés à la charge de travail. Un cluster avec des GPU rapides et un stockage faible peut néanmoins sous-performer.
3. Pipelines de données
Les pipelines de données déterminent à partir de quoi l’usine est autorisée à apprendre et avec quoi elle peut répondre. Ils couvrent l’ingestion, le filtrage, l’annotation, la déduplication, la gestion de la confidentialité, les frontières d’autorisation, les contrôles qualité et les calendriers d’actualisation.
Pour la génération augmentée par récupération, le pipeline de données peut être plus important que le choix du modèle. Pour le fine-tuning, de petits problèmes de qualité peuvent se transformer en échecs répétés en aval. Pour les agents, les outils de données et les outils web deviennent une partie de la surface d’entrée de l’usine.
4. Cycle de vie du modèle
Le cycle de vie du modèle couvre la sélection du modèle, la conception des prompts, le fine-tuning, l’évaluation, le versionnage, les tests de régression, les retours en arrière et les notes de version. C’est ici qu’une équipe décide d’utiliser une API de modèle frontier, un modèle à poids ouverts sur des GPU loués, un modèle spécialisé d’image/vidéo ou une approche hybride.
Flatkey est pertinent ici lorsqu’une équipe veut comparer et router entre des API de modèles officielles sans gérer de nombreuses clés de fournisseurs et des soldes séparés. Flatkey fournit aux développeurs une seule clé, un seul solde et une seule facture pour des centaines de modèles officiels et d’outils pay-per-call, ce qui peut être plus simple que de transformer chaque charge de travail en infrastructure détenue.
5. Service, routage et intégration applicative
Le serving transforme un modèle entraîné ou sélectionné en endpoint fiable. Le routage décide quel modèle, fournisseur, région ou chemin de repli doit gérer chaque requête.
C’est là que l’usine d’IA rencontre les applications. Un agent de codage, un copilote de support client, un pipeline d’images, un workflow vidéo ou un outil de recherche interne ne devraient pas avoir besoin de connaître chaque détail d’infrastructure. Ils ont besoin d’une API stable, d’une latence prévisible, d’un coût traçable et de modes de défaillance récupérables.
Si votre équipe se demande si elle doit posséder la couche de serving, lisez cloud GPU vs API de modèle. En bref : possédez le serving GPU lorsque le contrôle du matériel, les modèles personnalisés, l’isolation des données ou l’économie unitaire justifient la charge opérationnelle ; utilisez les API de modèles lorsque la vitesse, l’étendue, le failover et une charge plateforme plus faible comptent davantage.
6. Observabilité, évaluation et gouvernance
Une usine d’IA doit mesurer plus que la disponibilité. Elle doit suivre le volume de requêtes, la latence, les erreurs, les retries, le coût, le choix du modèle, les versions de prompts, les sources de données, les filtres de sécurité, les scores d’évaluation et les sorties acceptées.
La gouvernance va de pair avec l’observabilité. Les équipes ont besoin de contrôles d’accès, de journaux d’audit, de règles de conservation, d’approbation des fournisseurs, de limites pour les données clients et de chemins d’escalade pour les sorties non sûres ou de faible qualité. Sans ces contrôles, l’usine peut faire croître le risque plus vite que la valeur.
7. FinOps et cadence opérationnelle
Les usines d’IA transforment le calcul en résultats, mais les équipes finance doivent toujours savoir combien coûtent ces résultats. Le modèle opérationnel devrait attribuer les dépenses par produit, environnement, client, équipe ou flux de travail.
Les métriques unitaires utiles incluent :
- Coût par sortie acceptée
- Coût par action utilisateur terminée
- Coût par appel d’outil réussi
- Utilisation GPU par classe de charge de travail
- Gaspillage dû aux retries et aux échecs
- Taux de cache hit
- Temps d’attente en file
- Taux de fallback vers un autre modèle
La valeur de Flatkey est la plus forte lorsque les équipes souhaitent utiliser les modèles et les outils sur un registre partagé plutôt que sur des comptes fournisseurs fragmentés. Cela ne remplace pas un cluster GPU pour une infrastructure personnalisée, mais peut réduire la complexité des charges de travail de modèles/API qui ne nécessitent pas de contrôle direct du matériel.
Qu’est-ce qu’une usine d’IA dans la terminologie NVIDIA ?
De quoi parle généralement la discussion NVIDIA sur ce qu’est une usine d’IA ? NVIDIA utilise ce terme pour décrire une infrastructure qui transforme les données d’entreprise en intelligence, avec des GPU, un réseau accéléré, des logiciels et des schémas de déploiement qui fonctionnent ensemble. Les documents NVIDIA sur l’usine d’IA et l’architecture de référence d’entreprise se concentrent sur une conception full stack, pas seulement sur des accélérateurs individuels.
Ce cadrage est utile, mais il peut aussi orienter les lecteurs vers une vision centrée sur le matériel. L’acheteur pratique devrait traduire le concept NVIDIA en une liste de contrôle opérationnelle :
- Quelles charges de travail ont besoin directement de GPU NVIDIA ?
- Quels modèles sont entraînés, affinés ou servis sur ces GPU ?
- Quelles sources de données alimentent les modèles ?
- Quelle pile logicielle planifie et observe les tâches ?
- Quelles applications consomment les résultats ?
- Quelle équipe est responsable de la fiabilité, de la sécurité et des coûts ?
Jensen Huang présente souvent les usines d’IA comme la nouvelle génération de centres de données, car elles fabriquent des jetons ou de l’intelligence à partir des données et de l’énergie. Considérez cela comme le récit macroéconomique. Votre mise en œuvre a toujours besoin d’un dimensionnement des charges de travail, d’une gouvernance, d’une conception des niveaux de service et d’un modèle de coûts.
Qu’est-ce qu’une usine d’IA dans un contexte métier ?
Dans un contexte métier, une usine d’IA est une capacité organisationnelle. Elle offre aux équipes une manière reproductible de livrer des fonctionnalités d’IA, des workflows d’agents, des copilotes internes, des produits de données et des opérations automatisées.
L’usine devrait répondre aux questions métier en termes opérationnels :
| Question métier | Traduction en usine d’IA |
|---|---|
| Pouvons-nous lancer cette fonctionnalité d’IA en toute sécurité ? | Autorisations des données, évaluation du modèle, repli, journaux d’audit |
| Pouvons-nous monter en charge sans coût surprise ? | Budgets, limites de débit, registre d’utilisation, routage des modèles, utilisation des GPU |
| Pouvons-nous améliorer la qualité au fil du temps ? | Boucles de retour, jeux d’évaluation, tests de régression, versionnement des prompts/modèles |
| Les équipes peuvent-elles réutiliser la plateforme ? | API partagées, modèles, observabilité, contrôles d’accès |
| Pouvons-nous changer de modèles ou de fournisseurs ? | Couche d’abstraction, routes compatibles OpenAI, benchmarks de modèles |
C’est aussi la raison pour laquelle une usine d’IA n’est pas automatiquement le bon investissement pour chaque équipe. Si le produit n’a besoin que de texte standard, d’images, de vidéo, de recherche, de navigateur, d’enrichissement ou d’appels d’outils d’agents, une passerelle managée pour les modèles et les outils peut atteindre la production plus rapidement. Si le produit a besoin de poids de modèles personnalisés, d’un contrôle privé du plan de données, d’une inférence à grand volume ou de pipelines multimédias spécialisés, une usine alimentée par des GPU peut se justifier.
Construire, louer ou utiliser des API de modèles ?
La bonne stratégie d’usine d’IA est généralement hybride.
Construisez ou réservez une capacité GPU lorsque :
- Vous exécutez une inférence stable à grand volume et pouvez maintenir les GPU utilisés.
- Vous avez besoin de poids de modèles personnalisés, d’un service de modèles privé ou de noyaux spécialisés.
- Vous pouvez gérer le stockage, le réseau, l’ordonnancement, la sécurité et la réponse aux incidents.
- Le coût par sortie acceptée de la charge de travail est inférieur une fois tous les coûts cachés inclus.
Louez des clusters GPU lorsque :
- Vous avez besoin de pics d’entraînement, d’ajustement fin, d’évaluation ou d’inférence par lots.
- Vous voulez valider la forme de la charge de travail avant d’acheter ou de réserver de la capacité.
- Vous avez besoin d’accélérateurs, de régions ou de topologies spécifiques pour un projet défini.
- Vous pouvez tolérer le travail de configuration et de tests d’acceptation.
Utilisez des API de modèles ou une passerelle lorsque :
- Vous avez besoin d’un accès rapide à de nombreux modèles et modalités.
- La charge de travail change souvent.
- La bascule entre fournisseurs compte davantage que le contrôle brut du matériel.
- Votre équipe veut une seule clé API, une seule facture et des contrôles d’utilisation plutôt que des comptes fournisseurs éparpillés.
- Vous avez besoin d’outils tels que la recherche, l’automatisation du navigateur, l’enrichissement de données ou des API multimédias dans le même workflow.
Pour de nombreuses équipes, l’usine d’IA n’est pas un lieu unique. C’est un modèle opérationnel qui couvre des GPU loués, des API managées, des services internes et des outils d’agents.
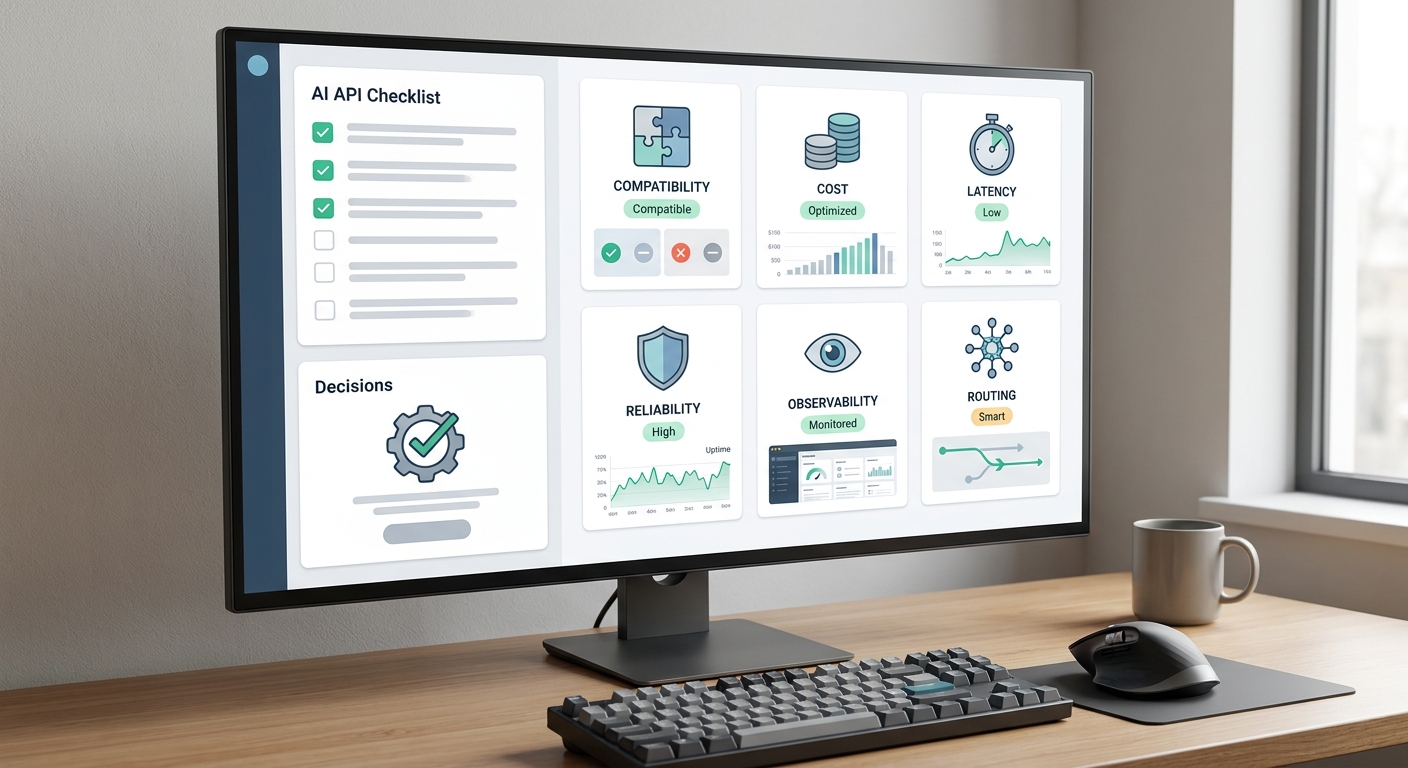
Liste de contrôle d’évaluation d’une usine d’IA
Avant d’investir dans une plateforme d’usine d’IA, posez-vous ces questions :
- Charge de travail : Entraînons-nous, affinons-nous, créons-nous des embeddings, servons-nous, générons-nous des médias, exécutons-nous des agents, ou faisons-nous tout cela ?
- Latence : Quelles charges de travail sont en temps réel, par lots, asynchrones ou avec intervention humaine ?
- Données : Quels ensembles de données, documents, journaux et résultats d’outils alimentent le système, et qui peut y accéder ?
- Stratégie de modèles : Quels modèles sont possédés, loués, à poids ouverts, API de pointe, multimodaux ou spécialisés ?
- Service : Les applications ont-elles besoin d’un point de terminaison interne stable, d’une API compatible OpenAI ou d’un accès direct au cluster ?
- Fiabilité : Que se passe-t-il lorsqu’un modèle, un fournisseur, un nœud GPU, un chemin de stockage ou une file d’attente échoue ?
- Coût : Quel est le coût par sortie acceptée après les réessais, le temps d’inactivité, le stockage, l’egress, l’ingénierie et le support ?
- Gouvernance : Comment les prompts, les sorties, les sources de données, les utilisateurs et les versions des modèles sont-ils audités ?
- Portabilité : La charge de travail peut-elle passer d’un fournisseur, d’une région, d’une famille de modèles ou d’un type de GPU à un autre ?
- Responsabilité : Quelle équipe prend en charge l’usine après le lancement ?
Si votre équipe ne peut pas répondre à ces questions, commencez plus petit. Utilisez des API managées pour le premier chemin de production, mesurez l’utilisation réelle, puis faites évoluer vers une plateforme d’usine d’IA plus formelle les charges de travail qui justifient clairement un contrôle direct des GPU.
Erreurs courantes
La première erreur consiste à considérer une usine d’IA comme un projet d’approvisionnement. Acheter des GPU n’est pas la même chose que construire un système de production d’IA.
La deuxième erreur consiste à ignorer les opérations sur les données. Une mauvaise qualité des données, des autorisations peu claires, des pipelines de récupération fragiles et l’absence d’ensembles d’évaluation créent davantage de risques en aval que le seul choix du modèle.
La troisième erreur consiste à mesurer uniquement le prix horaire du GPU. Pour l’IA en production, mesurez le travail utile achevé. Les prix de location des GPU ne sont qu’un des paramètres ; le temps d’attente en file, les nouvelles tentatives, les tâches échouées, le stockage, les mouvements de données et le temps du personnel comptent aussi.
La quatrième erreur consiste à construire une usine sur mesure pour des charges de travail qui devraient utiliser des API. Si une route gérée vers un modèle officiel est suffisante, le coût d’opportunité de l’exploitation de l’infrastructure peut dépasser les économies.
La cinquième erreur consiste à négliger la conception des pannes. Les systèmes d’IA tombent en panne à cause de la surcharge, de la dérive du modèle, d’incidents chez le fournisseur, de rejets liés aux politiques, de mauvaises récupérations, d’erreurs d’outils et de nouvelles tentatives incontrôlées. L’usine a besoin de contrôles avant l’arrivée du trafic.
Questions fréquemment posées
Qu’est-ce qu’une usine d’IA et comment fonctionne-t-elle ?
Une usine d’IA est un système de production qui transforme les données, les modèles, le calcul et les retours opérationnels en résultats d’IA. Elle fonctionne en combinant une capacité GPU ou API, des pipelines de données, la gestion du cycle de vie des modèles, l’inférence, l’observabilité, la gouvernance et les opérations de coûts dans une boucle reproductible.
Qu’est-ce qu’une plateforme d’usine d’IA ?
Une plateforme d’usine d’IA est l’infrastructure et la pile logicielle utilisées pour exécuter cette boucle. Elle peut inclure des clusters GPU, du stockage, des réseaux, des planificateurs, des pipelines de données, des registres de modèles, des points de terminaison d’inférence, de la surveillance, de la gouvernance, des contrôles de coûts et des passerelles de modèles/API.
Qu’est-ce qu’une usine d’IA NVIDIA ?
Dans la vision de NVIDIA, une usine d’IA est une infrastructure accélérée qui transforme les données d’entreprise en intelligence à l’aide de GPU, de réseaux, de logiciels et d’architectures de référence. L’enseignement utile est qu’une usine d’IA a besoin d’une pile complète autour des GPU : données, modèles, déploiement, observabilité et opérations.
Qu’est-ce qu’une usine d’IA selon NVIDIA Jensen Huang ?
Lorsque Jensen Huang parle d’usines d’IA, il décrit généralement le passage des centres de données traditionnels qui stockent et diffusent l’information à des centres de données accélérés qui produisent des jetons, des prédictions ou de l’intelligence. Pour les opérateurs, cette vision doit encore être traduite en dimensionnement des charges de travail, gouvernance des données, inférence des modèles et contrôles des coûts.
Qu’est-ce qu’une usine d’IA dans le contexte de l’entreprise ?
Dans un contexte d’entreprise, une usine d’IA est une capacité reproductible permettant de déployer et d’améliorer des fonctionnalités d’IA. Elle offre aux équipes un moyen contrôlé de transformer les données de l’entreprise et la capacité de modèles externes en flux de travail utiles, tout en suivant la qualité, les coûts, les risques et la responsabilité.
En résumé
Qu’est-ce qu’une usine d’IA ? C’est le système de production qui transforme l’IA d’expériences isolées en capacité opérationnelle. Les clusters GPU sont importants, mais ils ne constituent qu’une couche. L’usine a aussi besoin de pipelines de données, de la gestion du cycle de vie des modèles, de l’inférence, du routage, de l’évaluation, de la gouvernance et de contrôles financiers.
Pour les charges de travail qui nécessitent des modèles personnalisés ou un contrôle direct du matériel, planifiez toute la pile de l’usine d’IA avant d’acheter de la capacité. Pour les charges de travail qui peuvent utiliser des API et des outils de modèles officiels, Flatkey peut offrir une voie plus simple : une clé, un solde, une facture, et un routage entre les modèles et les outils payants à l’appel pendant que votre équipe apprend quelles charges de travail ont réellement besoin de leur propre usine.
Sources et lectures complémentaires
- NVIDIA : AI Factory
- Documentation NVIDIA : Aperçu de la conception d’AI Factory
- Dell Technologies : Dell AI Factory avec NVIDIA
- HPE : Qu’est-ce qu’une usine d’IA ?
- Flatkey : TCO d’un cluster GPU
- Flatkey : Cloud GPU vs API de modèle