
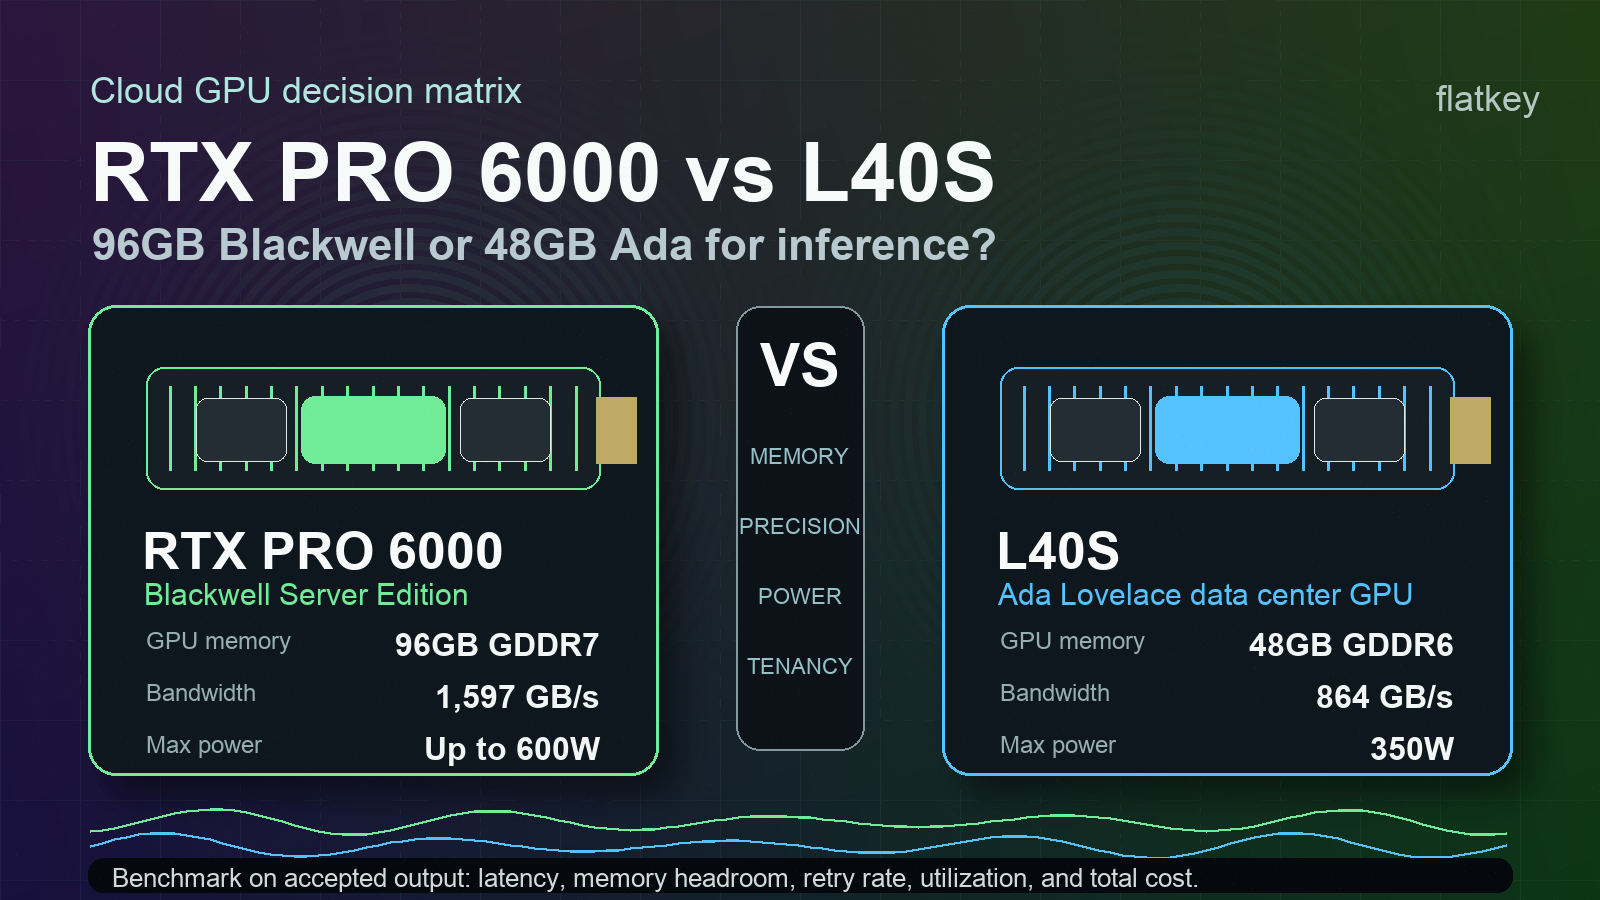
RTX PRO 6000 vs. L40S: 96 GB Blackwell oder Ada-Inference-GPU?
Die kurze Antwort für l40s vs rtx pro 6000: Wählen Sie NVIDIA RTX PRO 6000 Blackwell Server Edition, wenn 96 GB GPU-Speicher, Blackwell-FP4-Unterstützung, PCIe Gen 5, MIG-Partitionierung und neuere Media Engines Ihr Serving-Design verändern können. Wählen Sie NVIDIA L40S, wenn Ihre Workload bereits in 48 GB passt, Ihr Stack auf Ada-GPUs ausgereift ist und der Preis- oder Verfügbarkeitsunterschied groß genug ist, um die neuere Karte zu übertreffen.
Das ist keine klare Entscheidung nach dem Motto „neue GPU gewinnt immer“. Der rtx pro 6000 vs l40s-Vergleich dreht sich eigentlich um Speicherbedarf, Präzisionsunterstützung, Software-Reife, Leistungsbudget und Kosten pro akzeptierter Ausgabe. Wenn die RTX PRO 6000 Ihnen weniger Shards, größere Kontextfenster, größere Batches oder weniger Out-of-Memory-Wiederholungen ermöglicht, kann sie die stärkere Inference-GPU sein. Wenn L40S-Kapazität günstiger, einfacher zu reservieren und bereits ausreichend für Ihr Latenzziel ist, kann die ältere Ada-Karte weiterhin die pragmatische Wahl sein.
Geprüft am 13. Oktober 2026.
L40S vs. RTX PRO 6000: der praktische Unterschied
Nutzen Sie diese Tabelle als erste Beschaffungsprüfung, bevor Sie Anbieter-Benchmarks anfordern.
| Entscheidungspunkt | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA L40S |
|---|---|---|
| GPU-Generation | Blackwell | Ada Lovelace |
| Hauptgrund für den Kauf | Mehr Speicher, neuere Tensor Cores, FP4-Pfad, PCIe Gen 5, Workload-Partitionierung | Ausgereifte 48-GB-Rechenzentrum-GPU für Inference, Rendering, Grafiken und Video |
| GPU-Speicher | 96 GB GDDR7 mit ECC | 48 GB GDDR6 mit ECC |
| Speicherbandbreite | 1.597 GB/s | 864 GB/s |
| FP32 | 120 TFLOPS | 91,6 TFLOPS |
| Tensor-Präzisions-Highlights | FP4 4 PFLOPS, FP8 2 PFLOPS, FP16/BF16 1 PFLOP | FP8 733 / 1.466 TFLOPS mit Sparsity, FP16/BF16 362,05 / 733 TFLOPS mit Sparsity |
| Maximale Leistung | Bis zu 600 W konfigurierbar | 350 W |
| PCIe | PCIe Gen 5 | PCIe Gen 4 x16 |
| MIG | Bis zu vier isolierte Instanzen auf RTX PRO 6000 | Für L40S ist keine MIG-Unterstützung aufgeführt |
| Bester erster Test | LLM-Inferenz mit langem Kontext, größere multimodale Modelle, Multi-Tenant-GPU-Sharing, FP4-/Blackwell-optimiertes Serving | LLMs, die in 48 GB passen, Bildgenerierung im Stil von Stable Diffusion, Rendering, Video, ausgereifte Ada-Flotten |
Quellen: Produktseite der NVIDIA RTX PRO 6000 Blackwell Server Edition, Produktseite der NVIDIA L40S und die Blackwell-Architekturseite von NVIDIA.
Die schnelle Empfehlung
Beginnen Sie den l40s vs rtx pro 6000-Benchmark mit dem Speicher, nicht mit dem Peak-TFLOPS-Wert.
- Wählen Sie RTX PRO 6000 Blackwell Server Edition, wenn Ihr Modell auf der L40S speicherlimitiert ist, wenn Kontextlänge oder KV-Cache-Druck die Anzahl der GPUs bestimmen, wenn Sie FP4-/Blackwell-Inferenzpfade testen möchten oder wenn isolierte GPU-Slices für geteilte Enterprise-Cluster wichtig sind.
- Wählen Sie L40S, wenn Ihr Modell, Ihre Batchgröße und Ihr Kontextfenster bequem in 48 GB passen, wenn Ihr Produktions-Stack bereits für Ada optimiert ist oder wenn der Preisunterschied beim Anbieter groß genug ist, dass die ältere GPU bei den Kosten pro akzeptierter Ausgabe gewinnt.
- Verwenden Sie eine Model-API-Baseline, wenn Sie keine benutzerdefinierten Gewichte, CUDA-Kontrolle, private GPU-Planung oder direkte Medien-/Rendering-Beschleunigung benötigen. Hardware muss die Kosten und die betriebliche Einfachheit verwalteter Modellaufrufe nach Warteschlange, Wiederholungen, Leerlaufzeit und Engineering-Overhead schlagen.
Genau dieser letzte Punkt ist der Grund, warum die Entscheidung nvidia rtx pro 6000 vs l40s nicht bei einem Datenblatt enden sollte. Eine schnellere Karte kann trotzdem die falsche Anschaffung sein, wenn die Auslastung niedrig ist oder das Team GPU-Betrieb nicht selbst übernehmen muss.
Warum die RTX PRO 6000 die Inference-Diskussion verändert
Die RTX PRO 6000 Blackwell Server Edition verdoppelt die angegebene Speicherkapazität gegenüber der L40S: 96 GB GDDR7 statt 48 GB GDDR6. Außerdem steigt die angegebene Speicherbandbreite von 864 GB/s bei der L40S auf 1.597 GB/s.
Für Inference-Teams bedeutet Speicher nicht nur „Modellgröße“. Er umfasst auch KV-Cache, Puffer für Batching, Laufzeitpuffer, Adapter, multimodale Eingaben, Sicherheitsreserve für lange Prompts und Overhead durch Mandantenfähigkeit. In einem echten Dienst kann die Karte, die Out-of-Memory-Fehler vermeidet oder Tensor-Parallel-Sharding reduziert, eine günstigere Karte mit niedrigerem angegebenen Stundensatz übertreffen.
Die RTX PRO 6000 ist besonders dann einen Test wert, wenn:
- Sie LLM-Traffic mit langem Kontext bedienen und der KV-Cache die Speicherplanung dominiert.
- Sie 70B-Modelle oder größere quantisierte Modelle mit weniger Shards testen möchten.
- Sie gemischte multimodale Workloads betreiben, bei denen Bild-, Video-, Embedding-, Reranking- und LLM-Komponenten um Speicher konkurrieren.
- Sie eine physische GPU für mehrere Nutzer oder Workloads partitionieren müssen; NVIDIA nennt für die RTX PRO 6000 bis zu vier isolierte MIG-Instanzen.
- Sie Blackwell-spezifische Serving-Pfade wie FP4/NVFP4, TensorRT-LLM, vLLM oder Verbesserungen durch SGLang evaluieren.
Der Kompromiss bei der Leistungsaufnahme ist real. NVIDIA gibt für die RTX PRO 6000 bis zu 600 W konfigurierbar an, während die L40S bei 350 W liegt. Wenn Ihr Anbieter nach reserviertem Server, Leistungsaufnahme, Rack-Dichte oder reservierter Kapazität abrechnet, gehört diese höhere Obergrenze in das Kostenmodell für rtx 6000 pro vs l40s. Vergleichen Sie nicht einfach den GPU-Stundensatz, ohne zu fragen, welche Leistung, Kühlung, Host-Konfiguration, Support und Mandantenfähigkeit enthalten sind.
Warum die L40S weiterhin nützlich ist
L40S bleibt eine starke praktische GPU, weil es sich um eine ausgereifte Ada-Data-Center-Karte mit 48 GB ECC-Speicher, 864 GB/s Speicherbandbreite, 350 W maximaler Leistung und breiter Produktionsvertrautheit handelt. NVIDIA positioniert die L40S für generative KI, LLM-Training und -Inference, Grafik, Rendering, Omniverse und Video-Workloads.
Diese Reife ist in der Cloud-Beschaffung wichtig. Eine etwas ältere Karte kann gewinnen, wenn:
- Kapazität genau in der Region verfügbar ist, die Sie benötigen.
- Anbieter-Images, Treiber, Container und Monitoring bereits stabil sind.
- Der Workload mit 48 GB ohne aggressives Sharding auskommt.
- Ihr Engpass eher Wartezeit in der Queue, Datenladen, CPU-Vorverarbeitung oder Software-Scheduling ist als die rohe Tensor-Core-Spitzenleistung.
- Sie Bildgenerierung, Rendering-, Video- oder Visual-Computing-Jobs ausführen, die auf Ada bereits gut benchmarken.
Die Frage nach nvidia l40s vs rtx pro 6000 läuft oft darauf hinaus, ob die zusätzlichen 48 GB auf der RTX PRO 6000 die Bereitstellungsform verändern. Wenn nicht, kann die L40S die risikoärmere Miet- oder Reserved-Capacity-Option sein, insbesondere für Teams mit bestehenden Skripten und Baselines.
Entscheidungsmatrix nach Workload
Verwenden Sie diese Matrix, bevor Sie bei einem Anbieter ein Angebot anfordern.
| Workload | RTX PRO 6000 bevorzugen, wenn ... | L40S bevorzugen, wenn ... | Was messen |
|---|---|---|---|
| LLM-Inference mit langem Kontext | 48 GB die Kontextlänge, Batch-Größe oder den KV-Cache-Spielraum begrenzen | 48 GB die p95-Ziele für Kontext und Parallelität erfüllen | Zeit bis zum ersten Token, Tokens/s, p95-Latenz, OOM-Rate, akzeptierte Antworten/Stunde |
| Serving quantisierter Modelle der 70B-Klasse | 96 GB Sharding, Retries oder Platzierungs-Komplexität reduzieren | Ihr quantisiertes Modell und der KV-Cache bei der Ziel-Parallelität auf die L40S passen | GPU-Anzahl pro Replikat, Warteschlangenverzögerung, Qualitätswert, Retry-Rate |
| Multi-Tenant-Inference | MIG-Isolation und 96 GB Speicher die Auslastung verbessern | Mandantenfähigkeit auf Node- oder Scheduler-Ebene gehandhabt wird | Auslastung pro Tenant, Noisy-Neighbor-Vorfälle, fehlgeschlagene Jobs |
| Stable Diffusion und Bildgenerierung | Größere Modelle, größere Batches oder Mixed-Media-Phasen mehr Speicher benötigen | Vorhandene Pipelines bereits Durchsatz- und Qualitätsziele erfüllen | Akzeptierte Bilder/Stunde, VRAM-Spielraum, Kosten pro akzeptiertem Bild |
| Rendering und 3D-Grafik | Blackwell-RT-/Media-Features genau den Renderer oder die Pipeline verbessern | Die Ada-L40S-Leistung für den Renderer bereits validiert ist | Frame-/Render-Zeit, fehlgeschlagene Renderings, Durchsatz beim Media-Encoding/-Decoding |
| Enterprise-Refresh | Sie eine Blackwell-Ära-Plattform für die nächsten 24 Monate wollen | Sie inkrementelle Kapazität mit bekannten Abläufen benötigen | Auslastungsuntergrenze, Migrationsaufwand, Support-SLA, Verfügbarkeit der Kapazität |
So sollten Sie l40s vs rtx 6000 pro sinnvoll einordnen: nicht danach, welche Produktseite die größere Zahl zeigt, sondern welche GPU die Anzahl der akzeptierten Ausgaben erhöht, die Sie pro Dollar ausliefern können.
Akzeptierte Ausgaben benchmarken, nicht Spitzenspezifikationen
Ein seriöser l40s vs rtx pro 6000-Benchmark sollte Ihren Workload nachbilden, statt sich auf generische Spitzenwerte zu verlassen. Messen Sie die Ausgaben, die Ihre Nutzer oder Kunden akzeptieren.
Für LLM-Inference erfassen Sie:
| Metrik | Warum sie wichtig ist |
|---|---|
| Zeit bis zum ersten Token | Erfasst die interaktive Latenz für Nutzer |
| Inter-Token-Latenz | Zeigt das Decode-Verhalten unter realer Parallelität |
| Stabile Parallelität | Zeigt, ob 48 GB oder 96 GB das Batching verändern |
| Kontextlängen-Leiter | Findet heraus, wann KV-Cache-Druck auftritt |
| OOM- und Retry-Rate | Übersetzt Speicherpassung in reale Kosten |
| Akzeptierte Antworten pro Stunde | Normalisiert Qualitätsfilter, Fehler und Retries |
| Kosten pro 1 Mio. akzeptierten Output-Tokens | Ermöglicht es, RTX PRO 6000, L40S und Modell-APIs auf eine gemeinsame Kennzahl zu bringen |
| Engineering-Stunden pro Monat | Erfasst den Aufwand für Treiber, Kernel, Queue, Vorfälle und Benchmarks |
Für Bild-, Video-, Rendering- oder Multimodal-Workloads ersetzen Sie akzeptierte Tokens durch akzeptierte Bilder, akzeptierte Clips, gerenderte Frames oder abgeschlossene Jobs. Die Logik ist dieselbe. Eine Karte, die auf einem Hersteller-Benchmark schneller aussieht, kann verlieren, wenn sie die Queue-Contention erhöht, mehr fehlgeschlagene Jobs erzeugt oder eine Software-Migration erfordert, die Ihr Team nicht aufrechterhalten kann.
Fragen an den Anbieter vor dem Mieten von RTX PRO 6000 oder L40S
Stellen Sie vor der Entscheidung für eine der beiden GPUs diese Fragen:
- Handelt es sich bei der RTX PRO 6000-Kapazität ausdrücklich um die Blackwell Server Edition, und ist sie luftgekühlt mit Dual-Slot-Design oder flüssigkeitsgekühlt mit Single-Slot-Design?
- Ist die L40S-Kapazität dediziert, anteilig, containerisiert oder Teil eines verwalteten Job-Services?
- Welche Versionen von Treiber, CUDA, TensorRT-LLM, vLLM, SGLang, PyTorch und Container werden unterstützt?
- Stellt der Anbieter MIG auf der RTX PRO 6000 bereit, und wie werden Instanzen abgerechnet?
- Werden Benchmark-Läufe zu On-Demand-Tarifen, Reserved-Tarifen oder innerhalb eines Evaluierungsfensters abgerechnet?
- Wie lauten Region, Netzwerk-Fabric, Host-CPU, Storage-Klasse und lokale NVMe-Kapazität?
- Werden fehlgeschlagene Jobs, Leerlaufzeit, Queue-Zeit, Snapshots und Egress separat berechnet?
- Welches Support-SLA und welcher Ersatzpfad gelten, wenn ein GPU-Host nicht gesund ist?
- Können Sie GPU-Auslastung, Speichernutzung, Queue-Verzögerung, Retry-Rate und Kosten pro Job exportieren?
- Wie sieht der Fallback-Pfad aus, wenn Blackwell-Verfügbarkeit, Treiber oder Kernel Ihrem Launch-Zeitplan hinterherhinken?
Kombinieren Sie diese Antworten mit Flatkeys Leitfaden zu GPU-Mietpreisen, TCO-Arbeitsblatt für GPU-Cluster und GPU-Cloud vs. Model-API. Wenn Sie sich bei der GPU-Klasse noch nicht entschieden haben, lesen Sie vor der Eingrenzung auf nvidia l40s vs rtx pro 6000 den umfassenderen Leitfaden zur besten GPU für LLM-Inferenz.
Wo Flatkey passt
Flatkey ersetzt RTX PRO 6000 oder L40S nicht, wenn Sie direkte GPU-Kontrolle benötigen. Wenn Sie private Gewichte, benutzerdefinierte Kernel, strenge Datenlokalität, dedizierte Rendering-Pipelines oder Forschung auf Hardwareebene betreiben, benötigen Sie weiterhin Cloud-GPU-Kapazität oder eigene Infrastruktur.
Flatkey ist die zu schlagende Baseline, wenn Ihr Team vor allem zuverlässige Modellausgaben benötigt. Mit einem Schlüssel und einem Guthaben über offizielle Modelle und KI-Tools hinweg können Teams API-Workloads routen, Nutzung verfolgen, Modellkosten vergleichen und verstreute Anbieter-Accounts vermeiden. Das gibt Finance und Engineering eine saubere Kontrollgruppe, bevor sie sich auf feste GPU-Kapazitäten festlegen.
Praktisch gesehen gibt es drei Pfade:
| Pfad | Wann er gewinnt |
|---|---|
| RTX PRO 6000 | Mehr Speicher oder Blackwell-Funktionen reduzieren die GPU-Anzahl, Ausfälle oder Latenz genug, um die höheren Kosten auszugleichen |
| L40S | 48 GB sind ausreichend und die reife Ada-Kapazität hat den besten Preis pro akzeptierter Ausgabe |
| Verwaltete Model-API über Flatkey | Direkte GPU-Kontrolle ist nicht erforderlich und operative Einfachheit schlägt Infrastrukturbesitz |
Der richtige Gewinner ist der Pfad mit den niedrigsten Kosten pro akzeptierter Ausgabe bei Ihrem Qualitäts- und Latenzziel.
Empfehlung zum Schluss
Für l40s vs rtx pro 6000 sollten Sie die RTX PRO 6000 zuerst als Benchmark heranziehen, wenn Speicherreserve, FP4-/Blackwell-Unterstützung, PCIe Gen 5 oder MIG-Partitionierung die Bereitstellungsarchitektur verändern können. Nehmen Sie die L40S zuerst als Benchmark, wenn der Workload bereits in 48 GB passt und die reife Ada-Kapazität günstiger oder einfacher zu reservieren ist.
Vergleichen Sie dann beide mit einer Model-/API-Baseline. Wenn Flatkey oder ein anderer verwalteter API-Pfad Qualität, Latenz, Datenschutz und Kostenanforderungen erfüllt, muss die GPU-Miete ihren zusätzlichen Betriebsaufwand rechtfertigen. Wenn das nicht gelingt, ist der Hardware-Pfad gerechtfertigt, und die finale Entscheidung wird zu einem Workload-Playback: rtx pro 6000 vs l40s anhand der akzeptierten Ausgabe, nicht anhand von Marketing-Spitzenwerten.
Häufig gestellte Fragen
Ist die RTX PRO 6000 Blackwell schneller als die L40S?
Laut den öffentlichen Spezifikationen von NVIDIA hat die RTX PRO 6000 Blackwell Server Edition eine höhere angegebene FP32-Leistung, mehr Speicher, mehr Speicherbandbreite, neuere Tensor Cores und FP4-Unterstützung. Das bedeutet nicht, dass sie für jeden Workload günstiger ist. Benchmarken Sie Ihren genauen Serving-Stack und die Kosten pro akzeptierter Ausgabe.
Ist die L40S immer noch gut für LLM-Inferenz?
Ja, wenn Modell, Kontextfenster und Parallelitätsziel in 48 GB passen. Die L40S kann weiterhin praktisch für LLM-Inferenz, Bilderzeugung, Rendering, Video und gemischte visuelle Workloads sein, insbesondere dort, wo die Anbieter-Kapazität reif ist.
Was ist der größte Unterschied zwischen NVIDIA RTX PRO 6000 und L40S?
Der größte praktische Unterschied ist der Speicher. Die RTX PRO 6000 Blackwell Server Edition gibt 96 GB GDDR7 und 1.597 GB/s Speicherbandbreite an; die L40S gibt 48 GB GDDR6 und 864 GB/s Speicherbandbreite an. Die RTX PRO 6000 ergänzt außerdem einen Blackwell-FP4-Pfad und MIG-Unterstützung.
Sollte ich von der L40S auf die RTX PRO 6000 upgraden?
Upgraden Sie, wenn Speichergrenzen der L40S zusätzliche Shards, kleinere Batches, kürzere Kontextfenster, fehlgeschlagene Jobs oder eine geringe Auslastung verursachen. Bleiben Sie bei der L40S, wenn sie Ihre Latenz- und Qualitätsziele bereits zu geringeren Kosten pro akzeptierter Ausgabe erfüllt.
Sollte ich stattdessen eine Model-API nutzen, anstatt eine der beiden GPUs zu mieten?
Nutzen Sie eine Model-API, wenn Sie keine benutzerdefinierten Gewichte, keine direkte CUDA-Kontrolle, keine private GPU-Planung oder keine Rendering-/Media-Beschleunigung benötigen. Eine Model-API kann der wirtschaftlich bessere Weg sein, wenn die Workload-Nachfrage schwankt oder die GPU-Auslastung niedrig wäre.
Geprüfte Quellen
- NVIDIA RTX PRO 6000 Blackwell Server Edition Produktseite
- NVIDIA L40S Produktseite
- NVIDIA Blackwell-Architektur-Seite
- Flatkey-Themenkarte für Cloud-GPU und Quelle für das Cloud-GPU-Keyword vom 10.10.2026
- Flatkey-Produktübersicht und freigegebene Positionierung: ein Schlüssel, ein Guthaben, offizielle Modelle, Nutzungsprotokoll pro erfolgreichem Aufruf


