
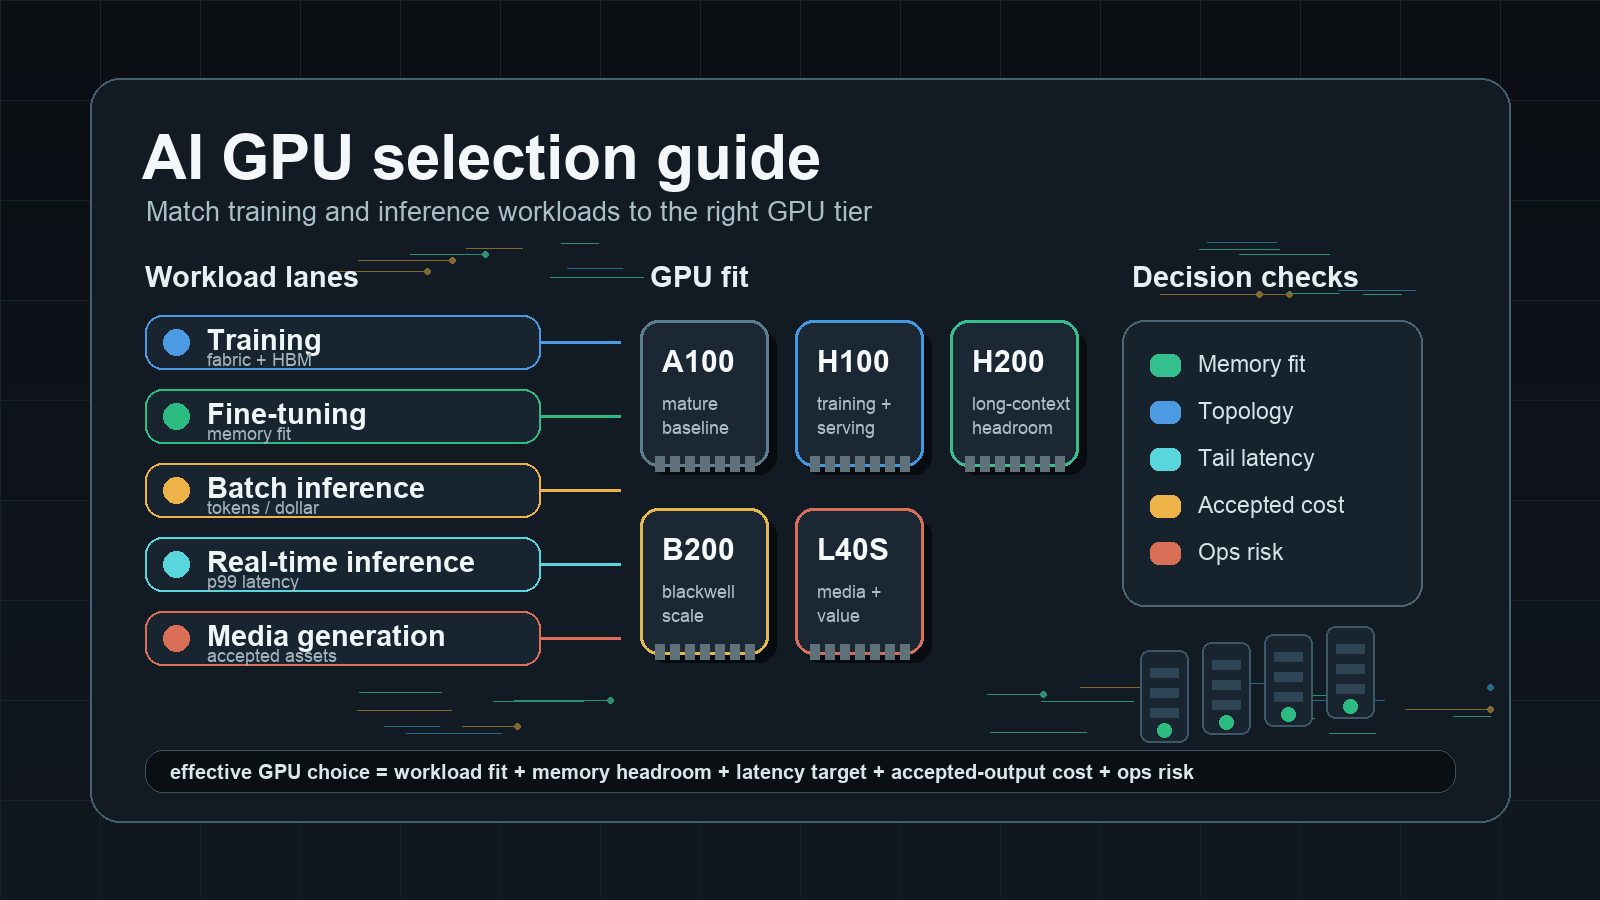
Guía de selección de GPU para IA: adapta las cargas de trabajo de entrenamiento e inferencia a la GPU adecuada
Una guía de selección de GPU para IA debe empezar por la carga de trabajo, no por el nombre del acelerador más reciente. El entrenamiento, el ajuste fino, la inferencia por lotes, la inferencia en tiempo real, los pipelines de recuperación, la generación de medios y los trabajos de evaluación ejercen presión sobre las GPU de distintas maneras. La GPU equivocada puede parecer atractiva en una tarifa y aun así perder cuando incluyes el ajuste de memoria, la topología de red, el tiempo de inactividad, la cola, el trabajo de la pila de serving y la calidad del resultado aceptado.
Usa esta guía de selección de GPU para IA como una lista de verificación de adquisición y arquitectura. Mapea las cargas de trabajo de IA comunes a los rasgos de GPU que importan, explica cuándo tienen sentido H100, H200, B200, A100, L40S, sistemas de clase GB200 y GPU locales de clase RTX, y ofrece un plan de evaluación comparativa que mantiene la decisión de compra ligada al trabajo completado en lugar de a cifras sintéticas de pico.
La regla práctica de Flatkey: elige las GPU por coste por ejecución de entrenamiento completada, coste por token aceptado, coste por imagen o vídeo aceptado y por el riesgo operativo que estás dispuesto a asumir. Si solo necesitas acceso al modelo, gobernanza, fallback y un único libro mayor de uso, compara el alquiler de GPU con rutas de modelo/API antes de comprometerte con hardware.
Respuesta rápida de la guía de selección de GPU para IA
Empieza con esta matriz antes de comparar presupuestos de proveedores.
| Carga de trabajo | Normalmente prioriza | Dirección de GPU | Aspectos a vigilar |
|---|---|---|---|
| Preentrenamiento o entrenamiento a gran escala | Red multi-nodo, capacidad HBM, ancho de banda de memoria, rendimiento BF16/FP8, I/O de checkpoints | H100/H200, sistemas de clase B200/GB200, clústeres de entrenamiento gestionados | El precio por hora es secundario frente al tiempo de ejecución completado y al riesgo de reinicio |
| Ajuste fino completo | Margen de memoria, ajuste del estado del optimizador, paralelismo tensorial, localización del almacenamiento | H100, H200, B200, A100 para modelos más pequeños | La falta de VRAM puede obligar a un sharding más lento o a tamaños de lote más pequeños |
| Ajuste fino LoRA/QLoRA | Ajuste a la VRAM, compatibilidad CUDA, rendimiento por dólar | A100, L40S, H100, H200, GPU locales de gama alta para trabajos pequeños | El conjunto de datos y la longitud del contexto pueden cambiar la respuesta de memoria |
| Inferencia LLM por lotes | Ajuste de memoria, eficiencia del batching, tokens por dólar, tolerancia a la cola | L40S, A100, H100, H200, B200 según el tamaño del modelo | Una baja utilización puede anular tarifas de GPU más baratas |
| Inferencia LLM en tiempo real | Latencia p95/p99, capacidad de la KV cache, estabilidad del streaming, compatibilidad de la pila de serving | H100/H200/B200 para modelos grandes o de contexto largo; L40S/A100 para modelos más pequeños | La latencia de cola y los reintentos importan más que los tokens/segundo máximos |
| Embeddings y reranking | Rendimiento por dólar, equilibrio CPU/GPU, tamaño del lote, simplicidad del servicio | L40S, A100, GPU cloud más pequeñas, a veces CPU para bajo volumen | El exceso de GPU es común con poco tráfico |
| Generación de imágenes y vídeo | VRAM, kernels de medios, rendimiento del almacenamiento, tolerancia a la cola | L40S, H100/H200/B200 para pipelines más pesados, estaciones de trabajo locales de clase RTX para creadores | El coste de imagen/clip aceptado de extremo a extremo supera a la velocidad bruta de renderizado |
| Evaluación y datos sintéticos | Capacidad de ráfaga, controles de coste, variedad de modelos | GPU spot/marketplace, APIs por lotes o rutas de modelo/API | Evita poseer capacidad ociosa para picos ocasionales |
La respuesta rápida no es intencionadamente "compra la GPU más rápida". Para los equipos de IA empresariales, la mejor GPU es la que encaja con el modelo, la longitud del contexto, el objetivo de latencia, la concurrencia, el límite de datos y el modelo operativo del equipo.
Paso 1: clasifica la carga de trabajo
El primer paso en cualquier guía de selección de GPU para IA es la clasificación de la carga de trabajo. Sin ella, toda comparación posterior se derrumba en un debate genérico sobre aceleradores.
Toda discusión sobre GPU debe empezar con un resumen de la carga de trabajo. Escríbelo antes de pedir presupuestos a los proveedores.
| Campo | Qué capturar |
|---|---|
| Tipo de carga de trabajo | Entrenamiento, ajuste fino, inferencia por lotes, inferencia en línea, generación de medios, embeddings, evaluación o notebooks |
| Forma del modelo | Número de parámetros, arquitectura, precisión, cuantización, ventana de contexto, modalidad y comportamiento del tokenizador |
| Forma de la solicitud | Tokens de entrada promedio y p95, tokens de salida, tamaño de imagen, duración de vídeo, tamaño del lote, sesiones concurrentes o registros por trabajo |
| Unidad de éxito | Ejecutución de entrenamiento completada, parche aceptado, respuesta aceptada, token aceptado, imagen aceptada, clip aceptado o registro aceptado |
| Objetivo de latencia | Sin conexión, minutos, segundos, subsegundo, requisito p95/p99 o requisito de streaming |
| Ciclo de trabajo | Siempre activo, por lotes programado, ráfaga estacional, experimental o notebook de desarrollador |
| Límite operativo | Nube pública, red privada, clúster dedicado, on-premises, residencia de datos o API gestionada |
| Herramientas | vLLM, SGLang, TensorRT-LLM, Triton, Ray, Slurm, Kubernetes, ComfyUI o endpoints gestionados por el proveedor |
Si no puedes completar esta tabla, pausa la selección de GPU. Sigues comprando posibilidad, no capacidad.
Paso 2: elige la métrica de decisión correcta
El segundo paso en una guía de selección de GPU para IA es elegir el denominador. Un buen denominador vincula la decisión sobre la GPU al trabajo completado, no a una hoja de especificaciones del proveedor.
Los FLOPS máximos, el número de Tensor Cores y el precio horario de la GPU son entradas útiles, pero no son la métrica de decisión. Usa un denominador vinculado al resultado del negocio.
| Carga de trabajo | Métrica mejor |
|---|---|
| Entrenamiento | Costo por ejecución de entrenamiento completada que alcance la puntuación de evaluación objetivo |
| Fine-tuning | Costo por checkpoint ajustado aceptado |
| Inferencia en línea | Costo por respuesta aceptada en el objetivo de latencia p95/p99 |
| Inferencia por lotes | Costo por registro aceptado o token de salida aceptado |
| Agentes de código | Costo por tarea aceptada, parche aceptado o incidencia resuelta |
| Generación de imágenes | Costo por imagen aceptada después de los filtros de calidad |
| Generación de vídeo | Costo por segundo aceptado o clip aceptado |
| Evaluación | Costo por suite de evaluación completada y tiempo de respuesta |
Usa esta fórmula base:
effective_unit_cost =
  all_in_workload_cost
  / accepted_outputs_after_retries_failures_and_quality_filters
Para entrenamiento:
training_run_cost =
  gpu_hours
  + storage
  + network
  + checkpointing
  + failed_run_waste
  + platform_labor
Para inferencia:
inference_cost_per_accepted_output =
  gpu_compute
  + storage
  + serving_stack
  + idle_capacity
  + retry_waste
  + observability
  + platform_labor
  / accepted_outputs
Aquí es donde cambian las elecciones de GPU. Una GPU que gana una prueba comparativa de rendimiento puede perder si requiere una topología costosa, funciona con baja utilización, no alcanza el objetivo de latencia o obliga a realizar trabajo operativo adicional.
Selección de GPU para entrenamiento
Para entrenamiento, una guía de selección de GPU para IA debería comportarse como una guía de clúster. La GPU individual importa, pero la ubicación, la interconexión, el almacenamiento y el comportamiento de reinicio suelen decidir el costo de la ejecución completada.
El entrenamiento necesita gran memoria, alto ancho de banda de memoria, redes GPU a GPU de alta velocidad, una ubicación multinodo estable y fiabilidad en los checkpoints. Es menos tolerante que la inferencia porque un nodo fallido puede desperdiciar horas o días de cómputo.
Lo que más importa en el entrenamiento
- Capacidad de HBM: los parámetros del modelo, los gradientes, los estados del optimizador, las activaciones, la longitud de secuencia y el tamaño del lote compiten por la memoria.
- Ancho de banda de memoria: las operaciones matriciales grandes y los pasos del optimizador pueden estar limitados por el ancho de banda.
- Interconexión: NVLink, NVSwitch, InfiniBand, RoCE, EFA o la red de IA específica del proveedor pueden decidir si el escalado es eficiente.
- Compatibilidad de precisión: BF16, FP8 y nuevas rutas de baja precisión solo importan si tu framework y tu receta de modelo las usan de forma segura.
- Almacenamiento e I/O de checkpoints: el tiempo de escritura del checkpoint y el tiempo de recuperación forman parte del costo de la ejecución completada.
- Fiabilidad de la ubicación: las GPUs correctas dispersas en una red débil no son lo mismo que un clúster de entrenamiento coherente.
Dirección de GPU para entrenamiento
Usa H100 o H200 cuando necesites soporte de entrenamiento probado de clase Hopper y una amplia madurez de framework. H200 añade más capacidad y ancho de banda de HBM que H100, lo que resulta útil para entrenamiento y fine-tuning con alta demanda de memoria. Usa sistemas de clase B200 o GB200 cuando la carga de trabajo pueda beneficiarse del rendimiento de clase Blackwell, de rutas de menor precisión, y cuando un proveedor pueda entregar realmente la topología, el soporte del framework y las pruebas de aceptación que necesitas. Usa A100 cuando el modelo sea más pequeño, la receta de entrenamiento esté madura, el presupuesto sea limitado o la disponibilidad importe más que el rendimiento máximo.
No elijas una GPU para entrenamiento a partir de un único benchmark. Ejecuta tu receta exacta o un proxy cercano. Mide el tiempo hasta la puntuación de evaluación objetivo, el comportamiento de reinicio, el tiempo de checkpoint y el costo total. Las decisiones H100 vs A100 y H200 vs H100 suelen ser decisiones de ejecución completada, no decisiones de tarifa horaria.
Lecturas complementarias útiles: H100 vs A100, H200 vs H100, B200 vs H200, y B300 vs B200.
Selección de GPU para Fine-Tuning
El fine-tuning se sitúa entre el entrenamiento y la inferencia. El fine-tuning completo se comporta como entrenamiento, mientras que LoRA y QLoRA pueden caber en hardware más pequeño si se controlan el tamaño del modelo, la longitud de contexto, el tamaño del lote y la precisión.
Fine-tuning completo
Para fine-tuning completo, prioriza primero la memoria y la topología. La GPU debe contener el estado de entrenamiento o fragmentarlo eficientemente. H100, H200, B200 y clústeres multi-GPU A100 son direcciones comunes según el tamaño del modelo y el presupuesto. Las GPUs H200 y de clase B200 pueden reducir la presión de fragmentación para trabajos con mucha memoria, pero solo si la pila del proveedor y la versión del framework están listas.
Preguntas que hacer:
- ¿Cuál es el modelo más grande y la longitud de contexto que debes ajustar?
- ¿Los estados del optimizador están cargados por completo, fragmentados, descargados o cuantizados?
- ¿El trabajo necesita paralelismo tensorial, paralelismo de pipeline, FSDP, DeepSpeed u otro enfoque distribuido?
- ¿El conjunto de datos está local en la región de la GPU?
- ¿Qué tan caro es un checkpoint fallido?
Fine-tuning de adaptadores
Para LoRA, QLoRA, instruction tuning y adaptación a dominios más pequeños, la respuesta puede ser más flexible. A100, L40S, H100, H200 y GPUs locales de clase RTX pueden encajar en distintas partes del flujo de trabajo. El riesgo es asumir que una demostración pequeña significa que el trabajo de producción cabrá. Contextos más largos, lotes más grandes, más ejemplos y ejecuciones de validación pueden empujar el trabajo a una clase diferente.
Este es un buen lugar para ejecutar un benchmark en dos etapas: primero demostrar que cabe en memoria, luego demostrar el tiempo hasta el checkpoint y el coste por modelo afinado aceptado.
Selección de GPU para inferencia de LLM
Para la inferencia, una guía de selección de GPU para IA debe separar el ajuste de memoria del ajuste de latencia. Una GPU puede cargar el modelo y aun así no cumplir el objetivo de p99 en producción.
La inferencia no es una sola carga de trabajo. La GPU adecuada cambia según el tamaño del modelo, la longitud del contexto, la concurrencia, el objetivo de latencia y si las solicitudes son por lotes o en tiempo real.
Primero viene el ajuste de memoria
Para la inferencia de LLM, la memoria de la GPU debe acomodar los pesos del modelo y la caché KV con suficiente margen para el framework de servicio. El contexto largo y la alta concurrencia pueden hacer que la caché KV sea la principal presión sobre la memoria. Una GPU que encaja un modelo para un usuario puede fallar con la concurrencia de producción.
Usa esta lista de verificación:
- Tamaño de los pesos en tu precisión: FP16, BF16, FP8, INT8, INT4 u otro formato cuantizado.
- Ventana de contexto y longitud de entrada p95 esperada.
- Longitud de salida y comportamiento de streaming.
- Sesiones concurrentes y tamaño de lote.
- Estrategia de caché KV, caché de prefijos y comportamiento de expulsión.
- Overhead del framework de servicio.
- Margen de seguridad para picos y fragmentación.
Si la memoria es ajustada, una GPU con más memoria puede superar a una GPU teóricamente más rápida pero con menos memoria, porque evita el sharding, el offload o una cuantización de menor calidad.
Inferencia en tiempo real
La inferencia en tiempo real se fija en la latencia p95 y p99, no solo en el rendimiento medio. Las GPUs de clase H100, H200 y B200 suelen encajar mejor para modelos grandes, contexto largo y cargas sensibles a la latencia. L40S y A100 pueden ser rentables para modelos más pequeños, menor concurrencia o cargas en las que los objetivos de p99 son más laxos.
Mide:
- Tiempo hasta el primer token.
- Latencia entre tokens.
- Latencia extremo a extremo p95/p99.
- Tokens por segundo por GPU.
- Tokens aceptados por dólar.
- Tasa de error bajo tráfico en ráfagas.
- Amplificación de reintentos bajo límites de tasa, OOMs o despliegues.
Para la elección del stack de servicio, usa vLLM vs SGLang y la guía de despliegue de vLLM.
Inferencia por lotes
La inferencia por lotes puede intercambiar latencia por rendimiento. Eso abre más opciones de GPU. L40S, A100, H100, H200 y B200 pueden tener sentido si el modelo cabe y la utilización es alta. La métrica decisiva suele ser el número de salidas aceptadas por dólar durante la ventana del lote.
Las cargas por lotes también encajan bien con capacidad spot, ventanas reservadas o capacidad de GPU serverless cuando el comportamiento de reintento está controlado. Si el mismo lote puede enviarse a una API de modelo con menor carga operativa, compara ambas rutas con la hoja de trabajo de nube de GPU vs API de modelo.
Selección de GPU para generación de medios
La generación de imágenes y vídeo suele comportarse de forma diferente a la inferencia de texto. La VRAM, la complejidad del pipeline del modelo, la E/S de almacenamiento y la tolerancia al encolado importan más que la latencia conversacional.
L40S suele ser atractiva para cargas de trabajo de imagen y medios más pequeños porque tiene una fuerte inferencia y características orientadas a gráficos a un nivel de adquisición inferior al de las GPUs de clase H100. H100, H200 y B200 se vuelven más relevantes cuando las cargas de trabajo son más pesadas, más grandes, multimodales o están fuertemente restringidas por la latencia. Las estaciones de trabajo locales de clase RTX pueden ser útiles para creadores, prototipado y pipelines de bajo volumen, pero los equipos de producción siguen necesitando encolado, almacenamiento, reintentos y observabilidad.
Usa el coste por imagen o clip aceptado, no el tiempo bruto de renderizado:
media_accepted_cost =
  gpu_cost
  + storage
  + failed_renders
  + moderation_or_quality_filtering
  + queue_overhead
  + operator_review
  / accepted_assets
Si tu equipo solo necesita acceso a varios modelos de imagen o vídeo, una ruta de modelo/API puede ser más simple que ejecutar pipelines de medios en GPU. Usa la misma disciplina de adquisición que usarías para texto: coste por resultado aceptado, no solo el precio de lista.
Resumen rápido de modelos de GPU
Usa esta tabla como punto de partida y luego verifica las especificaciones y la disponibilidad actuales en las páginas oficiales del proveedor. No la trates como una tabla de precios.
| Familia de GPU | Función práctica | Señales de mejor ajuste | Advertencias comunes |
|---|---|---|---|
| NVIDIA A100 | Base madura para entrenamiento e inferencia | Recetas existentes, variantes de 40GB/80GB, amplia disponibilidad en la nube, cargas de trabajo sensibles al presupuesto | Generación anterior; menor ancho de banda de memoria y rutas de precisión más nuevas que H100/H200/B200 |
| NVIDIA H100 | Caballo de batalla de entrenamiento e inferencia de clase Hopper | Gran madurez de frameworks, soporte de Transformer Engine FP8, alto ancho de banda de memoria, opciones NVLink/NVSwitch | La oferta y el precio aún pueden estar ограничados; la memoria puede ser ajustada para inferencia con contexto muy largo/alta concurrencia |
| NVIDIA H200 | Opción Hopper con mayor memoria | Mayor capacidad y ancho de banda HBM que H100; útil para inferencia con contexto largo y trabajos intensivos en memoria | La disponibilidad y el precio varían; compárelo con H100 para su carga de trabajo exacta |
| NVIDIA B200 | Acelerador de clase Blackwell | Entrenamiento e inferencia pesados, rutas de precisión más baja más nuevas, gran memoria y ancho de banda | Requiere preparación de la pila, disponibilidad del proveedor y validación de topología |
| Sistemas NVIDIA GB200 / a escala de rack | Entrenamiento grande e inferencia de alta densidad | Trabajos a escala de clúster donde la arquitectura del sistema importa tanto como el silicio de la GPU | La adquisición y las operaciones son decisiones de sistema, no de una sola GPU |
| NVIDIA L40S | Inferencia y medios sensibles al costo | Memoria de clase 48GB, canalizaciones de imagen/video, inferencia de LLM más pequeños, trabajos por lotes | No es un sustituto universal de H100/H200 para entrenamiento grande o inferencia de LLM p99 estricta |
| GPU locales de clase RTX | Experimentación local y flujos de trabajo de creadores | Prototipado, modelos pequeños, iteración en estación de trabajo privada | Memoria limitada, historia de operaciones de centro de datos más débil, no es por sí sola un clúster de producción |
La tabla oculta una verdad importante de adquisición: el modelo de GPU es solo una parte de la respuesta. La forma del nodo, el almacenamiento, el planificador, la interconexión, el modelo de cuota y la calidad del soporte pueden decidir si la GPU es útil.
La lista de verificación de adquisición
Antes de comprar o alquilar, pida a los proveedores estos detalles.
Hardware y topología
- Modelo exacto de GPU, capacidad de memoria, forma del nodo y GPUs por nodo.
- Interconexión dentro del nodo y entre nodos.
- CPU, RAM, NVMe local, ancho de banda de almacenamiento y ancho de banda de red.
- Suposiciones de región, zona, grupo de colocación, rack o clúster dedicado.
- Proceso de reemplazo de GPU, nodos, almacenamiento y dispositivos de red fallidos.
Pila de software
- Versión de driver, CUDA, cuDNN, NCCL, runtime de contenedores y versiones compatibles del framework.
- Modelo de acceso con Kubernetes, Slurm, endpoint gestionado o bare metal.
- Compatibilidad con vLLM, SGLang, TensorRT-LLM, Triton, Ray o canalizaciones de medios.
- Campos de observabilidad para utilización de GPU, memoria, espera en cola, latencia, errores y gasto.
- Proceso de actualización y reversión.
Modelo comercial
- Bajo demanda, spot, reservado, marketplace, clúster dedicado, nube privada o endpoint gestionado.
- Compromiso mínimo, derechos de cancelación, tarifas por exceso y niveles de soporte.
- Costos de almacenamiento, salida de datos, snapshots, IP pública, balanceador de carga y red privada.
- Formato de exportación de uso y granularidad de la factura.
- Si la capacidad ociosa se factura y cómo funciona la automatización del apagado.
Seguridad y gobernanza
- Perímetro de red, modelo VPC/VNet, soporte de endpoint privado y política de salida.
- IAM, manejo de secretos, registros de auditoría, acceso de soporte y notificación de incidentes.
- Almacenamiento de datos, retención de checkpoints, copias de seguridad, eliminación y retención legal.
- Evidencia de cumplimiento y soporte para revisión del proveedor.
- Presupuestos por equipo, cuotas, etiquetas y soporte de chargeback/showback.
Esta lista de verificación aplica a la nube pública de GPU, la nube privada de GPU y el alquiler de clústeres de GPU. Cuanto mayor sea el compromiso, más evidencia debería exigir.
Plan de benchmark: cómo probar antes de comprometerse
Esta es la parte de la guía de selección de GPU para IA que debería convertirse en su evidencia de adquisición. Guarde las entradas, salidas y criterios de aceptación para que los equipos de finanzas y plataforma puedan revisar la decisión más adelante.
Ejecute un benchmark que se parezca a su carga de trabajo. No dependa solo de tablas públicas de benchmarks.
Fase 1: prueba de ajuste de memoria
- Cargue el modelo exacto o el proxy más cercano.
- Use la precisión y cuantización previstas.
- Establezca la longitud de contexto y el tamaño de lote objetivo.
- Ejecute prompts o registros representativos.
- Registre el pico de memoria, la fragmentación, la tasa de OOM y el margen seguro.
Fase 2: prueba de rendimiento y latencia
- Pruebe tráfico constante y tráfico en ráfagas.
- Mida la latencia p50, p95 y p99.
- Mida el tiempo hasta el primer token para cargas de trabajo LLM en streaming.
- Mida tokens/seg, imágenes/hora, clips/hora o registros/hora.
- Registre las salidas aceptadas, no solo las salidas generadas.
Fase 3: prueba de fallos y operaciones
- Mate un worker, drene un nodo, reinicie la pila de serving y simule un despliegue defectuoso.
- Verifique la recuperación de checkpoints para entrenamiento y ajuste fino.
- Compruebe el tiempo de arranque en frío y el tiempo de carga del modelo.
- Confirme que los registros y métricas estén disponibles para los equipos de plataforma, seguridad y finanzas.
- Valide que la atribución de costos sobreviva a reintentos y fallos.
Fase 4: normalización financiera
Crea una fila para cada candidato:
| Candidato | Costo de GPU | Almacenamiento/red | Trabajo de plataforma | Desperdicio por fallos | Resultados aceptados | Costo unitario efectivo | Notas |
|---|---|---|---|---|---|---|---|
| Proveedor A H100 | Entrada de la cotización | Agregar extras verificados en origen | Estimación | Medido | Medido | Calculado | Incluir latencia p95 |
| Proveedor B H200 | Entrada de la cotización | Agregar extras verificados en origen | Estimación | Medido | Medido | Calculado | Incluir margen de memoria |
| Ruta de modelo/API | Costo de API verificado en origen | Costo de gateway/operaciones | Estimación de operaciones más baja | Reintentos medidos | Medido | Calculado | Incluir aceptación de calidad |
Esto convierte la guía de selección de GPU para IA en un registro de निर्णय para que finanzas, plataforma y producto puedan revisarlo.
¿Alquilar, reservar, comprar o usar una API de modelo?
El paso final de esta guía de selección de GPU para IA es decidir si la capacidad debe alquilarse, reservarse, comprarse o evitarse mediante una API de modelo.
La selección del modelo de GPU y la selección del modelo de capacidad son decisiones separadas.
| Situación | Mejor punto de partida |
|---|---|
| Demanda incierta, modelos cambiantes o prototipos | API de modelo o alquiler a corto plazo |
| Experimentos intermitentes y trabajos de evaluación | GPU spot/de marketplace o API de modelo por lotes |
| Inferencia estable de alto volumen en un solo modelo | GPU reservada, endpoint dedicado o clúster comprometido |
| Entrenamiento multinodo con requisitos de topología | Clúster de entrenamiento dedicado o tejido de alta velocidad reservado |
| Red privada estricta o aislamiento de hardware | Nube privada de GPU o clúster dedicado |
| Necesidad de muchos modelos oficiales, una sola factura y respaldo | Rutas de modelo/API gobernadas por Flatkey |
Si el argumento a favor de las GPU es principalmente "necesitamos acceso a modelos de IA", empieza con el enrutamiento de modelo/API. Si el argumento es "necesitamos controlar la topología, el tiempo de ejecución, los pesos, el límite de datos o los kernels personalizados", mantén abierta la vía de GPU. La diferencia importa porque la infraestructura GPU conlleva propiedad sobre el programador, el entorno de ejecución, la seguridad, FinOps y los incidentes.
Flatkey ayuda en el lado de API de esa decisión: una clave, un saldo, una factura, controles del libro mayor de uso y rutas oficiales de modelos/herramientas. No sustituye el control de hardware cuando el requisito es el control de hardware. Es la alternativa más simple cuando el requisito real es acceso gobernado a modelos y visibilidad de costes.
Errores comunes en la selección de GPU
Error 1: elegir por tarifa por hora
La tarifa por hora ignora la utilización, los reintentos, el tiempo en reposo, el almacenamiento, la red, el soporte y el tiempo de los ingenieros. Usa el coste por carga de trabajo completada en su lugar. La guía de precios de alquiler de GPU cubre las líneas de coste ocultas.
Error 2: tratar el ajuste de memoria como una pregunta de sí/no
Que la memoria encaje con una longitud de prompt o tamaño de lote no demuestra que encaje en producción. El contexto largo, la alta concurrencia, los cambios de modelo y la sobrecarga del framework de serving pueden cambiar la respuesta.
Error 3: ignorar la interconexión
Para trabajos multinodo y con varias GPU, la topología forma parte de la GPU. Un grupo de GPU más barato con una colocación deficiente puede perder frente a un clúster más caro pero coherente.
Error 4: comparar resultados generados en lugar de resultados aceptados
Las cargas de trabajo de IA tienen filtros de calidad, filtros de seguridad, reintentos, generaciones fallidas, parches fallidos y evaluaciones fallidas. Mide el coste de los resultados aceptados.
Error 5: olvidar la responsabilidad de la plataforma
Alguien tiene que ejecutar drivers, CUDA, contenedores, servidores de modelos, autoescalado, cuotas, registro, alertas, incidencias y reportes de gasto. Si ese equipo no existe, tenlo en cuenta.
Error 6: comprar solo para el modelo de hoy
La elección del modelo cambia. Las ventanas de contexto crecen. La cuantización mejora. La disponibilidad del proveedor cambia. Mantén flexible el registro de decisiones y evita compromisos que asuman que un solo modelo seguirá dominando.
Fuentes oficiales que revisar
Usa páginas oficiales para detalles volátiles o específicos del proveedor:
- Resumen de NVIDIA H100 para contexto de GPU de clase Hopper: NVIDIA H100 Tensor Core GPU.
- Resumen de NVIDIA H200 para contexto de mayor memoria HBM3e y ancho de banda: NVIDIA H200 Tensor Core GPU.
- Materiales de NVIDIA Blackwell/DGX B200 y GB200 para contexto de sistema Blackwell: NVIDIA DGX B200 y NVIDIA GB200 NVL72.
- Resumen de NVIDIA A100 para contexto de referencia madura de Ampere: NVIDIA A100 Tensor Core GPU.
- Página de NVIDIA L40S para contexto de inferencia y cargas de trabajo de gráficos/medios: NVIDIA L40S.
- Documentación de NVIDIA MIG al particionar GPUs compatibles: NVIDIA Multi-Instance GPU User Guide.
- Documentación de marcos de serving para ajuste en tiempo de ejecución: servidor compatible con OpenAI de vLLM, documentación de SGLang y NVIDIA TensorRT-LLM.
- Solicitudes de cotización del proveedor y páginas de precios para disponibilidad y coste actuales. Marca con fecha y hora cada precio que copies en una hoja de trabajo de compras.
Preguntas frecuentes
¿Cuál es la mejor GPU para entrenamiento de IA?
La mejor GPU para entrenamiento de IA depende del tamaño del modelo, la receta de entrenamiento, el requisito de memoria, la interconexión, el comportamiento de los checkpoints y el tiempo hasta alcanzar la puntuación objetivo de evaluación. Los sistemas de clase H100, H200, B200 y GB200 son candidatos sólidos para trabajos de entrenamiento grandes, mientras que A100 aún puede ser viable para cargas de trabajo más pequeñas o sensibles al presupuesto. Compara el coste de una ejecución completada antes de elegir.
¿Cuál es la mejor GPU para inferencia de LLM?
La mejor GPU para inferencia de LLM es la que encaja con los pesos del modelo y la caché KV, a la vez que cumple los objetivos de latencia p95/p99 y de coste por token aceptado. H100, H200 y B200 son sólidas para cargas de trabajo grandes o de contexto largo. L40S y A100 pueden ser eficientes para modelos más pequeños, inferencia por lotes y objetivos de latencia más relajados. Consulta la guía más detallada sobre la mejor GPU para inferencia de LLM para la matemática específica de inferencia.
¿Es H200 siempre mejor que H100?
No. H200 ofrece más margen de memoria y ancho de banda que H100, lo que puede ayudar en inferencia y entrenamiento con gran uso de memoria. Pero la mejor opción depende del precio, la disponibilidad, la madurez del framework, el tamaño de lote, la latencia y de si la carga de trabajo está realmente limitada por la memoria. Si H100 cumple el objetivo con un coste efectivo menor, H100 puede seguir ganando.
¿Cuándo debería elegir L40S en lugar de H100?
Elige L40S cuando el modelo quepa, los objetivos de latencia sean moderados, importe el rendimiento de medios/inferencia por dólar y la capacidad de clase H100 quedaría infrautilizada. Elige H100 cuando modelos más grandes, una latencia p99 más estricta, entrenamiento o inferencia con alta concurrencia requieran un rendimiento de acelerador de centro de datos más fuerte.
¿Debería alquilar GPUs o usar una API de modelo?
Alquila GPUs cuando necesites control del hardware, runtimes personalizados, topología privada o utilización sostenida en un modelo estable. Usa una API de modelo cuando la demanda sea incierta, los modelos cambien con frecuencia, importe el acceso a modelos de frontera o tu equipo necesite gobernanza, respaldo, registros y una sola factura más que control del hardware. Compara con GPU cloud vs model API.
¿Cómo evito comprar más GPUs de las necesarias?
Evita comprar de más comparando el trabajo exacto, midiendo las salidas aceptadas, incluyendo el tiempo de inactividad y las operaciones, y probando primero alternativas más pequeñas o gestionadas. Reserva o compra solo después de que el tráfico, la elección del modelo y la utilización estén demostrados.
En resumen
Esta guía de selección de GPU para IA no es una clasificación de aceleradores. Es una forma de hacer defendibles las decisiones sobre GPUs. Empieza por la carga de trabajo, elige una métrica alineada con el negocio, demuestra que la memoria encaja, prueba el rendimiento y la latencia de cola, incluye las operaciones y el desperdicio por fallos, y compara con rutas de modelo/API antes de firmar un compromiso.
Para muchos equipos, la respuesta correcta es híbrida: GPUs para cargas de trabajo que realmente necesitan control del hardware, y acceso a modelos/API gobernado por Flatkey para desbordamiento, modelos de frontera, respaldo, registros de uso y equipos que no deberían operar una pila de serving. La mejor elección de GPU es la que entrega trabajo aceptado al coste adecuado sin obligar a tu equipo a asumir una infraestructura que no necesita.


