
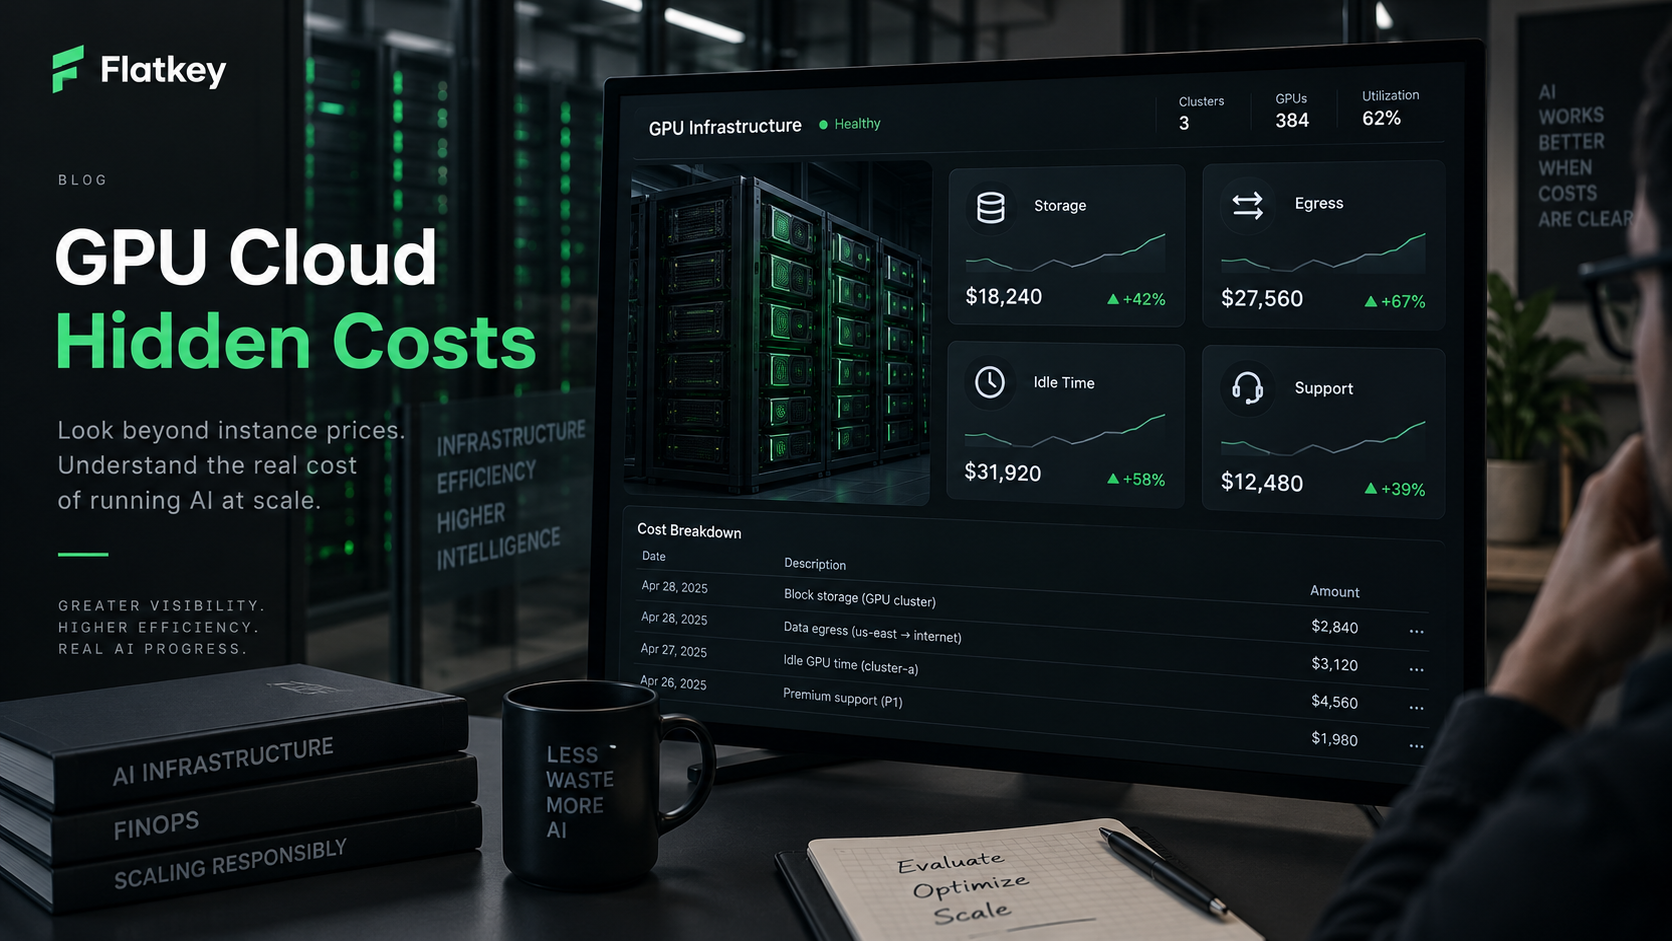
¿Cuáles son los costos ocultos de los servicios de GPU en la nube? La respuesta corta es que la tarifa horaria de la GPU es solo la línea de salida. La factura real también incluye almacenamiento, snapshots, salida de ancho de banda, notebooks o pods inactivos, arranques en frío, trabajos fallidos, planes de soporte, redes privadas, monitoreo y el trabajo de ingeniería necesario para mantener útil la capacidad de GPU.
Para los equipos empresariales de IA, los costos ocultos de GPU en la nube suelen aparecer después del primer benchmark exitoso. El equipo ve un precio horario razonable de H100, H200, A100, L40S o RTX, comienza a mover modelos y datos, y luego descubre que la factura está determinada por todo lo que rodea al acelerador. Una GPU más barata puede salir perdiendo si permanece inactiva, recarga los pesos del modelo repetidamente, mueve terabytes entre regiones o necesita un nivel de soporte que faltaba en la cotización original.
Esta guía ofrece a los equipos de ingeniería de plataformas, FinOps, compras y producto de IA una forma práctica de auditar el costo de la GPU en la nube antes de firmar un acuerdo de alquiler, capacidad reservada o clúster dedicado.
La regla útil es simple:
costo real de GPU en la nube =
  cómputo de GPU
  + almacenamiento
  + salida de datos y red
  + tiempo inactivo
  + desperdicio por reinicios y fallos
  + soporte
  + sobrecarga operativa
Si compara proveedores solo por la partida de la GPU, no está comparando el costo de un sistema de IA que funcione.
Costos ocultos de la nube de GPU: la respuesta rápida
Comience cada revisión de costos ocultos de GPU en la nube con esta tabla.
| Costo oculto | Cómo se manifiesta | Control que debe exigirse |
|---|---|---|
| Almacenamiento | Volúmenes persistentes, discos de bloque, almacenamiento de objetos, snapshots, cachés de modelos, conjuntos de datos, checkpoints | Separe los datos temporales y duraderos; etiquete los volúmenes; expire los snapshots sin uso; mantenga los pesos del modelo cerca de las GPU. |
| Salida de datos | Transferencia a Internet, movimiento entre regiones, tráfico de IP pública, datos que salen del almacenamiento de objetos, descargas de resultados | Mantenga los datos, las GPU y el almacenamiento en la misma región; presupueste la transferencia saliente; evite descargas repetidas de artefactos. |
| Tiempo inactivo | Pods, notebooks, endpoints o nodos reservados en ejecución sin trabajo útil de GPU | Detenga automáticamente los recursos inactivos; programe los trabajos mediante colas; genere alertas sobre baja utilización de GPU y experimentos de larga duración. |
| Arranques en frío | Descarga de contenedores, carga de pesos del modelo, calentamiento de kernels, montaje de volúmenes antes de que comience el trabajo útil | Preconstruya imágenes; almacene en caché los pesos; mida el tiempo de arranque como tiempo facturable. |
| Trabajos fallidos | Fallos por falta de memoria, incompatibilidad de controladores, preempciones, hosts defectuosos, implementaciones rotas | Ejecute canaries; haga checkpoints; use IDs de trabajos idempotentes; registre el costo de los fallos como una línea presupuestaria. |
| Soporte | Niveles de soporte de pago, tarifas de servicio gestionado, soporte de clúster privado, cobertura de SLA, ayuda de migración | Pregunte qué términos de soporte están incluidos en la cotización y cuáles son costos mensuales por separado. |
| Redes | Balanceadores de carga, NAT, enlaces privados, IP públicas, tráfico entre zonas, primas de InfiniBand o RoCE | Adapte la infraestructura de red a la carga de trabajo en lugar de aceptar una cotización genérica por hora de GPU. |
| Operaciones | Monitoreo, registros, trabajo del programador, parches de seguridad, incidentes del clúster, conciliación financiera | Cuente las horas de ingeniería de plataforma en el mismo modelo de TCO que la factura del proveedor. |
Para una revisión inicial de compra, haga una pregunta: ¿cuáles son los costos ocultos de los servicios de GPU en la nube después de que la GPU ya está en ejecución? La respuesta rara vez es una sola tarifa sorpresa. Por lo general, es un conjunto de componentes ordinarios de la nube que se vuelven caros porque las cargas de trabajo de IA mueven grandes artefactos y desperdician tiempo costoso del acelerador cuando la orquestación es débil.
Por qué la hora de GPU publicada está incompleta
Una hora de GPU en la nube es una unidad de capacidad. No es una ejecución de entrenamiento completada, una respuesta de inferencia aceptada, un video generado ni un lote de evaluación exitoso.
Esta distinción importa porque las cargas de trabajo de GPU suelen tener un alto costo circundante:
- Los pesos del modelo pueden tener decenas o cientos de gigabytes.
- Los conjuntos de datos de ajuste fino y los checkpoints pueden persistir mucho después de que termine el trabajo.
- Los endpoints de inferencia pueden necesitar capacidad en caliente para la latencia incluso cuando el volumen de solicitudes es irregular.
- El entrenamiento multinodo puede fallar si un trabajador, un enlace de red o un montaje de almacenamiento se comporta mal.
- La capacidad de marketplace o spot puede ser más barata, pero necesita controles de reinicio y de trabajo duplicado.
El mejor denominador es:
costo por carga de trabajo completada =
  costo total de GPU en la nube
  / ejecuciones completadas, salidas aceptadas, tokens aceptados, imágenes, clips o registros
Esta es la misma lógica detrás de la guía más amplia de Flatkey sobre GPU cloud vs model API. Si el negocio necesita resultados del modelo, compare el costo por resultado aceptado. Si el negocio realmente necesita control del hardware, compare cada opción de GPU por costo de carga de trabajo completada.
Costo oculto 1: almacenamiento, snapshots y artefactos del modelo
El almacenamiento es el primer costo oculto de los servicios de GPU en la nube porque los equipos de IA necesitan los datos cerca del cómputo. La partida puede incluir:
- Discos o volúmenes de bloques persistentes adjuntos a instancias de GPU.
- Almacenamiento de objetos para conjuntos de datos, prompts, salidas y artefactos del modelo.
- Snapshots y copias de seguridad.
- Sistemas de archivos en red o volúmenes compartidos para clústeres.
- NVMe local incluido con algunas máquinas pero perdido cuando la instancia se destruye.
- Cachés de modelo de larga duración de los que nadie se hace cargo después de un experimento.
Para un pequeño benchmark, el almacenamiento puede parecer insignificante. Para un LLM en producción, un modelo de visión o una canalización de medios, puede convertirse en un gasto mensual permanente. El error es conservar todo para siempre porque borrar la caché del modelo equivocada ralentizaría la siguiente ejecución.
Use una política de tres cubos:
| Clase de almacenamiento | Ejemplos | Regla de retención |
|---|---|---|
| Datos fuente duraderos | Corpus de entrenamiento, conjunto de evaluación aprobado, recursos aprobados por el cliente | Propiedad de la plataforma de datos; versionados y respaldados. |
| Artefactos reutilizables de ejecución | Pesos del modelo, variantes cuantizadas, capas de contenedor, archivos del tokenizador | Almacenados en caché cerca del cómputo; actualizados deliberadamente; no duplicados por experimento. |
| Salidas temporales | Checkpoints fallidos, registros de depuración, volúmenes temporales, medios intermedios | Caducan automáticamente salvo que se promocionen explícitamente. |
Las páginas del proveedor que conviene revisar incluyen los precios de AWS EC2 y EBS, los precios de persistent disk y snapshot de Google Cloud, los precios de managed disk de Azure, la documentación de almacenamiento y red de RunPod, los detalles de almacenamiento de los listados de Vast.ai y las suposiciones sobre almacenamiento de instancias de Lambda Cloud. Considérelo listas de verificación de origen, no tablas de tarifas copiadas.
Costo oculto 2: salida de datos y transferencia de red
La salida de datos es el costo oculto que con mayor probabilidad sorprende a los equipos que mueven datos entre nubes, regiones o categorías de proveedor. Los trabajos de GPU a menudo se construyen alrededor de entradas grandes y artefactos grandes:
- Conjuntos de datos de entrenamiento.
- Checkpoints de ajuste fino.
- Salidas de embeddings.
- Imágenes y videos generados.
- Trazas y registros de evaluación.
- Imágenes de contenedor y pesos del modelo.
El cargo no es solo "descarga a internet". Según el proveedor y la arquitectura, también puede pagar por transferencia entre regiones, transferencia entre zonas, NAT, balanceadores de carga, IP públicas, enlaces privados o servicios de red administrados. En clústeres multinodo, la red también es un requisito de rendimiento, no solo una línea de la factura.
Antes de aprobar el gasto, trace la ruta de los datos:
source dataset
  -> object storage
  -> GPU region
  -> scratch or shared storage
  -> inference/training output
  -> evaluation or application region
  -> customer, warehouse, or archive
Luego pregunte:
- ¿El conjunto de datos ya está en la misma región que la GPU?
- ¿El trabajo descargará repetidamente los pesos del modelo para cada worker?
- ¿Las salidas generadas salen del proveedor o solo se mueven internamente?
- ¿Un enlace privado reduce el riesgo de seguridad pero añade un costo fijo de red?
- ¿Los registros y trazas se exportan entre regiones?
Si la ruta de los datos cruza regiones o proveedores cada día, un precio horario bajo de GPU puede no ser el objetivo de optimización correcto.
Costo oculto 3: tiempo inactivo y baja utilización
El tiempo inactivo es el costo oculto más directo de la nube de GPU porque el acelerador es caro tanto si está haciendo trabajo útil como si está esperando a una persona, una cola, la descarga de una imagen, una implementación fallida o la carga de datos.
Mida dos números por separado:
billable running time =
  minutes the provider charges for the GPU resource

useful GPU-active time =
  minutes spent doing accepted training, inference, eval, or generation work
Luego calcule:
idle waste share =
  1 - useful GPU-active time / billable running time
Si un notebook se ejecuta durante 100 horas facturables y el trabajo útil de GPU ocurre durante 32 horas, el desperdicio oculto por inactividad es del 68%. Negociar una tarifa de GPU un 10% más baja no solucionará eso. Sí lo harán una política de autoapagado, el empaquetado de colas, la programación de trabajos y las etiquetas de propietario.
Controles útiles:
- Apagar automáticamente los notebooks interactivos tras inactividad.
- Eliminar pods no adjuntos, endpoints huérfanos y experimentos abandonados.
- Exigir etiquetas de propietario, proyecto, entorno y vencimiento.
- Seguimiento conjunto de utilización de GPU, utilización de memoria, espera en cola y tiempo de ejecución facturable.
- Mover los trabajos recurrentes de los notebooks a un programador.
- Alertar cuando una GPU permanezca por debajo de un umbral de utilización durante una ventana definida.
El tiempo inactivo también es la principal razón por la que una API de modelo gestionada puede superar al alquiler directo de GPU para cargas de inferencia inciertas. Si la utilización es baja o irregular, compare la hoja de cálculo de GPU con la comparación de precios de modelos de IA antes de reservar capacidad.
Costo oculto 4: interrupción, reintentos y cargas de trabajo fallidas
La capacidad de GPU spot, interrumpible y del mercado puede ser útil. También puede trasladar el costo desde la tarifa publicada hacia la lógica de reintentos.
El modelo de costo debería incluir:
- Expulsiones y preempciones.
- Descargas repetidas del modelo.
- Trabajo perdido desde el último checkpoint.
- Registros por lotes duplicados.
- Ajustes finos fallidos.
- Ejecuciones sin memoria suficiente.
- Combinaciones incorrectas de driver o CUDA.
- Retraso en la cola cuando no hay capacidad de reemplazo disponible.
Para trabajos que pueden reintentarse, use:
effective cost with failures =
  listed compute cost
  * retry amplification factor
Si 1.000 salidas aceptadas requieren 1.180 salidas intentadas después de errores, expulsiones y comprobaciones de calidad fallidas, el factor de amplificación por reintentos es 1.18x. Ese multiplicador pertenece a la misma hoja de cálculo que el precio por hora.
Para una elección más profunda entre modelos de precios, usa la guía de Flatkey sobre GPU bajo demanda vs. spot. Para este artículo, el punto clave es más acotado: los costos ocultos no son solo almacenamiento y salida de datos. El trabajo fallido también es trabajo facturable, a menos que tu proveedor lo acredite explícitamente.
Costo oculto 5: soporte, SLA y alcance del servicio gestionado
El soporte es fácil de omitir porque a menudo aparece fuera de la cotización de GPU. Los equipos empresariales de IA pueden necesitar:
- Planes de soporte de pago.
- Compromisos de tiempo de respuesta.
- Slack privado o soporte de cuenta.
- Incorporación dedicada al clúster.
- Ayuda con la migración.
- Revisión de seguridad.
- Documentación de cumplimiento.
- Soporte gestionado de Kubernetes, Slurm o servicio de inferencia.
- Créditos o remedios por interrupciones del lado del proveedor.
El soporte no es automáticamente algo malo. Puede ser más barato que perder tiempo de lanzamiento por problemas no resueltos de capacidad de GPU, controladores o redes. El error de adquisición es comparar la tarifa horaria de GPU de autoservicio de un proveedor con la tarifa gestionada o con soporte de otro como si fueran equivalentes.
Pregunta a cada proveedor:
| Pregunta | Por qué importa |
|---|---|
| ¿Qué nivel de soporte está incluido en esta cotización? | Evita comparar capacidad con soporte y sin soporte como si fueran el mismo producto. |
| ¿Cuál es el objetivo de tiempo de respuesta para incidentes de producción? | El valor del soporte depende del momento del incidente, no solo del acceso a tickets. |
| ¿Se acreditan los fallos del lado del proveedor? | Los créditos pueden reducir el desperdicio, pero solo si el contrato define los eventos cubiertos. |
| ¿Quién asume los problemas de controladores, CUDA, imágenes y kernel? | El alcance del soporte determina cuánto trabajo de la plataforma permanece interno. |
| ¿La migración o la aceptación de benchmarks están incluidas? | Una cotización horaria baja aún puede ser cara si la incorporación falla. |
Para clústeres privados y capacidad multinodo, el alcance del soporte puede ser tan importante como el modelo de GPU.
Costo oculto 6: monitoreo, registros y observabilidad
Las cargas de trabajo de GPU necesitan observabilidad más allá de una factura mensual. El costo aparece en dos lugares: en las propias herramientas de observabilidad y en el tiempo de ingeniería necesario para convertir métricas en acciones.
Monitorea:
- Utilización de GPU y utilización de memoria.
- Latencia p50, p95 y p99.
- Tiempo de espera en cola y tiempo de arranque en frío.
- Tiempo de descarga del contenedor.
- Tiempo de carga del modelo.
- Fallos por falta de memoria.
- Recuento de reintentos y costo de reintentos.
- Volumen de salida de datos.
- Crecimiento del almacenamiento por proyecto.
- Costo por salida aceptada.
Los registros y trazas también pueden convertirse en una línea de gasto si son verbosos, se conservan durante demasiado tiempo o se exportan a otra región. Mantén suficiente detalle para depurar costos y confiabilidad, pero define la retención por entorno. Las trazas de producción, los registros de evaluación y los registros de depuración no necesitan el mismo ciclo de vida.
Costo oculto 7: desajuste de reservas y bloqueo de capacidad
La capacidad reservada de GPU puede reducir el costo efectivo de cómputo cuando la demanda es real. También puede convertirse en una suscripción de capacidad inactiva.
Usa esta fórmula antes de comprometerte:
utilización de equilibrio de reserva =
  compromiso mensual reservado
  / costo mensual equivalente bajo demanda con uso completo
Luego sométela a una prueba de estrés:
- ¿Qué pasa si la demanda es 40% menor de lo previsto?
- ¿Qué pasa si el producto cambia de una familia de modelos a otra?
- ¿Puede el compromiso convertirse de H100 a H200, B200, L40S o a otra región?
- ¿Están el almacenamiento, la salida de datos, el soporte y las redes dentro del compromiso?
- ¿Pueden otras cargas de trabajo internas llenar la capacidad base inactiva?
Si la respuesta depende de la esperanza, reserva menos y mantén flexible la capacidad de ráfaga. Para implementaciones más grandes, combina esto con la hoja de cálculo de TCO de clústeres de GPU.
Hoja de trabajo de costos ocultos de GPU en la nube
Usa esta hoja de trabajo en las revisiones de adquisición. Complétala para cada proveedor, cada región y cada modo de producto.
| Campo | Qué ingresar |
|---|---|
| Proveedor y modo de producto | Instancia bajo demanda, pod, VM spot, GPU sin servidor, clúster reservado, host de marketplace, bare metal dedicado. |
| Modelo y cantidad de GPU | H100, H200, B200, A100, L40S, clase RTX, tamaño de memoria, número de GPU. |
| Región y ubicación de los datos | Dónde se originan los datos, dónde se ejecuta la GPU, hacia dónde se mueven los resultados. |
| Unidad de facturación | Segundo, minuto, hora, mes, plazo comprometido, bloque de capacidad, worker de endpoint. |
| Costo de cómputo de GPU publicado | Fuente o cotización con marca de tiempo, con la fecha verificada. |
| Estimación de utilización útil | Minutos activos de GPU esperados divididos entre minutos facturables. |
| Estimación de desperdicio por inactividad | Tiempo facturable esperado no útil. |
| Almacenamiento persistente | Volúmenes, discos, almacenamiento de objetos, sistemas de archivos compartidos, caché del modelo. |
| Instantáneas y copias de seguridad | Política de retención, responsable del costo, proceso de limpieza. |
| Salida de datos y red | Salida de datos a internet, movimiento entre regiones, enlaces privados, NAT, balanceadores de carga, IP públicas. |
| Costo de arranque en frío | Tiempo de descarga del contenedor, tiempo de carga del modelo, calentamiento del worker. |
| Amplificación por reintentos | Intentos fallidos divididos entre resultados aceptados. |
| Soporte y SLA | Soporte incluido, nivel de soporte de pago, alcance del servicio administrado, créditos. |
| Monitoreo y registros | Métricas, trazas, exportación de logs, retención. |
| Sobrecarga de ingeniería | Horas de plataforma, respuesta a incidentes, mantenimiento, conciliación financiera. |
| Denominador de la unidad | Salida aceptada, ejecución completada, token entrenado, imagen, clip, registro, GPU-mes. |
| Costo unitario final | Costo total dividido entre el trabajo útil completado. |
La hoja de cálculo debe revisarse mensualmente para cargas de trabajo en producción y antes de cada renovación de compromiso.
Lista de verificación de fuentes del proveedor
Las páginas de precios y almacenamiento de GPU cambian con frecuencia. No copie cifras antiguas en un caso de negocio. Use las páginas oficiales como lista de verificación de fuentes y registre la fecha de comprobación junto a cada cotización.
| Proveedor o fuente | Qué verificar |
|---|---|
| Precios de AWS EC2, Precios de Amazon EBS, Precios de transferencia de datos de AWS, Planes de soporte de AWS | Familia de instancias de GPU, On-Demand o Spot, EBS, instantáneas, transferencia de datos, plan de soporte. |
| Precios de GPU de Google Cloud Compute Engine, Precios de Persistent Disk, Precios de red de VPC, Cloud Customer Care | Tipo de GPU, familia de máquina, región, disco, instantánea, salida de datos, servicio de soporte. |
| Precios de Azure Virtual Machines, Precios de discos administrados de Azure, Precios de ancho de banda de Azure, Planes de soporte de Azure | SKU de VM de GPU, disco administrado, instantánea, ancho de banda, plan de soporte, términos de reserva. |
| Precios de RunPod y Documentación de almacenamiento de RunPod | Secure Cloud frente a Community Cloud, modo pod o serverless, volúmenes persistentes, volúmenes de red, comportamiento inactivo. |
| Precios de Vast.ai, Preguntas frecuentes de Vast.ai y detalles del anuncio del proveedor | Confiabilidad del host de marketplace, disco, ancho de banda, IP pública, estado interruptible, host de centro de datos o de la comunidad. |
| Precios de GPU de Lambda Cloud | Tipo de instancia, cantidad de GPU, supuestos de almacenamiento incluido, disponibilidad regional, términos de clúster reservado. |
| FinOps FOCUS | Dimensiones comunes de facturación y lenguaje de asignación de costos para equipos de finanzas y plataforma. |
| Precios de Flatkey, Modelos de Flatkey y Flatkey Compute | Alternativa de API de modelos, un solo saldo, registro de uso y verificaciones actuales de la fuente del mercado de cómputo. |
Para este artículo, la lista de verificación de fuentes se revisó el 13 de octubre de 2026. Vuelva a comprobarla antes de usar cualquier cotización de proveedor en un memorando de aprobación.
Preguntas de compras antes de aprobar el gasto en GPU en la nube
Use estas preguntas antes de aceptar una cotización o iniciar una migración.
- ¿Cuáles son los costos ocultos de los servicios de GPU en la nube en esta cotización, y cuáles quedan fuera de la cotización?
- ¿El almacenamiento, las instantáneas, el almacenamiento de objetos y las copias de seguridad están incluidos o se cobran por separado?
- ¿Qué transferencias de datos generan cargos por salida de datos o entre regiones?
- ¿Cuál es la tasa de inactividad esperada después de las brechas del programador, el tiempo de inicio y la depuración humana?
- ¿Cómo se acreditan las interrupciones de spot, las fallas del host y los incidentes del lado del proveedor?
- ¿Qué plan de soporte se requiere para los tiempos de respuesta de producción?
- ¿Quién asume los problemas de CUDA, del controlador, de la imagen, del kernel y del stack de serving?
- ¿Qué métricas demostrarán una utilización útil después del lanzamiento?
- ¿Cuál es la ruta de salida si cambia la elección del modelo?
- ¿Puede una API de modelo administrada o una ruta híbrida producir la misma salida aceptada con menos capacidad inactiva?
La última pregunta no es un atajo comercial. Es un control de TCO. Si la carga de trabajo no requiere control de hardware, el alquiler de GPU es solo una forma posible de comprar salidas del modelo.
Cuándo Flatkey entra en la comparación
Flatkey no sustituye a todos los clústeres de GPU. Los equipos siguen necesitando capacidad de GPU en la nube para entrenamiento personalizado, modelos de peso abierto autoalojados, kernels especializados, clústeres privados e infraestructura estrictamente controlada.
Flatkey entra en la comparación cuando la carga de trabajo realmente se trata de consumir resultados del modelo:
- El producto necesita muchos modelos oficiales en lugar de un único modelo autoalojado.
- La demanda es incierta, irregular o estacional.
- Finanzas quiere un solo saldo, una sola factura y un registro de uso.
- Ingeniería quiere acceso a modelos sin claves de proveedores dispersas.
- El equipo quiere comparar el costo de la API del modelo antes de alquilar o reservar GPU.
En ese camino, Flatkey ofrece a los equipos una clave API, un saldo y una factura para todas las rutas y herramientas de modelos oficiales. Si la hoja de costos ocultos muestra que el almacenamiento, la salida de datos, el tiempo inactivo y el soporte anulan la ventaja del precio por hora de la GPU, compare la ruta de API administrada antes de comprometerse con el hardware.
Comience con las guías de precios de alquiler de GPU, GPU en la nube vs API de modelo, TCO de clústeres de GPU y gestión del gasto en API de IA para una decisión más amplia.
Recomendación final
Cuando alguien pregunte cuáles son los costos ocultos de los servicios de GPU en la nube, no responda con una sola tarifa. Responda con una hoja de cálculo.
- Empiece con el precio por hora de la GPU.
- Añada almacenamiento, instantáneas, salida de datos, red, soporte, observabilidad y operaciones.
- No reste nada hasta que un crédito del proveedor quede escrito en el acuerdo.
- Divida por el trabajo completado, no por las horas facturables.
- Vuelva a ejecutar el modelo con menor utilización, mayor tasa de reintentos y un cambio en la elección del modelo.
Los servicios de GPU en la nube pueden ser la respuesta correcta cuando el equipo necesita control de hardware y puede mantener útil la capacidad. Se vuelven caros cuando el almacenamiento crece en silencio, los datos se mueven repetidamente, las GPU permanecen inactivas, falta soporte y el trabajo fallido se trata como problema de otra persona.
La tarea del comprador es hacer visibles esos costos antes de que llegue la factura.


