
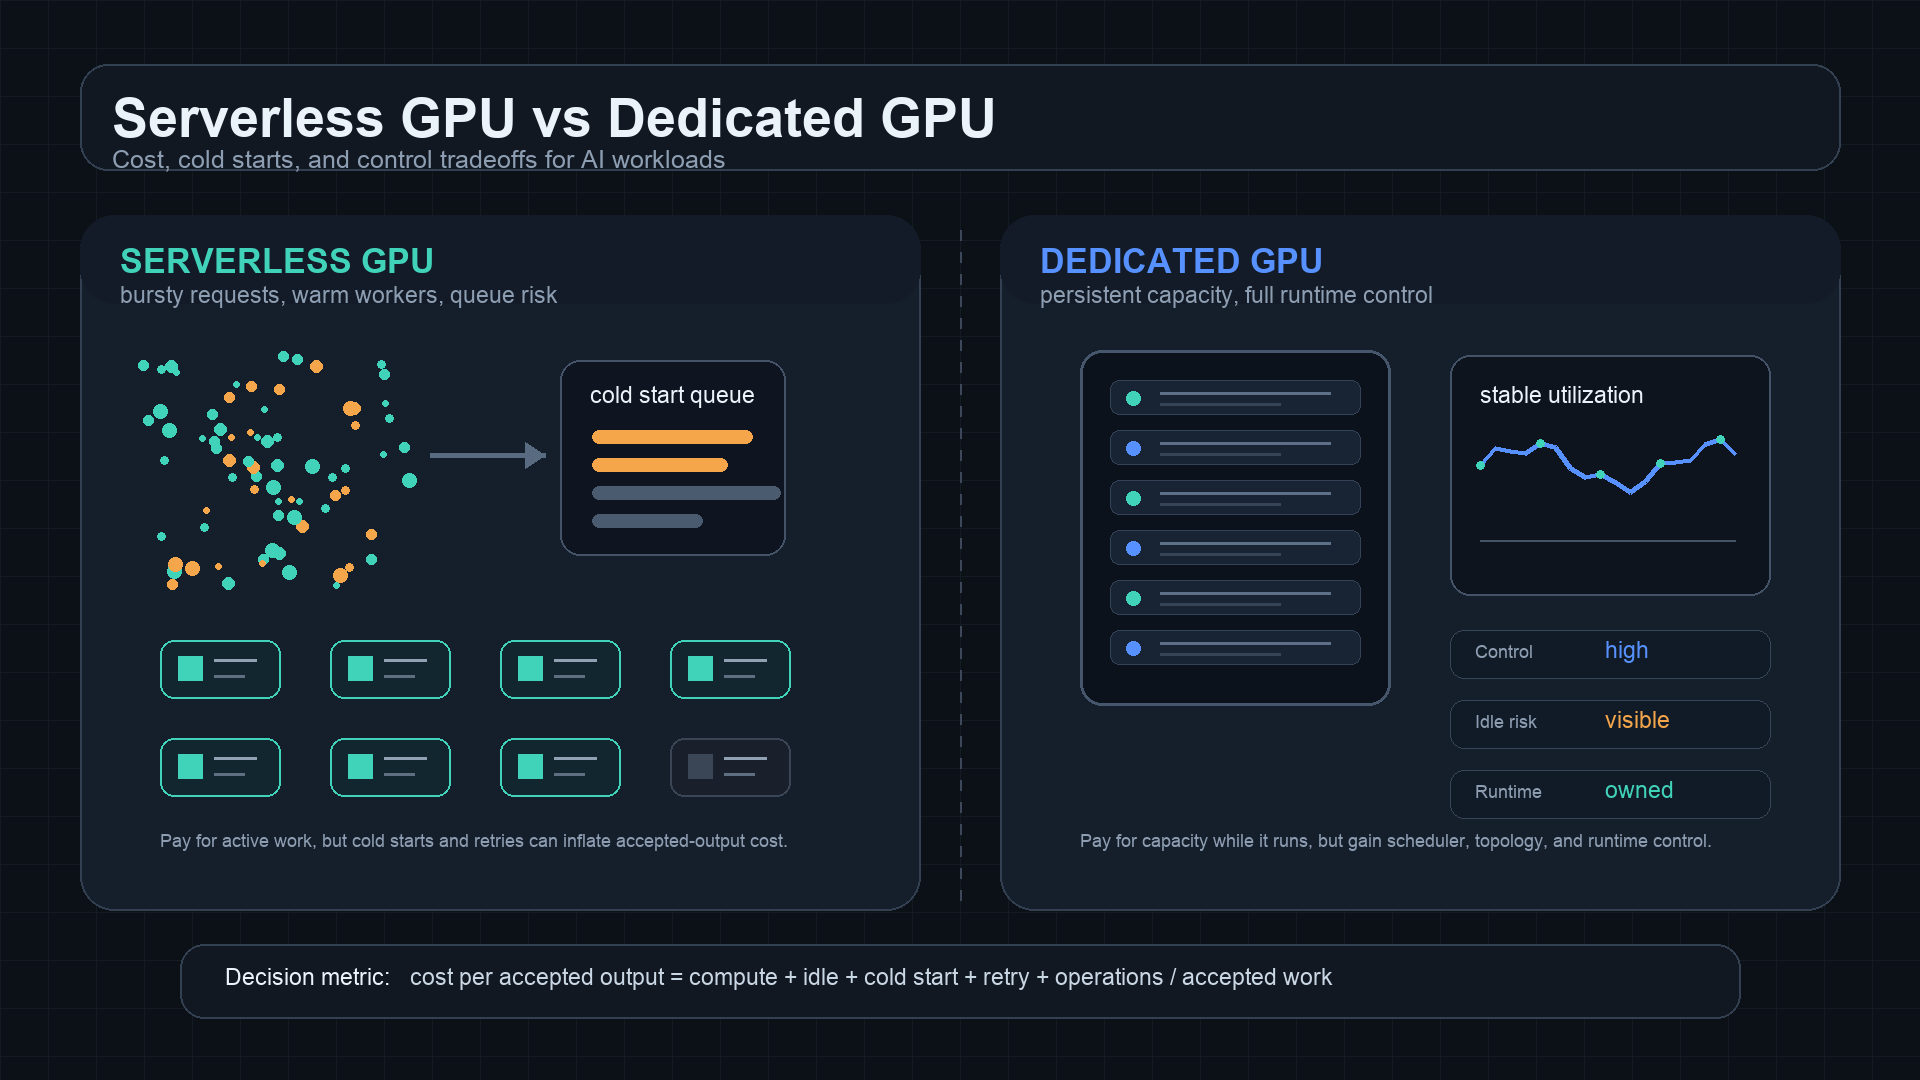
GPU sin servidor vs GPU dedicada: costo, tiempos de arranque en frío y control
Elegir entre GPU sin servidor y capacidad de GPU dedicada es, en su mayor parte, una cuestión de la forma de la carga de trabajo. Las GPU sin servidor son atractivas cuando el tráfico es intermitente, los experimentos son irregulares o el equipo quiere evitar hardware ocioso. Las GPU dedicadas son atractivas cuando la demanda es estable, la latencia de arranque importa o el equipo necesita control sobre controladores, programadores, redes, cachés de modelos y runtimes de serving.
El error es comparar el precio de una solicitud de GPU sin servidor con el precio por hora de una GPU dedicada como si describieran lo mismo. No lo hacen. Un endpoint sin servidor puede ocultar arranques en frío, retraso en cola, límites de concurrencia, costo de reintentos y sobrecoste por solicitud. Una GPU dedicada puede ocultar tiempo de inactividad, riesgo de capacidad reservada, almacenamiento, soporte y trabajo de ingeniería de plataforma.
Para desarrolladores independientes y pequeños equipos de IA, la regla práctica es:
gpu sin servidor vs gpu dedicada should be compared by cost per accepted output,
not by the lowest visible GPU rate.
Si todavía está decidiendo si el alquiler directo de GPU es necesario en absoluto, lea también las guías de Flatkey sobre nube de GPU vs API de modelo, precios de alquiler de GPU y costos ocultos de la nube de GPU. Este artículo se centra en la elección entre GPU sin servidor y GPU dedicada una vez que las GPU ya están en el conjunto de evaluación.
GPU sin servidor vs GPU dedicada: la respuesta rápida
Use esta tabla como primer filtro.
| Punto de decisión | Por lo general, encaja GPU sin servidor | Por lo general, encaja GPU dedicada |
|---|---|---|
| Patrón de tráfico | Irregular, en cola, experimental o desigual | Estable, de alto volumen, sensible a la latencia o planificado por capacidad |
| Forma de facturación | Pague principalmente cuando los workers se ejecutan o las solicitudes se procesan, según el proveedor | Pague mientras exista la instancia, pod, nodo, clúster o reserva |
| Riesgo de arranque | Arranques en frío, carga del modelo, descarga del contenedor, calentamiento del worker y retraso en cola | Menor exposición a arranques en frío después del calentamiento, pero la capacidad ociosa es facturable |
| Control operativo | Menor control sobre host, programador, runtime, topología y almacenamiento en caché | Más control sobre controladores, pila de serving, cachés, topología y observabilidad |
| Modelo de fiabilidad | Escalado administrado por el proveedor con límites de endpoint y posibles rutas en frío | Uptime, autoscaling, failover, parches y respuesta a incidentes gestionados por el equipo |
| Mejor primer uso | Demostraciones, trabajos de imagen/video, inferencia por lotes, APIs esporádicas, prototipos | Endpoints de inferencia estables, servicios de larga duración, runtimes personalizados, trabajo multinodo |
La mejor respuesta suele ser por fases:
- Empiece con GPU sin servidor para demanda desconocida.
- Mida arranques en frío, retraso en cola, tasa de reintentos y costo por salida aceptada.
- Migre solo las cargas de trabajo estables y de alto volumen a capacidad de GPU dedicada.
- Mantenga abierto un camino de API de modelo cuando el producto necesite muchos modelos o no requiera control de hardware.
Esa secuencia es más segura que reservar GPU dedicadas antes de saber si la carga de trabajo puede mantenerlas ocupadas.
Qué significa "GPU sin servidor" en la práctica
GPU sin servidor suele significar que el proveedor abstrae la propiedad de servidores de larga duración. Usted empaqueta un modelo, contenedor, función o endpoint; la plataforma inicia workers de GPU cuando llegan solicitudes; y la plataforma puede escalar workers hacia arriba o hacia abajo según la demanda.
Las implementaciones de los proveedores varían. RunPod describe Serverless en torno a endpoints y workers, con precios serverless separados de los precios de pods. Modal documenta funciones de GPU, arranques en frío y ciclo de vida de contenedores. Google Cloud Run admite servicios con GPU y tiene su propio modelo de precios de Cloud Run. Los despliegues de Replicate exponen endpoints de inferencia de producción configurables. Estos no son productos idénticos, así que la lista de verificación de la fuente importa.
Desde la perspectiva de un comprador, la capacidad de GPU sin servidor es útil cuando:
- El volumen de solicitudes es bajo, irregular o aún se está descubriendo.
- Los trabajos pueden esperar en una cola sin perjudicar la experiencia del usuario.
- Los arranques en frío son aceptables o se pueden ocultar.
- El equipo desea menos responsabilidad sobre la infraestructura.
- La carga de trabajo se empaqueta como trabajos repetibles en lugar de un servicio permanentemente en caliente.
- La empresa prefiere un gasto moldeado por el uso en lugar de una apuesta fija de capacidad mensual.
El intercambio oculto es que la GPU sin servidor no elimina la física. Los pesos del modelo aún deben cargarse. Los contenedores aún deben iniciarse. Las GPU aún necesitan capacidad disponible. El retraso en cola aún afecta a los usuarios. Los reintentos aún cuestan dinero.
Qué significa "GPU dedicada" en la práctica
La capacidad de GPU dedicada significa que usted controla una instancia, pod, servidor, nodo o clúster en ejecución durante un período de tiempo. Puede ser bajo demanda, reservada, comprometida, bare metal, capacidad de marketplace o un clúster privado. La característica común es que la GPU se asigna a su carga de trabajo en lugar de iniciarse solo alrededor de una solicitud.
La capacidad de GPU dedicada es útil cuando:
- El endpoint debe permanecer activo.
- El tráfico es lo suficientemente predecible como para mantener ocupada la GPU.
- Necesitas controladores personalizados, versiones de CUDA, kernels, servidores de modelos o redes.
- Necesitas condiciones de benchmark consistentes.
- Un arranque en frío rompería la latencia o la experiencia del usuario.
- La carga de trabajo es multinodo, sensible a la topología o sensible a la localidad de los datos.
- Quieres operar directamente vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, Kubernetes, Slurm o una infraestructura de servicio personalizada.
La contrapartida oculta es la capacidad ociosa. Si una GPU dedicada funciona durante 730 horas al mes pero solo realiza trabajo útil durante 180 horas, el precio horario publicado no es el verdadero precio por hora útil. Las horas ociosas forman parte del costo de la carga de trabajo.
La fórmula de costo que hace justa la comparación
Usa un mismo denominador para ambos lados:
costo por salida aceptada =
  cómputo
  + almacenamiento
  + ancho de banda
  + tiempo ocioso
  + desperdicio por arranque en frío
  + desperdicio por reintentos y trabajos fallidos
  + soporte
  + sobrecarga de ingeniería
  / salidas aceptadas, registros, tokens, imágenes, clips o trabajos
Para GPU sin servidor:
costo por salida aceptada de GPU sin servidor =
  costo facturado del trabajador/solicitud
  + desperdicio por arranque en frío y cola
  + costo de solicitudes fallidas y reintentos
  + almacenamiento y transferencia de artefactos
  + sobrecarga de integración de plataforma
  / salidas aceptadas
Para GPU dedicada:
costo por salida aceptada de GPU dedicada =
  costo de capacidad de GPU en ejecución
  + almacenamiento y redes
  + capacidad ociosa
  + operaciones de la pila de servicio
  + trabajo de soporte e incidentes
  + desperdicio por fallos y redeploy
  / salidas aceptadas
Aquí es donde a menudo se invierte la comparación entre GPU sin servidor y GPU dedicada. La opción sin servidor puede parecer cara por segundo, pero más barata en total si evita GPUs ociosas. La dedicada puede parecer cara por mes, pero más barata en total si la carga de trabajo mantiene ocupado el acelerador y evita el desperdicio por arranque en frío.
Los arranques en frío son el impuesto de la GPU sin servidor
Los arranques en frío son el riesgo más importante de la GPU sin servidor. Un arranque en frío puede incluir:
- Encontrar capacidad de GPU.
- Descargar o montar una imagen de contenedor.
- Importar dependencias.
- Cargar los pesos del modelo.
- Trasladar el modelo a la memoria de la GPU.
- Calentar kernels o rutas de compilación.
- Reconstruir cachés.
- Esperar detrás de solicitudes anteriores en cola.
La documentación de arranque en frío de Modal es útil porque separa el trabajo de inicio del contenedor, las importaciones y la inicialización de la aplicación. Los mecanismos exactos difieren según el proveedor, pero la lección es general: el tiempo de arranque forma parte de la experiencia del usuario y del modelo de costo.
Los arranques en frío importan más cuando:
| Carga de trabajo | Por qué perjudican los arranques en frío |
|---|---|
| Chat interactivo o agentes | Los usuarios notan una latencia lenta en el primer token. |
| Edición de imágenes en tiempo real | La primera solicitud puede parecer rota aunque las siguientes sean rápidas. |
| Webhooks o APIs orientadas al usuario | Los timeouts aguas arriba pueden convertir los arranques en frío en trabajos fallidos. |
| Colas por lotes con SLA estricto | El retraso de la cola puede incumplir las ventanas de entrega. |
| Modelos grandes | La carga de pesos puede dominar la ruta de la solicitud. |
La GPU sin servidor puede seguir siendo la opción correcta si la aplicación puede absorber ese retraso. Por ejemplo, los trabajos de imagen sin conexión, las colas de evaluación nocturna, la inferencia por lotes asíncrona y los experimentos internos suelen tolerar mejor el calentamiento que un chat orientado al cliente.
Las GPUs dedicadas cambian arranques en frío por riesgo de ociosidad
Las GPUs dedicadas suelen reducir la exposición a arranques en frío porque el servicio puede permanecer activo. Los pesos del modelo permanecen cargados, las cachés siguen calientes y el enrutamiento de solicitudes puede llegar a un endpoint conocido.
Pero la capacidad dedicada crea otro impuesto:
proporción de desperdicio ocioso =
  1 - tiempo útil activo de GPU / tiempo de ejecución facturable
Si la proporción útil de tiempo activo de GPU es del 30%, una tarifa horaria publicada más baja puede seguir resultando costosa. La GPU dedicada puede estar técnicamente lista, pero financieramente ociosa.
Las GPUs dedicadas funcionan mejor cuando puedes demostrar:
- Volumen base de solicitudes.
- Alta utilización de GPU después de batching y encolado.
- Selección estable del modelo.
- Requisitos de memoria predecibles.
- Una pila de servicio que el equipo pueda operar.
- Un plan para despliegues graduales, monitorización, alertas y fallback.
Si esos datos son desconocidos, la GPU sin servidor o una API de modelo suele ser el primer paso más limpio.
Control: lo que devuelven las GPUs dedicadas
El argumento más sólido a favor de la capacidad dedicada de GPU no siempre es el precio. Es el control.
La capacidad dedicada da al equipo más margen para decidir sobre:
- Modelo de GPU, memoria y cantidad.
- Región y localidad de los datos.
- Versiones de CUDA, controlador, kernel e imagen.
- Configuraciones de ejecución para vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve o personalizadas.
- Batching continuo, comportamiento de la caché KV, cuantización, decodificación especulativa y ajuste del programador.
- Cachés de modelos locales y pesos precargados.
- Topología de red, enlaces privados, diseño de VPC, balanceadores de carga e ingress.
- Observabilidad, trazas, registros y respuesta a incidentes.
Ese control es valioso cuando la carga de trabajo es lo bastante importante como para justificar la propiedad. Es caro cuando el equipo solo necesita salidas de modelo confiables.
Este es el mismo límite abordado en los artículos de Flatkey mejor GPU para inferencia de LLM, guía de implementación de vLLM y vLLM vs SGLang. Si estás ajustando el propio runtime, la capacidad de GPU dedicada puede ser la capa adecuada. Si estás lanzando funciones de producto a través de muchos modelos, una ruta de API gestionada puede ser más rápida.
Matriz de decisión de cargas de trabajo
Usa esta matriz antes de crear una hoja de cálculo.
| Carga de trabajo | Mejor punto de partida | Por qué |
|---|---|---|
| Nueva función de producto de IA con demanda desconocida | GPU sin servidor o API de modelo | Evita comprar capacidad ociosa antes de conocer el tráfico. |
| Cola asíncrona de generación de imágenes | GPU sin servidor | El retraso de la cola puede ser aceptable, y los picos no requieren GPUs siempre activas. |
| Demostración o prototipo breve | GPU sin servidor | La configuración rápida y la facturación basada en el uso suelen importar más que el control del runtime. |
| Inferencia LLM estable de alto volumen | GPU dedicada | Una utilización sostenida puede amortizar la pila de servicio. |
| Endpoint de cliente sensible a la latencia | GPU dedicada o API de modelo | Los arranques en frío y el retraso de la cola son más difíciles de ocultar. |
| Modelo grande con carga lenta de pesos | GPU dedicada | Mantener los pesos en caliente puede ser mejor que el arranque repetido sin servidor. |
| Conjunto de evaluación periódica | GPU sin servidor, GPU spot o API de modelo por lotes | Los trabajos son reintentables y pueden ejecutarse detrás de una cola. |
| Kernels CUDA personalizados o investigación de runtime | GPU dedicada | El equipo necesita control de bajo nivel. |
| Entrenamiento multinodo o inferencia distribuida | Clúster dedicado | La topología, la red y los dominios de fallo dominan. |
| Producto que necesita muchos modelos de frontera | API de modelo o gateway | La propiedad directa de la GPU no resuelve el acceso a modelos de múltiples proveedores. |
Para una planificación de capacidad más amplia, combina esto con las guías de Flatkey sobre GPU bajo demanda vs GPU spot, TCO de clúster GPU y alquiler de clúster GPU.
Trampas de costo de la GPU sin servidor
La economía de la GPU sin servidor puede decepcionar cuando los equipos ignoran estos factores.
| Trampa | Qué sucede | Control |
|---|---|---|
| Carga lenta del modelo | Cada trabajador en frío dedica tiempo facturable antes de que comience el trabajo útil | Preempaqueta los artefactos, reduce las imágenes, almacena en caché los pesos, mide el warmup por separado |
| Desajuste de timeouts | Los arranques en frío provocan timeouts aguas arriba y reintentos | Configura timeouts realistas, colas asíncronas, IDs de trabajo idempotentes |
| Opacidad de la cola | Los usuarios ven retraso, pero los paneles solo muestran solicitudes completadas | Haz seguimiento del tiempo de espera en cola, tiempo de arranque en frío, tiempo activo del trabajador y latencia de salida aceptada |
| Trabajos pequeños en GPUs grandes | La sobrecarga por solicitud domina la computación útil | Agrupa trabajos o usa un modelo más pequeño/ruta de API |
| Límites de concurrencia por picos | Las solicitudes se acumulan durante las ventanas de lanzamiento | Prueba la concurrencia del endpoint bajo carga antes del lanzamiento |
| Amplificación de reintentos | Los trabajos fallidos multiplican los intentos facturados | Haz seguimiento de las salidas aceptadas, no de las salidas intentadas |
| Transferencia de datos | Entradas, pesos y salidas se mueven repetidamente | Mantén los artefactos cerca de los workers y caduca los archivos temporales |
La pregunta de adquisición no es "¿el proveedor admite GPU sin servidor?" Es "¿qué le ocurre al costo por salida aceptada cuando los workers están en frío, las colas están llenas y se producen reintentos?"
Trampas de costo de la GPU dedicada
La economía de la GPU dedicada puede decepcionar en la dirección opuesta.
| Trampa | Qué sucede | Control |
|---|---|---|
| Endpoint inactivo | La GPU se mantiene caliente para solicitudes poco frecuentes | Autoescalado, consolidar cargas de trabajo o usar GPU sin servidor/API de modelo para bajo volumen |
| Memoria sobredimensionada | Una GPU grande ejecuta una carga de trabajo que cabe en hardware más pequeño | Evalúa la memoria y el rendimiento del modelo antes de comprometerte |
| Desajuste de reserva | El contrato asume una demanda que nunca aparece | Reserva contra la línea base medida, no contra las previsiones de lanzamiento |
| Propiedad de la pila de servicio | Los ingenieros mantienen el runtime en lugar de las funciones del producto | Cuenta el trabajo de plataforma en el TCO |
| Líneas ocultas de la nube | Almacenamiento, egreso, soporte y red quedan fuera de la tarifa de GPU | Usa una hoja completa de costos ocultos de GPU en la nube |
| Rotación de modelos | Una nueva familia de modelos cambia las necesidades de memoria, precisión o runtime | Mantén abiertas las vías de salida |
| Carga de incidentes | La disponibilidad se convierte en el problema de tu equipo | Define alertas, fallback y alcance del soporte del proveedor |
El control de la GPU dedicada solo es valioso cuando el equipo puede aprovecharlo. Si la carga de trabajo no es lo suficientemente estable como para ajustarla, el control adicional puede convertirse en una carga operativa.
Ejemplo práctico: por qué la respuesta cambia con la utilización
Supongamos que un equipo ejecuta una función asíncrona de generación de medios. Las tarifas exactas son hipotéticas; sustitúyelas por precios de proveedor verificados antes de comprar.
| Campo | GPU sin servidor | GPU dedicada |
|---|---|---|
| Tareas aceptadas por mes | 120,000 | 120,000 |
| Cómputo listado | Adaptado al uso | Capacidad mensual fija |
| Tiempos de arranque en frío y desperdicio en cola | Mayor | Menor |
| Capacidad inactiva | Menor | Mayor |
| Control de tiempo de ejecución | Menor | Mayor |
| Mejor riesgo | La demanda es desconocida | La demanda es constante |
Si la mayoría de las tareas llegan en ráfagas cortas y el resto del día hay poco movimiento, la GPU sin servidor puede ganar porque evita la capacidad dedicada inactiva. Si las tareas llegan de forma constante durante todo el día y el modelo tiene una ruta de calentamiento lenta, la GPU dedicada puede ganar porque los workers se mantienen activos y el rendimiento es más fácil de ajustar.
Ahora cambia la carga de trabajo a una inferencia de LLM orientada al cliente con latencia estricta. La decisión puede invertirse incluso si la GPU sin servidor parece más barata con tráfico ligero, porque las rutas de arranque en frío y el retraso en cola crean riesgo para el producto. En ese caso, una GPU dedicada o una API de modelo administrada con controles de latencia establecidos puede ser más segura.
La idea no es que un modelo siempre gane. La idea es que la GPU sin servidor vs GPU dedicada debe decidirse según la forma medida de la carga de trabajo.
Plan de benchmark antes de elegir
Ejecuta la misma carga de trabajo a través de ambas rutas durante una ventana de prueba representativa. Registra estas métricas.
| Métrica | Ruta de GPU sin servidor | Ruta de GPU dedicada |
|---|---|---|
| Resultados aceptados | Cuenta los resultados correctos después de los filtros de calidad | El mismo denominador |
| Resultados intentados | Incluye trabajos fallidos y reintentados | Incluye trabajos fallidos y reintentados |
| Latencia p50 / p95 / p99 | Incluye el tiempo de cola y de arranque en frío | Incluye el tiempo de enrutamiento y de batching |
| Tiempo hasta el primer trabajo útil | Inicio del worker, carga del modelo, calentamiento | Inicio del despliegue, carga del modelo, puesta en producción |
| Proporción de arranque en frío | Porcentaje de solicitudes que llegan a workers en frío | Normalmente menor después del calentamiento |
| Tiempo de espera en cola | Retraso en la cola del endpoint y presión de concurrencia | Cola del programador y espera del batch |
| Utilización de GPU | Tiempo activo del worker si está expuesto | Utilización de cómputo y memoria de la GPU |
| Costo de inactividad | Normalmente menor, pero revisa los mínimos | Principal riesgo de costo |
| Tasa de reintentos | Timeout, errores del worker, errores de capacidad | OOM, despliegue, tiempo de ejecución, errores del host |
| Horas de ingeniería | Integración y depuración del endpoint | Operaciones de la plataforma y trabajo de incidentes |
La prueba debe incluir condiciones frías, condiciones cálidas, tráfico en ráfagas, tráfico normal y recuperación ante fallos. Un benchmark que solo mide el rendimiento en caliente no es una decisión entre GPU sin servidor vs GPU dedicada; es una prueba parcial de velocidad.
Lista de verificación de fuentes del proveedor
Usa las páginas oficiales como listas de verificación de fuentes, no como listas de tarifas congeladas. Revísalas de nuevo el día en que apruebes el gasto.
| Proveedor/categoría | Fuente oficial a consultar | Qué capturar |
|---|---|---|
| RunPod Serverless | Descripción general de RunPod Serverless, Precios de RunPod Serverless | Modelo de endpoint, comportamiento del worker, base de facturación, comportamiento de arranque en frío, almacenamiento, red, concurrencia, registros, límites |
| RunPod Pods / estilo dedicado | Descripción general de RunPod Pods, Precios de RunPod Pods, Precios de RunPod | Modelo de GPU, modo seguro/comunidad, facturación del pod, almacenamiento, volumen de red, expectativas de tiempo de actividad |
| Modal | Documentación de GPU de Modal, Arranques en frío de Modal, Precios de Modal | Tipo de GPU, ciclo de vida de la función, controles de arranque en frío, estrategia de imagen de contenedor, facturación por uso activo |
| Google Cloud Run con GPUs | Configuración de GPU en Cloud Run, Precios de Cloud Run | Restricciones del servicio de GPU, instancias mínimas, concurrencia, facturación de CPU/memoria/GPU, impacto en la latencia de solicitudes |
| Google Compute Engine GPUs | Precios de GPU de Compute Engine | Tipo de GPU, región, costo de VM, disco, red, reservas, descuentos por uso comprometido |
| Instancias GPU de AWS EC2 | Precios de Amazon EC2 | On-Demand, Spot, Savings Plans, Reserved Instances, bloques de capacidad, almacenamiento, transferencia de datos, soporte |
| Lambda Cloud | Lambda GPU Cloud | Tipo de instancia, disponibilidad, términos on-demand/reservados, almacenamiento, red, alcance del soporte |
| Implementaciones de Replicate | Documentación de deployments de Replicate | Configuración del deployment, comportamiento de escalado, opciones de hardware, instancias mínimas/máximas, ajuste para endpoint de producción |
Para este artículo, la lista de verificación de fuentes se revisó el 13 de octubre de 2026.
Preguntas de compras antes de comprometerte
Haz estas preguntas antes de elegir GPU sin servidor vs GPU dedicada.
| Pregunta | Por qué importa |
|---|---|
| ¿Cuál es el denominador de resultados aceptados? | Evita comparar intentos de solicitud con resultados comerciales exitosos. |
| ¿Con qué frecuencia estará en frío el endpoint? | Los arranques en frío pueden dominar la latencia y el costo en cargas de trabajo esporádicas. |
| ¿Cuánto tarda la carga del modelo? | Los pesos grandes pueden borrar los ahorros del modo sin servidor. |
| ¿Qué ocurre ante una concurrencia en ráfaga? | Tanto las colas sin servidor como los autoescaladores dedicados necesitan pruebas de estrés. |
| ¿Cuál es la tasa de inactividad de la GPU dedicada? | La capacidad ociosa es la principal fuga de costo fijo. |
| ¿Pueden los trabajos reintentarse de forma segura? | Los flujos de trabajo sin servidor y tipo spot necesitan idempotencia. |
| ¿Necesitamos control personalizado del runtime? | Si no, la propiedad de una GPU dedicada puede ser innecesaria. |
| ¿Están incluidos el almacenamiento, la salida de datos, los registros y el soporte? | El cómputo de GPU es solo una parte de la factura. |
| ¿Puede la carga de trabajo migrar a una API de modelo? | Los productos de baja utilización o multmodelo pueden no justificar las operaciones de GPU. |
| ¿Cuál es la vía de salida si cambia el modelo? | Los compromisos de hardware se vuelven arriesgados cuando cambia la arquitectura del modelo. |
El mejor paquete de adquisición incluye un resultado de benchmark, una hoja de cálculo de costo por resultado aceptado y una razón clara de por qué el equipo necesita capacidad de GPU sin servidor ajustada al uso o capacidad de GPU dedicada controlada.
Cuando una API de modelo supera a ambas
Tanto la GPU sin servidor como la GPU dedicada asumen que operar a nivel de GPU es útil. A veces no lo es.
Una API o pasarela de modelo gestionada puede ser mejor cuando:
- La demanda es desconocida o tiene picos.
- El producto necesita varios modelos, no un solo modelo estable autohospedado.
- El equipo necesita modelos de frontera o propietarios.
- La confiabilidad, el respaldo y la diversidad de proveedores importan más que el control del host.
- Finanzas necesita registros de uso, presupuestos y una sola factura.
- El tiempo de ingeniería se aprovecha mejor en el comportamiento del producto que en las operaciones de GPU.
Flatkey encaja en este lado de la decisión. Ofrece a los equipos una ruta compatible con OpenAI, una clave, un saldo, una factura, visibilidad de uso y acceso a endpoints oficiales de modelos de distintos proveedores. Si la hoja de cálculo de GPU sin servidor vs GPU dedicada muestra baja utilización, alto desperdicio por arranques en frío o demasiada sobrecarga operativa, compara esa vía con comparación de precios de modelos de IA, comparación de precios de API de IA y gestión del gasto en API de IA antes de comprometerte con infraestructura de GPU.
Recomendación final
Usa esta secuencia para las decisiones entre GPU sin servidor y GPU dedicada:
- Usa GPU sin servidor para prototipos, trabajos con picos, colas asíncronas y demanda desconocida.
- Mide los arranques en frío, el retraso de cola, la tasa de reintentos y el costo por resultado aceptado.
- Mueve las cargas de trabajo estables, de gran volumen y sensibles a la latencia a capacidad de GPU dedicada solo después de demostrar la utilización.
- Mantén abierta una ruta de API de modelo cuando la elección del modelo cambie con frecuencia, no se requiera control del hardware o el equipo necesite una facturación y una vía de respaldo más limpias.
GPU sin servidor vs GPU dedicada no es una decisión universal de ganador se lo lleva todo. La GPU sin servidor compra flexibilidad y menor riesgo de inactividad. La GPU dedicada compra control y capacidad más caliente. La respuesta correcta es la que le da a tu equipo el costo más bajo por resultado aceptado mientras pone la latencia, la confiabilidad y el riesgo operativo en un lugar que realmente puedas gestionar.
Preguntas frecuentes
¿La GPU sin servidor es más barata que la GPU dedicada?
La GPU sin servidor es más barata cuando el tráfico es bajo, intermitente o lo bastante incierto como para que las GPU dedicadas queden ociosas. La GPU dedicada es más barata cuando la utilización es alta, el modelo permanece en caliente y el equipo puede operar la pila de serving de forma eficiente.
¿La GPU sin servidor siempre tiene arranques en frío?
No todas las solicitudes estarán en frío, y los proveedores ofrecen distintos controles para capacidad en caliente, trabajadores mínimos, optimización de imágenes y escalado. Pero los arranques en frío son un riesgo central en la evaluación de GPU sin servidor porque los modelos grandes y los contenedores pueden tardar un tiempo significativo en volverse útiles.
¿Cuándo debo pasar de GPU sin servidor a GPU dedicada?
Cambia cuando puedas demostrar demanda estable, alta utilización, latencia inaceptable por arranques en frío, necesidad de control personalizado del runtime o una ventaja de costo por resultado aceptado después de contar las operaciones y el tiempo de inactividad.
¿Es mejor la GPU dedicada para la inferencia de LLM?
La GPU dedicada puede ser mejor para inferencia de LLM estable y de gran volumen, especialmente cuando ajustas vLLM, SGLang, TensorRT-LLM, batching, el comportamiento de la caché y la carga del modelo. Para productos de bajo volumen, multmodelo o de cambio rápido, una API de modelo puede ser más simple y más barata.
¿Qué debo medir primero?
Mide los resultados aceptados, la proporción de arranques en frío, el tiempo de espera en cola, la latencia p95/p99, la tasa de reintentos, la utilización útil de GPU, el costo de inactividad, el almacenamiento/salida de datos y las horas de ingeniería. Esas métricas hacen que la decisión entre GPU sin servidor y GPU dedicada sea defendible.


