
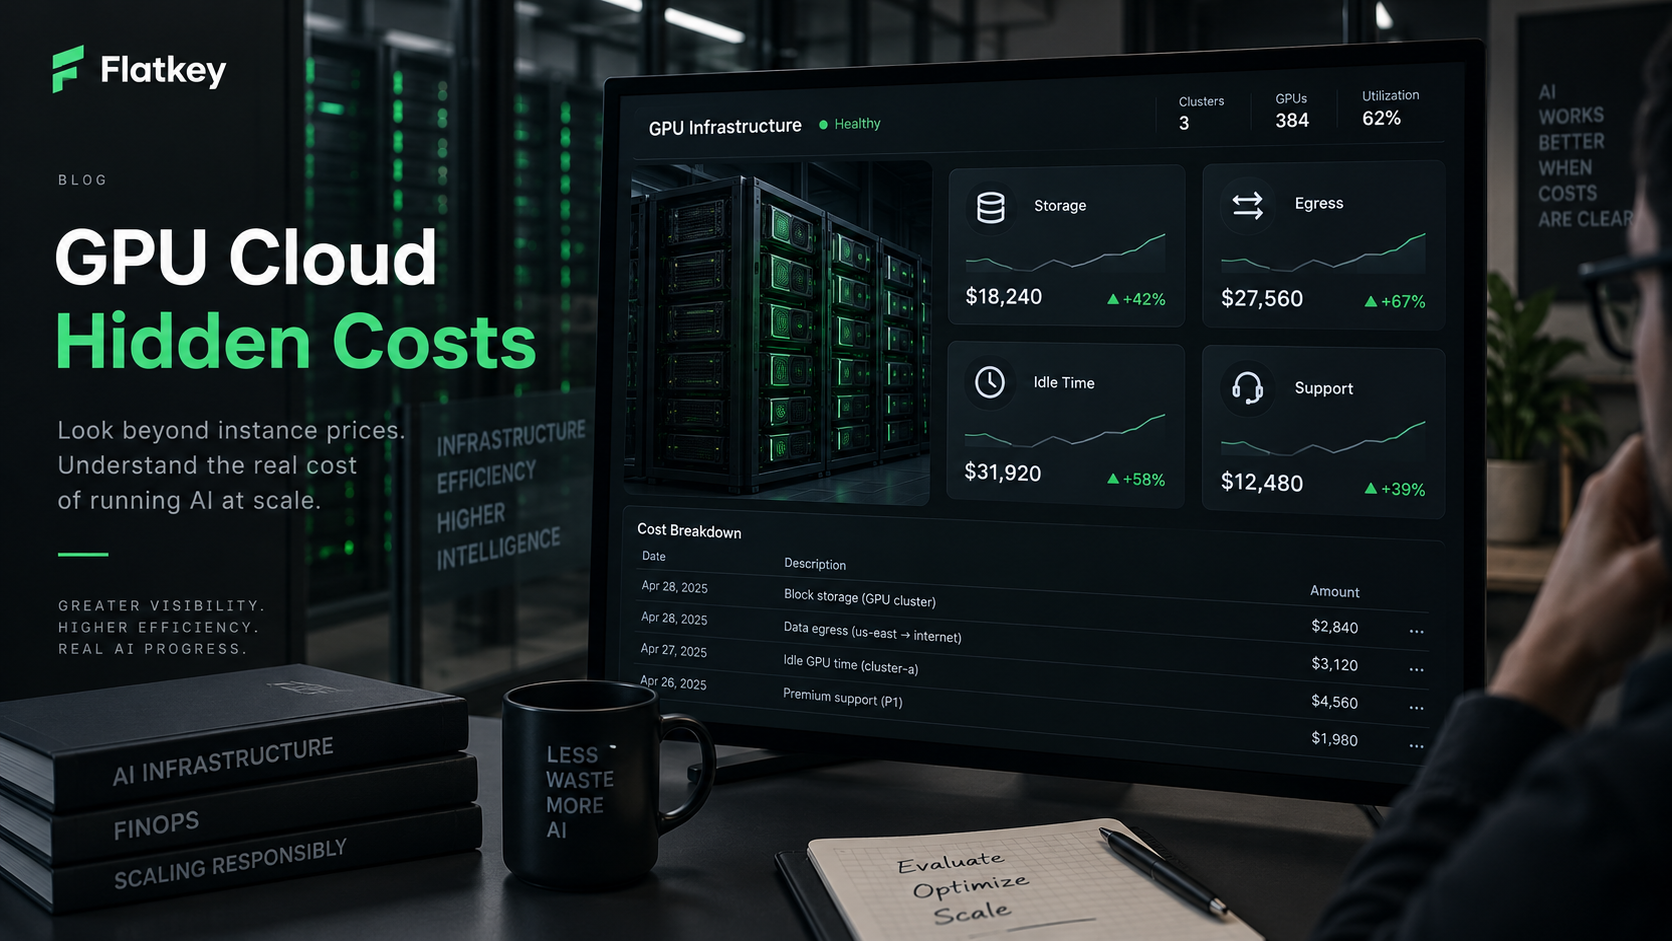
Quels sont les coûts cachés des services GPU cloud ? La réponse courte est que le tarif horaire du GPU n’est qu’un point de départ. La facture réelle inclut aussi le stockage, les snapshots, l’egress de bande passante, les notebooks ou pods inactifs, les démarrages à froid, les jobs échoués, les plans de support, le réseau privé, la surveillance et le travail d’ingénierie nécessaire pour conserver une capacité GPU réellement utile.
Pour les équipes IA d’entreprise, les coûts cachés du GPU cloud apparaissent généralement après le premier benchmark réussi. L’équipe voit un prix horaire raisonnable pour H100, H200, A100, L40S ou RTX, commence à déplacer les modèles et les données, puis découvre que la facture est façonnée par tout ce qui entoure l’accélérateur. Un GPU moins cher peut perdre s’il reste inactif, recharge sans cesse les poids du modèle, déplace des téraoctets entre régions ou nécessite un niveau de support qui manquait au devis initial.
Ce guide offre aux équipes d’ingénierie de plateforme, FinOps, achats et produits IA une manière pratique d’auditer le coût des GPU cloud avant de signer un contrat de location, de capacité réservée ou de cluster dédié.
La règle utile est simple :
coût réel du GPU cloud =
  calcul GPU
  + stockage
  + egress et réseau
  + temps d’inactivité
  + pertes liées aux redémarrages et aux échecs
  + support
  + frais généraux d’exploitation
Si vous comparez les fournisseurs uniquement sur la ligne GPU, vous ne comparez pas le coût d’un système IA fonctionnel.
Coûts cachés du GPU cloud : la réponse rapide
Commencez chaque analyse des coûts cachés du GPU cloud avec ce tableau.
| Coût caché | Comment il se manifeste | Contrôle à exiger |
|---|---|---|
| Stockage | Volumes persistants, disques blocs, stockage objet, snapshots, caches de modèles, jeux de données, checkpoints | Séparer les données temporaires et durables ; étiqueter les volumes ; expirer les snapshots inutilisés ; garder les poids du modèle près des GPU. |
| Egress | Transfert Internet, mouvements interrégionaux, trafic d’IP publiques, données quittant le stockage objet, téléchargements de résultats | Garder les données, les GPU et le stockage dans la même région ; budgéter le transfert sortant ; éviter les téléchargements répétés d’artefacts. |
| Temps d’inactivité | Pods, notebooks, endpoints ou nœuds réservés en cours d’exécution sans travail GPU utile | Arrêt automatique des ressources inactives ; planifier les jobs via des files d’attente ; alerter sur une faible utilisation du GPU et les expériences de longue durée. |
| Démarrages à froid | Récupération des conteneurs, chargement des poids du modèle, réchauffement des kernels, montage des volumes avant le début du travail utile | Préconstruire les images ; mettre en cache les poids ; mesurer le temps de démarrage comme temps facturable. |
| Jobs échoués | Échecs de manque de mémoire, incompatibilités de pilotes, préemptions, hôtes défectueux, déploiements cassés | Exécuter des canaris ; faire des checkpoints ; utiliser des ID de job idempotents ; suivre le coût des échecs comme une ligne budgétaire. |
| Support | Niveaux de support payants, frais de service managé, support de cluster privé, couverture SLA, aide à la migration | Demander quels termes de support sont inclus dans le devis et lesquels constituent des coûts mensuels séparés. |
| Réseau | Load balancers, NAT, liaisons privées, IP publiques, trafic inter-zone, primes InfiniBand ou RoCE | Adapter le fabric réseau à la charge de travail plutôt que d’accepter un devis générique à l’heure GPU. |
| Exploitation | Surveillance, journaux, travail du planificateur, correctifs de sécurité, incidents de cluster, réconciliation financière | Compter les heures d’ingénierie de plateforme dans le même modèle TCO que la facture du fournisseur. |
Pour une revue initiale côté acheteur, posez une question : quels sont les coûts cachés des services GPU cloud une fois que le GPU est déjà en cours d’exécution ? La réponse est rarement un frais surprise unique. Il s’agit généralement d’un ensemble de composants cloud ordinaires qui deviennent coûteux parce que les charges de travail IA déplacent de gros artefacts et gaspillent du temps précieux d’accélérateur lorsque l’orchestration est faible.
Pourquoi l’heure GPU affichée est incomplète
Une heure GPU cloud est une unité de capacité. Ce n’est pas un entraînement terminé, une réponse d’inférence acceptée, une vidéo générée ou un lot d’évaluation réussi.
Cette distinction compte parce que les charges de travail GPU ont souvent un coût périphérique élevé :
- Les poids du modèle peuvent représenter des dizaines ou des centaines de gigaoctets.
- Les jeux de données de fine-tuning et les checkpoints peuvent persister longtemps après la fin du job.
- Les endpoints d’inférence peuvent avoir besoin d’une capacité chaude pour la latence, même lorsque le volume de requêtes est irrégulier.
- L’entraînement multi-nœuds peut échouer si un worker, une liaison réseau ou un montage de stockage se comporte mal.
- La capacité marketplace ou spot peut être moins chère, mais nécessite des contrôles de redémarrage et de duplication du travail.
Le meilleur dénominateur est :
coût par charge de travail terminée =
  coût total du GPU cloud
  / exécutions terminées, sorties acceptées, tokens acceptés, images, clips ou enregistrements
C’est la même logique que celle du guide plus large de Flatkey sur GPU cloud vs model API. Si l’entreprise a besoin de sorties de modèle, comparez le coût par sortie acceptée. Si l’entreprise a vraiment besoin du contrôle matériel, comparez chaque option GPU selon le coût par charge de travail terminée.
Coût caché 1 : stockage, snapshots et artefacts de modèle
Le stockage est le premier coût caché des services GPU cloud parce que les équipes IA ont besoin des données à proximité du calcul. La ligne de coût peut inclure :
- Des disques blocs ou volumes persistants attachés aux instances GPU.
- Du stockage objet pour les datasets, prompts, sorties et artefacts de modèle.
- Des snapshots et des sauvegardes.
- Des systèmes de fichiers réseau ou des volumes partagés pour les clusters.
- Du NVMe local inclus avec certaines machines, mais perdu lorsque l’instance est détruite.
- Des caches de modèles de longue durée dont personne n’est propriétaire après une expérience.
Pour un petit benchmark, le stockage peut sembler négligeable. Pour un LLM de production, un modèle de vision ou un pipeline multimédia, il peut devenir une dépense mensuelle durable. L’erreur consiste à tout conserver indéfiniment parce que supprimer le mauvais cache de modèle ralentirait l’exécution suivante.
Utilisez une politique à trois compartiments :
| Classe de stockage | Exemples | Règle de rétention |
|---|---|---|
| Données source durables | Corpus d’entraînement, ensemble d’évaluation approuvé, assets approuvés par le client | Géré par la plateforme de données ; versionné et sauvegardé. |
| Artefacts d’exécution réutilisables | Poids du modèle, variantes quantifiées, couches de conteneur, fichiers du tokenizer | Mis en cache près du calcul ; actualisé délibérément ; non dupliqué par expérience. |
| Sorties temporaires | Checkpoints en échec, journaux de débogage, volumes scratch, médias intermédiaires | Expiration automatique sauf promotion explicite. |
Les pages des fournisseurs à vérifier incluent les tarifs AWS EC2 et EBS, les tarifs Google Cloud persistent disk et snapshot, les tarifs Azure managed disk, la documentation RunPod sur le stockage et les volumes réseau, les détails des annonces de stockage de Vast.ai, ainsi que les hypothèses de stockage d’instance de Lambda Cloud. Considérez-les comme des listes de vérification sources, et non comme des tableaux de tarifs à recopier.
Coût caché 2 : egress et transfert réseau
L’egress est le coût caché qui surprend le plus souvent les équipes qui déplacent des données entre clouds, régions ou catégories de fournisseurs. Les jobs GPU sont souvent construits autour de grandes entrées et de grands artefacts :
- Jeux de données d’entraînement.
- Checkpoints de fine-tuning.
- Sorties d’embeddings.
- Images et vidéos générées.
- Traces et journaux d’évaluation.
- Images de conteneur et poids de modèle.
La facturation ne concerne pas seulement le « téléchargement vers Internet ». Selon le fournisseur et l’architecture, vous pouvez aussi payer pour les transferts inter-régions, inter-zones, NAT, load balancers, IP publiques, liens privés ou services réseau managés. Pour les clusters multi-nœuds, le réseau est aussi une exigence de performance, pas seulement une ligne de facture.
Avant d’approuver la dépense, cartographiez le trajet des données :
source dataset
  -> object storage
  -> GPU region
  -> scratch or shared storage
  -> inference/training output
  -> evaluation or application region
  -> customer, warehouse, or archive
Puis demandez-vous :
- Le jeu de données se trouve-t-il déjà dans la même région que le GPU ?
- Le job téléchargera-t-il à plusieurs reprises les poids du modèle pour chaque worker ?
- Les sorties générées quittent-elles le fournisseur ou circulent-elles seulement en interne ?
- Un lien privé réduit-il le risque de sécurité mais ajoute-t-il un coût réseau fixe ?
- Les journaux et traces sont-ils exportés entre régions ?
Si le trajet des données traverse des régions ou des fournisseurs chaque jour, un faible tarif horaire GPU peut être la mauvaise cible d’optimisation.
Coût caché 3 : temps d’inactivité et mauvaise utilisation
Le temps d’inactivité est le coût caché le plus direct du cloud GPU, car l’accélérateur est coûteux qu’il fasse un travail utile ou qu’il attende une personne, une file, le téléchargement d’une image, un déploiement en échec ou le chargement de données.
Mesurez séparément deux chiffres :
billable running time =
  minutes facturées par le fournisseur pour la ressource GPU

useful GPU-active time =
  minutes passées à faire du travail d’entraînement, d’inférence, d’évaluation ou de génération accepté
Calculez ensuite :
idle waste share =
  1 - useful GPU-active time / billable running time
Si un notebook tourne pendant 100 heures facturées et que le travail GPU utile n’a lieu que pendant 32 heures, le gaspillage caché lié à l’inactivité est de 68 %. Négocier un tarif GPU inférieur de 10 % ne résoudra pas cela. Une politique d’arrêt automatique, le compactage de la file, l’ordonnancement des jobs et le balisage des propriétaires le feront.
Contrôles utiles :
- Arrêter automatiquement les notebooks interactifs après une période d’inactivité.
- Supprimer les pods non attachés, les endpoints orphelins et les expériences abandonnées.
- Exiger des tags propriétaire, projet, environnement et expiration.
- Suivre ensemble l’utilisation GPU, l’utilisation mémoire, l’attente en file et la durée d’exécution facturée.
- Déplacer les jobs récurrents des notebooks vers un ordonnanceur.
- Alerter lorsqu’un GPU reste sous un seuil d’utilisation pendant une fenêtre définie.
Le temps d’inactivité est aussi la principale raison pour laquelle une API de modèle managée peut battre une location GPU directe pour des charges d’inférence incertaines. Si l’utilisation est faible ou irrégulière, comparez la feuille de calcul GPU à la comparaison des tarifs des modèles d’IA avant de réserver de la capacité.
Coût caché 4 : interruption, nouvelles tentatives et charges de travail en échec
La capacité GPU spot, interruptible et marketplace peut être utile. Elle peut aussi déplacer le coût de la grille tarifaire vers la logique de reprise.
Le modèle de coût devrait inclure :
- Évictions et préemptions.
- Téléchargements répétés du modèle.
- Travail perdu depuis le dernier checkpoint.
- Enregistrements batch dupliqués.
- Fine-tunes échoués.
- Exécutions en manque de mémoire.
- Mauvaises combinaisons de pilotes ou de CUDA.
- Délai de file d’attente lorsque la capacité de remplacement n’est pas disponible.
Pour les jobs avec reprise possible, utilisez :
effective cost with failures =
  listed compute cost
  * retry amplification factor
Si 1 000 sorties acceptées nécessitent 1 180 sorties tentées après des erreurs, des évictions et des contrôles qualité échoués, le facteur d’amplification des nouvelles tentatives est de 1.18x. Ce multiplicateur doit figurer dans la même feuille de calcul que le prix horaire.
Pour un choix plus approfondi entre les modèles de tarification, utilisez le guide Flatkey sur le GPU à la demande vs spot. Pour cet article, le point clé est plus restreint : les coûts cachés ne se limitent pas au stockage et à l’egress. Le travail échoué est aussi un travail facturable, sauf si votre fournisseur le crédite explicitement.
Coût caché 5 : support, SLA et périmètre du service managé
Le support est facile à omettre parce qu’il apparaît souvent en dehors du devis GPU. Les équipes IA d’entreprise peuvent avoir besoin de :
- Forfaits de support payants.
- Engagements sur les délais de réponse.
- Support privé sur Slack ou support compte dédié.
- Onboarding de cluster dédié.
- Aide à la migration.
- Revue de sécurité.
- Documentation de conformité.
- Support managé pour Kubernetes, Slurm ou le service d’inférence.
- Crédits ou recours en cas d’indisponibilités côté fournisseur.
Le support n’est pas automatiquement un problème. Il peut coûter moins cher que de perdre du temps de mise sur le marché à cause de problèmes non résolus de capacité GPU, de pilotes ou de réseau. L’erreur d’achat consiste à comparer le tarif horaire GPU en self-service d’un fournisseur avec le tarif managé ou supporté d’un autre comme s’ils étaient équivalents.
Demandez à chaque fournisseur :
| Question | Pourquoi c’est important |
|---|---|
| Quel niveau de support est inclus dans ce devis ? | Empêche de comparer une capacité supportée et non supportée comme s’il s’agissait du même produit. |
| Quel est l’objectif de délai de réponse pour les incidents de production ? | La valeur du support dépend du moment de l’incident, et pas seulement de l’accès au ticket. |
| Les défaillances côté fournisseur sont-elles créditées ? | Les crédits peuvent réduire le gaspillage, mais seulement si le contrat définit les événements couverts. |
| Qui prend en charge les problèmes de pilotes, de CUDA, d’image et de kernel ? | Le périmètre du support détermine quelle part du travail de plateforme reste en interne. |
| La migration ou l’acceptation des benchmarks est-elle incluse ? | Un devis horaire bas peut rester coûteux si l’onboarding échoue. |
Pour les clusters privés et les capacités multi-nœuds, le périmètre du support peut être aussi important que le modèle de GPU.
Coût caché 6 : monitoring, logs et observabilité
Les workloads GPU ont besoin d’une observabilité qui va au-delà d’une facture mensuelle. Le coût apparaît à deux endroits : dans les outils d’observabilité eux-mêmes et dans le temps d’ingénierie nécessaire pour transformer les métriques en actions.
Suivez :
- L’utilisation du GPU et l’utilisation de la mémoire.
- La latence p50, p95 et p99.
- Le temps d’attente dans la file et le temps de cold start.
- Le temps de téléchargement du conteneur.
- Le temps de chargement du modèle.
- Les échecs de manque de mémoire (out-of-memory).
- Le nombre de retries et le coût des retries.
- Le volume d’egress.
- La croissance du stockage par projet.
- Le coût par sortie acceptée.
Les logs et les traces peuvent aussi devenir une ligne de facture s’ils sont trop verbeux, conservés trop longtemps ou exportés vers une autre région. Gardez suffisamment de détails pour déboguer les coûts et la fiabilité, mais définissez la rétention par environnement. Les traces de production, les logs d’évaluation et les logs de debug n’ont pas besoin du même cycle de vie.
Coût caché 7 : inadéquation des réservations et verrouillage de capacité
Une capacité GPU réservée peut réduire le coût de calcul effectif lorsque la demande est réelle. Elle peut aussi devenir un abonnement à une capacité inutilisée.
Utilisez cette formule avant de vous engager :
point mort d’utilisation de la réservation =
  engagement mensuel réservé
  / coût mensuel équivalent à la demande à pleine utilisation
Puis testez la robustesse :
- Que se passe-t-il si la demande est inférieure de 40 % aux prévisions ?
- Que se passe-t-il si le produit passe d’une famille de modèles à une autre ?
- L’engagement peut-il passer de H100 à H200, B200, L40S ou à une autre région ?
- Le stockage, l’egress, le support et le réseau sont-ils inclus dans l’engagement ?
- D’autres charges de travail internes peuvent-elles utiliser la capacité de base inutilisée ?
Si la réponse dépend de l’espoir, réservez moins et gardez la flexibilité de la capacité de burst. Pour les déploiements plus importants, associez cela à la fiche de calcul TCO d’un cluster GPU.
Fiche de calcul des coûts cachés du cloud GPU
Utilisez cette fiche de calcul dans les revues d’achat. Remplissez-la pour chaque fournisseur, chaque région et chaque mode de produit.
| Champ | À renseigner |
|---|---|
| Fournisseur et mode de produit | Instance à la demande, pod, VM spot, GPU serverless, cluster réservé, hôte marketplace, bare metal dédié. |
| Modèle de GPU et quantité | H100, H200, B200, A100, L40S, classe RTX, taille de mémoire, nombre de GPU. |
| Région et emplacement des données | Où les données commencent, où le GPU s’exécute, où les sorties sont déplacées. |
| Unité de facturation | Seconde, minute, heure, mois, durée engagée, bloc de capacité, worker de point de terminaison. |
| Coût de calcul GPU affiché | Source ou devis horodaté, avec date de vérification. |
| Estimation de l’utilisation utile | Minutes GPU actives attendues divisées par les minutes facturables. |
| Estimation du gaspillage d’inactivité | Temps facturable non utile attendu. |
| Stockage persistant | Volumes, disques, stockage d’objets, systèmes de fichiers partagés, cache du modèle. |
| Snapshots et sauvegardes | Politique de rétention, responsable des coûts, processus de nettoyage. |
| Egress et réseau | Egress Internet, déplacement inter-régions, liaisons privées, NAT, load balancers, IP publiques. |
| Coût de cold-start | Temps de téléchargement du conteneur, temps de chargement du modèle, montée en température du worker. |
| Amplification des tentatives | Tentatives échouées divisées par résultats acceptés. |
| Support et SLA | Support inclus, niveau de support payant, périmètre du service géré, crédits. |
| Supervision et journaux | Métriques, traces, export des logs, rétention. |
| Surcharge d’ingénierie | Heures de plateforme, réponse aux incidents, maintenance, rapprochement financier. |
| Dénominateur unitaire | Sortie acceptée, exécution terminée, token entraîné, image, clip, enregistrement, GPU-mois. |
| Coût unitaire final | Coût tout compris divisé par le travail utile terminé. |
La feuille de calcul doit être revue chaque mois pour les charges de travail de production et avant chaque renouvellement d’engagement.
Liste de contrôle des sources du fournisseur
Les pages de tarification GPU et de stockage changent souvent. Ne copiez pas d’anciens chiffres dans un dossier d’arbitrage. Utilisez les pages officielles comme liste de contrôle des sources et consignez la date de vérification à côté de chaque devis.
| Fournisseur ou source | À vérifier |
|---|---|
| Tarification AWS EC2, Tarification Amazon EBS, Tarification du transfert de données AWS, Plans de support AWS | Famille d’instances GPU, à la demande ou Spot, EBS, snapshots, transfert de données, plan de support. |
| Tarification des GPU Google Cloud Compute Engine, Tarification Persistent Disk, Tarification du réseau VPC, Cloud Customer Care | Type de GPU, famille de machines, région, disque, snapshot, egress, service de support. |
| Tarification des machines virtuelles Azure, Tarification des disques managés Azure, Tarification de la bande passante Azure, Plans de support Azure | SKU de VM GPU, disque managé, snapshot, bande passante, plan de support, conditions de réservation. |
| Tarification RunPod et documentation RunPod sur le stockage | Secure Cloud vs Community Cloud, mode pod ou serverless, volumes persistants, volumes réseau, comportement en cas d’inactivité. |
| Tarification Vast.ai, FAQ Vast.ai, et détails de l’annonce du fournisseur | Fiabilité de l’hôte marketplace, disque, bande passante, IP publique, statut interruptible, hôte datacenter ou communautaire. |
| Tarification GPU Lambda Cloud | Type d’instance, quantité de GPU, hypothèses de stockage inclus, disponibilité régionale, conditions de cluster réservé. |
| FinOps FOCUS | Dimensions de facturation communes et vocabulaire d’allocation des coûts pour les équipes finance et plateforme. |
| Tarification Flatkey, Modèles Flatkey, et Flatkey Compute | Alternative d’API de modèle, solde unique, registre d’utilisation et vérifications actuelles des sources du marché du calcul. |
Pour cet article, la liste de contrôle des sources a été examinée le 13 octobre 2026. Revérifiez-la avant d’utiliser un devis fournisseur dans une note d’approbation.
Questions d’achats avant d’approuver une dépense GPU cloud
Utilisez ces questions avant d’accepter un devis ou de lancer une migration.
- Quels sont les coûts cachés des services GPU cloud dans ce devis, et lesquels sont hors devis ?
- Le stockage, les snapshots, le stockage d’objets et les sauvegardes sont-ils inclus ou facturés séparément ?
- Quels transferts de données créent des frais d’egress ou inter-régions ?
- Quel est le taux d’inactivité attendu après les écarts du scheduler, le temps de démarrage et le débogage humain ?
- Comment les interruptions spot, les défaillances d’hôte et les incidents côté fournisseur sont-ils crédités ?
- Quel plan de support est requis pour les temps de réponse en production ?
- Qui prend en charge les problèmes CUDA, driver, image, kernel et stack de serving ?
- Quelles métriques prouveront une utilisation utile après le lancement ?
- Quel est le chemin de sortie si le choix du modèle change ?
- Une API de modèle managée ou un parcours hybride peut-il produire la même sortie acceptée avec moins de capacité inactive ?
La dernière question n’est pas un raccourci commercial. C’est un levier de contrôle du TCO. Si la charge de travail ne nécessite pas de contrôle matériel, la location de GPU n’est qu’une manière possible d’acheter des sorties de modèle.
Quand Flatkey a sa place dans la comparaison
Flatkey ne remplace pas tous les clusters GPU. Les équipes ont encore besoin de capacité GPU cloud pour l’entraînement personnalisé, les modèles open-weight auto-hébergés, les kernels spécialisés, les clusters privés et les infrastructures étroitement contrôlées.
Flatkey a sa place dans la comparaison lorsque la charge de travail consiste vraiment à consommer des résultats de modèle :
- Le produit a besoin de nombreux modèles officiels plutôt que d’un seul modèle auto-hébergé.
- La demande est incertaine, par à-coups ou saisonnière.
- La finance veut un seul solde, une seule facture et un registre d’utilisation.
- L’ingénierie veut accéder aux modèles sans clés de fournisseur dispersées.
- L’équipe veut comparer le coût des API de modèle avant de louer ou de réserver des GPU.
Dans ce cas, Flatkey donne aux équipes une seule clé API, un seul solde et une seule facture sur les routes et outils de modèles officiels. Si la feuille de calcul des coûts cachés montre que le stockage, l’egress, le temps d’inactivité et le support annulent l’avantage du coût horaire GPU, comparez l’option d’API managée avant de vous engager sur du matériel.
Commencez par les guides prix de location des GPU, GPU cloud vs API de modèle, TCO d’un cluster GPU et gestion des dépenses des API IA pour la décision plus large.
Recommandation finale
Quand quelqu’un demande quels sont les coûts cachés des services GPU cloud, ne répondez pas avec un seul tarif. Répondez avec une feuille de calcul.
- Partez du prix horaire du GPU.
- Ajoutez le stockage, les snapshots, l’egress, le réseau, le support, l’observabilité et les opérations.
- Ne déduisez rien tant qu’un crédit fournisseur n’est pas écrit dans le contrat.
- Divisez par le travail réalisé, pas par les heures facturables.
- Relancez le modèle avec une utilisation plus faible, un taux de retry plus élevé et un changement de modèle.
Les services GPU cloud peuvent être la bonne réponse lorsque l’équipe a besoin de contrôle matériel et peut maintenir une capacité utile. Ils deviennent coûteux lorsque le stockage grossit silencieusement, que les données circulent à répétition, que les GPU restent inactifs, que le support est absent et que le travail échoué est considéré comme le problème de quelqu’un d’autre.
Le rôle de l’acheteur est de rendre ces coûts visibles avant l’arrivée de la facture.


