
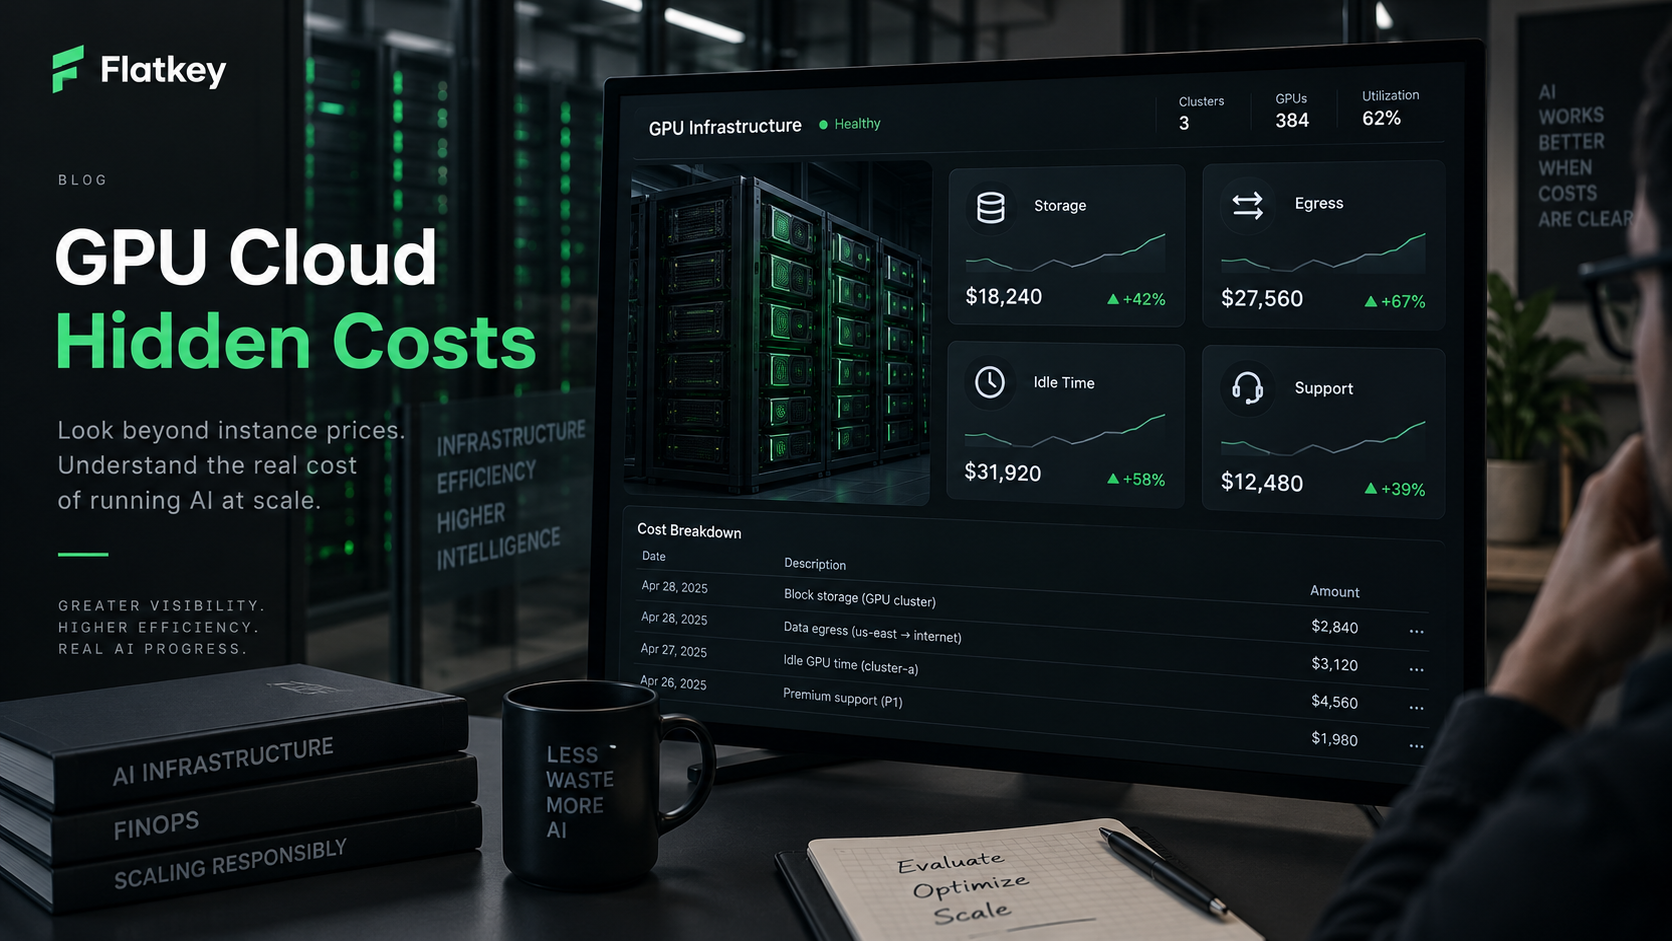
Apa saja biaya tersembunyi dari layanan GPU cloud? Jawaban singkatnya adalah bahwa tarif per jam GPU hanya merupakan garis awal. Tagihan sebenarnya juga mencakup penyimpanan, snapshot, egress bandwidth, notebook atau pod yang menganggur, cold start, job yang gagal, paket dukungan, private networking, pemantauan, dan pekerjaan engineering yang diperlukan agar kapasitas GPU tetap berguna.
Bagi tim AI enterprise, biaya tersembunyi GPU cloud biasanya muncul setelah benchmark pertama yang berhasil. Tim melihat harga per jam H100, H200, A100, L40S, atau RTX yang terlihat wajar, mulai memindahkan model dan data, lalu menemukan bahwa invoice dibentuk oleh segala sesuatu di sekitar akselerator. GPU yang lebih murah bisa kalah jika dibiarkan menganggur, memuat ulang bobot model berulang kali, memindahkan terabita lintas region, atau membutuhkan tingkatan dukungan yang tidak ada dalam penawaran awal.
Panduan ini memberi tim platform engineering, FinOps, procurement, dan produk AI cara praktis untuk mengaudit biaya GPU cloud sebelum menandatangani perjanjian sewa, reserved-capacity, atau dedicated-cluster.
Aturan yang berguna sederhana:
biaya GPU cloud sebenarnya =
  komputasi GPU
  + penyimpanan
  + egress dan networking
  + waktu menganggur
  + pemborosan saat restart dan kegagalan
  + dukungan
  + overhead operasional
Jika Anda membandingkan penyedia hanya berdasarkan item baris GPU, Anda tidak sedang membandingkan biaya dari sistem AI yang benar-benar bekerja.
Biaya tersembunyi GPU cloud: jawaban singkat
Mulailah setiap tinjauan biaya tersembunyi GPU cloud dengan tabel ini.
| Biaya tersembunyi | Cara kemunculannya | Kontrol yang harus diminta |
|---|---|---|
| Penyimpanan | Persistent volume, disk blok, object storage, snapshot, cache model, dataset, checkpoint | Pisahkan data sementara dan data tahan lama; beri tag pada volume; kedaluwarsakan snapshot yang tidak terpakai; simpan bobot model dekat dengan GPU. |
| Egress | Transfer internet, perpindahan lintas region, traffic IP publik, data keluar dari object storage, unduhan hasil | Simpan data, GPU, dan penyimpanan di region yang sama; alokasikan anggaran transfer keluar; hindari pengunduhan artefak berulang. |
| Waktu menganggur | Pod, notebook, endpoint, atau node reserved yang berjalan tanpa pekerjaan GPU yang bermanfaat | Auto-stop sumber daya yang menganggur; jadwalkan job melalui antrean; beri alert pada utilisasi GPU yang rendah dan eksperimen yang berjalan lama. |
| Cold start | Menarik container, memuat bobot model, menghangatkan kernel, memasang volume sebelum pekerjaan berguna dimulai | Bangun image sebelumnya; cache bobot; ukur waktu startup sebagai waktu yang ditagihkan. |
| Job yang gagal | Kegagalan out-of-memory, ketidakcocokan driver, preemption, host yang buruk, deployment yang rusak | Jalankan canary; lakukan checkpoint; gunakan ID job yang idempotent; lacak biaya kegagalan sebagai pos anggaran. |
| Dukungan | Tingkatan dukungan berbayar, biaya layanan terkelola, dukungan private cluster, cakupan SLA, bantuan migrasi | Tanyakan syarat dukungan mana yang termasuk dalam penawaran dan mana yang merupakan biaya bulanan terpisah. |
| Networking | Load balancer, NAT, private link, IP publik, traffic lintas zone, premi InfiniBand atau RoCE | Sesuaikan network fabric dengan workload alih-alih menerima penawaran umum per jam GPU. |
| Operasi | Pemantauan, log, pekerjaan scheduler, patch keamanan, insiden cluster, rekonsiliasi keuangan | Hitung jam platform engineering dalam model TCO yang sama dengan invoice penyedia. |
Untuk tinjauan pembeli tahap awal, ajukan satu pertanyaan: apa saja biaya tersembunyi dari layanan GPU cloud setelah GPU sudah berjalan? Jawabannya jarang berupa satu biaya kejutan. Biasanya berupa serangkaian komponen cloud biasa yang menjadi mahal karena workload AI memindahkan artefak besar dan membuang waktu akselerator yang mahal saat orkestrasi lemah.
Mengapa jam GPU yang terdaftar tidak lengkap
Satu jam GPU cloud adalah unit kapasitas. Itu bukan training run yang selesai, respons inferensi yang diterima, video yang dihasilkan, atau batch evaluasi yang berhasil.
Perbedaan ini penting karena workload GPU sering memiliki biaya di sekitarnya yang tinggi:
- Bobot model dapat berukuran puluhan atau ratusan gigabita.
- Dataset fine-tuning dan checkpoint dapat bertahan lama setelah job berakhir.
- Endpoint inferensi mungkin memerlukan kapasitas hangat untuk latensi meskipun volume permintaan tidak merata.
- Pelatihan multi-node dapat gagal jika satu worker, sambungan jaringan, atau mount penyimpanan bermasalah.
- Kapasitas marketplace atau spot mungkin lebih murah tetapi memerlukan kontrol restart dan kerja ganda.
Penyebut yang lebih baik adalah:
biaya per workload selesai =
  biaya cloud GPU all-in
  / run yang selesai, output yang diterima, token yang diterima, gambar, klip, atau record
Ini adalah logika yang sama di balik panduan GPU cloud vs model API dari Flatkey yang lebih luas. Jika bisnis membutuhkan output model, bandingkan biaya per output yang diterima. Jika bisnis benar-benar membutuhkan kontrol hardware, bandingkan setiap opsi GPU berdasarkan biaya per workload selesai.
Biaya tersembunyi 1: penyimpanan, snapshot, dan artefak model
Penyimpanan adalah biaya tersembunyi pertama dari layanan GPU cloud karena tim AI perlu data dekat dengan komputasi. Item barisnya dapat mencakup:
- Persistent block disk atau volume yang terpasang pada instance GPU.
- Object storage untuk dataset, prompt, output, dan artefak model.
- Snapshot dan backup.
- Network file system atau shared volume untuk cluster.
- NVMe lokal yang disertakan dengan beberapa mesin tetapi hilang saat instance dihancurkan.
- Cache model yang hidup lama yang tidak dimiliki siapa pun setelah eksperimen.
Untuk benchmark kecil, penyimpanan mungkin terlihat tidak signifikan. Untuk LLM produksi, model visi, atau pipeline media, biaya ini bisa menjadi pengeluaran bulanan yang berkelanjutan. Kesalahannya adalah menyimpan semuanya selamanya karena menghapus cache model yang salah akan memperlambat run berikutnya.
Gunakan kebijakan tiga-bucket:
| Kelas penyimpanan | Contoh | Aturan retensi |
|---|---|---|
| Data sumber yang berkelanjutan | Korpus pelatihan, set evaluasi yang disetujui, aset yang disetujui pelanggan | Dimiliki oleh platform data; diberi versi dan dicadangkan. |
| Aset runtime yang dapat digunakan kembali | Bobot model, varian terkuantisasi, layer container, file tokenizer | Di-cache dekat komputasi; diperbarui secara sengaja; tidak digandakan per eksperimen. |
| Output sementara | Checkpoint yang gagal, log debug, volume scratch, media промежуточный | Kedaluwarsa otomatis kecuali secara eksplisit dipromosikan. |
Halaman penyedia yang perlu diperiksa mencakup harga AWS EC2 dan EBS, harga persistent disk dan snapshot Google Cloud, harga managed disk Azure, dokumentasi storage dan network-volume RunPod, detail daftar storage Vast.ai, serta asumsi storage instance Lambda Cloud. Perlakukan ini sebagai daftar periksa sumber, bukan tabel tarif yang disalin.
Biaya tersembunyi 2: egress dan transfer jaringan
Egress adalah biaya tersembunyi yang paling mungkin mengejutkan tim yang memindahkan data antar cloud, region, atau kategori penyedia. Pekerjaan GPU sering dibangun di sekitar input besar dan artefak besar:
- Dataset pelatihan.
- Checkpoint fine-tuning.
- Output embedding.
- Gambar dan video yang dihasilkan.
- Trace evaluasi dan log.
- Image container dan bobot model.
Biaya ini bukan hanya "download ke internet." Bergantung pada penyedia dan arsitektur, Anda juga mungkin membayar transfer lintas-region, transfer lintas-zone, NAT, load balancer, IP publik, private link, atau layanan jaringan terkelola. Untuk cluster multi-node, fabric jaringan juga merupakan kebutuhan performa, bukan sekadar baris tagihan.
Sebelum menyetujui pengeluaran, petakan jalur data:
source dataset
  -> object storage
  -> GPU region
  -> scratch or shared storage
  -> inference/training output
  -> evaluation or application region
  -> customer, warehouse, or archive
Lalu tanyakan:
- Apakah dataset sudah berada di region yang sama dengan GPU?
- Apakah job akan berulang kali mengunduh bobot model untuk setiap worker?
- Apakah output yang dihasilkan meninggalkan penyedia atau hanya berpindah secara internal?
- Apakah private link mengurangi risiko keamanan tetapi menambah biaya jaringan tetap?
- Apakah log dan trace diekspor lintas region?
Jika jalur data melintasi region atau penyedia setiap hari, tarif GPU per jam yang rendah bisa menjadi target optimasi yang salah.
Biaya tersembunyi 3: waktu menganggur dan utilisasi yang buruk
Waktu menganggur adalah biaya tersembunyi cloud GPU yang paling langsung karena akselerator mahal baik saat melakukan pekerjaan yang berguna maupun saat menunggu orang, antrean, pull image, deployment gagal, atau pemuatan data.
Ukur dua angka secara terpisah:
billable running time =
  menit yang ditagihkan penyedia untuk resource GPU

useful GPU-active time =
  menit yang dihabiskan untuk training, inference, eval, atau generation yang diterima
Lalu hitung:
idle waste share =
  1 - useful GPU-active time / billable running time
Jika sebuah notebook berjalan selama 100 jam yang ditagihkan dan pekerjaan GPU yang berguna terjadi selama 32 jam, pemborosan menganggur tersembunyi adalah 68%. Menegosiasikan tarif GPU 10% lebih rendah tidak akan memperbaiki itu. Kebijakan auto-stop, queue packing, penjadwalan job, dan tagging owner akan melakukannya.
Kontrol yang berguna:
- Auto-stop notebook interaktif setelah tidak aktif.
- Hentikan pod yang tidak terpasang, endpoint yatim piatu, dan eksperimen yang ditinggalkan.
- Wajibkan tag owner, project, environment, dan expiration.
- Lacak utilisasi GPU, utilisasi memori, waktu tunggu antrean, dan runtime yang ditagihkan secara bersamaan.
- Pindahkan job berulang dari notebook ke scheduler.
- Beri peringatan saat GPU berada di bawah ambang utilisasi selama jendela waktu yang ditentukan.
Waktu menganggur juga menjadi alasan utama API model terkelola dapat mengungguli penyewaan GPU langsung untuk beban inferensi yang tidak pasti. Jika utilisasi rendah atau melonjak-lonjak, bandingkan worksheet GPU dengan perbandingan harga model AI sebelum memesan kapasitas.
Biaya tersembunyi 4: interupsi, percobaan ulang, dan workload yang gagal
Kapasitas GPU spot, interruptible, dan marketplace bisa berguna. Tetapi juga dapat memindahkan biaya dari daftar tarif ke logika retry.
Model biaya harus mencakup:
- Eviction dan preemption.
- Pengunduhan model berulang.
- Pekerjaan yang hilang sejak checkpoint terakhir.
- Rekaman batch duplikat.
- Fine-tune yang gagal.
- Run kehabisan memori.
- Kombinasi driver atau CUDA yang buruk.
- Penundaan antrean saat kapasitas pengganti tidak tersedia.
Untuk job yang dapat di-retry, gunakan:
effective cost with failures =
  listed compute cost
  * retry amplification factor
Jika 1.000 output yang diterima memerlukan 1.180 output yang dicoba setelah error, eviction, dan pemeriksaan kualitas yang gagal, faktor amplifikasi retry adalah 1.18x. Pengali itu harus dimasukkan ke worksheet yang sama dengan harga per jam.
Untuk memilih secara lebih mendalam antara model harga, gunakan panduan on-demand vs spot GPU dari Flatkey. Untuk artikel ini, poin utamanya lebih sempit: biaya tersembunyi bukan hanya penyimpanan dan egress. Pekerjaan yang gagal juga merupakan pekerjaan yang tetap ditagihkan, kecuali penyedia Anda secara eksplisit memberikan kredit.
Biaya tersembunyi 5: dukungan, SLA, dan cakupan managed service
Dukungan mudah diabaikan karena sering muncul di luar penawaran harga GPU. Tim AI enterprise mungkin membutuhkan:
- Paket dukungan berbayar.
- Komitmen waktu respons.
- Slack privat atau dukungan akun.
- Onboarding klaster khusus.
- Bantuan migrasi.
- Tinjauan keamanan.
- Dokumentasi kepatuhan.
- Dukungan Kubernetes terkelola, Slurm, atau inference-serving.
- Kredit atau perbaikan untuk gangguan di sisi penyedia.
Dukungan tidak otomatis buruk. Ini bisa lebih murah daripada kehilangan waktu peluncuran karena masalah kapasitas GPU, driver, atau jaringan yang belum terselesaikan. Kesalahan dalam pengadaan adalah membandingkan tarif GPU per jam self-service dari satu penyedia dengan tarif terkelola atau didukung dari penyedia lain seolah-olah keduanya setara.
Tanyakan ke setiap pemasok:
| Pertanyaan | Mengapa ini penting |
|---|---|
| Tingkat dukungan apa yang termasuk dalam penawaran ini? | Mencegah perbandingan kapasitas yang didukung dan tidak didukung seolah-olah produk yang sama. |
| Apa target respons untuk insiden produksi? | Nilai dukungan bergantung pada waktu insiden, bukan hanya akses tiket. |
| Apakah kegagalan di sisi penyedia diberikan kredit? | Kredit dapat mengurangi pemborosan, tetapi hanya jika kontrak mendefinisikan peristiwa yang dicakup. |
| Siapa yang menangani masalah driver, CUDA, image, dan kernel? | Cakupan dukungan menentukan seberapa banyak pekerjaan platform tetap internal. |
| Apakah migrasi atau penerimaan benchmark termasuk? | Penawaran per jam yang rendah tetap bisa mahal jika onboarding gagal. |
Untuk klaster privat dan kapasitas multi-node, cakupan dukungan bisa sama pentingnya dengan model GPU.
Biaya tersembunyi 6: monitoring, log, dan observability
Beban kerja GPU memerlukan observability selain tagihan bulanan. Biayanya muncul di dua tempat: pada alat observability itu sendiri dan waktu engineering yang diperlukan untuk mengubah metrik menjadi tindakan.
Lacak:
- Utilisasi GPU dan utilisasi memori.
- Latensi p50, p95, dan p99.
- Waktu tunggu antrean dan cold-start.
- Waktu pull container.
- Waktu muat model.
- Kegagalan out-of-memory.
- Jumlah retry dan biaya retry.
- Volume egress.
- Pertumbuhan storage per proyek.
- Biaya per output yang diterima.
Log dan trace juga dapat menjadi item tagihan jika terlalu verbose, disimpan terlalu lama, atau diekspor ke region lain. Simpan detail yang cukup untuk men-debug biaya dan keandalan, tetapi tetapkan retensi berdasarkan lingkungan. Trace produksi, log evaluasi, dan log debug tidak memerlukan siklus hidup yang sama.
Biaya tersembunyi 7: ketidaksesuaian reservasi dan lock-in kapasitas
Kapasitas GPU yang dipesan dapat menurunkan biaya komputasi efektif ketika permintaan memang nyata. Namun, itu juga bisa menjadi langganan kapasitas menganggur.
Gunakan rumus ini sebelum berkomitmen:
utilisasi impas reservasi =
  komitmen bulanan yang dipesan
  / biaya bulanan on-demand yang setara pada penggunaan penuh
Kemudian uji stres:
- Apa yang terjadi jika permintaan 40% lebih rendah dari perkiraan?
- Apa yang terjadi jika produk beralih dari satu keluarga model ke keluarga model lain?
- Apakah komitmen dapat dikonversi dari H100 ke H200, B200, L40S, atau region yang berbeda?
- Apakah storage, egress, dukungan, dan jaringan termasuk dalam komitmen?
- Bisakah beban kerja internal lain mengisi kapasitas baseline yang menganggur?
Jika jawabannya bergantung pada harapan, pesan lebih sedikit dan pertahankan fleksibilitas kapasitas burst. Untuk deployment yang lebih besar, pasangkan ini dengan lembar kerja GPU cluster TCO.
Lembar kerja biaya tersembunyi cloud GPU
Gunakan lembar kerja ini dalam tinjauan pengadaan. Isi untuk setiap penyedia, setiap region, dan setiap mode produk.
| Bidang | Apa yang harus diisi |
|---|---|
| Penyedia dan mode produk | Instans on-demand, pod, VM spot, GPU serverless, cluster terpesan, host marketplace, bare metal khusus. |
| Model GPU dan jumlah | H100, H200, B200, A100, L40S, kelas RTX, ukuran memori, jumlah GPU. |
| Region dan lokasi data | Tempat data dimulai, tempat GPU berjalan, tempat output dipindahkan. |
| Satuan penagihan | Detik, menit, jam, bulan, jangka waktu komitmen, blok kapasitas, worker endpoint. |
| Biaya komputasi GPU yang tercantum | Sumber atau penawaran bertimestamp, dengan tanggal pengecekan. |
| Estimasi pemanfaatan yang berguna | Menit GPU aktif yang diharapkan dibagi menit yang dapat ditagih. |
| Estimasi pemborosan akibat idle | Waktu billable yang diperkirakan tidak menghasilkan manfaat. |
| Penyimpanan persisten | Volume, disk, object storage, sistem berkas bersama, cache model. |
| Snapshot dan cadangan | Kebijakan retensi, pemilik biaya, proses pembersihan. |
| Egress dan jaringan | Egress internet, perpindahan lintas region, tautan privat, NAT, load balancer, IP publik. |
| Biaya cold-start | Waktu pull container, waktu muat model, pemanasan worker. |
| Amplifikasi retry | Percobaan gagal dibagi hasil yang diterima. |
| Dukungan dan SLA | Dukungan yang disertakan, tingkatan dukungan berbayar, cakupan managed service, kredit. |
| Monitoring dan log | Metrik, trace, ekspor log, retensi. |
| Overhead engineering | Jam platform, respons insiden, pemeliharaan, rekonsiliasi keuangan. |
| Penyebut unit | Output yang diterima, run selesai, token terlatih, gambar, klip, record, GPU-bulan. |
| Biaya unit akhir | Biaya total dibagi pekerjaan selesai yang berguna. |
Lembar kerja ini harus ditinjau setiap bulan untuk workload produksi dan sebelum setiap perpanjangan komitmen.
Daftar periksa sumber penyedia
Halaman harga GPU dan penyimpanan sering berubah. Jangan menyalin angka lama ke dalam business case. Gunakan halaman resmi sebagai daftar periksa sumber dan catat tanggal pengecekan di samping setiap kutipan.
| Penyedia atau sumber | Apa yang harus diverifikasi |
|---|---|
| Harga AWS EC2, Harga Amazon EBS, Harga transfer data AWS, Paket AWS Support | Familia instans GPU, On-Demand atau Spot, EBS, snapshot, transfer data, paket dukungan. |
| Harga GPU Google Cloud Compute Engine, Harga Persistent Disk, Harga jaringan VPC, Cloud Customer Care | Jenis GPU, keluarga mesin, region, disk, snapshot, egress, layanan dukungan. |
| Harga Azure Virtual Machines, Harga disk terkelola Azure, Harga bandwidth Azure, Paket dukungan Azure | SKU VM GPU, disk terkelola, snapshot, bandwidth, paket dukungan, ketentuan reservasi. |
| Harga RunPod dan Dokumentasi penyimpanan RunPod | Secure Cloud vs Community Cloud, mode pod atau serverless, volume persisten, volume jaringan, perilaku idle. |
| Harga Vast.ai, FAQ Vast.ai, dan detail listing penyedia | Keandalan host marketplace, disk, bandwidth, IP publik, status interruptible, host pusat data atau komunitas. |
| Harga GPU Lambda Cloud | Jenis instans, jumlah GPU, asumsi penyimpanan yang disertakan, ketersediaan regional, ketentuan cluster terpesan. |
| FinOps FOCUS | Dimensi penagihan umum dan bahasa alokasi biaya untuk tim keuangan dan platform. |
| Harga Flatkey, Model Flatkey, dan Flatkey Compute | Alternatif API model, satu saldo, ledger penggunaan, dan pengecekan sumber pasar komputasi terkini. |
Untuk artikel ini, daftar periksa sumber telah ditinjau pada 13 Oktober 2026. Periksa kembali sebelum menggunakan kutipan penyedia apa pun dalam memo persetujuan.
Pertanyaan pengadaan sebelum menyetujui pengeluaran GPU cloud
Gunakan pertanyaan-pertanyaan ini sebelum Anda menerima penawaran atau memulai migrasi.
- Apa saja biaya tersembunyi dari layanan GPU cloud dalam penawaran ini, dan mana yang di luar penawaran?
- Apakah penyimpanan, snapshot, object storage, dan backup sudah termasuk atau terpisah?
- Transfer data mana yang menimbulkan biaya egress atau lintas-region?
- Berapa tingkat waktu menganggur yang diharapkan setelah jeda scheduler, waktu startup, dan debugging manual?
- Bagaimana gangguan spot, kegagalan host, dan insiden di sisi penyedia dikreditkan?
- Rencana dukungan apa yang diperlukan untuk waktu respons produksi?
- Siapa yang bertanggung jawab atas masalah CUDA, driver, image, kernel, dan serving stack?
- Metrik apa yang akan membuktikan pemanfaatan yang berguna setelah peluncuran?
- Apa jalur keluar jika pilihan model berubah?
- Apakah API model terkelola atau rute hibrida dapat menghasilkan output yang diterima sama dengan kapasitas menganggur yang lebih sedikit?
Pertanyaan terakhir bukan jalan pintas penjualan. Itu adalah kontrol TCO. Jika beban kerja tidak memerlukan kontrol perangkat keras, sewa GPU hanyalah salah satu cara untuk membeli output model.
Kapan Flatkey masuk dalam perbandingan
Flatkey bukan pengganti untuk setiap klaster GPU. Tim tetap membutuhkan kapasitas GPU cloud untuk pelatihan kustom, model open-weight yang di-host sendiri, kernel khusus, klaster privat, dan infrastruktur yang dikendalikan secara ketat.
Flatkey masuk dalam perbandingan ketika beban kerja sebenarnya adalah tentang mengonsumsi hasil model:
- Produk membutuhkan banyak model resmi, bukan satu model yang di-host sendiri.
- Permintaan tidak pasti, melonjak, atau bersifat musiman.
- Keuangan menginginkan satu saldo, satu faktur, dan satu buku besar penggunaan.
- Teknik menginginkan akses model tanpa kunci penyedia yang tersebar.
- Tim ingin membandingkan biaya API model sebelum menyewa atau memesan GPU.
Dalam jalur itu, Flatkey memberi tim satu API key, satu saldo, dan satu faktur di seluruh rute dan alat model resmi. Jika lembar kerja biaya tersembunyi menunjukkan bahwa penyimpanan, egress, waktu menganggur, dan dukungan menghapus keunggulan biaya per jam GPU, bandingkan rute API terkelola sebelum berkomitmen pada perangkat keras.
Mulailah dengan panduan harga sewa GPU, GPU cloud vs API model, TCO klaster GPU, dan manajemen pengeluaran API AI untuk keputusan yang lebih luas.
Rekomendasi akhir
Saat seseorang bertanya apa saja biaya tersembunyi dari layanan GPU cloud, jangan jawab dengan satu biaya. Jawablah dengan lembar kerja.
- Mulailah dari harga per jam GPU.
- Tambahkan penyimpanan, snapshot, egress, jaringan, dukungan, observabilitas, dan operasional.
- Jangan kurangi apa pun sampai kredit dari penyedia tertulis dalam perjanjian.
- Bagi berdasarkan pekerjaan yang selesai, bukan jam yang ditagihkan.
- Jalankan ulang model di bawah utilisasi yang lebih rendah, tingkat retry yang lebih tinggi, dan perubahan pilihan model.
Layanan GPU cloud bisa menjadi jawaban yang tepat ketika tim membutuhkan kontrol perangkat keras dan dapat menjaga kapasitas tetap berguna. Layanan ini menjadi mahal ketika penyimpanan bertambah diam-diam, data berpindah berulang kali, GPU menganggur, dukungan tidak ada, dan pekerjaan yang gagal dianggap sebagai masalah orang lain.
Tugas pembeli adalah membuat biaya-biaya itu terlihat sebelum faktur datang.


