
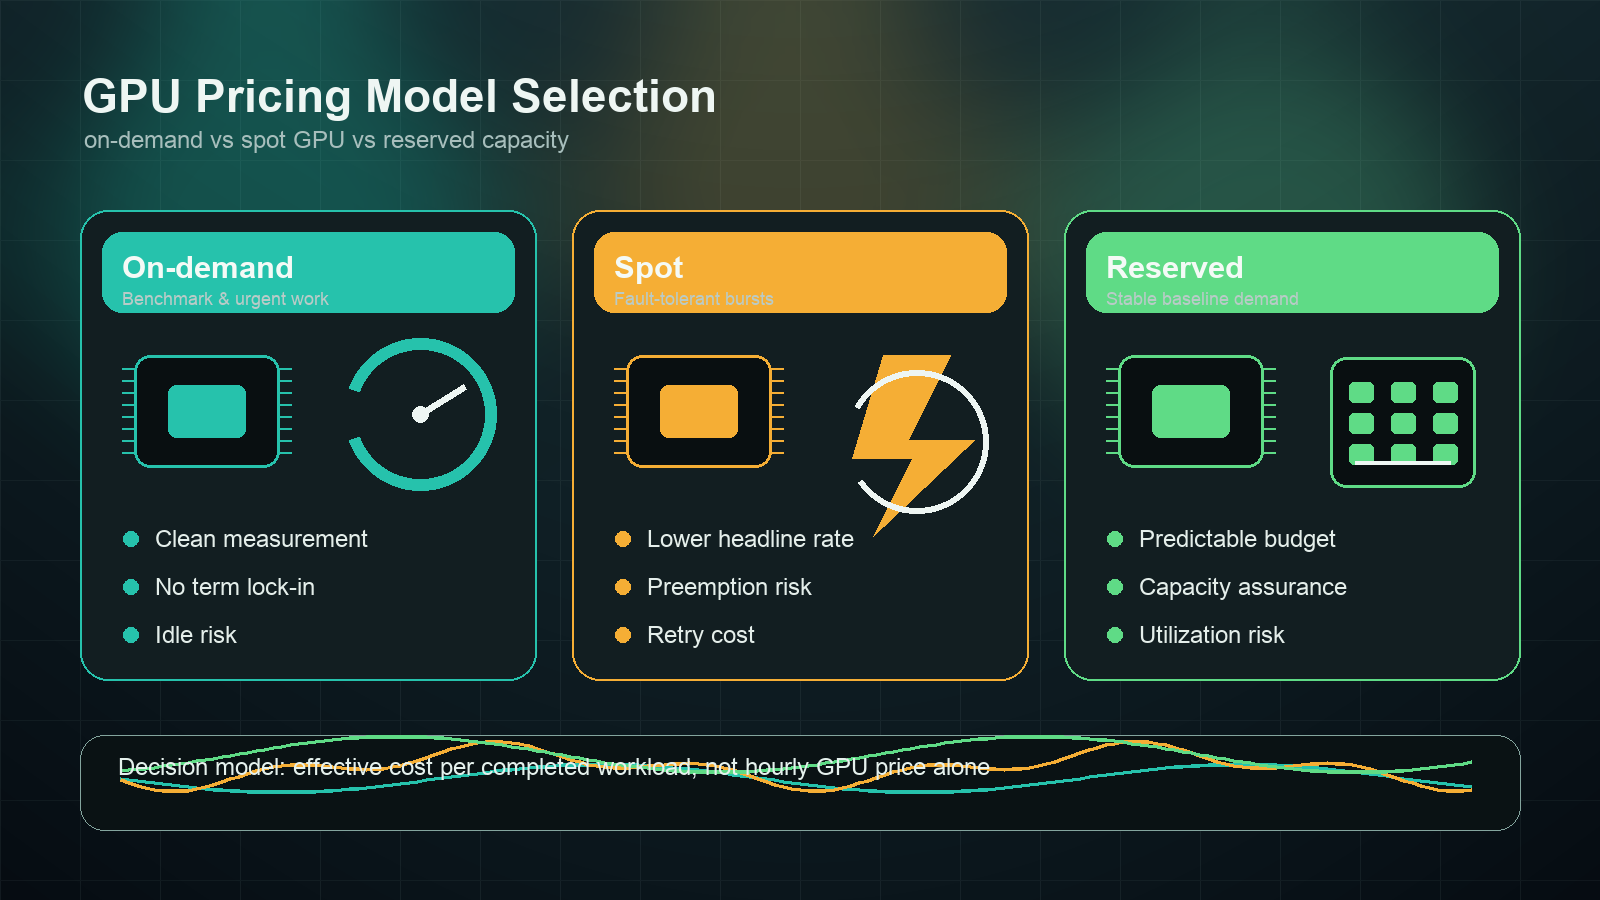
Choisir entre la capacité GPU à la demande et la capacité GPU Spot n’est pas seulement un exercice de comparaison tarifaire. Le prix horaire le plus bas peut se révéler plus coûteux si les tâches redémarrent, si les checkpoints sont insuffisants, si les données doivent être rechargées, ou si les ingénieurs passent des jours à maintenir en vie des machines interruptibles. La capacité GPU réservée peut également sembler moins chère jusqu’à ce que la demande pour le modèle évolue et que l’équipe se retrouve bloquée avec du matériel sous-utilisé.
Ce guide compare la tarification GPU à la demande, Spot et réservée pour les acheteurs d’infrastructure IA, les équipes FinOps et les ingénieurs plateforme qui ont besoin d’un modèle de décision pratique par charge de travail. La réponse courte : utilisez des GPU à la demande pour les premières mesures et les travaux urgents, des GPU Spot pour les charges batch tolérantes aux pannes, et une capacité GPU réservée uniquement après avoir pu prouver un taux d’utilisation de base.
Si vous êtes encore en train de décider s’il faut louer des GPU tout court, commencez par les guides plus larges sur les prix de location des GPU et GPU cloud vs API de modèle. Cet article se concentre sur le choix du modèle tarifaire une fois que vous savez déjà que la capacité GPU doit faire partie du plan.
La réponse rapide : GPU à la demande vs GPU Spot vs réservé
Pour la plupart des équipes, une première approche devrait ressembler à ceci :
| Modèle tarifaire | Cas d’usage idéal | Risque principal | Métrique à surveiller |
|---|---|---|---|
| GPU à la demande | Benchmarks, expériences urgentes, démos, production précoce, utilisation inconnue | Temps d’inactivité et tarif horaire affiché plus élevé | Minutes GPU utiles actives / minutes facturables |
| GPU Spot | Inférence batch, évaluations hors ligne, entraînement avec checkpoints, files média, workers réessayables | Éviction, délai de file d’attente, gaspillage lors des redémarrages, travail dupliqué | Travaux terminés après coût d’interruption |
| GPU réservé | Inférence en production stable, entraînement planifié, fenêtres de lancement, clusters dédiés | Sous-utilisation, verrouillage matériel, inadéquation contractuelle | Utilisation de base par rapport au point mort de l’engagement |
La règle durable pour les décisions GPU à la demande vs Spot est simple : comparez le coût effectif par charge de travail terminée, et non l’heure GPU affichée.
coût effectif par charge de travail terminée =
  (calcul + stockage + bande passante + temps d'inactivité + gaspillage lors des redémarrages + support + surcharge d'ingénierie)
  / travaux acceptés, jetons entraînés, jetons d'inférence, images, clips ou exécutions de benchmark
Cette formule compte parce que chaque modèle déplace le risque à un endroit différent. La demande à la demande place le risque dans le temps d’inactivité. Le Spot place le risque dans les interruptions et l’orchestration. La capacité réservée place le risque dans la précision des prévisions.
Ce que signifie la tarification GPU à la demande
La tarification GPU à la demande est le point de référence le plus clair. Vous payez tant que l’instance, le pod ou le serveur fonctionne, sans engagement à long terme. AWS décrit les instances On-Demand comme une capacité à paiement à l’usage, sans engagement à long terme. Les clouds GPU spécialisés utilisent un langage similaire pour les pods, instances ou serveurs GPU horaires, même si l’unité de facturation et le stockage inclus peuvent varier.
Utilisez d’abord le modèle à la demande lorsque la charge de travail est encore inconnue :
| Cas d’usage | Pourquoi la demande à la demande convient |
|---|---|
| Premier benchmark d’un modèle ou d’une pile de service | Vous avez besoin d’un timing propre sans variables d’interruption. |
| Validation du driver, de CUDA, du conteneur ou du framework | Le débogage ne doit pas être mélangé avec un risque d’éviction Spot. |
| Démo client ou environnement QA | La prévisibilité compte plus que le tarif le plus bas. |
| Point de terminaison de production précoce | Vous avez besoin de disponibilité avant d’avoir des données d’utilisation stables. |
| Exécution courte et urgente d’entraînement ou de fine-tuning | Le délai de file peut coûter plus cher que les économies horaires. |
Le piège, c’est le temps d’inactivité. Si un notebook, un pod ou un serveur d’inférence fonctionne pendant 100 heures facturables, mais que le GPU n’est actif que 28 heures utiles, le coût réel n’est pas le tarif horaire affiché par le fournisseur. Le taux réel est gonflé par le gaspillage dû à l’inactivité.
taux horaire effectif à la demande =
  tarif horaire à la demande affiché / part d'utilisation utile
Si l’utilisation est de 35 %, un GPU à 4 $/heure se comporte comme une ressource à 11,43 $/heure utile avant stockage, bande passante ou surcharge d’ingénierie. Pour les décisions GPU à la demande vs Spot, corrigez les arrêts d’inactivité et le regroupement des files avant de négocier un meilleur tarif horaire.
Ce que signifie la tarification GPU Spot
La tarification GPU Spot utilise une capacité excédentaire ou interruptible. AWS indique que les EC2 Spot Instances utilisent la capacité EC2 excédentaire et peuvent offrir des remises allant jusqu’à 90 % par rapport aux prix On-Demand. Les Google Cloud Spot VMs et les Azure Spot Virtual Machines suivent le même schéma général : une capacité à prix réduit qui peut être préemptée ou évincée lorsque le cloud en a de nouveau besoin.
Les GPU Spot sont attrayants pour les charges de travail IA parce que l’entraînement, l’évaluation, la génération d’images et l’inférence batch comportent souvent de gros blocs réessayables. Mais « réessayable » n’est pas automatique. Il vous faut du checkpointing, des jobs idempotents, la localisation des données, du monitoring et un ordonnanceur capable de redémarrer sans corrompre les résultats.
Le Spot est généralement un bon candidat lorsque :
- Les jobs d’entraînement sauvegardent fréquemment des checkpoints et reprennent proprement.
- L’inférence batch peut être relancée sans échec visible pour l’utilisateur.
- Les évaluations hors ligne peuvent s’exécuter sur de nombreux workers.
- Les jobs de génération média passent par une file d’attente.
- Un worker en échec n’invalide pas le job multi-nœuds complet.
- L’équipe dispose déjà d’une orchestration pour les évictions et la prévention des doublons.
Le Spot est généralement un mauvais candidat lorsque :
- Une seule exécution d’entraînement de plusieurs jours redémarre à partir d’un ancien checkpoint.
- Le temps de démarrage est dominé par le téléchargement des modèles, images ou jeux de données.
- La latence côté client dépend du fait que la machine reste active.
- L’entraînement multi-nœuds échoue lorsqu’un worker disparaît.
- Les ingénieurs doivent surveiller et relancer manuellement les redémarrages.
Pour les avantages et inconvénients des instances GPU spot par rapport aux instances à la demande, le calcul doit inclure le gaspillage dû aux interruptions :
taux horaire effectif spot =
  taux horaire spot / (1 - part de gaspillage dû aux interruptions)
Si le spot est 60 % moins cher mais que les interruptions, les rechargements de données, les étapes échouées et l’attente dans la file gaspillent 35 % du travail écoulé, la remise réelle est bien plus faible que le tarif affiché. Si le gaspillage lié aux redémarrages atteint un ordre de grandeur similaire à la remise, la capacité à la demande est souvent plus simple.
Ce que signifie la tarification GPU réservée
La tarification GPU réservée est un modèle d’engagement. Elle peut prendre la forme d’instances réservées, de Savings Plans, de remises sur usage engagé, de clusters réservés, de capacité privée, de blocs de capacité ou de contrats GPU dédiés. Les noms varient selon le fournisseur, mais l’arbitrage est le même : vous échangez de la flexibilité contre une capacité prévisible ou un taux effectif plus faible.
La capacité GPU réservée a du sens lorsque :
| Signal | Ce que cela ნიშნავს |
|---|---|
| Trafic d’inférence de base stable | Vous pouvez maintenir les GPU occupés pendant la plupart des heures du mois. |
| Calendrier d’entraînement répété | Vous savez quand la capacité est nécessaire et pendant combien de temps. |
| Besoin de capacité au lancement | Vous ne pouvez pas compter sur la disponibilité du spot au mieux des efforts. |
| Exigence de topologie multi-nœuds | Le placement réseau, le fabric et la proximité du stockage sont importants. |
| Les achats nécessitent une dépense fixe | Un engagement mensuel connu est plus facile à approuver qu’une consommation volatile. |
La question centrale de la capacité réservée est le seuil de rentabilité de l’utilisation :
utilisation seuil de rentabilité réservée =
  engagement mensuel réservé
  / (taux horaire à la demande * heures dans le mois)
Si l’engagement réservé atteint l’équilibre à 62 % d’utilisation et que votre base réelle est de 25 %, la capacité réservée n’est pas une remise. C’est un abonnement à de la capacité inutilisée. Pour les clusters GPU, combinez cela avec le modèle de coût total de possession d’un cluster GPU afin d’inclure le réseau, le stockage, le support, les opérations à distance et l’exploitation.
Matrice de décision par charge de travail
Le meilleur modèle tarifaire dépend davantage de la tolérance aux pannes et de l’utilisation que de la taille du modèle seule.
| Charge de travail | Meilleur point de départ | Pourquoi |
|---|---|---|
| Premier benchmark de modèle | GPU à la demande | Vous avez besoin d’une base propre pour le débit, la latence, la mémoire et les modes de panne. |
| Évaluation d’une nouvelle stack de serving | GPU à la demande | Validez vLLM, SGLang, TensorRT-LLM, les pilotes, les images et le chargement du modèle avant d’optimiser le prix. |
| Suite d’évaluation hors ligne | GPU spot | Les résultats peuvent être relancés, partitionnés et vérifiés pour détecter les doublons de travail. |
| Embeddings batch ou inférence batch | GPU spot, avec repli sur la demande | Les tâches peuvent être mises en file si l’idempotence et les contrôles de reprise existent. |
| Base d’inférence orientée client | Réservé plus burst à la demande | Une demande stable peut justifier l’engagement ; le burst reste flexible. |
| Lancement ponctuel ou courte campagne | À la demande ou bloc de capacité | La garantie de capacité peut compter davantage qu’une remise à long terme. |
| Entraînement distribué multi-nœuds | Réservé ou cluster dédié | Le placement, le fabric réseau et les domaines de panne dominent le prix horaire. |
| Fonction IA à faible volume | API de modèle ou passerelle | Une capacité GPU inactive peut coûter plus cher qu’une inférence gérée au usage. |
Pour le choix du modèle GPU dans n’importe quelle ligne, associez cet article au guide de sélection de GPU pour l’IA, au meilleur GPU pour l’inférence LLM et au guide de déploiement vLLM.
Économie GPU à la demande vs spot : un exemple simple
Supposons qu’un lot d’inférence puisse s’exécuter sur la même classe de GPU en mode à la demande ou spot.
| Champ | À la demande | Spot |
|---|---|---|
| Taux horaire affiché | $4.00 |
$1.80 |
| Utilisation utile | 70% |
70% |
| Gaspillage dû aux redémarrages et aux évictions | 0% |
22% |
| Coût effectif par heure utile | $5.71 |
$3.30 |
Le spot gagne encore dans cet exemple parce que la remise est supérieure au gaspillage. Modifiez maintenant le gaspillage de redémarrage à 55 % parce que la tâche recharge à plusieurs reprises les poids et perd des lots partiels.
| Champ | À la demande | Spot |
|---|---|---|
| Taux horaire affiché | $4.00 |
$1.80 |
| Utilisation utile | 70% |
70% |
| Gaspillage dû aux redémarrages et aux évictions | 0% |
55% |
| Coût effectif par heure utile | $5.71 |
$5.71 |
À ce stade, la remise apparente du spot disparaît. C’est pourquoi une comparaison GPU à la demande vs spot doit inclure le gaspillage opérationnel, et pas seulement le pourcentage de spot du fournisseur.
Économie des GPU réservés : le test d’utilisation
La capacité réservée nécessite un test différent. Supposons qu’un GPU à la demande coûte $4/hour, et qu’un engagement mensuel réservé pour une capacité équivalente coûte $1,900/month.
monthly on-demand cost at 100% utilization =
  $4 * 730 hours = $2,920

reserved break-even utilization =
  $1,900 / $2,920 = 65%
Cette réservation n’est intéressante que si la charge de travail peut occuper le GPU pendant plus d’environ deux tiers du mois. Si votre point de terminaison de production utilise fortement le GPU pendant les heures ouvrables mais reste à l’arrêt la nuit et le week-end, la base réelle peut être inférieure au seuil de rentabilité.
La version achat de la question est :
- Quel est le niveau de base mesuré, et non le pic prévu ?
- Quelles charges de travail sont autorisées à remplir la capacité réservée inutilisée ?
- Que se passe-t-il si le modèle passe de H100 à H200, B200, L40S ou à une API managée ?
- Le stockage, le support, le réseau et l’egress sont-ils inclus dans l’engagement ou non ?
- Le contrat peut-il être réduit, converti vers un autre type de GPU ou déplacé vers une autre région ?
Ne réservez pas sur l’espoir. Réservez sur l’utilisation mesurée.
Liste de vérification des sources fournisseurs
Les pages de tarification GPU changent souvent, et les prix des marketplaces peuvent évoluer plus vite qu’un cycle d’achat. Utilisez ceci comme une liste de vérification des sources, et non comme une grille tarifaire figée. Revérifiez-la le jour où vous approuvez la dépense.
| Catégorie de fournisseur | Source officielle à vérifier | Éléments à relever |
|---|---|---|
| AWS | Tarification Amazon EC2, EC2 Spot Instances, EC2 Capacity Blocks for ML | Région, famille d’instances GPU, On-Demand, Spot, Savings Plans ou Reserved Instances, calendrier des capacity blocks, EBS, transfert de données, support. |
| Google Cloud | Tarification des GPU Compute Engine, Spot VMs, Remises pour engagement d’utilisation | Type de GPU, famille de machines, région, statut de Spot VM, durée d’engagement, besoins de réservation, disque persistant, sortie réseau. |
| Microsoft Azure | Azure Spot Virtual Machines, Reserved VM Instances | SKU de VM GPU, région, politique d’éviction, paramètre de prix maximal, durée de réservation, disque managé, bande passante, support. |
| RunPod | Tarification RunPod et documentation produit | Secure Cloud vs Community Cloud, tarification des pods, tarification serverless, stockage persistant, volume réseau, comportement au démarrage à froid. |
| Vast.ai | Tarification Vast.ai et documentation Vast.ai | Fiabilité de l’hôte, statut datacenter/community, indicateur interruptible, disque, bande passante, hôte vérifié, besoin d’IP publique. |
| Lambda | Tarification GPU Lambda Cloud | Type d’instance, nombre de GPU, région, disponibilité à la demande, conditions de devis pour cluster réservé, hypothèses de stockage et de réseau. |
Ajoutez une ligne de date de vérification à votre feuille de calcul. Pour cet article, la liste de vérification des sources a été examinée le 13 octobre 2026.
Questions d’achat avant de choisir
Avant de choisir une capacité GPU à la demande vs spot ou de signer un contrat GPU réservé, posez ces questions :
| Question | Pourquoi c’est important |
|---|---|
| Le job peut-il créer un checkpoint et reprendre sans réparation manuelle ? | Détermine si le risque d’interruption du spot est acceptable. |
| Combien de temps le démarrage prend-il avant que le travail GPU utile commence ? | Un chargement long du modèle et des données réduit les économies du spot et nuit à l’efficacité de l’on-demand. |
| Quel est le taux d’inactivité mesuré ? | Le temps d’inactivité est la principale fuite de coût en on-demand. |
| Quel est le niveau de base, et non le pic ? | La tarification réservée ne fonctionne que lorsque la demande de base est réelle. |
| La charge de travail a-t-elle besoin d’une région ou d’un tissu réseau spécifique ? | Une topologie rare peut rendre les tarifs spot/on-demand génériques sans pertinence. |
| Le stockage, les snapshots, la bande passante et le support sont-ils inclus ? | Les heures GPU ne représentent qu’une ligne sur la facture réelle. |
| Quelle est la voie de sortie si le choix du modèle change ? | Le verrouillage matériel coûte cher lorsque l’architecture du modèle évolue. |
| Une API de modèle managée peut-elle répondre au besoin à la place ? | Les charges de travail à faible utilisation ou multi-modèles peuvent ne pas justifier l’exploitation de GPU. |
Pour les décisions multi-nœuds et de capacité privée, comparez cela avec location de cluster GPU et cloud GPU privé.
Quand une API de modèle dépasse les trois modèles de tarification GPU
Les GPU à la demande, spot et réservés supposent tous que la location et l’exploitation du matériel sont le bon niveau d’abstraction. Ce n’est pas toujours vrai.
Une API de modèle gérée peut être le meilleur point de départ économique lorsque :
- L’utilisation est faible, par à-coups ou inconnue.
- Le produit a besoin de nombreux modèles plutôt que d’un seul modèle auto-hébergé.
- La fiabilité, les mises à niveau et la mise à l’échelle détourneraient l’attention de la feuille de route produit.
- L’équipe a davantage besoin de journaux d’utilisation, de budgets et de factures que d’un contrôle du matériel.
- La charge de travail consiste en de l’inférence en production plutôt qu’en de l’entraînement de modèle ou en de la recherche sur un service personnalisé.
Flatkey se situe de ce côté de l’API dans la décision. Il offre aux équipes IA une seule clé API, un seul solde, une seule facture, une visibilité sur l’utilisation et un accès aux routes officielles des modèles sur plusieurs fournisseurs. Si la feuille de calcul GPU à la demande vs Spot montre que l’utilisation du matériel n’est pas encore assez élevée, comparez le coût d’une API gérée par résultat accepté avant d’acheter ou de réserver de la capacité GPU. L’étape suivante est les guides de comparaison des tarifs des modèles d’IA et de tarification des passerelles d’IA.
Recommandation finale
Utilisez cette séquence :
- Commencez avec une capacité GPU à la demande jusqu’à ce que les mesures de benchmark et d’utilisation soient fiables.
- Déplacez les tâches relançables vers des GPU Spot uniquement après avoir démontré la mise en checkpoint, l’idempotence et l’automatisation des redémarrages.
- Réservez de la capacité GPU uniquement pour une demande de base mesurée, des fenêtres de lancement engagées ou des clusters sensibles à la topologie.
- Gardez une voie d’accès par API de modèle ouverte lorsque l’utilisation est faible, que le choix du modèle change souvent ou que les finances ont besoin d’une attribution d’utilisation plus claire.
La meilleure décision GPU à la demande vs Spot n’est pas celle qui affiche le tarif horaire le plus bas. C’est la décision GPU à la demande vs Spot qui minimise le coût par charge de travail terminée tout en gardant le risque de fiabilité là où votre équipe peut réellement le gérer.


